Seed-Coder: Let the Code Model Curate Data for Itself
模型驱动的代码预训练数据构建方法,最小化人工干预
Seed-Coder: Let the Code Model Curate Data for Itself
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Seed-Coder: Let the Code Model Curate Data for Itself |
| 作者 | ByteDance Seed, Yuyu Zhang, Jing Su, Yifan Sun, Chenguang Xi, Xia Xiao, Shen Zheng, Anxiang Zhang, Kaibo Liu, Daoguang Zan, Tao Sun, Jinhua Zhu, Shulin Xin, Dong Huang, Yetao Bai, Lixin Dong, Chao Li 等 |
| 机构 | ByteDance Seed |
| 论文 | arXiv:2506.03524 |
| 代码 | GitHub |
| 主页 | Homepage |
| 发布 | 2025年6月4日 (v1), 2025年6月5日 (v2) |
| 领域 | cs.CL, cs.AI, cs.LG |
二、核心思想
问题定义
代码数据在大语言模型(LLM)预训练中至关重要,不仅对代码相关任务有益,还能增强LLM的通用智能。然而,当前开源LLM在构建代码预训练数据时面临严重挑战:
-
人工规则的局限性:
- 手工过滤规则针对特定编程语言定制,扩展性和维护成本高
- 人工标注数据训练质量过滤器,存在主观偏差
- 规则之间容易冲突,难以全面评估代码质量
-
可扩展性问题:
- 跨编程语言扩展成本高
- 人工评估难以处理大规模数据
- 代码质量标准难以量化
-
质量评估困难:
- 看似结构良好的代码可能包含隐藏的逻辑错误
- 短小的API调用代码可能被错误过滤
- 需要全面上下文才能准确评估代码质量
解决方案概述
本文提出Seed-Coder,一系列8B规模的开源LLM(包括base、instruct和reasoning模型),通过模型驱动的数据管道最小化人工干预:
核心思想:让代码模型自己管理数据,用LLM替代手工规则进行代码数据评分和过滤。
关键创新:
- 模型驱动数据管道:主要利用LLM对代码数据进行评分和过滤
- 多阶段预训练:常规预训练 + 持续预训练(高质量数据 + 长上下文)
- 指令微调:合成数据生成 + 沙盒自纠正
- 推理模型:LongCoT强化学习提升多步推理能力
核心成果:
- 在相似规模的开源模型中达到最先进水平
- 甚至超越一些更大的模型
- 支持代码生成、补全、编辑、推理和软件工程任务
三、技术架构
整体框架图
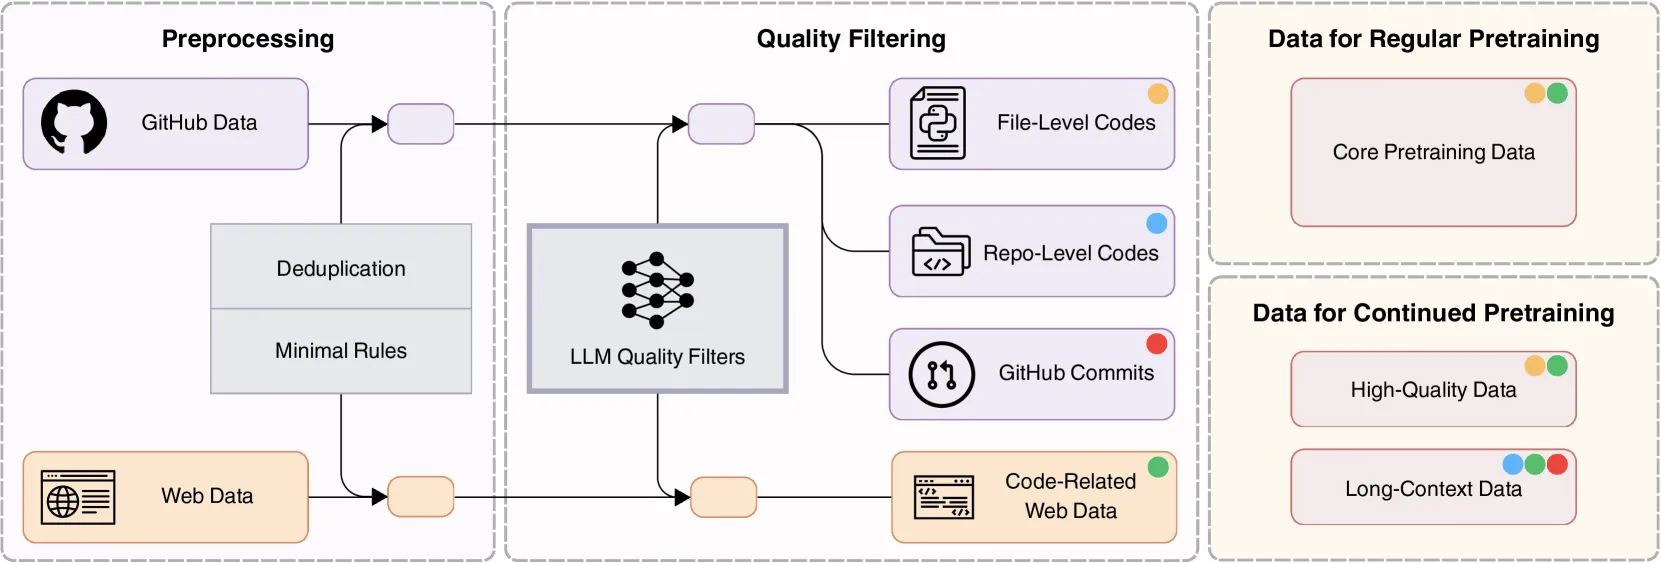
Figure 2: 预训练数据处理管道。从GitHub和web archives收集数据,处理为四类:文件级代码(黄色)、仓库级代码(蓝色)、GitHub commits(红色)和代码相关web数据(绿色)。
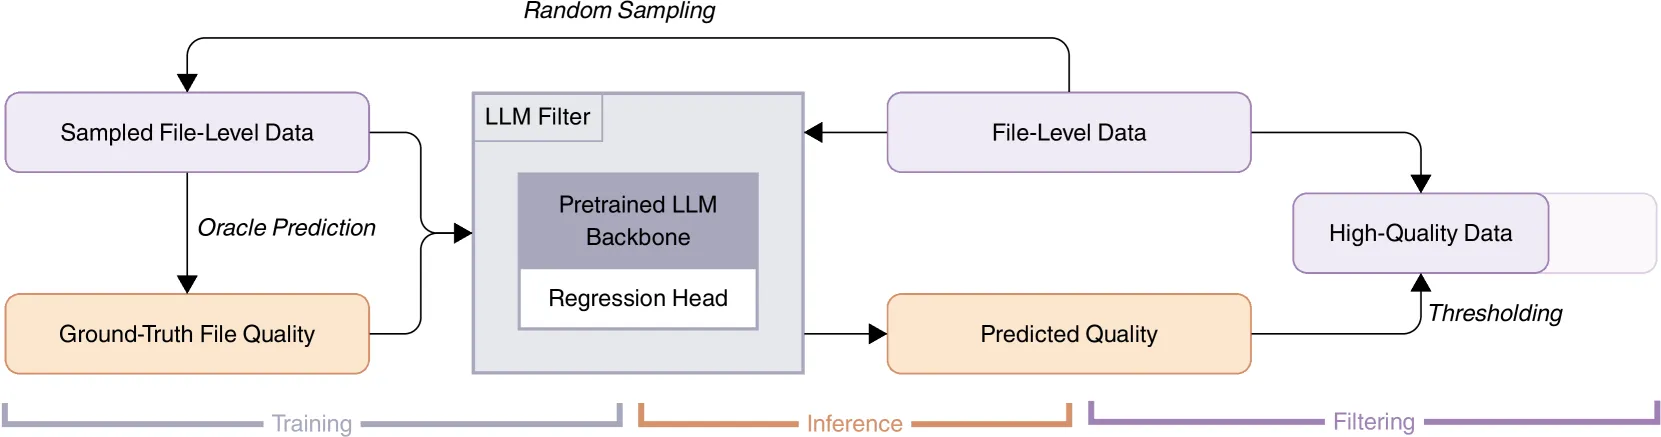
Figure 5: 数据质量评分器管道。
核心公式
数据质量评分
评分标准(4个维度):
- 可读性(Readability):合理的注释、一致的命名、遵循格式规范
- 模块化(Modularity):良好的结构、避免过度复杂、清晰的功能分离
- 清晰度(Clarity):最小化冗余、清晰传达意图
- 可复用性(Reusability):无语法/逻辑错误、避免硬编码、易于集成
评分公式:
过滤策略:
其中 为阈值,过滤底部约10%的文件。
Fill-in-the-Middle (FIM)
SPM格式(Suffix-Prefix-Middle):
FIM比率:
- 常规预训练:0.5
- 持续预训练:0.1
GRPO训练
GRPO(Group Relative Policy Optimization):
训练配置:
- Batch size: 128
- 学习率:
- 温度: 0.6
- Clip ratio: 0.28
- 移除KL损失
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 基础架构 | Llama 3结构 | 8.2B参数,36层 |
| 隐藏大小 | Hidden size | 4,096 |
| 中间大小 | Intermediate size | 14,336 |
| 注意力机制 | Grouped Query Attention | 32查询头,8键值头 |
| 上下文长度 | Context length | 8K → 32K |
训练流程
预训练阶段:
-
常规预训练(5T tokens):
- 前1T tokens:代码相关web数据 + 数学数据,学习率
- 后4T tokens:精选代码数据
-
持续预训练(1T tokens):
- 第一阶段:学习率降低10倍,400B tokens
- 第二阶段:学习率 ,600B tokens
- 高质量数据 + 长上下文数据(32K)
指令微调阶段:
-
SFT(监督微调):
- 约300万高质量指令-响应对
- 学习率 ,3个epoch
- 难度感知采样
-
DPO(直接偏好优化):
- 约20,000个高质量偏好对
- 专注于代码生成和推理
推理模型训练:
-
LongCoT预热:
- 从base模型开始(而非instruct模型)
- 学习率
- 少量蒸馏数据,保留探索空间
-
GRPO强化学习:
- 渐进式探索策略:16K → 32K序列长度
- 优化课程学习:过滤简单问题(正确率>87.5%)
- 总计250步
数据管道
四类数据:
-
文件级代码:GitHub单个代码文件
- 精确去重 + MinHash近似去重
- Tree-sitter语法检查
- LLM质量评分(1.3B回归模型)
-
仓库级代码:保持项目结构的代码
- 基于文件质量分数选择高质量仓库
- 拓扑连接(Python, Java, C)或随机连接(HTML, SQL, Shell)
-
GitHub Commits:代码变更数据
- 74M commits,来自140K高质量仓库
- 代码变更预测任务格式
- BM25检索相关文件
-
代码相关Web数据:Common Crawl中的代码内容
- fastText召回(99%召回率,45%精确率)
- LLM质量过滤
- 类别特定过滤协议
高质量数据构建:
- 迭代训练fastText模型(2-3轮)
- 硬负样本:高分但无注释的代码、fastText召回但LLM低分的代码
- 最终约130B tokens高质量数据
算法流程
Algorithm 1: Seed-Coder训练流程
输入: GitHub数据, Web数据, 训练配置
输出: Seed-Coder-8B-Base, Instruct, Reasoning

// 预训练阶段
1. 数据预处理
   - 去重(精确 + MinHash)
   - 语法检查(Tree-sitter)
   - 基本过滤

2. LLM质量过滤
   - 训练1.3B回归模型作为评分器
   - 过滤底部10%代码文件

3. 两阶段预训练
   - 阶段1: 5T tokens (代码 + 数学)
   - 阶段2: 1T tokens (高质量 + 长上下文)

// 指令微调阶段
4. SFT数据构建
   - 合成指令生成(种子代码 + 风格增强)
   - 质量过滤(规则 + 模型)
   - 难度过滤(难度分数 < 3 过滤)
   - 沙盒自纠正

5. SFT训练
   - 3M指令-响应对
   - 3 epochs, lr=2e-5

6. DPO训练
   - 20K偏好对
   - 代码生成和推理任务

// 推理模型训练
7. LongCoT预热
   - 从base模型开始
   - 少量蒸馏数据

8. GRPO强化学习
   - 渐进式探索(16K → 32K)
   - 优化课程学习
   - 250步训练
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 模型驱动数据管道 | 用LLM替代手工规则进行代码质量过滤 | 比规则过滤更准确,可扩展 |
| 四维度评分标准 | 可读性、模块化、清晰度、可复用性 | 全面评估代码质量 |
| 渐进式FIM训练 | SPM格式,字符级随机分割 | 比PSM略优,减少位置偏差 |
| 沙盒自纠正 | 迭代生成+单元测试+修正 | 保留更多高难度样本 |
| 优化课程学习 | 过滤简单问题(正确率>87.5%) | 鼓励更高效的思考token利用 |
| 渐进式探索策略 | 序列长度和rollout数量逐步扩展 | 提高训练效率 |
与人工规则对比
| 方法 | 优势 | 劣势 |
|---|---|---|
| 手工规则 | 可控、可解释 | 扩展性差、主观偏差、维护成本高 |
| LLM过滤 | 模糊标准、可扩展、一致 | 计算成本高、需要训练评分器 |
关键发现
-
LLM过滤有效性:
- 预训练过程中性能持续提升
- 与最小规则过滤相比,LLM过滤显著提高基准性能
-
SPM vs PSM:
- SPM在训练中略优于PSM
- 原因:注意力机制的位置偏差
-
从Base模型开始RL:
- Instruct模型在RL中容易退化到SFT模式
- Base模型保留更多探索空间
五、实验结果
基准测试
实验环境:
- 模型规模:8B参数
- 预训练数据:6T tokens
- 上下文长度:32K
Base模型评估
HumanEval(+)和MBPP(+):
| 模型 | 大小 | HumanEval | HE+ | MBPP | MBPP+ |
|---|---|---|---|---|---|
| StarCoder2-7B | 7B | 35.4 | 29.9 | 54.4 | 45.6 |
| DeepSeek-Coder-6.7B | 6.7B | 47.6 | 39.6 | 70.2 | 56.6 |
| Qwen2.5-Coder-7B | 7B | 72.0 | 67.1 | 79.4 | 68.3 |
| Seed-Coder-8B-Base | 8B | 77.4 | 68.3 | 82.0 | 69.0 |
| Qwen2.5-Coder-14B | 14B | 83.5 | 75.6 | 83.6 | 69.8 |
MultiPL-E(多语言代码生成):
| 模型 | 大小 | Python | C++ | Java | 平均 |
|---|---|---|---|---|---|
| Qwen2.5-Coder-7B | 7B | 72.0 | 62.1 | 53.2 | 58.8 |
| Seed-Coder-8B-Base | 8B | 77.4 | 69.6 | 72.8 | 67.6 |
| Qwen2.5-Coder-14B | 14B | 83.5 | 69.6 | 46.8 | 62.3 |
CrossCodeEval(代码补全):
| 模型 | 大小 | Python | Java | TypeScript | 平均 |
|---|---|---|---|---|---|
| Qwen2.5-Coder-7B | 7B | 42.4 | 48.1 | 46.8 | 49.3 |
| Seed-Coder-8B-Base | 8B | 49.5 | 52.6 | 50.5 | 53.7 |
| Qwen2.5-Coder-14B | 14B | 47.7 | 54.7 | 52.9 | 55.4 |
CRUXEval(代码推理):
| 模型 | 大小 | Input-CoT | Output-CoT |
|---|---|---|---|
| Qwen2.5-Coder-7B | 7B | 56.5 | 56.0 |
| Seed-Coder-8B-Base | 8B | 52.0 | 54.8 |
| Qwen2.5-Coder-14B | 14B | 60.6 | 66.4 |
长上下文能力:
- “Needle in the Code”压力测试:32K上下文长度下100%准确率
Instruct模型评估
代码生成:
| 模型 | 大小 | HumanEval | HE+ | MBPP | MBPP+ | LiveCodeBench |
|---|---|---|---|---|---|---|
| Qwen2.5-Coder-7B | 7B | 88.4 | 84.1 | 83.5 | 71.7 | 17.3 |
| Qwen3-8B | 8B | 84.8 | 80.5 | 77.0 | 67.2 | 23.5 |
| Seed-Coder-8B-Instruct | 8B | 84.8 | 78.7 | 85.2 | 71.2 | 24.7 |
| Qwen2.5-Coder-14B | 14B | 89.6 | 87.2 | 86.2 | 72.8 | 19.3 |
MBXP(多语言指令跟随):
| 模型 | 大小 | Python | Java | C++ | 平均 |
|---|---|---|---|---|---|
| Qwen2.5-Coder-7B | 7B | 83.5 | 70.5 | 74.1 | 72.9 |
| Qwen3-8B | 8B | 77.0 | 69.0 | 72.8 | 69.3 |
| Seed-Coder-8B-Instruct | 8B | 85.2 | 72.7 | 77.0 | 75.3 |
| Qwen2.5-Coder-14B | 14B | 89.6 | 76.2 | 77.3 | 77.4 |
推理模型评估
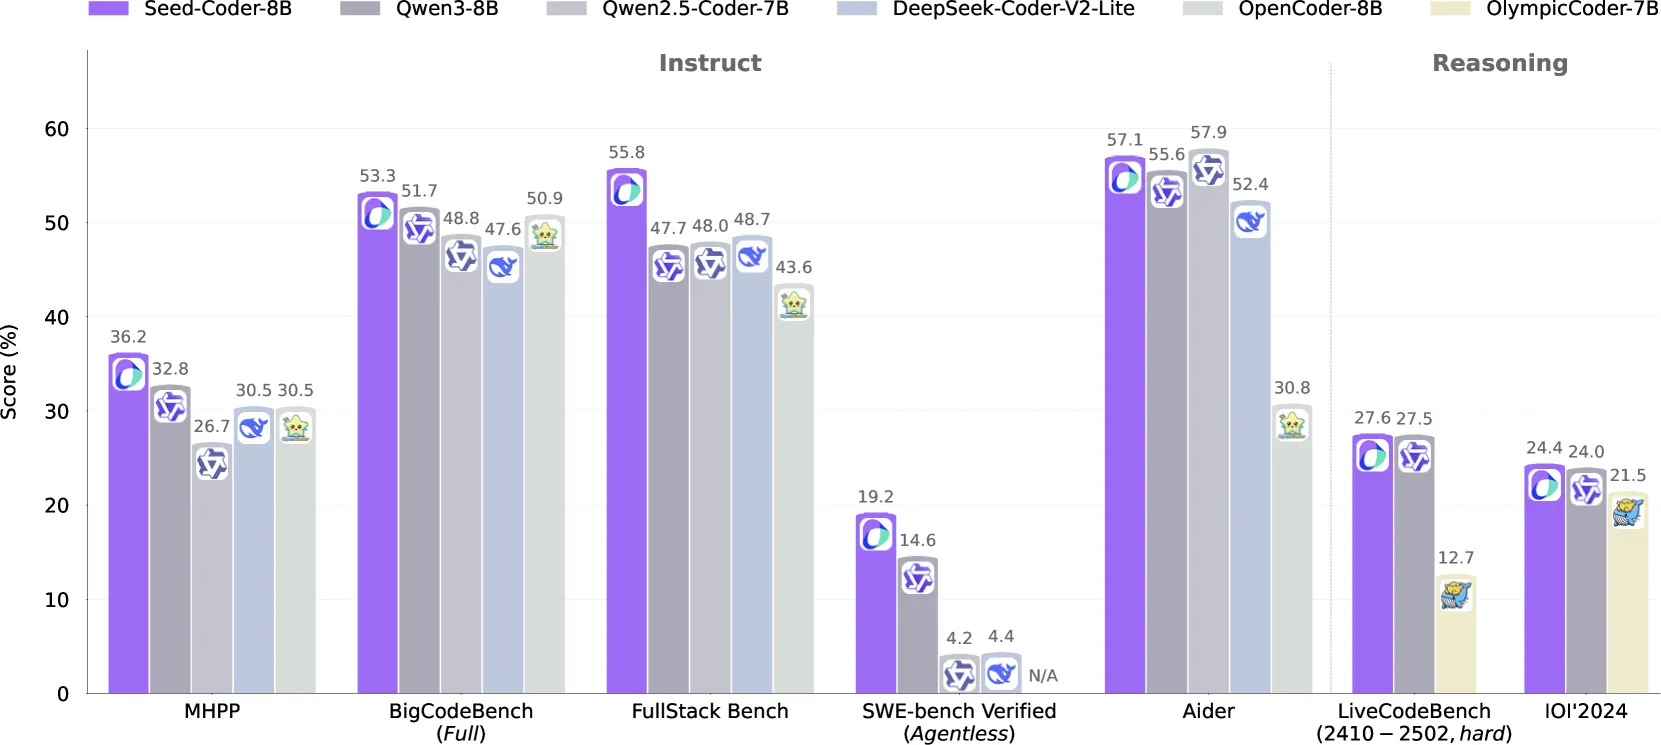
Figure 1: Seed-Coder-8B Instruct和Reasoning变体的基准性能。
IOI’2024和Codeforces:
- Seed-Coder-8B-Reasoning在竞赛编程任务上表现出色
- 与更大规模的推理模型竞争
关键发现
-
Base模型:
- 在8B规模中达到最先进水平
- 在7/8编程语言上超越相似规模模型
- 甚至超越一些13B+模型
-
Instruct模型:
- 在LiveCodeBench上表现最佳(24.7)
- 多语言能力突出(MBXP平均75.3)
-
推理模型:
- RL训练显著提升复杂推理能力
- 渐进式探索策略提高训练效率
六、相关工作
代码LLM
- StarCoder/StarCoder2:经典代码LLM,基于The Stack数据
- CodeLlama:基于Llama 2的代码LLM
- DeepSeek-Coder:项目级代码预训练
- Qwen2.5-Coder:多规模代码LLM系列
- OpenCoder:开源代码LLM,130+手工过滤规则
数据过滤方法
- 规则过滤:手工规则、Tree-sitter语法检查
- 模型过滤:fastText、回归模型、分类器
- 混合方法:规则 + 模型组合
强化学习
- GRPO:Group Relative Policy Optimization
- DAPO:避免熵崩溃的Clip-Higher技术
- LongCoT:长链推理强化学习
七、总结
核心贡献
-
模型驱动数据管道:
- 用LLM替代手工规则进行代码质量过滤
- 四维度评分标准:可读性、模块化、清晰度、可复用性
- 1.3B回归模型作为质量评分器
-
Seed-Coder模型系列:
- Base模型:6T tokens预训练
- Instruct模型:SFT + DPO
- Reasoning模型:LongCoT + GRPO RL
-
训练技术创新:
- 渐进式FIM训练(SPM格式)
- 沙盒自纠正机制
- 优化课程学习
- 渐进式探索策略
-
开源贡献:
- 8B规模,支持研究和部署
- 在多个基准测试上达到最先进水平
技术影响
- 数据构建范式:从人工规则到模型驱动的转变
- 代码LLM发展:8B规模的高性能代码模型
- 训练方法:LongCoT RL在代码推理中的应用
- 开源生态:提供可复现的训练流程
局限性
- 模型规模:主要在8B验证,更大规模的适用性待探索
- 计算成本:LLM过滤需要大量计算资源
- 评分器依赖:需要训练专门的质量评分模型
- 语言覆盖:虽然支持89种语言,但某些小众语言可能数据不足
未来工作
- 更大规模模型(14B-70B)的扩展
- 更高效的数据过滤方法
- 多模态代码理解
- 更长上下文支持(64K+)
八、参考资源
- 论文: arXiv:2506.03524
- PDF: arxiv.org/pdf/2506.03524
- HTML版本: arxiv.org/html/2506.03524v2
- GitHub: ByteDance-Seed/Seed-Coder
- HuggingFace: ByteDance-Seed Collection
引用
@article{seed2025coder,
  title={Seed-Coder: Let the Code Model Curate Data for Itself},
  author={ByteDance Seed and Zhang, Yuyu and Su, Jing and Sun, Yifan and Xi, Chenguang and Xiao, Xia and Zheng, Shen and Zhang, Anxiang and Liu, Kaibo and Zan, Daoguang and Sun, Tao and Zhu, Jinhua and Xin, Shulin and Huang, Dong and Bai, Yetao and Dong, Lixin and Li, Chao and others},
  journal={arXiv preprint arXiv:2506.03524},
  year={2025}
}