MERIT: Multilingual Semantic Retrieval with Interleaved Multi-Condition Query
首个多语言多条件语义检索数据集,通过对比重建框架提升检索性能45.9%
MERIT: Multilingual Semantic Retrieval with Interleaved Multi-Condition Query
论文信息: arXiv:2506.03144 [cs.CV] 4 Jun 2025
机构: ByteDance Inc.
数据集规模: 320,000 queries, 135,000 products, 5 languages, 7 categories
一、论文概述
1.1 研究背景
语义检索是现代应用的关键任务,但在多语言、多条件、多图像场景下仍存在不足。现有数据集局限于单一语言、单一图像或单一检索条件,无法充分利用视觉信息的表达能力。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 多条件查询 | 实际检索涉及多个条件(如图案、颜色、风格) |
| 多图像输入 | 查询可能包含多个图像作为条件 |
| 多语言支持 | 需要跨语言检索能力 |
| 视觉信息利用 | 现有方法未充分利用图像信息 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| MERIT 数据集 | 首个多语言多条件语义检索数据集 |
| Coral 框架 | 对比重建微调框架,提升检索性能 45.9% |
| 局限性识别 | 发现现有方法忽略条件元素的问题 |
| 跨基准验证 | 在 8 个标准检索基准上验证泛化能力 |
1.3 一句话总结
MERIT 是首个多语言多条件语义检索数据集,包含 320,000 个查询和 135,000 个产品,通过 Coral 框架实现 45.9% 的性能提升。
二、核心思想
2.1 设计原则
┌─────────────────────────────────────────────────────────────────┐
│                    MERIT 设计原则                                │
├─────────────────────────────────────────────────────────────────┤
│  1. 多条件查询 (Multi-Condition Query)                          │
│     • 每个查询包含多个条件(文本+图像)                           │
│     • 条件包括图案、颜色、风格等                                 │
│     • 需要同时满足所有条件                                       │
│                                                                 │
│  2. 多语言支持 (Multilingual Support)                            │
│     • 支持 5 种语言(英语、马来语、印尼语、越南语、泰语)        │
│     • 跨语言检索能力                                            │
│     • 语言无关的语义理解                                        │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | MERIT 解决方案 |
|---|---|---|
| 条件元素忽略 | 现有方法仅关注全局语义 | Coral 框架保留细粒度条件元素 |
| 视觉信息利用 | 图像可被文本替代而不影响性能 | 强调视觉信息的必要性 |
| 多图像处理 | 现有 MLLM 丢失交错输入能力 | 训练后序列输入性能提升 14.3% |
| 数据集局限 | 单一语言、单一图像、单一条件 | 多语言、多图像、多条件数据集 |
三、MERIT 数据集
3.1 数据集概览
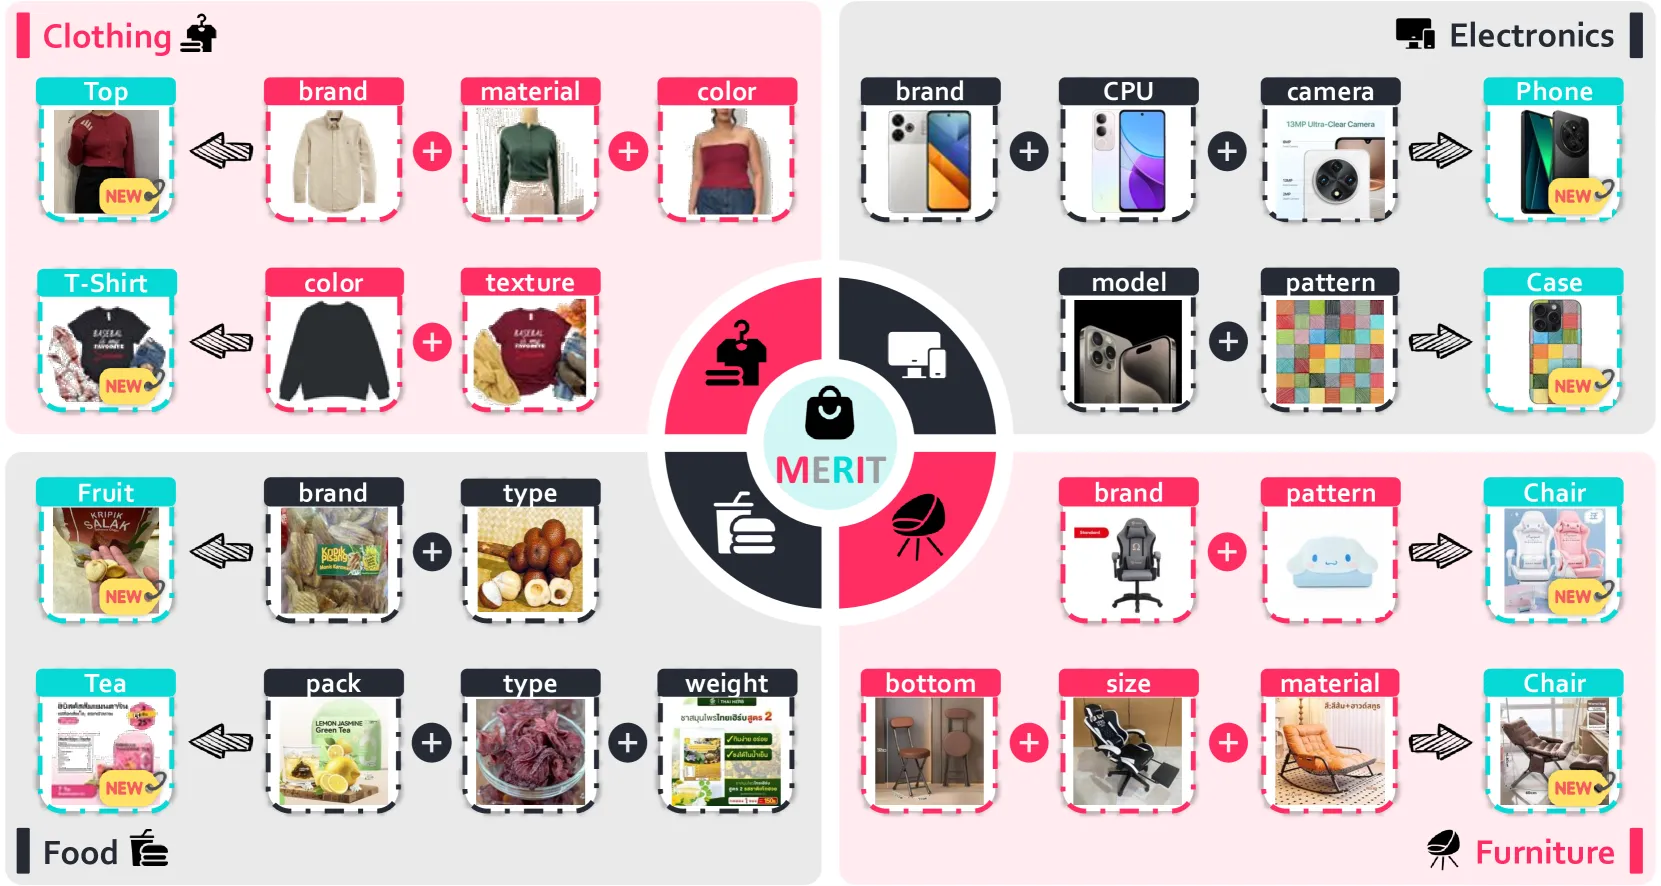 图 1:交错多条件语义检索示例。MERIT 支持首个具有复合多条件查询的多语言语义检索,查询交错文本描述和视觉参考。
| 统计项 | 数量 |
|---|---|
| 总查询数 | 320,000 |
| 两条件查询 | 319,600 |
| 三条件查询 | 300 |
| 四条件查询 | 100 |
| 唯一属性数 | 116 |
| 唯一属性值数 | 2,594 |
| 产品数量 | 135,000 |
| 支持语言 | 5(英语、马来语、印尼语、越南语、泰语) |
| 产品类别 | 7 |
3.2 数据集对比
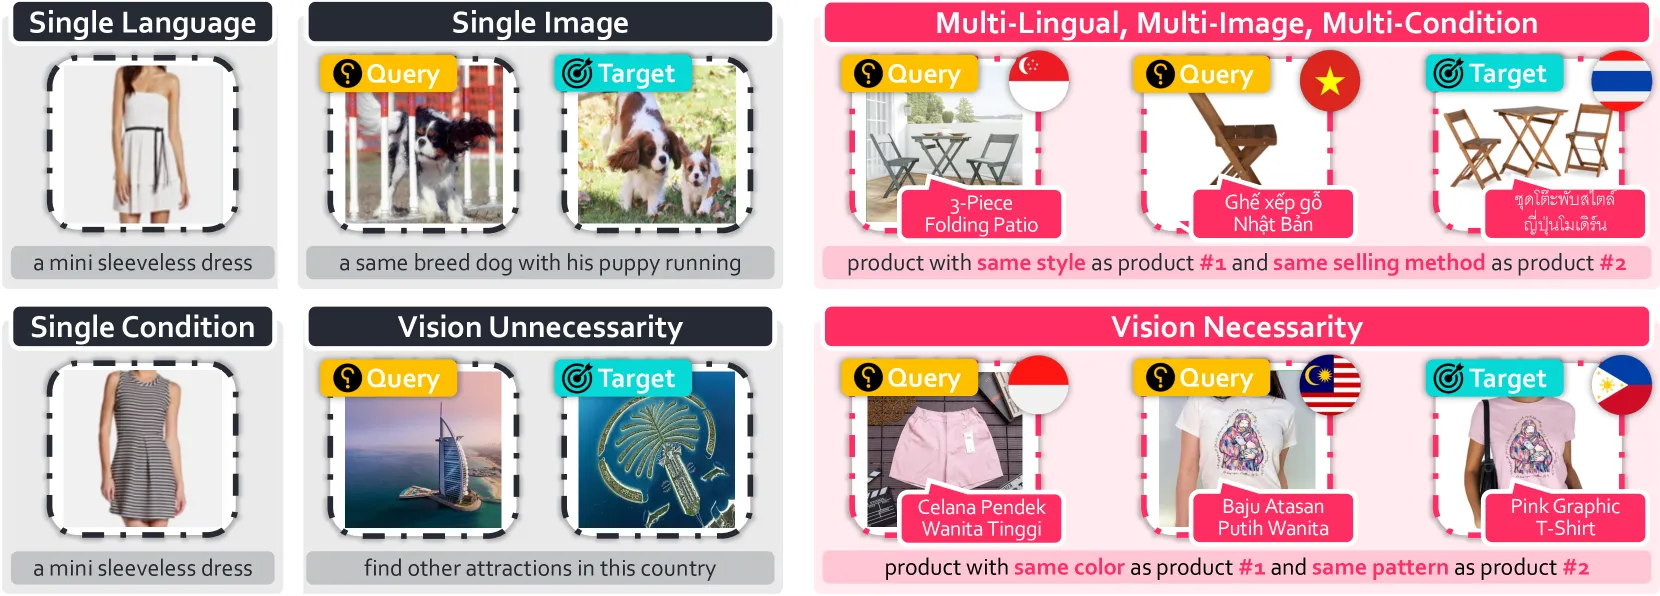 图 2:与现有数据集的对比。左:现有工作局限于单条件、单图像、单语言场景。右:我们的基准支持多语言语义检索,具有复合多条件查询。
| 特性 | 现有数据集 | MERIT |
|---|---|---|
| 语言 | 单一语言 | 5 种语言 |
| 图像 | 单一图像 | 多图像 |
| 条件 | 单一条件 | 多条件 |
| 视觉必要性 | 可被文本替代 | 不可替代 |
3.3 数据收集流程
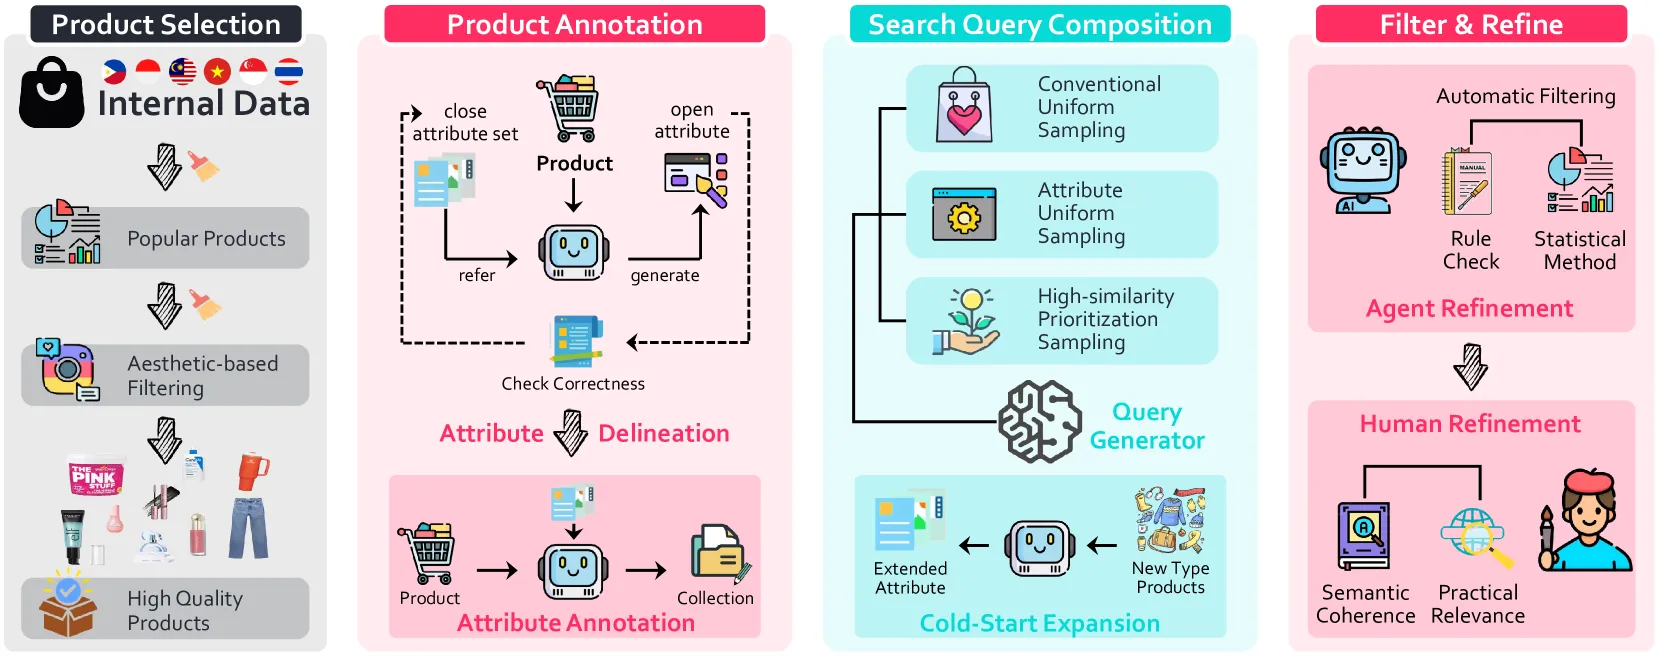 图 5:MERIT 数据标注流程。通过 4 个步骤的开放集去重和多轮过滤确保数据多样性和质量。
四步流程:
| 步骤 | 说明 |
|---|---|
| 1. 高质量产品选择 | 从 6 个东南亚国家选择热门产品,使用 GPT-4o 生成标题 |
| 2. 产品标注 | 开放标注获取细粒度属性,属性界定后标注产品 |
| 3. 搜索查询组合 | 三种采样方法:均匀采样、属性均匀采样、高相似度产品优先采样 |
| 4. 过滤与精炼 | 自动过滤(规则+统计)+ 人工过滤(专家标注) |
四、Coral 框架
4.1 框架概览
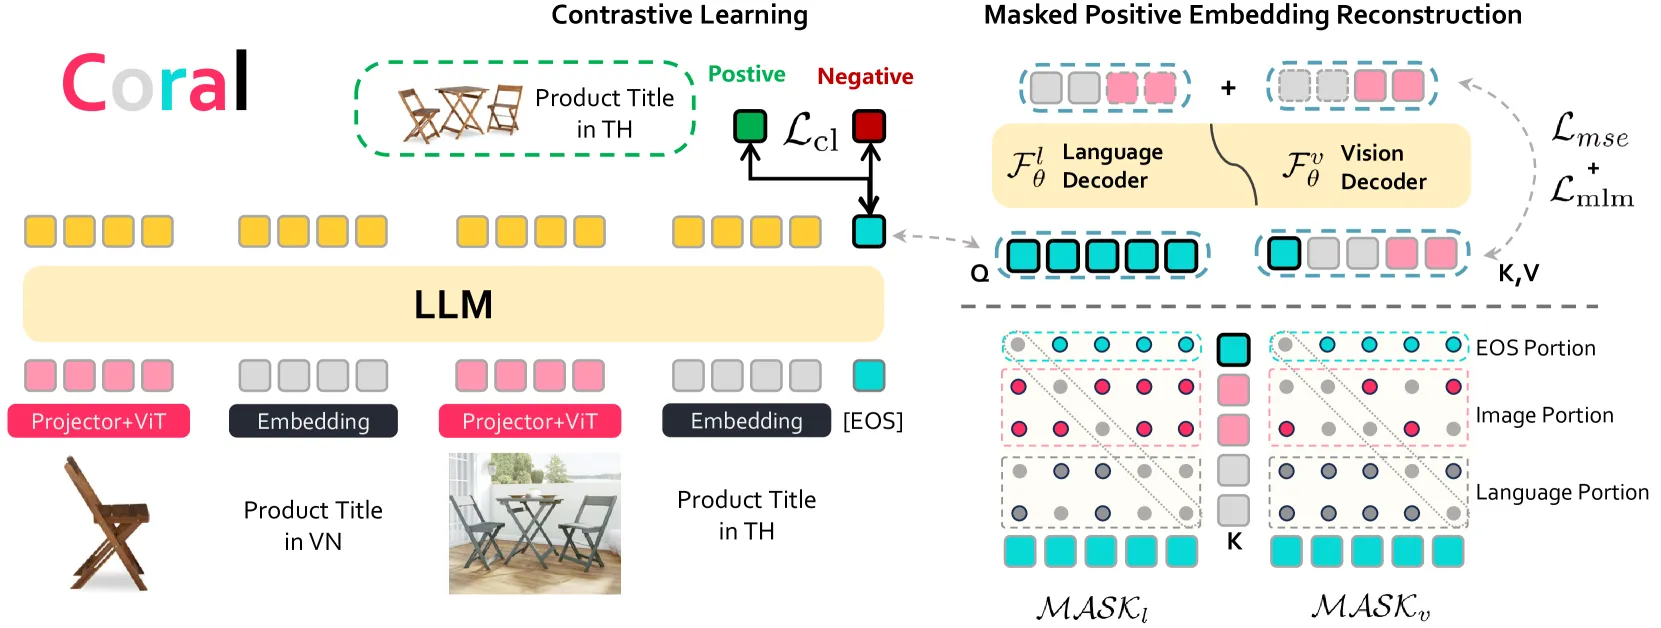 图 8:Coral 概览。损失函数由三个组件组成:对比学习损失、视觉重建损失和掩码语言建模损失。
核心组件:
| 组件 | 说明 | 目标 |
|---|---|---|
| 对比学习损失 | InfoNCE Loss | 提取全局语义 |
| 视觉重建损失 | MSE Loss | 保留视觉条件元素 |
| 掩码语言建模损失 | MLM Loss | 保留文本条件元素 |
4.2 关键公式
对比学习损失 (InfoNCE Loss):
视觉重建损失 (MSE Loss):
掩码语言建模损失:
总体训练目标:
4.3 技术亮点
1. 嵌入重建:
- 掩码视觉和语言部分的注意力图
- 重建原始嵌入以保留细粒度条件元素
- 视觉重建和语言重建同时进行
2. 对比学习:
- InfoNCE Loss 提取全局语义
- 监督对比学习区分正负样本
- 温度系数控制相似度分布
3. 多模态融合:
- 交错图像-文本输入
- 序列输入优于图像拼接
- 保留更多图像信息
五、实验结果
5.1 主要结果
MERIT 基准性能:
| 方法 | 类型 | R@1 (%) | R@5 (%) | R@10 (%) | MRR (%) |
|---|---|---|---|---|---|
| Zero-Shot | |||||
| InternVL2.5 (1B) | Cat | 0.20 | 0.98 | 1.72 | 0.56 |
| Qwen2.5-VL (3B) | Cat | 0.05 | 0.27 | 0.40 | 0.14 |
| Embedding MLLM | |||||
| E5-V (8B) | Avg | 3.10 | 7.54 | 9.90 | 5.03 |
| LLaVE (2B) | Cat | 5.80 | 43.62 | 53.51 | 21.78 |
| GME-Qwen2VL (22B) | Cat | 8.47 | 47.13 | 56.18 | 25.02 |
| LamRA-Qwen2.5VL (7B) | Cat | 12.05 | 39.13 | 48.03 | 23.80 |
| Coral (Ours) | |||||
| Qwen2.5-VL + Coral | Seq | 69.68 | 89.26 | 93.08 | 78.33 |
关键发现:
- 现有方法在 MERIT 上表现不佳,最佳 R@1 仅 12.05%
- Coral 实现 45.9% 的性能提升
- 序列输入优于图像拼接
5.2 消融实验
| 方法 | LoRA | 类型 | R@1 (%) | R@5 (%) | R@10 (%) | MRR (%) |
|---|---|---|---|---|---|---|
| 基线 (CL) | ✓ | Seq | 48.52 | 73.11 | 77.93 | 59.48 |
| +Vision | ✓ | Seq | 58.18 | 83.19 | 88.02 | 69.13 |
| +Language | ✓ | Seq | 58.38 | 83.01 | 88.26 | 69.35 |
| +Vision | ✗ | Seq | 59.46 | 85.46 | 90.81 | 70.89 |
| +Language | ✗ | Seq | 59.98 | 86.01 | 90.72 | 71.22 |
| Coral (Full) | ✗ | Seq | 69.68 | 89.26 | 93.08 | 78.33 |
关键发现:
- 嵌入重建显著提升性能
- 多模态重建优于部分重建
- 全参数微调优于 LoRA
5.3 跨基准验证
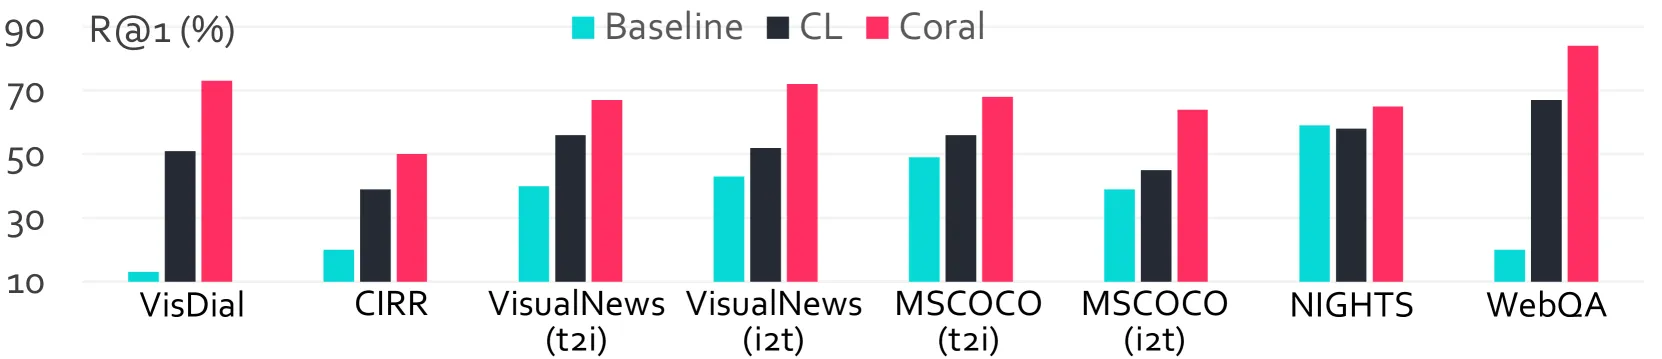 图 9:我们的方法与其他方法在 8 个标准检索任务上的对比
关键发现:
- 在 8 个标准检索基准上一致提升
- VisDial 上提升 181%
- 强大的泛化能力
5.4 视觉必要性测试
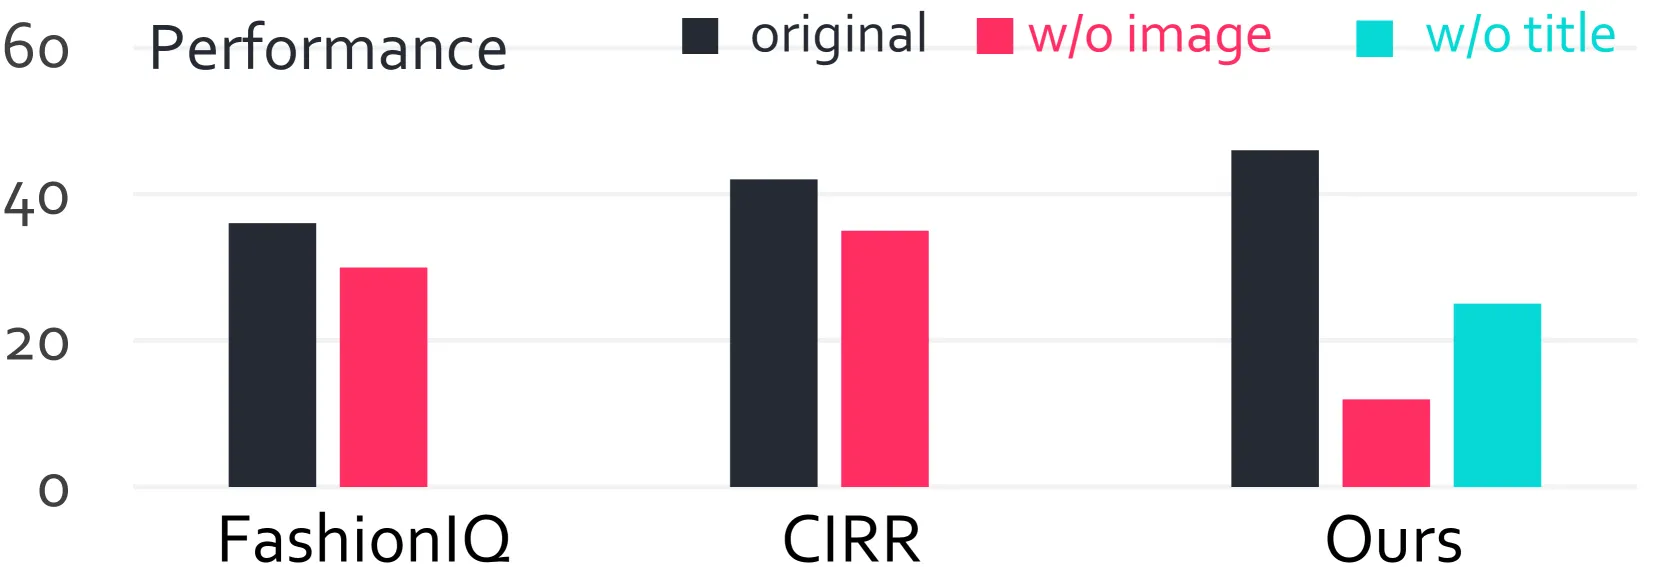 图 6:(a) 视觉必要性测试,(b) 分布外场景
关键发现:
- 在 FashionIQ 和 CIRR 上,图像被文本替代后性能无显著下降
- 在 MERIT 上,移除图像导致性能下降 73.9%
- 证明 MERIT 中图像和文本都不可或缺
六、核心创新
6.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个多条件数据集 | 320,000 查询,5 语言,7 类别 | 数据集统计和基准对比 |
| 条件元素识别 | 发现现有方法忽略条件元素 | 错误分析和消融实验 |
| Coral 框架 | 对比重建保留细粒度条件 | 45.9% 性能提升 |
| 交错输入发现 | 序列输入优于图像拼接 | 14.3% 性能提升 |
6.2 技术亮点
1. 数据集设计:
- 开放属性标注增加多样性
- 闭合产品标注提高精度
- 三种采样算法增强丰富性
2. 错误分析:
- 属性错误:无法提取特定属性
- 视觉理解错误:误解视觉内容
- 类别错误:产品类别识别错误
3. 框架创新:
- 嵌入重建保留条件元素
- 对比学习提取全局语义
- 多模态融合提升性能
七、应用场景
7.1 电子商务检索
- 多条件搜索:用户同时指定图案、颜色、风格等条件
- 跨语言检索:支持多种语言的商品搜索
- 视觉搜索:通过图像参考进行检索
7.2 内容推荐
- 个性化推荐:基于多条件用户偏好
- 跨模态推荐:结合文本和图像信息
- 多语言推荐:支持多语言用户
7.3 信息检索
- 多模态搜索:结合文本和图像查询
- 条件过滤:精确匹配多个条件
- 跨语言信息检索:多语言文档检索
八、相关工作
8.1 语义检索
| 方法 | 特点 | 局限性 |
|---|---|---|
| CLIP | 视觉-语言对齐 | 单一条件,单一图像 |
| E5-V | 多模态嵌入 | 未充分利用视觉信息 |
| LLaVE | MLLM 检索 | 多条件性能有限 |
8.2 多模态学习
| 方法 | 特点 | 局限性 |
|---|---|---|
| LLaVA | 视觉问答 | 生成式模型不适合检索 |
| Qwen2.5-VL | 多模态理解 | 未针对检索优化 |
| Coral | 对比重建 | 本方法 |
九、总结
9.1 核心贡献
- MERIT 数据集:首个多语言多条件语义检索数据集
- Coral 框架:对比重建微调框架,提升 45.9%
- 局限性识别:发现现有方法忽略条件元素
- 跨基准验证:在 8 个标准检索基准上验证
9.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| 语义检索 | 推动多条件检索研究 |
| 多模态学习 | 展示视觉信息的重要性 |
| 跨语言检索 | 支持多语言检索场景 |
| 电子商务 | 改进商品搜索体验 |
9.3 局限性
- 数据集规模:320,000 查询仍有限
- 语言覆盖:仅支持 5 种语言
- 计算开销:全参数微调成本较高
- 条件数量:主要支持 2-3 个条件
9.4 未来方向
- 数据集扩展:增加更多语言和条件
- 模型压缩:降低计算开销
- 实时检索:支持实时多条件检索
- 更多模态:扩展到音频、视频等模态
十、参考资源
10.1 论文链接
- arXiv: https://arxiv.org/abs/2506.03144
- PDF: https://arxiv.org/pdf/2506.03144
- 项目主页: https://huggingface.co/papers/2506.03144
10.2 代码资源
- GitHub: https://github.com/WeiChow/MERIT
- HuggingFace: https://huggingface.co/datasets/WeiChow/merit
- 模型: https://huggingface.co/Bia/CORAL
10.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 交错多条件检索示例 | figure-1-interleaved-retrieval.png |
| 图 2 | 数据集对比 | figure-2-dataset-comparison.png |
| 图 5 | 数据收集流程 | figure-5-data-pipeline.png |
| 图 6 | 视觉必要性测试 | figure-6-visual-necessity.png |
| 图 8 | Coral 框架概览 | figure-8-coral-overview.png |
| 图 9 | 跨基准性能对比 | figure-9-retrieval-benchmarks.png |


10.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| CLIP | Radford et al. | 2021 | 视觉-语言对齐基础 |
| LLaVA | Liu et al. | 2024 | MLLM 架构 |
| Qwen2.5-VL | Alibaba | 2025 | 多模态理解基线 |
| E5-V | Microsoft | 2024 | 多模态嵌入基线 |
10.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 语义检索 | Semantic Retrieval | 基于语义相似性的检索 |
| 多条件查询 | Multi-Condition Query | 包含多个条件的查询 |
| 对比学习 | Contrastive Learning | 区分正负样本的学习方法 |
| 嵌入重建 | Embedding Reconstruction | 重建嵌入以保留信息 |
| 交错输入 | Interleaved Input | 交错的图像-文本输入 |
分析完成时间:2026年6月17日 分析工具:Claude Code + agent-browser