R-KV: Redundancy-aware KV Cache Compression for Reasoning Models
面向推理模型的冗余感知KV缓存压缩
R-KV: Redundancy-aware KV Cache Compression for Reasoning Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | R-KV: Redundancy-aware KV Cache Compression for Reasoning Models |
| 作者 | Zefan Cai, Wen Xiao, Hanshi Sun, Cheng Luo, Yikai Zhang, Ke Wan, Yucheng Li, Yeyang Zhou, Li-Wen Chang, Jiuxiang Gu, Zhen Dong, Anima Anandkumar, Abedelkadir Asi, Junjie Hu |
| 机构 | University of Wisconsin-Madison, Microsoft, CMU, Caltech, UC San Diego, University of Surrey, UC Berkeley |
| 论文 | arXiv:2505.24133 |
| 代码 | GitHub |
| 领域 | cs.CL, KV Cache压缩, 推理模型优化 |
二、核心思想
问题定义
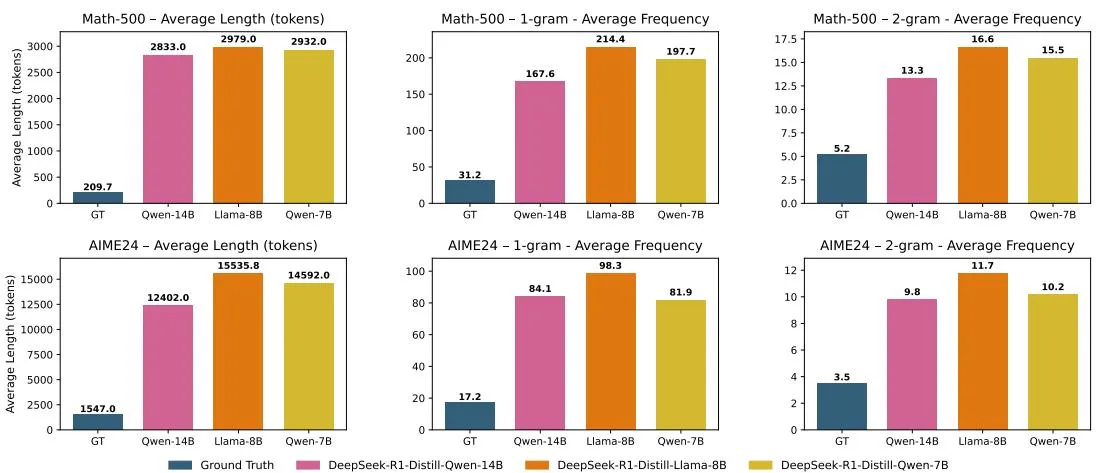
推理模型(如DeepSeek-R1)在链式思维(CoT)推理中表现出色,但会产生过长的输出,导致KV缓存内存急剧增长。
推理模型的独特挑战:
| 特性 | 说明 | 影响 |
|---|---|---|
| 超长输出 | 推理模型生成8-14×更多token | KV缓存内存爆炸 |
| 高重复性 | 1-/2-gram频率比ground truth高5-7× | 大量冗余token |
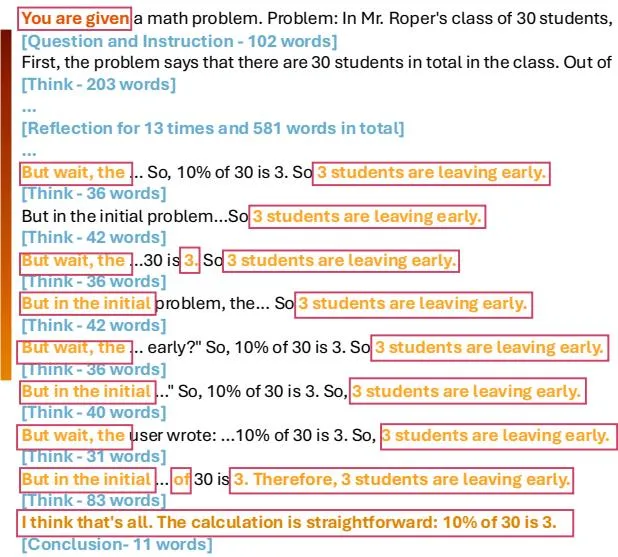
| 自反思冗余 | 不必要的反思、迭代重评估 | 浪费缓存空间 |
核心数据:
- DeepSeek-R1-Distill-Llama-8B生成32K token消耗4.1GB KV缓存
- 超过一半的token对任务性能贡献极小
现有方法的失败
| 方法 | 设计目标 | 推理模型问题 |
|---|---|---|
| SnapKV | 长输入prompt压缩 | 重复内容获得高注意力分数,被过度保留 |
| H2O | Heavy-Hitter Oracle | 忽略冗余,保留大量重复自反思 |
| StreamingLLM | 流式推理 | 不适用于超长生成输出 |
关键发现:重复内容在注意力分数中获得不成比例的高权重,导致现有方法过度保留冗余token。
解决方案概述
R-KV提出冗余感知的解码时KV缓存压缩方法:
| 组件 | 功能 | 方法 |
|---|---|---|
| 重要性评分 | 识别关键token | 基于注意力权重 |
| 冗余估计 | 识别重复token | 基于key向量语义相似度 |
| 联合选择 | 平衡重要性和冗余 | 加权组合策略 |
三、技术架构
整体框架
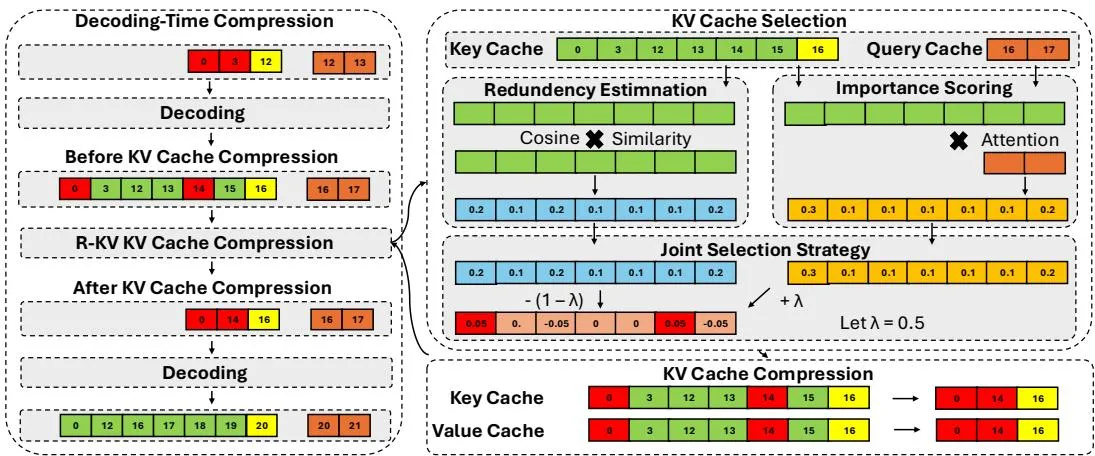
R-KV包含三个关键步骤:
解码时压缩
与现有方法的区别:
| 方法 | 压缩阶段 | 目标 |
|---|---|---|
| SnapKV, H2O | 预填充阶段 | 长输入prompt |
| R-KV | 解码阶段 | 长生成输出 |
压缩流程:
- 分配缓存:
- 每生成固定长度文本段后触发压缩
- 保留最后个token作为观察token
- 从候选token中选择top-保留
重要性评分(基于注意力权重)
Multi-Head Attention (MHA):
Grouped-Query Attention (GQA):
重要性评分:
冗余估计(基于语义相似度)
余弦相似度计算:
保留最近token:对于高相似度token集合,保留个最近的token,将其相似度置零。
冗余评分:
联合选择策略
最终选择分数:
- :重要性vs冗余的权衡参数
- 默认(更重视减少冗余)
选择策略:选择最高的个token保留。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 冗余感知压缩 | 首次针对推理模型冗余特性设计 | 50%+ token贡献极小 |
| 解码时压缩 | 区别于预填充阶段压缩 | 适用于长生成输出 |
| 语义相似度冗余估计 | 基于key向量余弦相似度 | 识别重复自反思 |
| 联合选择策略 | 平衡重要性和冗余 | 最优 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 模型 | DeepSeek-R1-Distill-Llama-8B, DeepSeek-R1-Distill-Qwen-14B |
| 数据集 | MATH-500, AIME 2024 |
| 基线 | SnapKV, FullKV |
| 评估 | pass@1 (64 responses/question), temperature=0.6, top-p=0.95 |
| 硬件 | NVIDIA A100 80G |
| 超参数 | , , |
准确率结果
R1-Llama-8B - AIME24:
| 方法 | KV缓存比例 | 准确率 | vs FullKV |
|---|---|---|---|
| FullKV | 100% | 基准 | 100% |
| SnapKV | 10% | ~60% | 60% |
| R-KV | 10% | ~100% | ~100% |
| R-KV | 16% | ~105% | 105% |
关键发现:
- R-KV用10% KV缓存达到近100% FullKV性能
- R-KV用16% KV缓存达到105% FullKV性能(超过完整缓存!)
- SnapKV仅能达到60%性能
R1-Qwen-14B - AIME24:
| 方法 | KV缓存比例 | 准确率 | vs FullKV |
|---|---|---|---|
| FullKV | 100% | 基准 | 100% |
| SnapKV | 10% | ~60% | 60% |
| R-KV | 25% | ~100% | ~100% |
| R-KV | 33% | ~105% | 105% |
固定预算分析
R1-Llama-8B:
| 数据集 | 预算 | 无损压缩 |
|---|---|---|
| MATH-500 | 1024 tokens | ✓ |
| AIME-2024 | 1536 tokens | ✓ |
R1-Qwen-14B:
| 数据集 | 预算 | 无损压缩 |
|---|---|---|
| MATH-500 | 1536 tokens | ✓ |
| AIME-2024 | 3072 tokens | ✓ |
效率提升
| 指标 | 提升 |
|---|---|
| 内存节省 | 90% |
| 吞吐量提升 | 6.6× |
超参数分析
敏感度:
- :最优平衡(更重视减少冗余)
- 过大:过度重视重要性,冗余token保留过多
- 过小:过度重视冗余,可能误删重要token
六、相关工作
| 方法类别 | 代表方法 | 特点 | 与R-KV的区别 |
|---|---|---|---|
| 注意力驱逐 | SnapKV, H2O | 基于注意力分数选择 | 忽略冗余,重复token被过度保留 |
| 层级压缩 | PyramidKV | 动态层级预算分配 | 正交于R-KV |
| 头级压缩 | Not All Heads Matter | 头级预算分配 | 正交于R-KV |
| 量化 | KVQuant, KIVI | 降低数值精度 | 可与R-KV结合 |
| 流式推理 | StreamingLLM | 注意力汇 | 不适用于长生成 |
七、总结
核心贡献
- 首次系统分析推理模型冗余:超过50% token贡献极小
- 冗余感知压缩框架:结合重要性和冗余的联合选择策略
- 解码时压缩:区别于预填充阶段,适用于长生成输出
- 显著性能提升:10%缓存达到100%性能,16%缓存达到105%性能
技术影响
- 内存效率:90%内存节省
- 推理速度:6.6×吞吐量提升
- 训练无关:无需额外训练
- 模型无关:适用于各种推理模型
- 可与其他方法结合:预算分配、量化等正交技术
局限性
- 超参数调优:需要根据任务调整
- 相似度阈值:需要设定固定阈值
- 计算开销:余弦相似度矩阵计算
- 模型依赖:主要在DeepSeek-R1系列上验证
八、参考资源
- 论文:arXiv:2505.24133
- 代码:GitHub - R-KV
- 相关项目:SnapKV, H2O, PyramidKV, StreamingLLM