EfficientLLM: Efficiency in Large Language Models
首个全面评估 LLM 效率技术的大规模基准测试,涵盖架构预训练、微调和量化推理
EfficientLLM: Efficiency in Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | EfficientLLM: Efficiency in Large Language Models |
| 作者 | Zhengqing Yuan, Weixiang Sun, Yixin Liu, Huichi Zhou, Rong Zhou, Yiyang Li, Zheyuan Zhang, Wei Song, Yue Huang, Haolong Jia, Keerthiram Murugesan, Yu Wang, Lifang He, Jianfeng Gao, Lichao Sun, Yanfang Ye |
| 机构 | Notre Dame University, Microsoft Research, Lehigh University 等 |
| 论文 | arXiv:2505.13840 |
| 代码 | 无公开代码(数据集和评估流程开源) |
| 发布 | 2025-05-20 |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
大语言模型(LLMs)的参数量和上下文窗口持续增长,导致计算、能源和金钱成本急剧上升。现有研究通常孤立地评估单一效率技术(如量化或注意力变体),缺乏一个统一的、大规模的、跨维度的效率评估框架。
解决方案概述
EfficientLLM 提出了首个全面的 LLM 效率基准测试,在生产级集群(48×GH200 + 8×H200 GPU)上系统性评估了三大维度的效率技术:
- 架构预训练:高效注意力变体(MQA, GQA, MLA, NSA)、稀疏 MoE
- 微调:参数高效方法(LoRA, RSLoRA, DoRA)
- 推理:量化方法(int4, float16)
定义了 6 个细粒度指标:内存利用率、计算利用率、延迟、吞吐量、能源消耗、压缩率。
三、技术架构
整体框架图
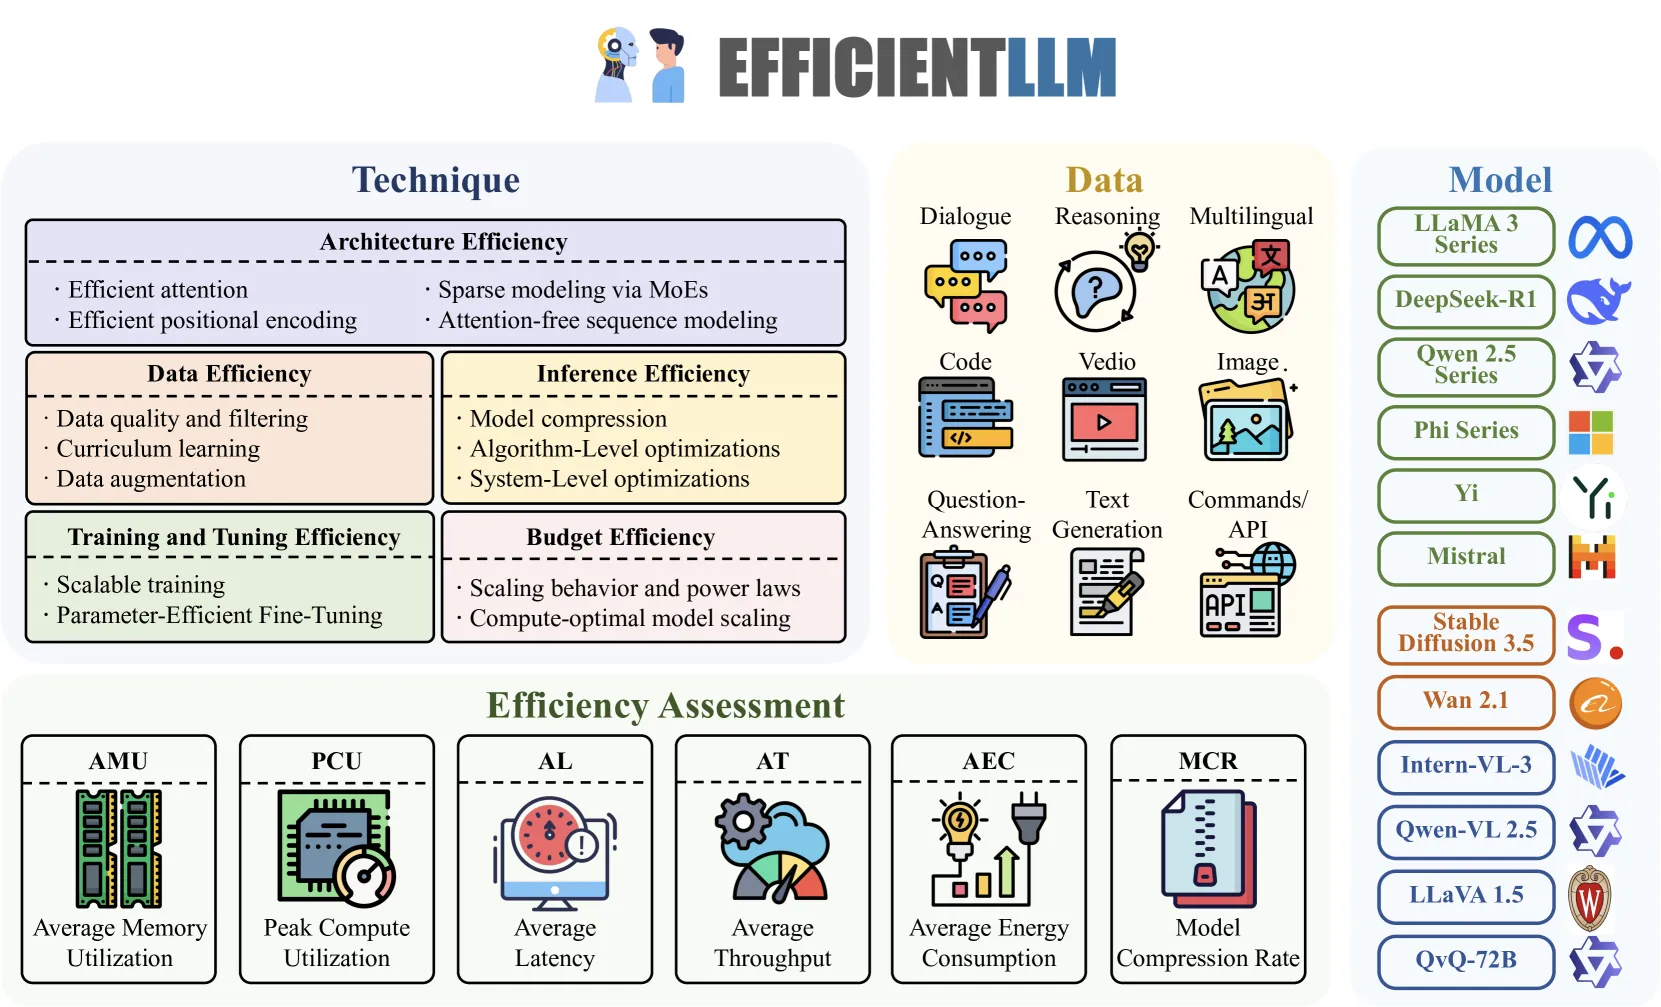
EfficientLLM 的评估框架覆盖 LLM 生命周期的三个关键阶段:
┌─────────────────────────────────────────────────────────────┐
│                    EfficientLLM Framework                    │
├─────────────────────────────────────────────────────────────┤
│                                                             │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐        │
│  │ Architecture │  │ Fine-Tuning │  │ Inference   │        │
│  │ Pretraining  │  │             │  │             │        │
│  ├─────────────┤  ├─────────────┤  ├─────────────┤        │
│  │ MQA, GQA    │  │ LoRA        │  │ int4        │        │
│  │ MLA, NSA    │  │ RSLoRA      │  │ float16     │        │
│  │ MoE         │  │ DoRA        │  │ bfloat16    │        │
│  │ Mamba       │  │ PISSA       │  │             │        │
│  └─────────────┘  └─────────────┘  └─────────────┘        │
│                                                             │
├─────────────────────────────────────────────────────────────┤
│                    6 Efficiency Metrics                     │
│  AMU (内存) | PCU (计算) | AL (延迟) | TT (吞吐) | AEC (能耗) | MCR (压缩) │
└─────────────────────────────────────────────────────────────┘
效率指标体系
| 指标 | 全称 | 说明 | 方向 |
|---|---|---|---|
| AMU | Average Memory Utilization | 平均 GPU 内存利用率 | ↑ |
| PCU | Peak Compute Utilization | 峰值计算利用率 | ↑ |
| AL | Average Latency | 平均推理延迟 | ↑ (归一化后) |
| TT | Tokens Throughput | 每秒生成 token 数 | ↑ |
| AEC | Average Energy Consumption | 平均能源消耗 | ↑ (归一化后) |
| MCR | Model Compression Rate | 模型压缩率 | ↑ |
效率排名总览
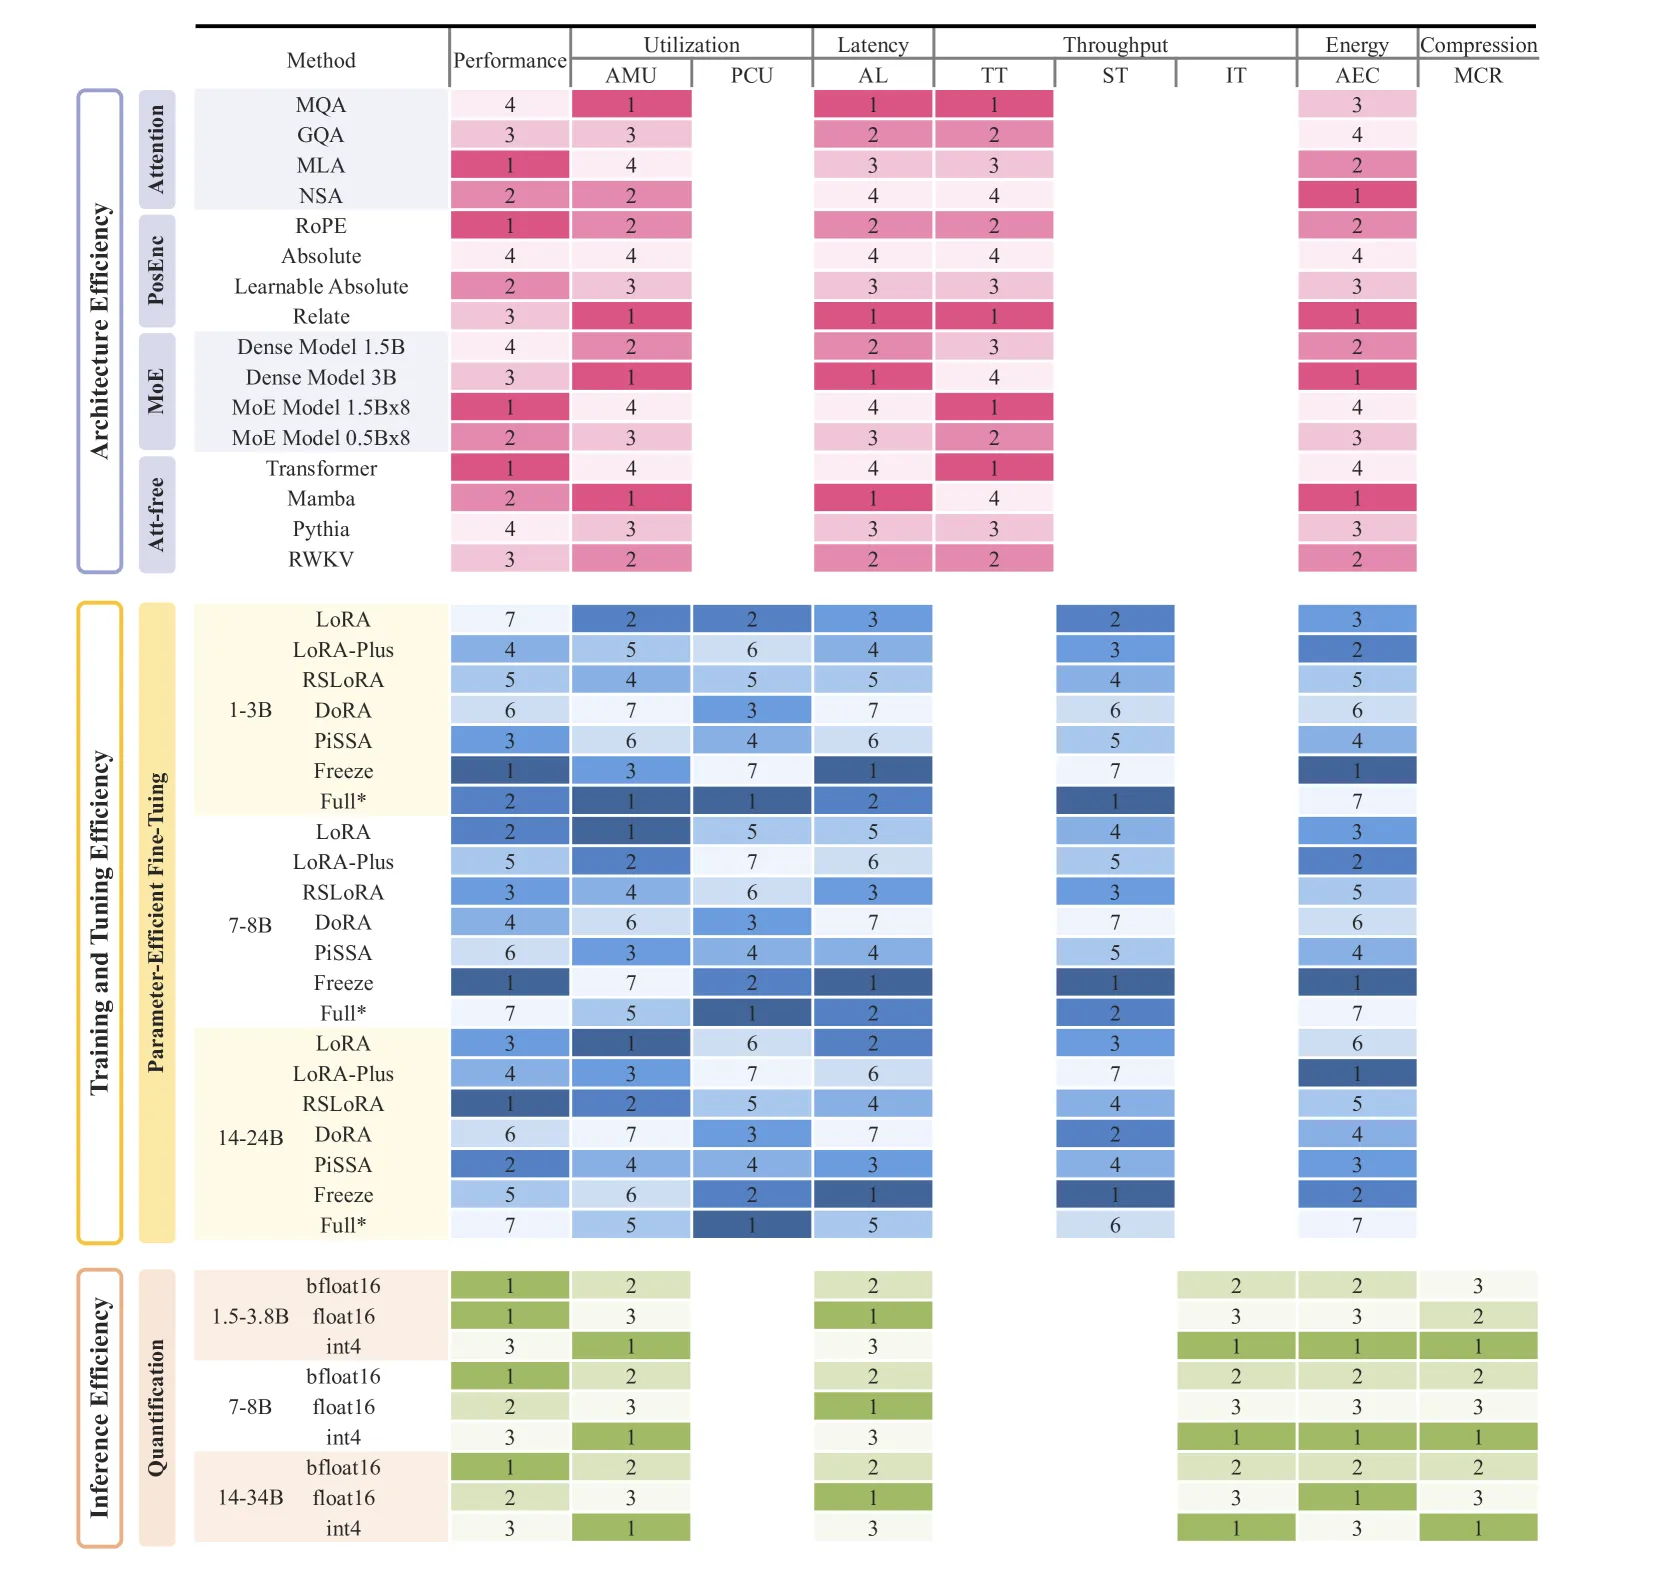
四、核心发现
三大核心洞察
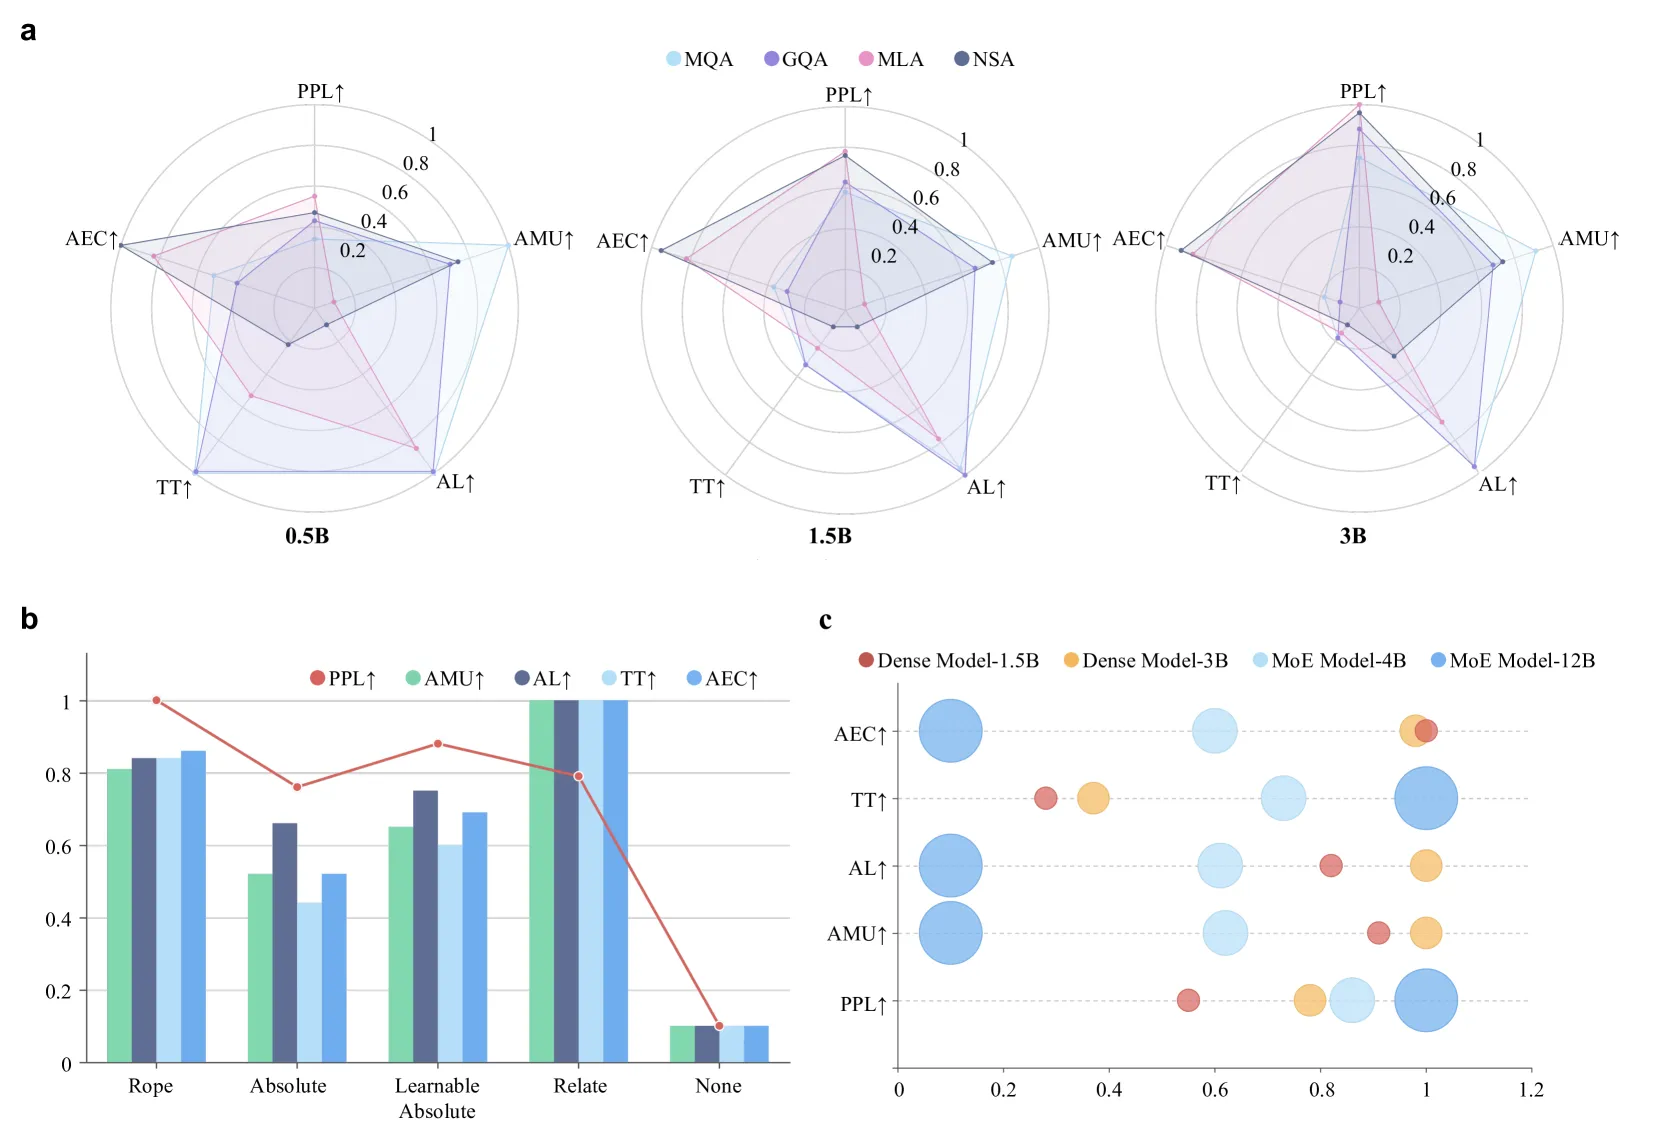
洞察 1:效率涉及可量化的权衡
没有单一方法在所有效率轴上实现帕累托最优。
| 技术 | 优势 | 劣势 |
|---|---|---|
| MoE | 提升精度,降低 FLOPs | VRAM 增加 40% |
| int4 量化 | 内存/能耗降低 3.9x | 精度下降 3-5% |
| MQA | 最佳内存-延迟权衡 | 精度略低 |
| MLA | 最低困惑度 | 内存开销较大 |
洞察 2:最优解依赖任务和规模
| 场景 | 最优技术 | 原因 |
|---|---|---|
| 受限设备 | MQA | 内存-延迟最优 |
| 质量关键任务 | MLA | 最低困惑度 |
| >14B 参数 | RSLoRA | 效率超越 LoRA |
| <14B 参数 | LoRA | 更简单高效 |
洞察 3:技术跨模态泛化
- 视觉模型(Stable Diffusion 3.5, Wan 2.1)
- 视觉语言模型(Qwen2.5-VL)
- 效率技术有效迁移
架构预训练效率
注意力变体对比
| 变量 | MQA | GQA | MLA | NSA |
|---|---|---|---|---|
| 内存效率 | 最高 | 高 | 中 | 高 |
| 延迟 | 最低 | 低 | 中 | 低 |
| 精度 (PPL) | 中 | 中 | 最低 | 中 |
| 能耗 | 低 | 低 | 中 | 最低 |
| 适用场景 | 受限设备 | 通用 | 质量关键 | 能耗敏感 |
MoE 效率分析
| 模型类型 | 参数量 | 激活参数 | FLOPs | VRAM |
|---|---|---|---|---|
| Dense 1.5B | 1.5B | 1.5B | 1.5B | 基线 |
| MoE 1.5B | ~3B | 0.5B | 0.5B | +40% |
| MoE 3B | ~6B | 1B | 1B | +40% |
关键发现:MoE 在预训练中可提升 3.5 个百分点精度,同时将训练 FLOPs 降低 1.8x,但 VRAM 使用增加 40%。
无注意力模型
| 模型 | AMU 变化 | AEC 变化 | PPL 变化 |
|---|---|---|---|
| Mamba | -25% | -25% | +1 |
| RWKV | 最轻内存 | - | - |
| Pythia | - | - | 最低延迟,高 PPL |
微调效率
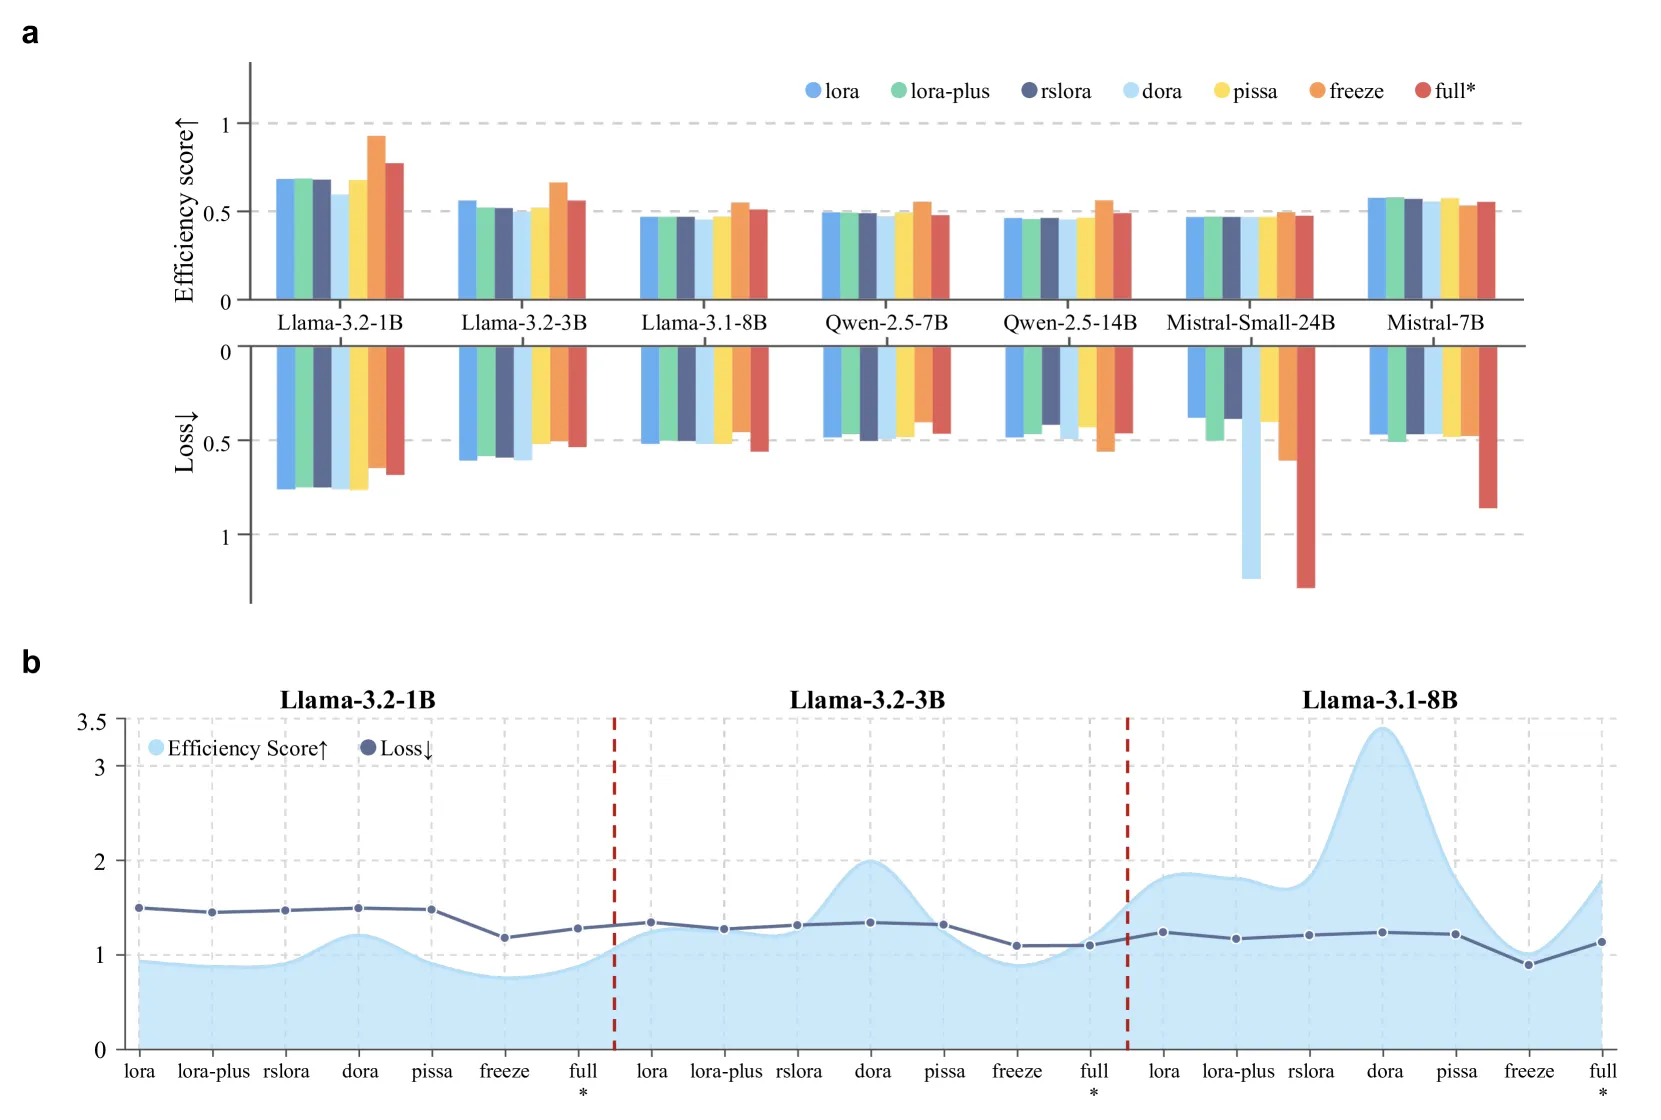
| 方法 | 效率分数 | 损失 | 适用规模 |
|---|---|---|---|
| LoRA | 高 | 中 | <14B |
| RSLoRA | 高 | 中 | >14B |
| DoRA | 中 | 低 | 通用 |
| PISSA | 中 | 中 | 通用 |
| Freeze | 最高 | 高 | 资源受限 |
| Full (DS ZeRO-3) | 低 | 最低 | 资源充足 |
关键发现:
- RSLoRA 仅在 14B+ 参数时超越 LoRA 效率
- LoRA 在小模型上更简单高效
- Full fine-tuning 使用 DeepSpeed ZeRO-3 可训练但资源密集
推理量化效率
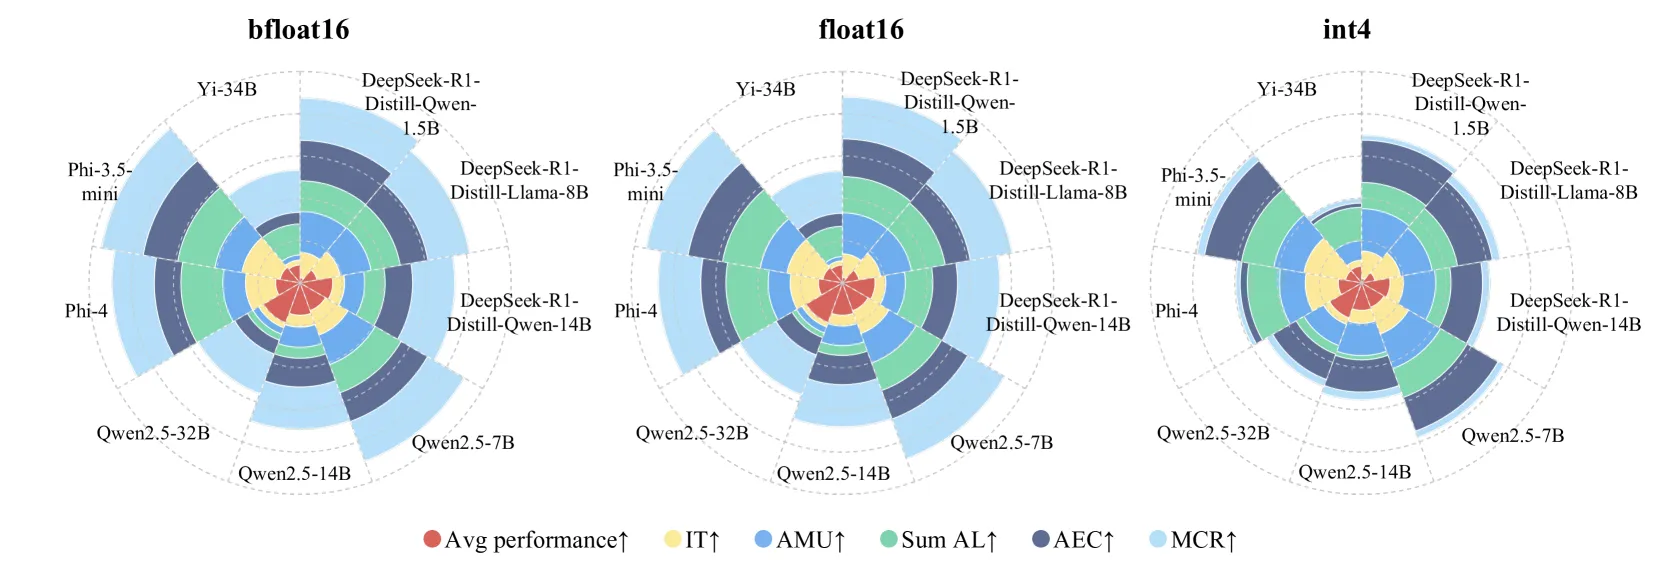
| 量化格式 | 性能 | 吞吐量 | 内存 | 能耗 | 压缩率 |
|---|---|---|---|---|---|
| bfloat16 | 最高 | 低 | 低 | 高 | 1x |
| float16 | 高 | 低 | 低 | 高 | 1x |
| int4 | 中 | 最高 | 最高 | 最低 | 4x |
关键发现:
- bfloat16 性能最佳但资源消耗大
- int4 在吞吐量、内存和压缩方面表现最优
- int4 适合部署受限环境
硬件趋势分析
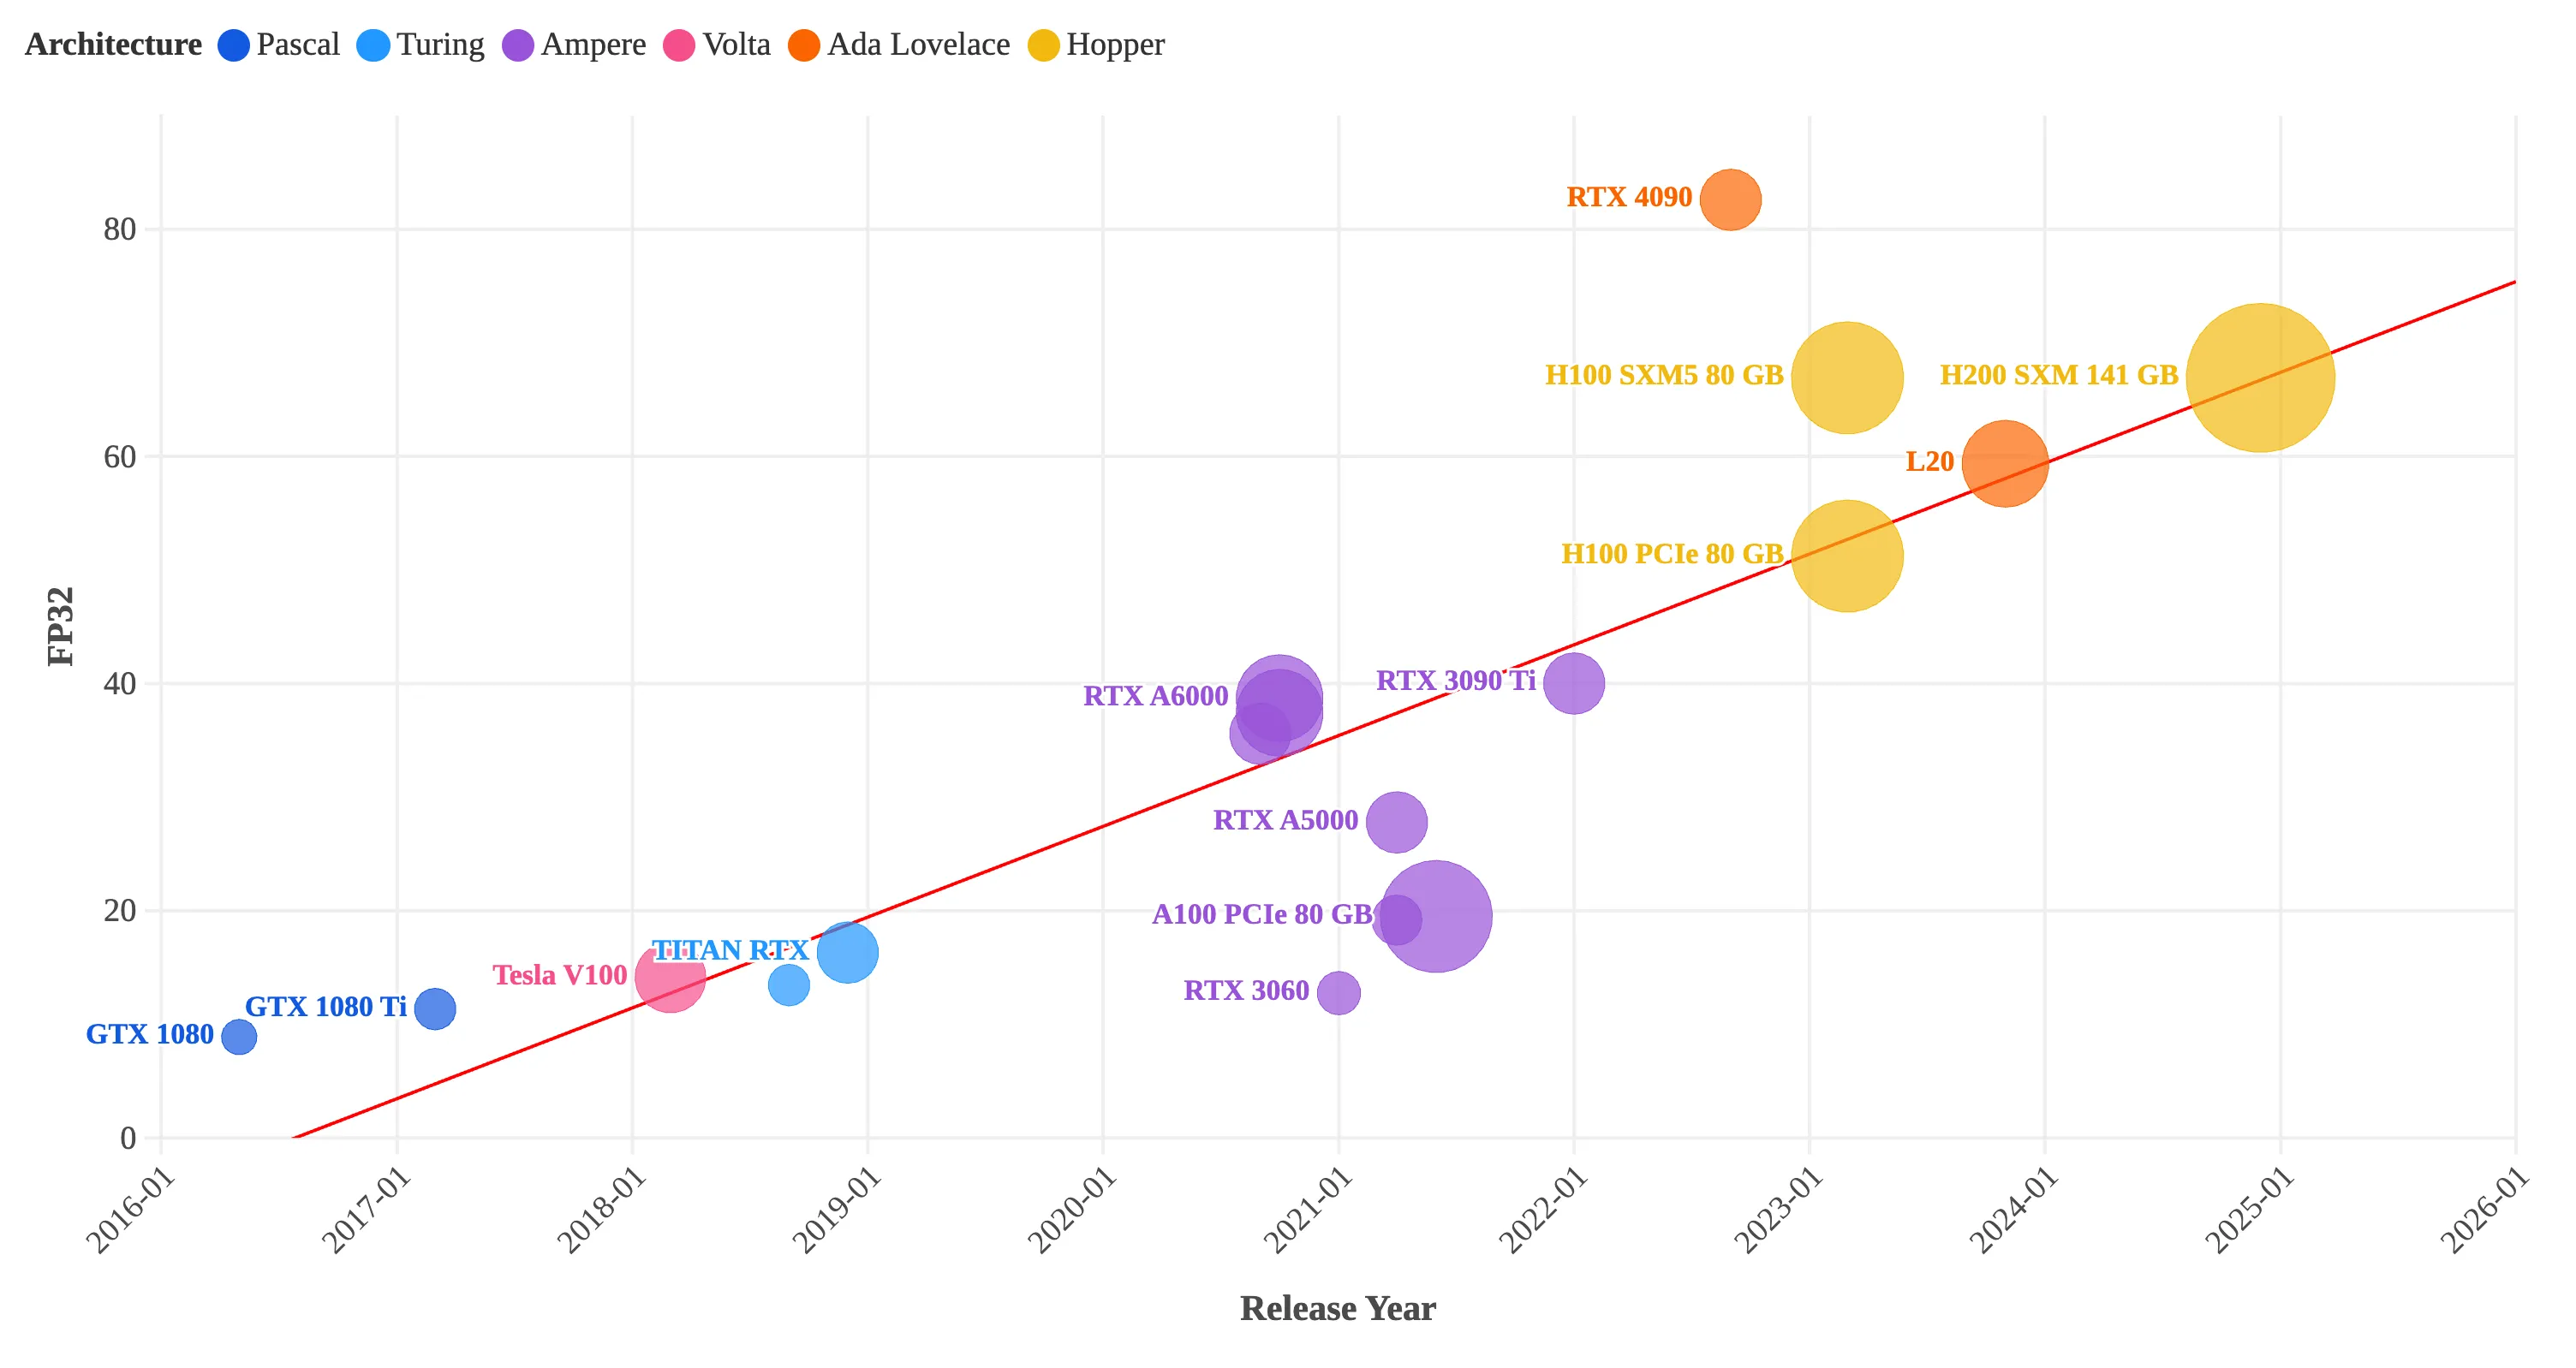
NVIDIA GPU 系列的计算效率和内存容量发展趋势,显示硬件能力持续提升。
LVM/VLM 扩展性分析
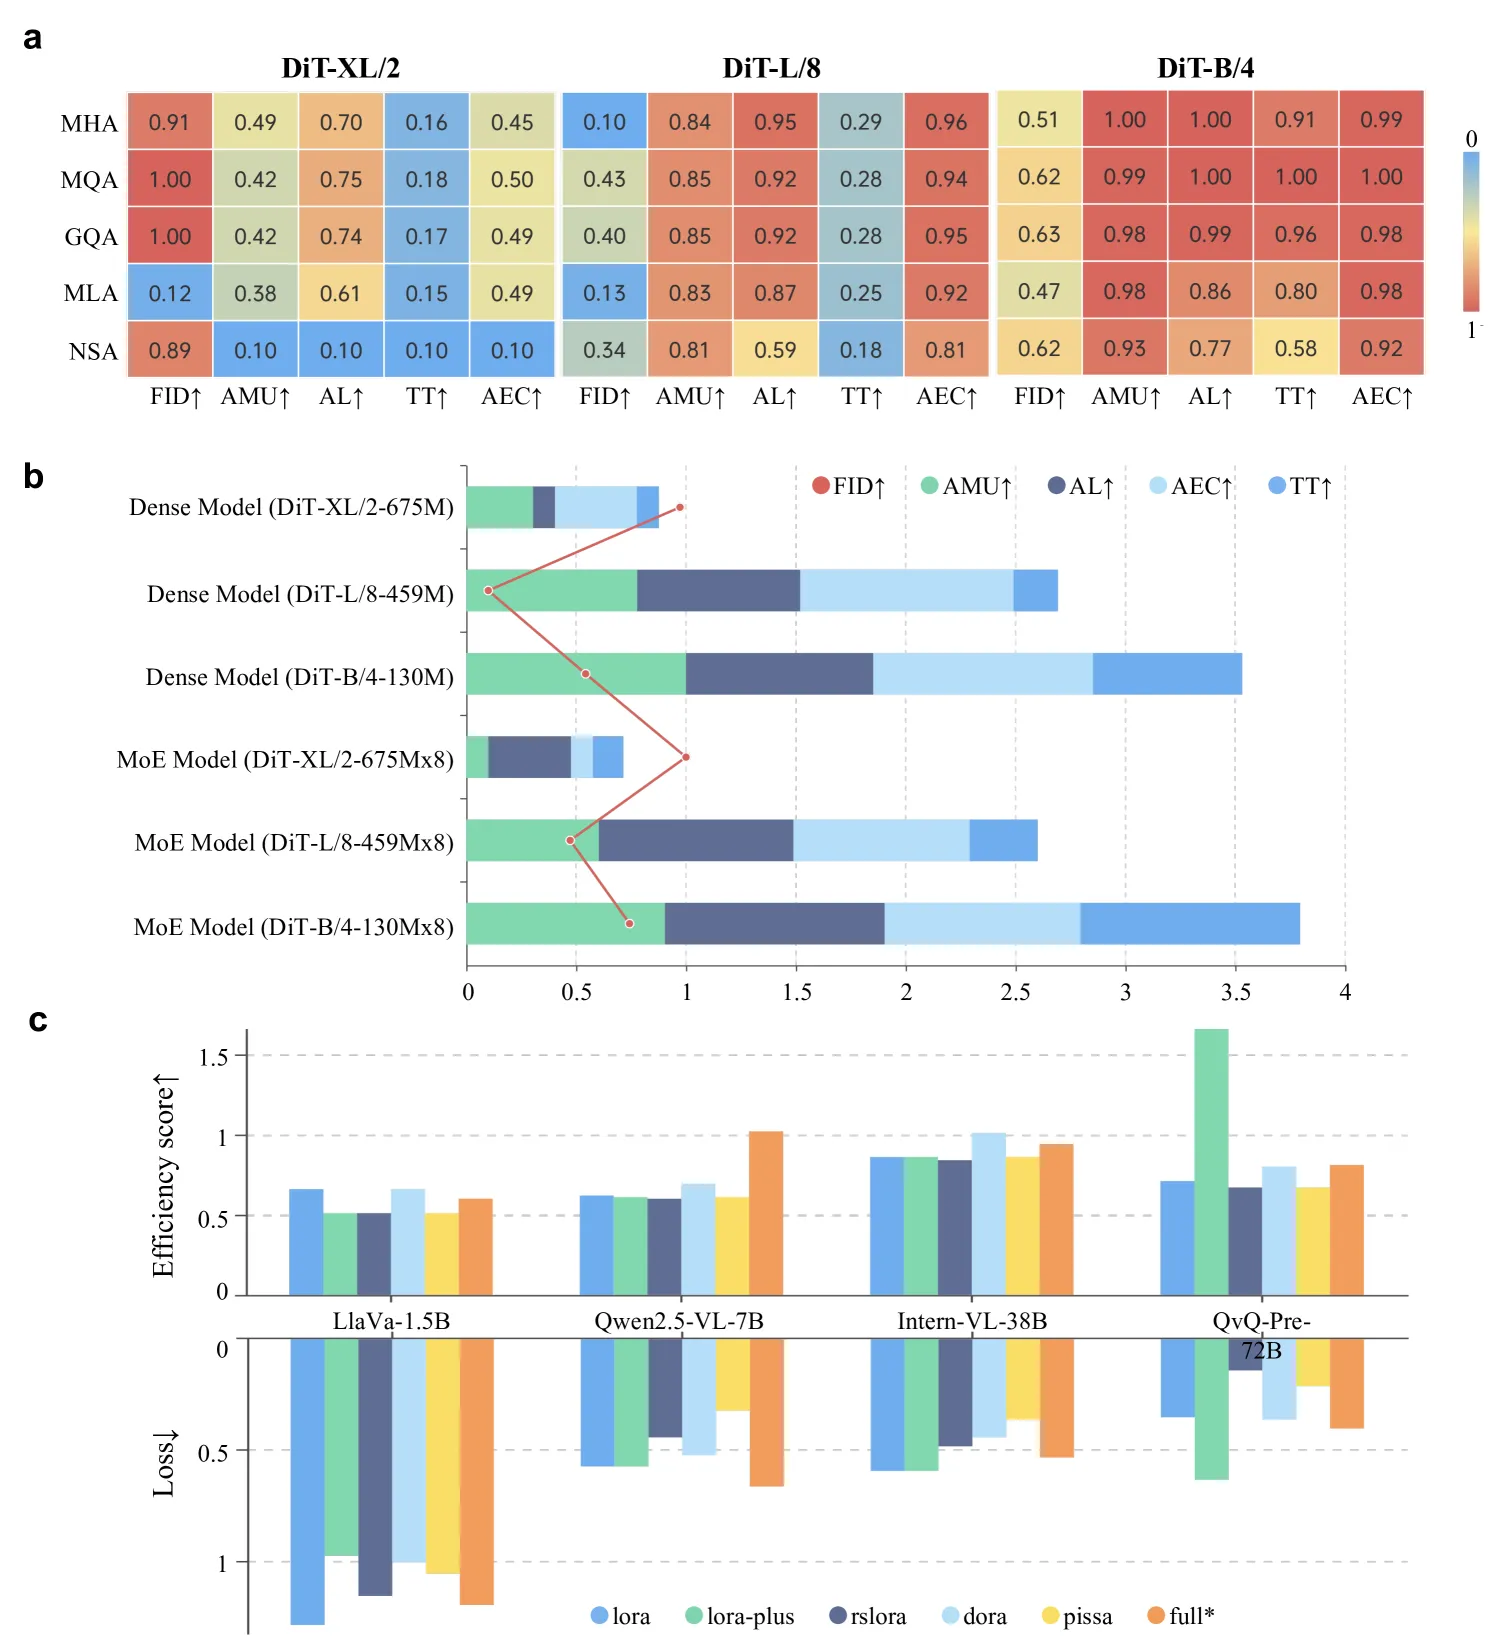
- 效率技术在视觉模型和视觉语言模型中有效迁移
- MoE 在 DiT 架构中同样展现优势
- PEFT 方法在 VLM 中保持高效
五、实验设置
硬件配置
| 组件 | 规格 |
|---|---|
| GPU | 48× NVIDIA GH200 + 8× NVIDIA H200 |
| 总 GPU 数 | 56 |
| GPU 类型 | 生产级集群 |
评估模型
| 模型家族 | 参数范围 | 用途 |
|---|---|---|
| LLaMA-3.2 | 1B, 3B | 架构预训练 |
| LLaMA-3.1 | 8B | 架构预训练 |
| Qwen-2.5 | 7B, 14B | 微调评估 |
| Mistral | 7B, Small-24B | 微调评估 |
| DeepSeek | 多规模 | 量化评估 |
| Phi | 多规模 | 量化评估 |
| Yi | 多规模 | 量化评估 |
评估数据集
| 数据集 | 用途 |
|---|---|
| O1-SFT | 微调训练 |
| MMLU | 多任务理解 |
| HellaSwag | 常识推理 |
| ARC | 科学推理 |
| WinoGrande | 常识推理 |
| GSM8K | 数学推理 |
评估流程
- 预训练阶段:评估注意力变体、位置编码、MoE、无注意力模型
- 微调阶段:评估 LoRA、RSLoRA、DoRA、PISSA、Freeze、Full
- 推理阶段:评估 int4、float16、bfloat16 量化
六、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个统一效率基准 | 跨架构/微调/推理三维度的系统评估 | 100+ 模型-技术组合 |
| 6 细粒度指标 | 内存/计算/延迟/吞吐/能耗/压缩 | 生产级集群实测 |
| 跨模态验证 | LLM → LVM → VLM 的效率迁移 | Stable Diffusion, Wan 2.1, Qwen2.5-VL |
| 开源生态 | 数据集、评估流程、排行榜 | 可复现性 |
七、相关工作
| 工作 | 重点 | 本文差异 |
|---|---|---|
| LLM Efficiency Survey (2023) | 综述效率技术 | 本文提供大规模实证评估 |
| HELM (2022) | 全面性能评估 | 本文专注于效率维度 |
| Open LLM Leaderboard | 开源模型排名 | 本文定义效率指标 |
| Chinchilla (2022) | 计算最优缩放 | 本文覆盖更多效率技术 |
八、总结
核心贡献
- 建立 EfficientLLM 基准:首个全面评估 LLM 效率的大规模基准测试
- 量化效率权衡:通过 100+ 实验揭示效率-性能的可量化权衡关系
- 发现任务/规模依赖性:最优技术因任务和模型规模而异
- 验证跨模态泛化:效率技术在 LVM/VLM 中有效迁移
- 开源评估生态:提供数据集、流程和排行榜
技术影响
- 研究指导:为 LLM 效率研究提供实证基础
- 工程实践:为模型选择和部署提供决策依据
- 标准化:建立统一的效率评估指标体系
- 跨领域应用:验证效率技术在多模态模型中的泛化性
局限性
- 硬件特定:评估基于 NVIDIA GPU,其他硬件平台未覆盖
- 规模限制:最大模型为 72B,未扩展到 100B+
- 任务覆盖:主要评估 NLP 任务,代码/数学等任务较少
- 动态性:技术快速发展,部分结论可能随新方法出现而变化
- 能耗测量:基于软件估计而非硬件直接测量
九、参考资源
- 论文: arXiv:2505.13840
- 相关基准:
- HELM (Stanford) - 全面性能评估
- Open LLM Leaderboard (Hugging Face) - 开源模型排名
- LMSYS Chatbot Arena - 人类偏好评估
- 关键系统:
- DeepSpeed (Microsoft) - 分布式训练
- Megatron-LM (NVIDIA) - 大规模训练框架
- FlashAttention (Tri Dao) - 高效注意力内核
- LoRA (Hu et al., 2021) - 参数高效微调
- 开源项目: