SageAttention3: Microscaling FP4 Attention for Inference and An Exploration of 8-Bit Training
首个 FP4 微缩放注意力推理加速与 INT8 可训练注意力探索
SageAttention3: Microscaling FP4 Attention for Inference and An Exploration of 8-Bit Training
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SageAttention3: Microscaling FP4 Attention for Inference and An Exploration of 8-Bit Training |
| 作者 | Jintao Zhang*, Jia Wei*, Pengle Zhang, Xiaoming Xu, Haofeng Huang, Haoxu Wang, Kai Jiang, Jun Zhu, Jianfei Chen |
| 机构 | 清华大学计算机系、智能技术与系统国家重点实验室、交叉信息研究中心、THBI Lab、清华-博世联合机器学习中心;声水科技 |
| 论文 | https://arxiv.org/abs/2505.11594 |
| 代码 | https://github.com/thu-ml/SageAttention |
| 发表 | NeurIPS 2025 |
| 前置工作 | SageAttention (ICLR 2025), SageAttention2 (ICML 2025), SpargeAttn (ICML 2025) |
核心贡献:
- 设计了首个 FP4 微缩放注意力(SageAttention3),利用 Blackwell GPU 的 FP4 Tensor Cores,在 RTX5090 上实现 1038 TOPS,较 FlashAttention2 提速 5×
- 首次探索低比特注意力用于训练(SageBwd):在指令微调任务中实现无损性能,但在预训练中收敛较慢
- 提出两级量化 P 矩阵策略,将 E4M3 范围利用率从 35 个值提升到 127 个值
- 证明 INT8 比 FP8 更适合训练,梯度精度更高且硬件支持更广
二、核心思想
问题定义
注意力计算 具有二次时间复杂度 ,是生成模型的瓶颈。现有低比特注意力工作(FlashAttention3、SageAttention)仅针对推理优化,未探索训练场景。同时,Blackwell GPU 引入了新的 FP4 Tensor Cores,但直接应用 FP4 量化面临严重精度损失。
解决方案概述
| 方向 | 方法 | 用途 | 精度 |
|---|---|---|---|
| SageAttention3 | FP4 微缩放量化 + 两级 P 缩放 | 推理加速 | NVFP4 E2M1 + E4M3 缩放因子 (FP8) |
| SageBwd | INT8 逐块量化 + FP16 关键路径 | 训练加速(前向+反向) | INT8 per-block |
三大技术挑战
-
C1 — FP4 值域严重受限:FP4 仅有 15 个可表示值,逐张量或逐 token 量化均不足以保持模型精度。通过约束量化组大小为 1×16(而非逐张量或逐通道),有效容纳每个 block 内的异常值效应。
-
C2 — P 矩阵缩放因子范围极窄: 的值在 [0, 1] 范围内(online softmax 结果),直接量化到 FP4 导致缩放因子进入 0~0.167 的极窄动态范围()。而硬件要求缩放因子使用 FP8(E4M3)格式,造成显著精度损失。
-
C3 — 训练时注意力梯度对量化误差敏感:反向传播中 的精度直接影响 和 ,误差会在 FlashAttention 反向传播过程中沿序列长度递归累积到 和 ,序列越长误差越大。
三、技术架构
整体框架
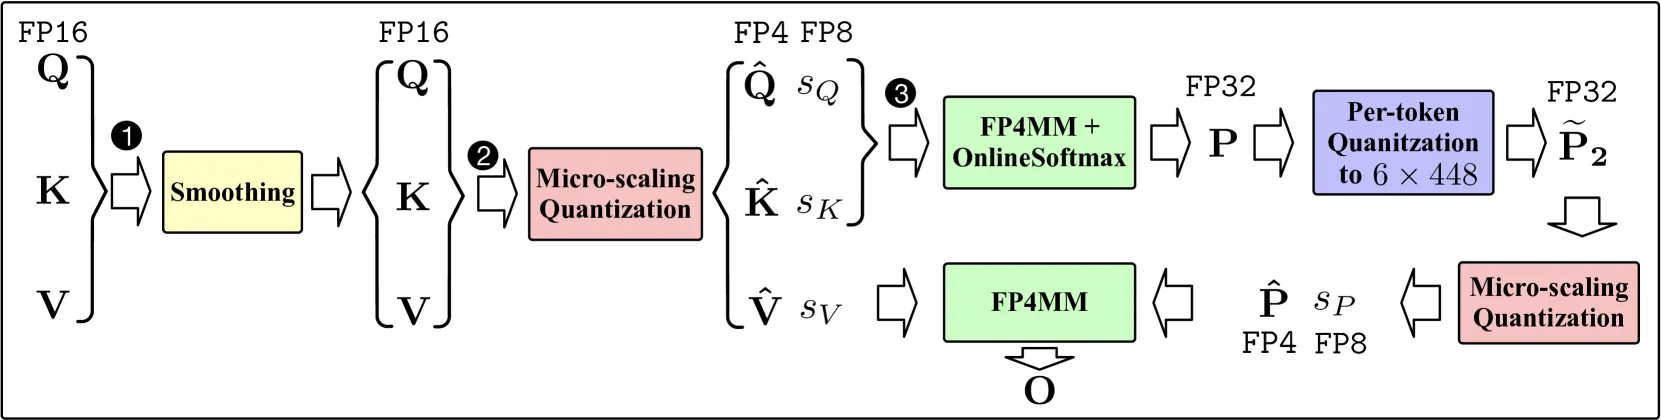
SageAttention3 基于 FlashAttention 的 tiling 策略,将 Q 分为 个块 ,将 K、V 分为 个块 。使用在线 softmax 避免对完整的 矩阵 S 和 P 进行大量全局内存 I/O。
核心公式
FlashAttention 在线 Softmax 基础
其中 和 是 向量,初始化为 和 。
FP4 微缩放量化(Section 3.1)
对于矩阵 ,将其划分为 块 :
其中 表示 FP4 rounding。每个 块对应一个缩放因子 。
FP4 数据格式选择:
| 格式 | 数据类型 | 块大小 | 缩放因子格式 |
|---|---|---|---|
| NVFP4 | E2M1 | 1×16 | E4M3 (FP8) |
| MXFP4 | E2M1 | 1×32 | E8M0 |
选择 NVFP4 的原因:CogVideoX 全层精度对比显示 NVFP4 CosSim 为 99.52%,MXFP4 仅为 98.37%。
FP4 微缩放矩阵乘法
RTX5090 上 FP4 MM 速度约 1600 TOPS,是 FP32 GEMM(约 200 TOPS)的 8 倍:
注意力计算全流程
两级 P 缩放(Section 3.2)
由于 每块内值落在 [0, 1] 范围,缩放因子 的范围仅为 0~0.167。E4M3 FP8 格式在此极窄范围内表示效率极低。两级量化策略:
第一级:逐 token 归一化到 [0, 448×6] 范围:
第二级:标准 FP4 微缩放:
重构:
其中 , , 为 FP32,, 为 FP8,, 为 FP4。
理论分析(Appendix A.10):
- 直接量化:E4M3 缩放因子有 35 个可表示值,输出可表示值为
- 两级量化:E4M3 缩放因子有 127 个可表示值,输出可表示值为
- 量化间隔更细:,因此
INT8 前向传播(Algorithm 2)
INT8 逐块量化:
前向过程中对 采用 Smoothing K + per-block INT8 量化;对 采用 per-token INT8 量化(而非静态 per-block),因为静态 per-block 缩放因子 不够准确。同时复用 online softmax 中的全局和局部最大值消除显式的 max 操作。
INT8 反向传播(Algorithm 3)
反向传播包含五个矩阵乘法:
关键发现:是否对 进行量化对 、 的精度影响最大。这是因为 的精度直接决定 和 的精度,而 的精度损失会在 FlashAttention 反向传播的沿序列长度递归过程中持续累积到 和 。
策略:保持 为 FP16,其余四个矩阵乘法使用 INT8 per-block 量化:
其中 。
量化误差评估指标
| 指标 | 公式 | 说明 |
|---|---|---|
| CosSim | 余弦相似度,越接近 100% 越好 | |
| L1 | $\sum | O-O’ |
| RMSE | 均方根误差,越小越好 |
完整算法流程(Algorithm 1 — FP4 注意力)
Input: Q(FP16), K(FP16), V(FP16) ∈ ℝ^(N×d), block size Bq, Bkv

Preprocessing: K ← K - mean(K)                          // Smoothing K (SageAttention)
Divide Q → {Qi} (Tm=N/Bq blocks); divide K,V → {Ki},{Vi} (Tn=N/Bkv blocks)

for i = 1 to Tm do
  qi_bar = mean(Qi)                                     // Smoothing Q (SageAttention2)
  (sQ, Q̂i) = φ(Qi - qi_bar)
  for j = 1 to Tn do
    (sK, K̂j) = φ(Kj^⊤),   (sV, V̂j) = φ(Vj)
    // Smoothed Q: FP4MM on quantized part + GEMV on mean part
    Sij = FP4MM(Q̂i, sQ, K̂j, sK) + GEMV(qi_bar, Kj^⊤)
    mij = max(mi,j-1, rowmax(Sij))
    P̃ij = exp(Sij - mij)
    lij = e^(mi,j-1 - mij) * li,j-1 + rowsum(P̃ij)
    // Two-level quantization for P
    sP1 = rowmax(P̃ij) / (448 × 6), P̃2 = P̃ij / sP1
    (sP2, P̂2ij) = φ(P̃2)
    Oij = diag(e^(mi,j-1 - mij))^(-1) * Oi,j-1
        + FP4MM(P̂2ij, sP2, V̂j, sV) × sP1
  end
  Oi = diag(li,Tn)^(-1) * Oi,Tn
end
return O = {Oi}
模型组件总览
| 组件 | 说明 | 关键参数/细节 |
|---|---|---|
| NVFP4 微缩放 | E2M1 数据格式,1×16 块,E4M3 FP8 缩放因子 | 15 个可表示值 |
| MXFP4 微缩放 | E2M1 数据格式,1×32 块,E8M0 缩放因子 | 对比基线 |
| 两级 P 量化 | 第一级逐 token 归一化到 [0, 448×6],第二级 FP4 微缩放 | FP32 中间精度 |
| Smoothing K | K 矩阵去均值(来自 SageAttention) | K = K - mean(K) |
| Smoothing Q | Q 块去均值(来自 SageAttention2) | Qi = Qi - mean(Qi) |
| INT8 Per-block | 逐块量化,缩放因子 $\max( | \mathbf{X} |
| INT8 Per-token | 逐 token 量化 P 矩阵 | 用于前向 PV 乘法 |
| FP16 关键路径 | 保持 FP16 | 防止梯度累积误差 |
硬件实现优化(Section 3.3)
1. K 矩阵置换
FP32 累加器的寄存器布局与操作数 A 的寄存器布局不同(见 Fig. 19-20)。执行 thread shuffle 来匹配操作数 A 的布局会导致内核性能退化。
解决方案:通过置换 P tile 的列来变换累加器布局(Fig. 21),同时相应地重新排列 K 的列以保持矩阵乘法正确性。该操作可融合到 K 量化核中,无额外开销。
2. 复用 Shuffle
在 kernel 内对 进行微缩放量化需要找到 16 个连续行元素的最大值。但这 16 个元素分布在四个线程中,需要线程内最大值归约 + 线程间 shuffle,显著降低内核速度。
优化:将量化与 online softmax 融合——online softmax 已计算行最大值,直接复用即可。减少约 50% 冗余 shuffle 和 max 操作,整体内核提速 ~10%。
3. Producer Warp Epilogue
在传统 warp-specialized kernel 中,consumer warps 负责 MatMul 和存储,producer 仅加载输入。但由于寄存器约束,FP4 attention kernel 无法采用此方案。
创新方案:在 producer warps 之间实现 ping-pong 调度——当一个 producer 加载下一个 MatMul 的输入时,另一个 producer 同时将输出存储到全局内存。Consumer warps 仅负责将 MatMul 结果从寄存器传输到共享内存。此设计在寄存器约束下实现了 MatMul 与全局内存存储的重叠。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个 FP4 注意力 | 利用 Blackwell GPU FP4 Tensor Cores,推理速度达 1038 TOPS | RTX5090 上 5× over FA2,CosSim 99.55% |
| NVFP4 vs MXFP4 | NVFP4 (1×16 块, E4M3 缩放) 精度远高于 MXFP4 (1×32 块, E8M0 缩放) | CogVideoX 全层 CosSim: 99.52% vs 98.37% (Table 1a) |
| 两级 P 量化 | 将 E4M3 范围利用率从 35 个值提升到 127 个值 | 理论证明 ;CosSim 93.32%→99.52% (Table 1b) |
| dOV^⊤ 保持 FP16 | 最敏感的矩阵乘法不量化,防止梯度累积误差 | CosSim 97.47%→99.77%;RMSE 2.440→0.692 (Table 1c) |
| 首个可训练低比特注意力 | 6/7 矩阵乘法 INT8 量化,微调无损 | Qwen2.5-3B: GSM8K 0.607 vs BF16 0.601 |
| INT8 > FP8 训练 | INT8 梯度精度更高,硬件支持更广 | dQ L1 error: 0.0290 vs 0.0696;支持 A100/MI250/Ascend |
| Smoothing Q+K | 结合两代 smoothing 技术提升 FP4 量化精度 | CosSim 从 0.9156 提升到 0.9912 |
| HilbertCurve 排列(SpargeAttn 协同) | 空间填充曲线提升图像/视频模型的块自相似性 | Sim-q=0.572, Sim-k=0.479 (Table 4) |
五、代码实现分析
实现技术栈:
- SageAttention3: CUTLASS + CUDA(手写内核,基于 FP4MM 指令)
- SageBwd: OpenAI Triton(便于快速迭代,但存在性能差距)
关键文件结构(GitHub: thu-ml/SageAttention):
- FP4 内核基于 CUTLASS 的 FP4MM 指令构建
- 8-bit 训练注意力基于 Triton 实现
- 两阶段掩码生成逻辑
- Smoothing Q/K 预处理
六、实验结果
内核速度对比
RTX5090(head dim=128, causal=True):
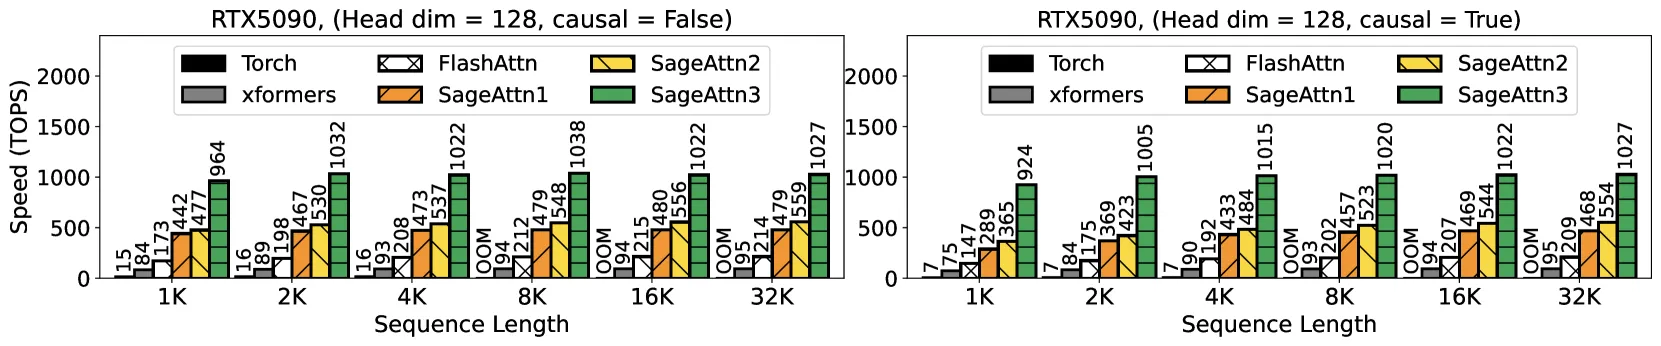
| 方法 | TOPS on 5090 | TOPS on H100 | CosSim |
|---|---|---|---|
| FlashAttention2 | 214 | 338 | 100.000% |
| FlashAttention3 (16bit) | N/A | 470 | 100.000% |
| FlashAttention3 (8bit) | N/A | 890 | 98.570% |
| SageAttention1 | 479 | 518 | 99.996% |
| SageAttention2 (8bit) | 643 | 885 | 99.995% |
| SageAttention3 (4bit) | 1038 | N/A | 99.551% |
SageAttention3 较 FlashAttention2 提速 ~4.85×,较 xformers 提速 ~11×。
RTX5090(head dim=64): 趋势一致,SageAttention3 在短维度下优势更明显(Fig. 5)。
SageBwd 速度对比(RTX4090): SageBwd 前向传播最高提速 2×,反向传播提速 1.2~1.6×(Appendix Fig. 15-18)。
端到端推理指标
文本到视频模型(Table 2):
| 模型 | 方法 | CLIPSIM↑ | CLIP-T↑ | VQA-a↑ | VQA-t↑ | FScore↑ |
|---|---|---|---|---|---|---|
| CogVideoX | Full-Precision | 0.1865 | 0.9968 | 70.476 | 69.875 | 4.780 |
| CogVideoX | SageAttn2 (8bit) | 0.1880 | 0.9969 | 69.414 | 70.750 | 4.534 |
| CogVideoX | SageAttn3 (4bit) | 0.1881 | 0.9969 | 69.860 | 70.364 | 4.035 |
| HunyuanVideo | Full-Precision | 0.1838 | 0.9993 | 68.998 | 78.891 | 1.4793 |
| HunyuanVideo | SageAttn2 (8bit) | 0.1836 | 0.9993 | 69.497 | 77.019 | 1.4741 |
| HunyuanVideo | SageAttn3 (4bit) | 0.1866 | 0.9993 | 70.552 | 75.440 | 1.232 |
| Mochi | Full-Precision | 0.1828 | 0.9990 | 61.9840 | 61.0000 | 1.8042 |
| Mochi | SageAttn2 (8bit) | 0.1819 | 0.9990 | 61.0093 | 60.3732 | 1.7539 |
| Mochi | SageAttn3 (4bit) | 0.1800 | 0.9993 | 61.863 | 59.429 | 1.649 |
文本到图像模型(Table 2):
| 模型 | 方法 | FID↓ | sFID↓ | CLIP↑ | IR↑ |
|---|---|---|---|---|---|
| Flux | Full-Precision | 162.812 | 146.980 | 31.409 | 0.91 |
| Flux | SageAttn2 (8bit) | 163.107 | 146.213 | 31.436 | 0.90 |
| Flux | SageAttn3 (4bit) | 162.121 | 142.839 | 31.450 | 0.94 |
| SD3.5 | Full-Precision | 166.421 | 146.379 | 31.93 | 0.93 |
| SD3.5 | SageAttn2 (8bit) | 164.986 | 148.557 | 32.01 | 0.93 |
| SD3.5 | SageAttn3 (4bit) | 166.102 | 145.587 | 32.01 | 0.92 |
SageAttention3 在所有模型上几乎无损,部分指标甚至优于全精度(如 Flux 的 FID 从 162.812 降至 162.121)。
端到端速度提升(Table 4)
(a) 推理延迟:
| 模型 | 原始 | Sage1 | Sage2 | Sage3 |
|---|---|---|---|---|
| CogVideoX (2B) | 64 s | 55 s | 46 s | 27 s (~2.4×) |
| HunyuanVideo | 489 s | 257 s | 240 s | 164 s (~3×) |
(b) 训练延迟:
| 模型 | 原始 | SageBwd |
|---|---|---|
| Llama (8K) | 2.1 s | 1.9 s (~1.15×) |
| Llama (16K) | 6.0 s | 5.2 s (~1.15×) |
微调性能对比(Table 3)
| 模型 | 方法 | GSM8K | DROP(F1) | MMLU | HellaSwag |
|---|---|---|---|---|---|
| Qwen2.5 (1.5B) | BF16 | 0.521 | 0.733 | 0.569 | 0.905 |
| Qwen2.5 (1.5B) | SageBwd | 0.520 | 0.734 | 0.574 | 0.911 |
| Qwen2.5 (3B) | BF16 | 0.601 | 0.785 | 0.640 | 0.944 |
| Qwen2.5 (3B) | SageBwd | 0.607 | 0.782 | 0.653 | 0.943 |
| Llama3.2 (1B) | BF16 | 0.259 | 0.641 | 0.464 | 0.828 |
| Llama3.2 (1B) | SageBwd | 0.268 | 0.637 | 0.458 | 0.823 |
多随机种子实验(Appendix Tables 5-10)进一步验证:SageBwd 在各种子下的平均性能与 BF16 高度一致,标准差几乎相同(如 Qwen2.5-1.5B GSM8K: SageBwd 0.5077±0.0090 vs BF16 0.5081±0.0089)。
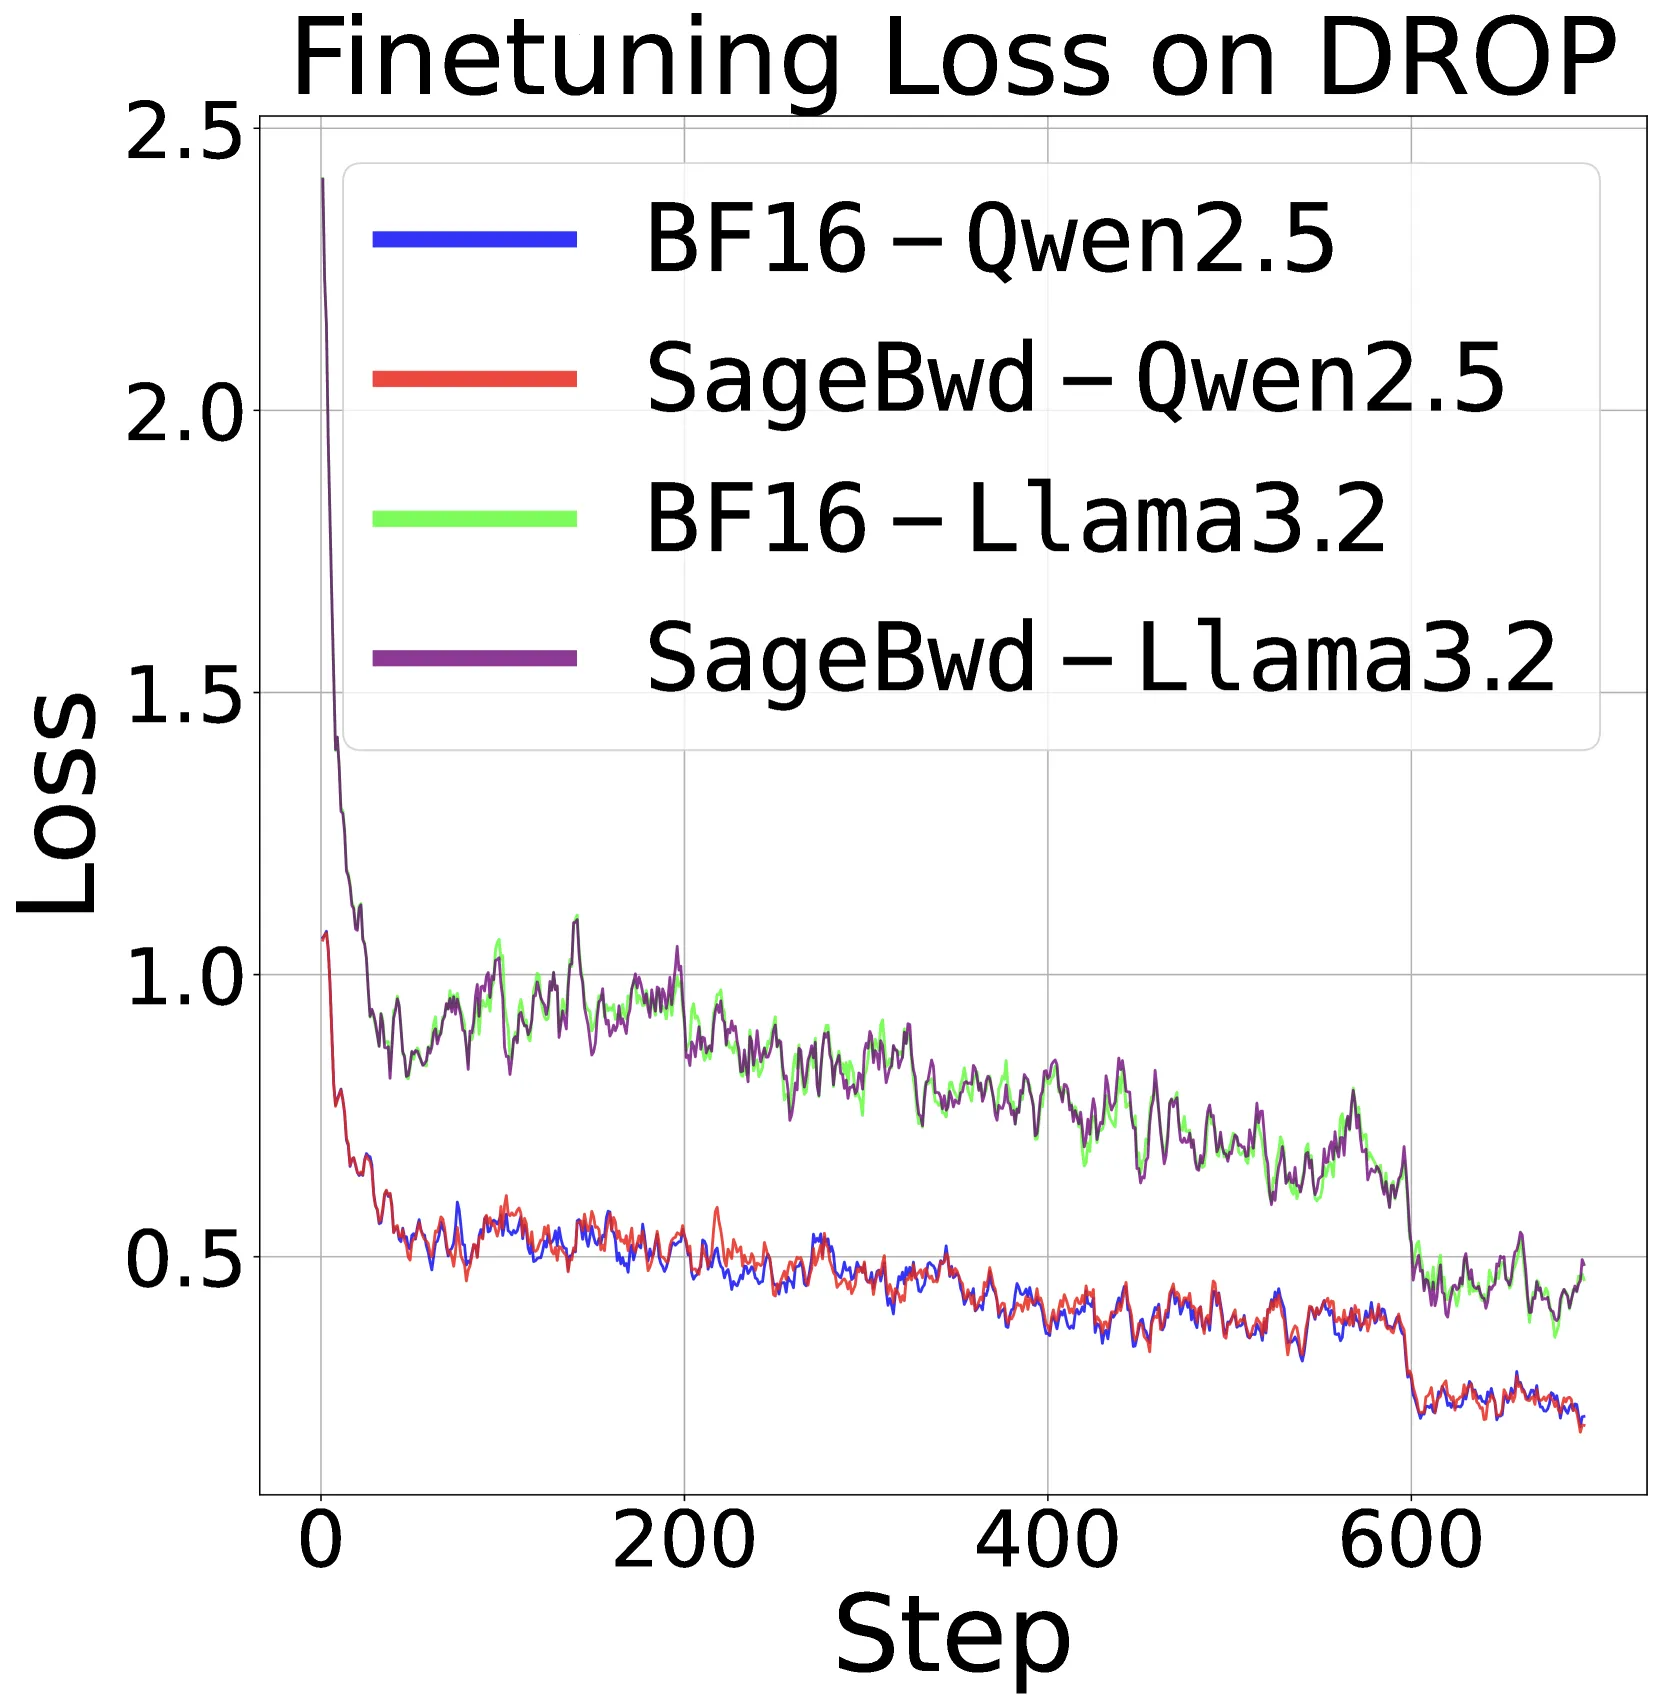
预训练 vs 微调(Fig. 8)
- 微调(700 steps, lr=3e-5, warmup 100, batch=32/128):SageBwd 损失曲线与 BF16 完全对齐,各数据集标准差几乎相同
- 预训练(FineWeb-Edu, 400M 模型, lr=1e-3, warmup 1000, 2M tokens/step):SageBwd 可以收敛但速度较慢,目前不适用于预训练
组合使用 SageBwd + SageAttention3
先 INT8 微调再 FP4 推理的效果优于 BF16 微调 + FP4 推理:
| 模型 | 方法 | GSM8K | MMLU |
|---|---|---|---|
| Qwen2.5-1.5B | BF16 微调 | 0.4912 | 0.4688 |
| Qwen2.5-1.5B | SageBwd 微调 | 0.5232 | 0.4934 |
| Qwen2.5-3B | BF16 微调 | 0.5860 | 0.6000 |
| Qwen2.5-3B | SageBwd 微调 | 0.5945 | 0.6032 |
可视化对比
SageAttention3 生成的视频和图像与全精度方法视觉质量一致。附录中还提供了更多定性示例(Fig. 10-11: Flux/SD3.5 图像生成; Fig. 13-14: CogVideoX/HunyuanVideo 视频生成; Fig. 12: 两级量化 vs 直接量化的 CogVideoX 生成对比)。
七、消融研究
平滑技术消融
| 方法 | CosSim↑ | L1 Error↓ | RMSE↓ |
|---|---|---|---|
| None | 0.9156 | 0.3359 | 0.3035 |
| SmoothQuant | 0.9301 | 0.2676 | 0.2529 |
| Hadamard | 0.9412 | 0.2620 | 0.2240 |
| Smoothing_Q | 0.9828 | 0.1157 | 0.1259 |
| Smoothing_K | 0.9912 | 0.0948 | 0.0977 |
结合 Smoothing_Q 和 Smoothing_K 效果最佳,CosSim 从 0.9156 提升到 0.9912。
层级量化误差累积
| 方法 | Layer1 L1 | Layer10 L1 | Layer20 L1 | Layer30 L1 |
|---|---|---|---|---|
| 直接使用 SageAttention3 | 0.0076 | 0.0922 | 0.1146 | 0.0571 |
| 保留 3 个最敏感层在 FP16 | 0.0076 | 0.0447 | 0.0773 | 0.0429 |
累积误差一般随层深增加而增大,深层偶尔出现部分误差抵消。保留最敏感的三层在 FP16 可显著降低整体误差。
不同 FP4 格式对比(Table 1a)
| Type | CosSim↑ | L1↓ | RMSE↓ |
|---|---|---|---|
| MXFP4 | 98.37% | 0.294 | 0.994 |
| NVFP4 | 99.52% | 0.077 | 0.201 |
不同 P 缩放策略对比(Table 1b)
| Method | CosSim | L1 | RMSE |
|---|---|---|---|
| Direct | 93.32% | 0.193 | 1.103 |
| Two-level | 99.52% | 0.077 | 0.201 |
dOV^⊤ 数据类型对比(Table 1c)
| Method | CosSim | L1 | RMSE |
|---|---|---|---|
| INT8 | 97.47% | 0.171 | 2.440 |
| FP16 | 99.77% | 0.039 | 0.692 |
INT8 vs FP8 训练对比
| 指标 | INT8 SageBwd | FP8 SageBwd |
|---|---|---|
| dQ L1 error | 0.0290 | 0.0696 |
| dK L1 error | 0.0317 | 0.0999 |
| dV L1 error | 0.0423 | 0.0873 |
| dQ CosSim | 0.9987 | 0.9880 |
| dK CosSim | 0.9993 | 0.9910 |
| dV CosSim | 0.9995 | 0.9955 |
INT8 选择原因:(1) 更高的梯度精度 (2) 更广泛的硬件支持(A100、AMD MI250、Ascend 910B)。
理论吞吐对比(Appendix A.8)
| 方法 | B300 TOPS | B200 TOPS | RTX5090 TOPS |
|---|---|---|---|
| FlashAttention3 | 2500 | 2500 | 209.5 |
| FlashAttention3 (FP8) | 5000 | 5000 | 419 |
| SageAttention3 (FP4) | 15000 | 10000 | 1676 |
多随机种子消融(Appendix A.4, Tables 5-10)
在 Qwen2.5 (1.5B/3B) 和 Llama3.2 (1B/3B) 上,使用 5 个不同随机种子(42, 233, 1234, 5678, 11)分别微调后评估:
- SageBwd 与 BF16 的平均性能几乎完全一致
- 标准差非常接近(通常差异 < 0.001)
- 证明 SageBwd 的微损效果具有统计稳健性
八、相关工作
推理加速方法
- FlashAttention 系列:FlashAttention (ICLR 2022) 引入 tiling 减少 GPU 全局内存 I/O;FlashAttention2 (ICLR 2024) 改进并行度和 warp 分区策略;FlashAttention3 (NeurIPS 2024) 仅在 Hopper GPU 上优化,不支持 RTX 系列。
- xformers:专用 CUDA kernel 加速注意力。
- SageAttention 系列:SageAttention (ICLR 2025) 使用量化 + outlier smoothing;SageAttention2 (ICML 2025) 引入 thorough outlier smoothing + per-thread int4 量化。
- FlashAttention3 FP8:虽支持 FP8 量化但未以 plug-and-play 方式应用于视频生成模型,且不支持反向传播。
线性注意力与稀疏注意力
- 线性注意力:Linformer (ICML 2020)、Performer (ICML 2021)、Metaformer (CVPR 2022)、Transformers are RNNs (ICML 2020)、Lightning Attention-2 (arXiv 2024)、Gated Delta Networks (arXiv 2024)。
- 稀疏注意力:Swin Transformer (ICCV 2021)、Twins (NeurIPS 2021)、Uniformer (ICLR 2022)、StreamingLLM (ICLR 2024)、InfLLM (2024)、LongLoRA (ICLR 2024)、MInference (NeurIPS 2024)、Skip-Attention (ICLR 2024)、SeerAttention (arXiv 2024)、MOA (arXiv 2024)、Sparse VideoGen (arXiv 2025)、SpargeAttn (ICML 2025)。
以上方法与 SpargeAttn 正交,可组合使用。
九、总结
核心贡献
- FP4 推理加速:设计首个 FP4 微缩放注意力,RTX5090 上 1038 TOPS(5× over FlashAttention2),端到端质量几乎无损
- INT8 训练探索:首次将低比特注意力应用于训练,微调无损、预训练收敛较慢
- 两级 P 量化:将 E4M3 范围利用率从 35 提升到 127,理论证明
- INT8 > FP8:证明 INT8 在训练中的优势——梯度精度更高、硬件支持更广
局限性
- SageBwd 在预训练任务中收敛速度较慢,目前不适用于预训练
- FP4 注意力依赖 Blackwell GPU 硬件支持,Hopper 及以下架构无法使用
- 深层网络中仍存在量化误差累积,需保留部分层在 FP16
- SageBwd 当前 Triton 实现与理论性能上限存在差距
未来方向
- 优化 Triton 内核实现以缩小 SageBwd 与理论性能差距
- 探索低比特注意力在预训练任务中的可行性
十、参考资源
- arXiv: https://arxiv.org/abs/2505.11594
- 代码: https://github.com/thu-ml/SageAttention
- 相关论文:
- SageAttention (ICLR 2025): Accurate 8-bit attention for plug-and-play inference acceleration
- SageAttention2 (ICML 2025): Efficient attention with thorough outlier smoothing and per-thread int4 quantization
- SpargeAttn (ICML 2025): Accurate and training-free sparse attention accelerating any model inference
- FlashAttention (ICLR 2022), FlashAttention2 (ICLR 2024), FlashAttention3 (NeurIPS 2024)
- xformers: A modular and hackable transformer modelling library
附图索引
| 编号 | 文件名 | 说明 |
|---|---|---|
| Figure 1 | figure-1-speedup-rtx5090.png | RTX5090 内核速度对比及 HunyuanVideo 端到端加速 |
| Figure 2 | figure-2-fp4-workflow.png | 微缩放 FP4 注意力工作流程 |
| Figure 3 | figure-3-two-level-quantization-analysis.png | 两级量化分析(分布、误差、可表示值对比) |
| Figure 4 | figure-4-kernel-speed-head128.png | RTX5090 head dim=128 内核速度对比 |
| Figure 5 | figure-5-kernel-speed-head64.png | RTX5090 head dim=64 内核速度对比 |
| Figure 6 | figure-6-sagebwd-speed-head128.png | RTX4090 SageBwd 前向+反向速度 head=128 |
| Figure 7 | figure-7-sagebwd-speed-head64.png | RTX4090 SageBwd 速度 head=64 |
| Figure 8 | figure-8-training-loss-curves.png | 预训练和微调损失曲线 |
| Figure 9 | figure-9-visible-comparison.png | 视频/图像生成可视化对比 |
| Appendix Fig. 10-11 | — | Flux/SD3.5 图像生成额外对比 |
| Appendix Fig. 12 | — | 两级量化 vs 直接量化的 CogVideoX 生成对比 |
| Appendix Fig. 13-14 | — | CogVideoX/HunyuanVideo 视频生成额外对比 |
| Appendix Fig. 15-18 | — | SageBwd 前向/反向单独速度对比 |
| Appendix Fig. 19-21 | — | FP4 寄存器布局与置换示意图 |