MegaScale-MoE: 大规模通信高效的生产级混合专家模型训练系统
本文深入分析MegaScale-MoE,一个专为大规模MoE模型高效训练设计的生产系统,通过通信高效并行策略、通信-计算重叠和通信压缩,在1,440个NVIDIA Hopper GPU上训练352B MoE模型实现1.41M tokens/s吞吐量,相比Megatron-LM提升1.88倍。
MegaScale-MoE: 大规模通信高效的生产级混合专家模型训练系统
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MegaScale-MoE: Large-Scale Communication-Efficient Training of Mixture-of-Experts Models in Production |
| 作者 | Chao Jin, Ziheng Jiang, Zhihao Bai, Zheng Zhong, Juncai Liu, Xiang Li, Ningxin Zheng, Xi Wang, Cong Xie, Qi Huang, Wen Heng, Yiyuan Ma, Wenlei Bao, Size Zheng, Yanghua Peng, Haibin Lin, Xuanzhe Liu, Xin Jin, Xin Liu |
| 机构 | 北京大学计算机学院 & ByteDance Seed |
| 论文 | arXiv:2505.11432 |
| 代码 | 未开源(生产系统) |
| 发布 | 2025年5月16日(v1),最后修订2025年10月17日(v3) |
| 许可 | 未明确 |
| 领域 | 机器学习 (cs.LG);分布式、并行与集群计算 (cs.DC) |
二、核心思想
随着大语言模型(LLM)规模的不断增长,混合专家(Mixture-of-Experts, MoE)架构因其稀疏激活特性成为扩展LLM的有效途径。MoE模型通过动态路由将输入token分配给选定的专家子集,而非所有参数,从而实现计算量的亚线性扩展。然而,在生产环境中训练大规模MoE模型时,通信开销成为关键性能瓶颈。
MegaScale-MoE的核心洞察是:在现代GPU硬件上,计算能力的快速提升(如NVIDIA Hopper GPU)使得通信开销在总训练时间中的占比越来越大。例如,在内部模型训练中,通信占前向传播时间的43.6%,占整个训练过程的32%。这一瓶颈源于两个因素:(1) MoE模型因参数规模更大需要更多GPU进行模型并行;(2) 稀疏计算需要额外的all-to-all通信来分发和聚合token。
问题定义
大规模MoE模型训练面临的核心问题:
- 通信瓶颈:随着硬件计算能力提升,通信开销相对计算时间的比例不断增大
- 并行策略效率低:传统张量并行(TP)在MoE训练中引入过多通信且影响GEMM效率
- 内存压力:MoE模型参数量大,训练时内存消耗显著高于同等计算量的稠密模型
- 硬件异构性:不同GPU(H800、A100、H20)的计算/通信比差异大
解决方案概述
MegaScale-MoE采用三层递进优化策略:
- 通信高效并行策略:为注意力和FFN组件定制不同的并行策略,减少通信量
- 通信-计算重叠:在算子间和算子内两个层面实现全面的通信隐藏
- 通信压缩:通过精度降低进一步减少通信开销
三、技术架构
整体框架图
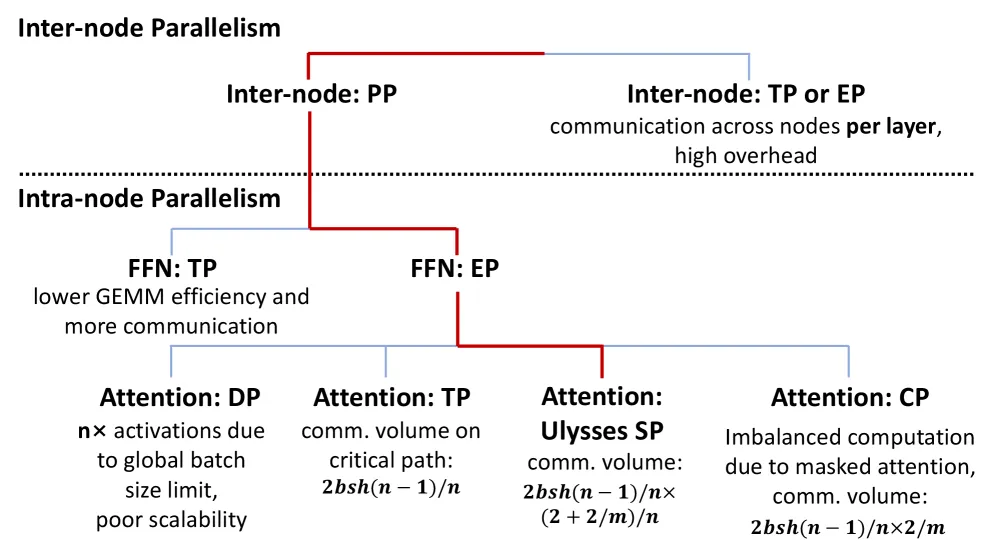
图4:大规模MoE训练的设计空间
MegaScale-MoE的架构设计基于以下核心原则:
┌─────────────────────────────────────────────────────────────────────┐
│                      MegaScale-MoE 训练系统                         │
├─────────────────────────────────────────────────────────────────────┤
│  并行策略层                                                         │
│  ┌─────────────────┐  ┌─────────────────┐  ┌─────────────────────┐ │
│  │  注意力模块      │  │  FFN/专家模块    │  │  数据/流水线并行    │ │
│  │  序列并行(SP)    │  │  专家并行(EP)    │  │  DP + PP            │ │
│  └─────────────────┘  └─────────────────┘  └─────────────────────┘ │
├─────────────────────────────────────────────────────────────────────┤
│  通信-计算重叠层                                                    │
│  ┌─────────────────────────────────────────────────────────────────┐│
│  │  算子间重叠:异步CUDA流调度                                      ││
│  │  算子内重叠:Tile级通知 + 设备内存屏障                           ││
│  │  选择性激活重计算:减少内存占用                                  ││
│  └─────────────────────────────────────────────────────────────────┘│
├─────────────────────────────────────────────────────────────────────┤
│  通信压缩层                                                         │
│  ┌─────────────────────────────────────────────────────────────────┐│
│  │  DP梯度压缩:FP32→BF16精度降低 + All-to-All通信                 ││
│  │  FP8训练优化:Per-token量化 + 多精度优化器                       ││
│  └─────────────────────────────────────────────────────────────────┘│
└─────────────────────────────────────────────────────────────────────┘
MoE层结构
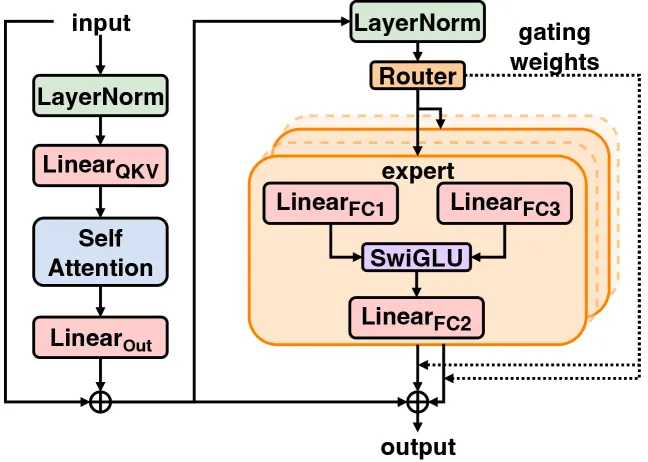
图2:混合专家(MoE)层结构
MoE模型在Transformer架构的FFN组件中集成多个专家网络,通过可训练的门控机制动态路由token到最相关的专家。
核心公式
并行策略通信量分析
张量并行(TP)在注意力中的通信量:
序列并行(SP)在注意力中的通信量:
其中:
- :微批次大小
- :序列长度
- :隐藏维度大小
- :模型并行度(TP、SP或EP大小)
- :查询头数与KV头数的比值
- :每个token路由的专家数量
关键发现:当模型在NVLink域(大小为8)上训练时,SP的通信延迟显著低于TP,尤其是使用分组查询注意力(GQA)时。
专家并行(EP)通信量:
张量并行(TP)在FFN中的通信量:
虽然EP和TP的相对效率取决于的比值,但MegaScale-MoE设计了自适应通信策略来最小化EP的通信量。
计算-通信比分析
对于包含MoE机制的SwiGLU结构,计算时间与通信时间的比值定义为:
重要结论:随着并行度增大,EP的通信量减少(与TP相反),理论上可以扩展到更大规模。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 注意力模块 | 标准Transformer自注意力 | 隐藏维度,头数(Q/KV比) |
| MoE FFN模块 | 多专家前馈网络 | 专家数、top-k、FFN中间维度 |
| 门控网络 | Token路由机制 | 可训练,决定token分配给哪些专家 |
| 序列并行(SP) | 注意力模块并行策略 | 沿序列维度分割,减少通信 |
| 专家并行(EP) | FFN模块并行策略 | 分布专家到不同GPU |
| 流水线并行(PP) | 跨层并行 | 15个流水线阶段 |
训练流程
MegaScale-MoE的训练流程包含以下关键步骤:
-
并行策略配置
- 注意力模块:序列并行(SP),沿序列维度分割
- FFN模块:专家并行(EP),专家分布到节点内GPU
- 流水线并行:15个阶段,使用Interleaved 1F1B调度
-
前向传播
- 注意力计算(SP并行)
- Token路由(门控网络)
- Token分发(All-to-All或All-Gather+Reduce-Scatter)
- 专家计算(GroupedGEMM)
- Token聚合
-
反向传播
- 梯度计算
- 选择性激活重计算
- 梯度通信与计算重叠
-
参数更新
- FP32梯度累积
- BF16梯度通信压缩
- 多精度优化器更新
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 通信高效并行策略 | 为注意力和FFN定制不同并行策略(SP+EP替代TP) | SP通信量比TP低倍;EP通信量随并行度增大而减少 |
| 自适应EP通信模式 | 当top-k > n时,用All-Gather+Reduce-Scatter替代All-to-All | All-to-All需要所有worker间通信,而AG/RS遵循环形模式,当top-k > 6时更高效 |
| 算子间通信-计算重叠 | 异步CUDA流执行,整体调度策略 | 通过将MoE层分解为独立GPU内核实现灵活调度 |
| 算子内通信-计算重叠 | 融合通信和计算算子,Tile级通知 | 使用设备内存屏障实现细粒度Tile级通知,消除主机干预 |
| 选择性激活重计算 | 战略性保留昂贵激活,重计算内存密集型操作 | 减少激活内存需求,同时将重计算与其他操作重叠 |
| DP通信压缩 | FP32→BF16梯度压缩 + All-to-All通信 | 梯度通信开销降低50%,精度损失可忽略 |
| FP8训练优化 | Per-token量化替代per-tensor量化,多精度优化器 | 解决SwiGLU数值范围扩展问题,降低内存消耗 |
自适应EP通信策略详解
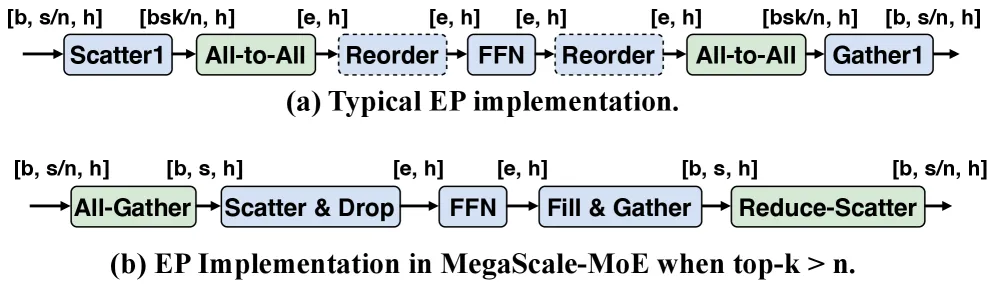
图6:通信高效专家并行
传统EP实现需要两次All-to-All通信(token分发和聚合),加上额外的scatter操作确保内存连续性。MegaScale-MoE的优化策略:
- 当 :使用标准All-to-All
- 当 :使用All-Gather + Reduce-Scatter
- All-Gather收集所有worker的token
- 本地scatter丢弃不需要的token
- 专家计算后,reduce-scatter产生最终结果
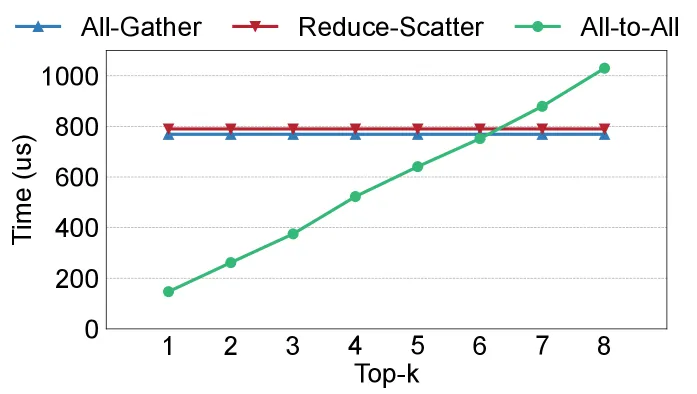
图7:Mixtral-8x7B上AG、RS和A2A的通信时间比较
算子内重叠技术
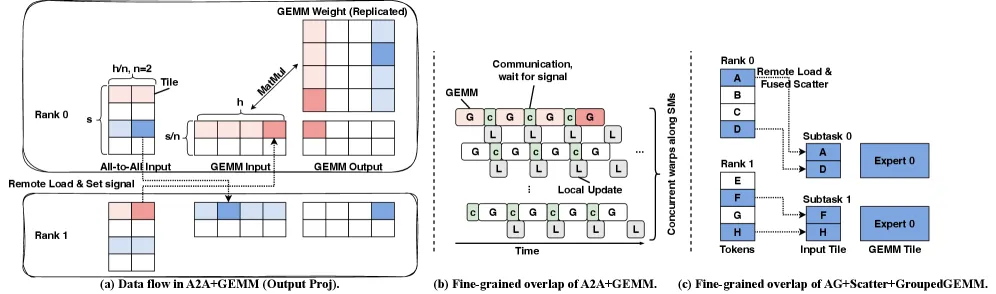
图10:细粒度算子内通信-计算重叠
算子内重叠的核心思想是融合通信和计算算子,将工作负载分解为Tile:
- A2A+GEMM:GEMM在本地数据上计算,同时通信远程数据。一旦远程数据Tile到达,信号通知GEMM继续计算
- GEMM+A2A:All-to-All操作融合到GEMM内核中,每个GEMM计算Tile结束后进行远程数据传输
使用专用GPU拷贝引擎进行数据传输,确保所有SM完全用于计算。
选择性激活重计算
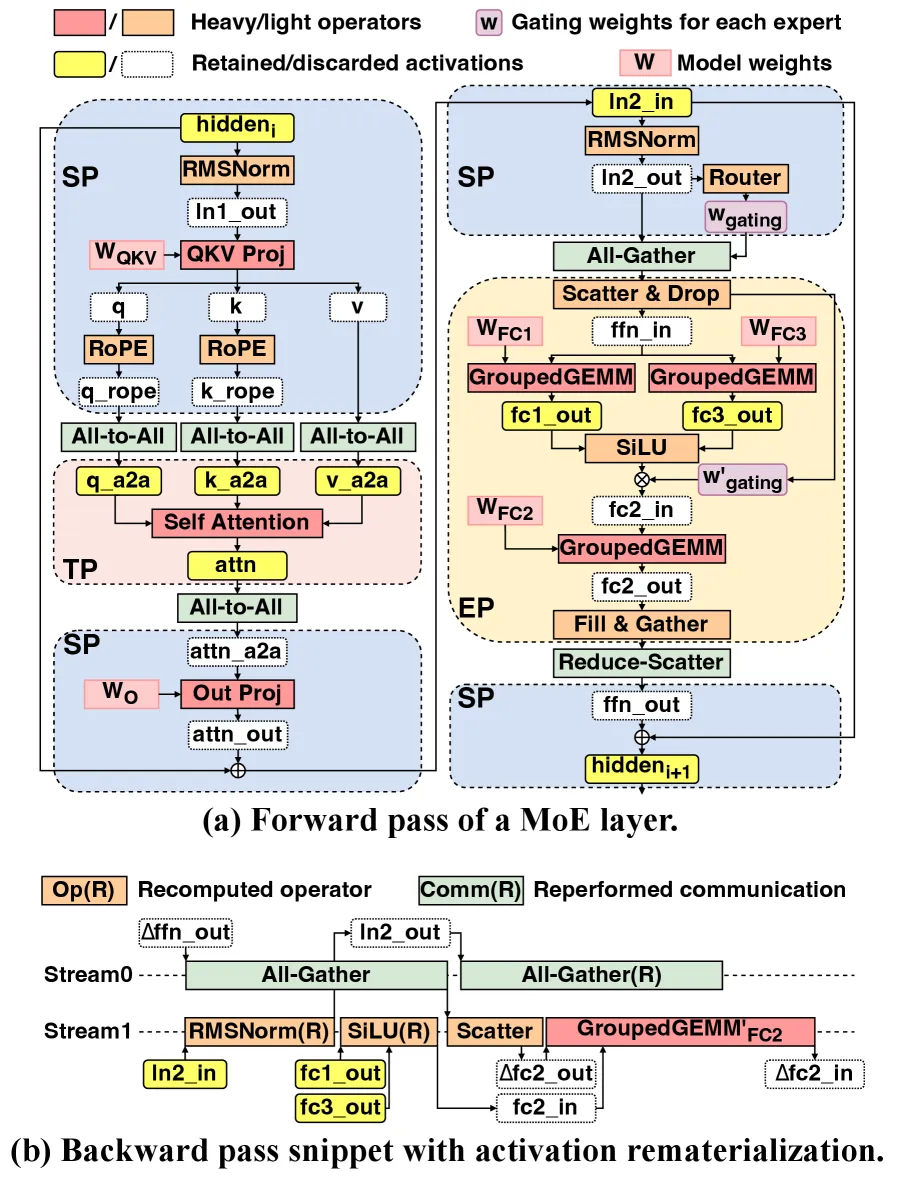
图8:选择性激活重计算
MegaScale-MoE战略保留计算昂贵的激活(如FC2输入),重计算内存密集型操作或通信操作的激活。例如:
- 反向传播中GroupedGEMM的FC2需要fc2_in和Δfc2_out
- MegaScale-MoE重计算fc2_in,并将此操作与梯度通信(All-Gather for Δffn_out)重叠
- ffn_in通过重新执行RMSNorm和All-Gather获得,隐藏在前序通信和FC2 GroupedGEMM中
五、实验结果
基准测试配置
| 模型 | 层数 | 隐藏维度 | 头数 | (Q/KV比) | 专家数 | top-k | |
|---|---|---|---|---|---|---|---|
| Internal-352B | 60 | 4096 | 32 | 4 | 14336 | 32 | 3 |
| Mixtral-8x7B | 32 | 4096 | 32 | 4 | 14336 | 8 | 2 |
| Mixtral-8x22B | 56 | 6144 | 48 | 6 | 16384 | 8 | 2 |
| Hunyuan-Large | 64 | 6400 | 80 | 10 | 18304 | 16 | 1 |
| Phi-3.5-MoE | 32 | 4096 | 32 | 4 | 6400 | 16 | 2 |
| DeepSeekMoE | 28 | 2048 | 16 | 1 | 1408 | 64 | 6 |
352B MoE模型强扩展性能
| 系统 | GPU数 | 迭代时间(s) | 吞吐量(tokens/s) | 训练1T Tokens(天) |
|---|---|---|---|---|
| Megatron-LM | 240 | 39.94 | 151.1k | 76.61 |
| 480 | 19.56 | 301.1k | 38.38 | |
| 720 | 13.70 | 430.5k | 26.88 | |
| 960 | 10.82 | 550.2k | 21.23 | |
| 1440 | 7.90 | 746.6k | 15.50 | |
| MegaScale-MoE | 240 | 21.61 | 272.9k (1.81x) | 42.41 |
| 480 | 11.83 | 498.6k (1.65x) | 23.21 | |
| 720 | 7.97 | 740.1k (1.72x) | 15.64 | |
| 960 | 6.12 | 963.8k (1.77x) | 12.01 | |
| 1440 | 4.19 | 1407.7k (1.88x) | 8.22 |
关键结果:在1,440个NVIDIA H800 GPU上,MegaScale-MoE实现1.41M tokens/s吞吐量,相比Megatron-LM提升1.88倍。
弱扩展性能
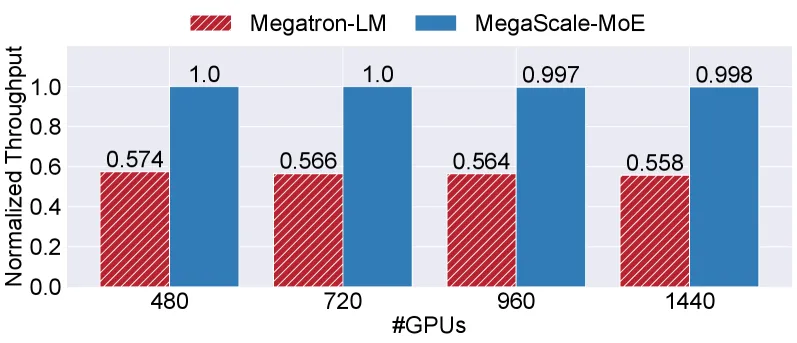
图12:352B MoE模型在NVIDIA H800 GPU上的弱扩展训练性能
弱扩展实验(全局批次大小从360到1,080,GPU从480到1,440):
- MegaScale-MoE实现1.74-1.79x吞吐量相比Megatron-LM
- Megatron-LM吞吐量随规模增加下降2.74%(通信开销增加)
- MegaScale-MoE实现近线性扩展,吞吐量仅下降0.2%
不同GPU上的性能分解
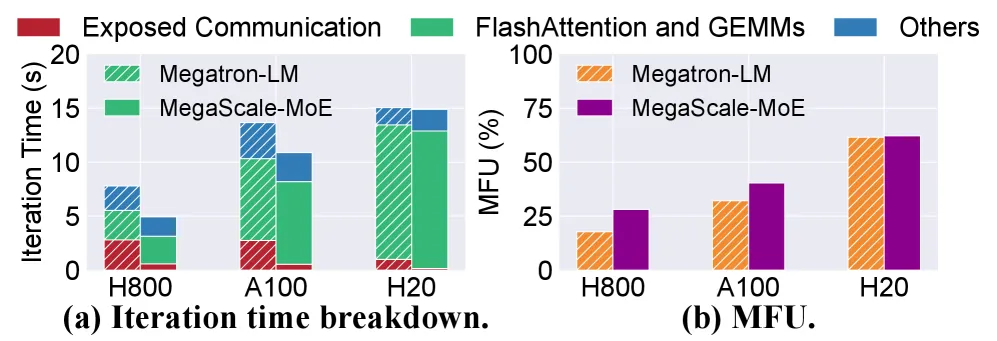
图13:在不同GPU上训练Mixtral-8x7B的性能分解
| GPU | 计算能力(TFLOPS) | 内存容量(GB) | 内存带宽(TB/s) | NVLink带宽(GB/s) |
|---|---|---|---|---|
| H800 | 989 | 80 | 3.4 | 400 |
| A100 | 312 | 80 | 2.0 | 600 |
| H20 | 148 | 96 | 4.0 | 900 |
在三种GPU上,MegaScale-MoE一致性地比Megatron-LM高1.58倍MFU。
消融实验
| 索引 | 方法 | 归一化吞吐量 | 增量 |
|---|---|---|---|
| 1 | baseline (TP+TP,无重叠) | 1 | - |
| 2 | (1) + SP+EP | 1.13 | +13% |
| 3 | (2) + 算子间重叠 | 1.22 | +9% |
| 4 | (3) + 算子内重叠 | 1.28 | +6% |
消融分析(240 GPU,352B MoE模型,批次大小720):
- SP+EP并行策略:+13%吞吐量提升
- 算子间通信-计算重叠:+9%提升
- 算子内重叠:+6%提升
- 总计:28%吞吐量提升
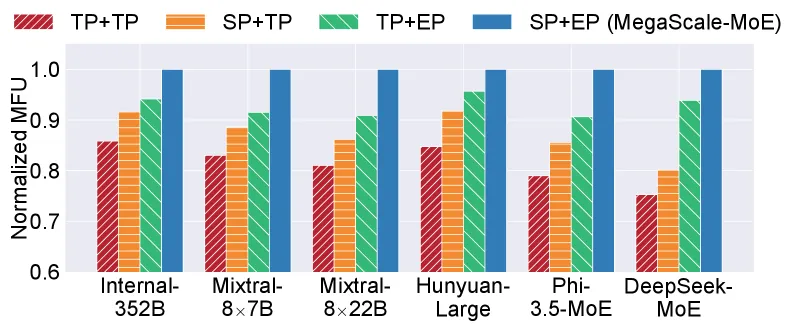
图14:不同模型的并行效率
SP+EP策略在6个不同配置的MoE模型上一致优于其他三种并行策略(TP+TP、TP+EP、SP+TP),MFU提升14.9%-32.9%。
通信重叠效果
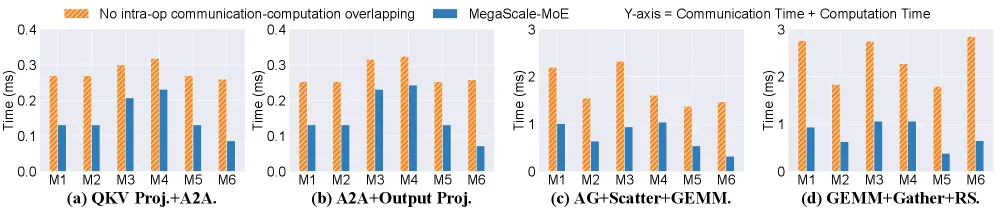
图16:各层重叠vs非重叠通信-计算时间
该图展示了6个模型(M1-M6)中All-to-All(A2A)、All-Gather(AG)和Reduce-Scatter(RS)的重叠效果。
模型收敛
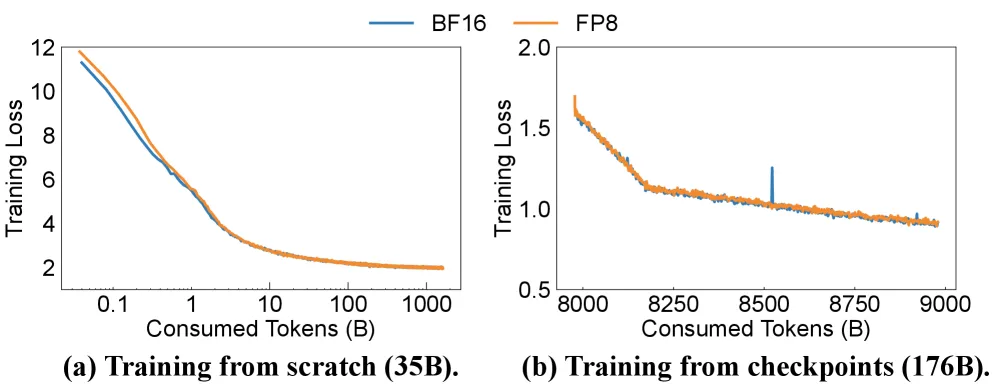
图19:MegaScale-MoE在FP8和BF16下的损失曲线
MegaScale-MoE确保在BF16和FP8格式下的稳定收敛和一致训练损失:
- 35B MoE模型从头训练
- 176B MoE模型从检查点继续训练
- FP8训练收敛稳定,无精度问题
生产环境验证
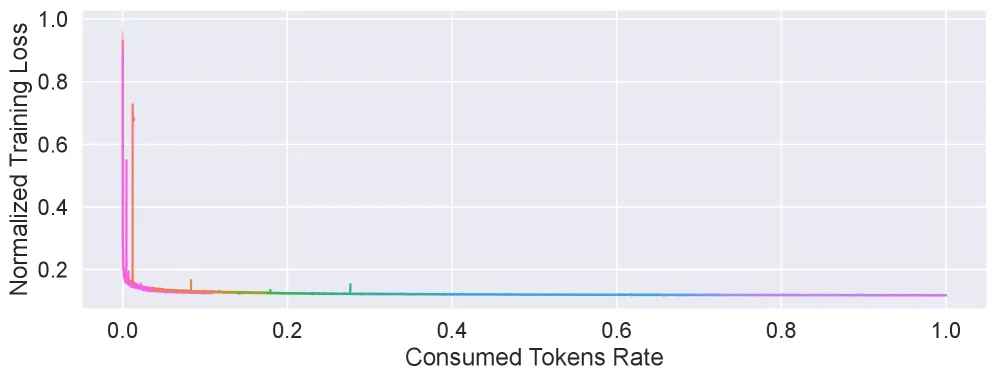
图20:超过10,000 GPU上运行数月的生产任务训练损失曲线
实际生产部署:
- 训练200B参数MoE模型(20B激活/token)
- 使用超过10,000 GPU
- 训练持续数月
- 损失持续收敛,训练过程稳定
六、相关工作
大模型训练系统
| 系统 | 核心技术 | 与MegaScale-MoE的区别 |
|---|---|---|
| DeepSpeed | ZeRO优化器,分布式训练 | 未专门优化MoE训练通信 |
| Megatron-LM | 3D并行(TP+PP+DP) | TP在MoE训练中通信开销大,GEMM效率低 |
| MegaScale | 大规模稠密模型训练 | 未针对MoE架构优化 |
| DeepSpeed-MoE | MoE训练框架 | 使用TP分割专家维度,影响GEMM效率 |
| DeepSeek-V3 | DeepEP + DualPipe | DeepEP限制跨节点token分发到最多4个节点;DualPipe需要2x模型参数内存 |
MoE训练优化
| 方法 | 核心思想 | 局限性 |
|---|---|---|
| HetuMoE | 层次化All-to-All通信 | 未解决通信-计算重叠问题 |
| SE-MoE | 异构资源训练 | 引入CPU/SSD访问延迟 |
| FasterMoE | 动态shadowing、细粒度调度 | 未解决大规模扩展问题 |
| Janus | 数据中心范式 | 需要修改数据处理流程 |
| Tutel | 自适应并行和流水线 | 动态切换和层次化All-to-All对大模型开销大 |
MegaScale-MoE vs DeepSeek-V3
| 特性 | MegaScale-MoE | DeepSeek-V3 |
|---|---|---|
| Token分发 | 节点内,可路由到任意top-k专家 | 限制跨节点最多4节点 |
| 通信-计算重叠 | 单微批次内重叠 | 需要2x模型参数内存 |
| 内存开销 | 无额外内存开销 | DualPipe需要存储2x参数 |
| 兼容性 | 兼容有/无流水线并行的系统 | 依赖流水线并行 |
七、总结
核心贡献
- 通信高效并行策略:为MoE模型的注意力和FFN组件定制SP+EP并行策略,通信量比传统TP显著降低
- 全面的通信-计算重叠:在算子间和算子内两个层面实现通信隐藏,包括整体调度策略和Tile级融合
- 选择性激活重计算:战略保留昂贵激活,重计算内存密集型操作,实现内存优化与性能平衡
- 通信压缩技术:DP梯度压缩(FP32→BF16)减少50%通信开销,FP8训练优化确保收敛稳定
- 生产级系统验证:在1,440 GPU上训练352B MoE模型,实现1.41M tokens/s,1.88x加速
技术影响
- 工业应用:已部署在ByteDance生产环境,负责大部分大规模MoE训练任务
- 规模能力:支持单训练任务超过10,000 GPU,训练持续数月
- 成本节约:通过优化技术节省数百万GPU小时
- 架构指导:为未来MoE系统设计提供重要参考
局限性
- 未开源:作为生产系统,核心代码未开源,难以直接复现
- 硬件依赖:优化主要针对NVIDIA Hopper架构,其他硬件需重新适配
- 模型特化:并行策略针对MoE架构设计,对稠密模型效果有限
- 路由灵活性:虽然支持任意top-k路由,但实际部署可能需要配合特定的负载均衡策略
- 跨节点扩展:当扩展到NVLink域外时,带宽下降到RDMA级别,需要进一步优化
未来方向
- 探索更高效的跨节点通信模式
- 研究MoE模型的动态负载均衡策略
- 优化FP8训练的数值稳定性
- 支持更多硬件架构(如AMD GPU、自研芯片)
八、参考资源
- 论文: arXiv:2505.11432
- PDF: arXiv PDF
- HTML版本: arXiv HTML
- 相关工作:
- GPU规格: