TokenWeave: Efficient Compute-Communication Overlap for Distributed LLM Inference
首个在低延迟推理场景下为张量并行LLM推理实现高效计算通信重叠的系统,通过融合AllReduce-RMSNorm核和波感知智能分割达成最高1.28×加速
TokenWeave: Efficient Compute-Communication Overlap for Distributed LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TokenWeave: Efficient Compute-Communication Overlap for Distributed LLM Inference |
| 作者 | Raja Gond, Nipun Kwatra, Ramachandran Ramjee |
| 机构 | Microsoft Research India |
| 论文 | arXiv:2505.11329 |
| 代码 | github.com/microsoft/tokenweave |
| 发布 | 2025-05-16 (v1), 2026-05-01 (v5, 最终版) |
| 发表 | MLSys 2026 |
| 许可 | CC BY 4.0 |
| 领域 | Distributed, Parallel, and Cluster Computing (cs.DC); Machine Learning (cs.LG) |
二、核心思想
问题定义
在分布式LLM推理中,即使通过NVLink连接的高性能GPU,张量并行(Tensor Parallelism)带来的通信开销仍高达端到端延迟的9-23%(Figure 1)。更令人惊讶的是,RMSNorm操作的开销也达到4-9%,此前一直被忽视。
现有的计算-通信重叠技术(如TileLink、NanoFlow、Flux)都无法在低延迟推理场景中有效工作,原因有二:
- 分解开销:将计算分解为更小的子任务以实现重叠,会导致GPU wave quantization效应,降低计算效率
- SM资源竞争:通信操作占用大量流式多处理器(SM),挤占了本可用于计算的资源
因此,尽管已有大量研究,vLLM、SGLang、TensorRT-LLM等主流推理系统默认并未开启任何通信重叠优化,张量并行推理仍承受高达20%的通信成本。
解决方案概述
TokenWeave是首个在低至1024 token的小批次下实现高效计算-通信重叠的系统,核心创新包括:
- 发现并优化RMSNorm:识别RMSNorm为关键瓶颈,设计融合的AllReduce-RMSNorm核
- 波感知智能分割(Wave-Aware Smart-Splitting):两路token分割,确保总wave数不增加
- NVSHARP/Multimem优化:仅用2-8个SM即可完成通信和归一化,释放大部分SM用于计算
三、技术架构
整体框架
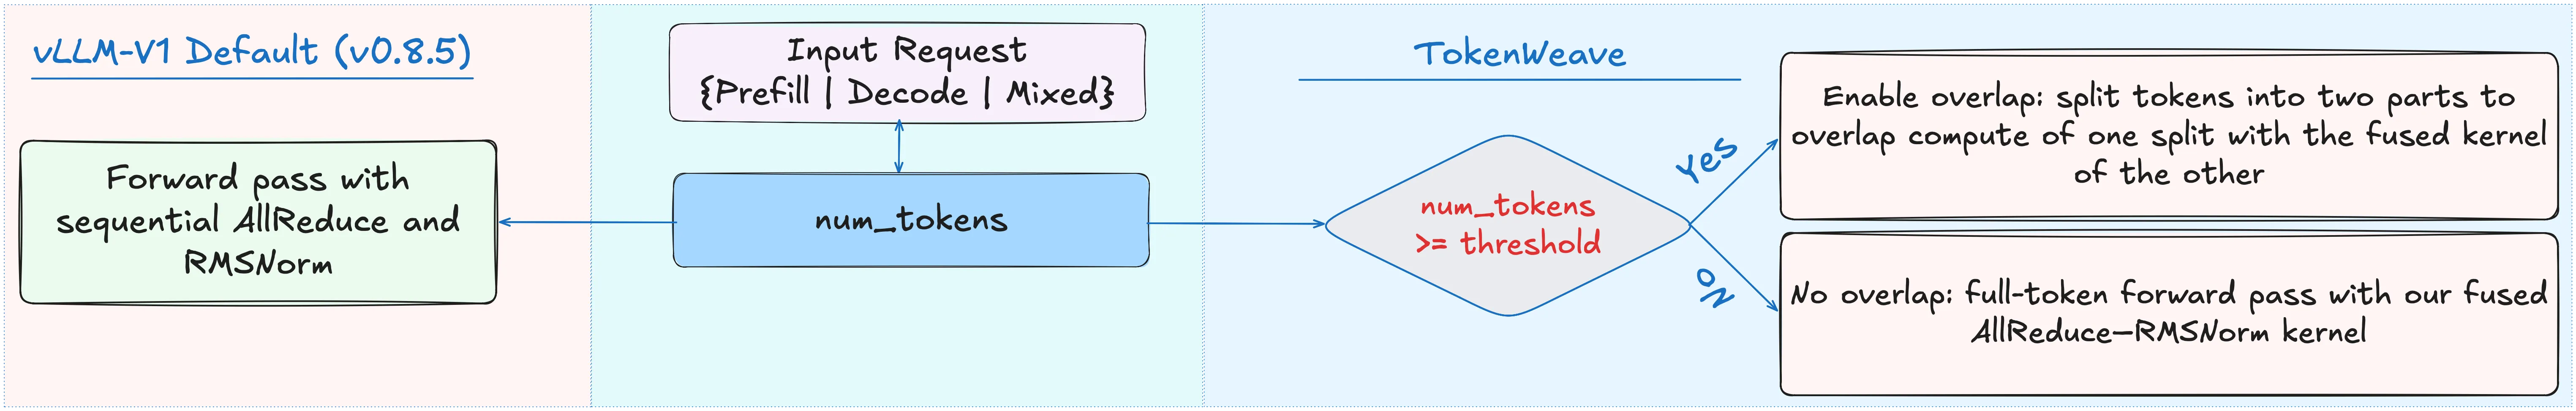
TokenWeave的三个核心技术:
┌─────────────────────────────────────────────────────────────┐
│                    TokenWeave Pipeline                       │
│                                                              │
│  输入批次 → Smart-Split (两路分割)                            │
│    ├─ Split 0 → Compute 0 (并行)                            │
│    │            + Fused-AR-RMSNorm 0 (与Split 1重叠)         │
│    └─ Split 1 → Compute 1 (并行)                            │
│              + Fused-AR-RMSNorm 1 (与Split 0重叠)            │
│                                                              │
│  关键: 通信(Split 0) 与 计算(Split 1) 交织执行               │
└─────────────────────────────────────────────────────────────┘
核心公式与设计要点
融合核优化原理:
标准做法中,vLLM在AllReduce之后执行RMSNorm,或者将AllReduce拆分为ReduceScatter+AllGather并在ReduceScatter后执行RMSNorm。后者虽然减少了每GPU的RMSNorm计算量(除以TP度),但引入了显著的额外开销(Figure 4):
| 序列长度 | RS+AG / AR 比率 |
|---|---|
| 64 | 2.03× |
| 1K | 1.06× |
| 8K | 1.01× |
| 32K | 1.00× |
对于小批次(≤8K),拆分开销达1-6%,抵消了RMSNorm节省。
融合核实现(CUDA Kernel伪代码,见附录A.1):
__global__ multimem_fused_allreduce_rmsnorm_kernel(...) {
    // 每个CTA处理一批token
    // 1. 通过multimem ld reduce add执行GPU间约简
    auto multimem_temp = multimem_ld_reduce_add<multimem_address_ptr>(offset);

    // 2. 累加残差并计算方差
    temp += residual_o[idx];
    variance[0] += temp.sum_squares();

    // 3. 归一化后直接写入输出
    vec_t temp = residual_o[idx] * s_variance * weight_v[idx];
    multimem_st<multimem_output_ptr>(offset, temp);
}关键优化:消除中间HBM访问——约简、残差累加、方差计算、归一化均在共享内存中完成,只通过multimem指令进行最终的远程存储。
智能分割(Smart-Splitting):
传统等量分割:  Split 0 = T/2 tokens,  Split 1 = T/2 tokens

TokenWeave:     Split 0 = T/2 + offset tokens,
                Split 1 = T/2 - offset tokens

其中 offset 通过离线分析使Split 0的最后wave满occupancy
wave量化效应示意(Figure 8):
假设kernel有10个CTA,GPU有4个SM:
Wave 1: CTA 0,1,2,3 → 4个SM满载
Wave 2: CTA 4,5,6,7 → 4个SM满载
Wave 3: CTA 8,9     → 仅2个SM工作(浪费6个SM)

Smart-split确保Split 0的last wave满occupancy,
使两个split的总wave数 ≤ 原始kernel的wave数
Multimem SM效率(Figure 5, 10):
| 序列长度 | 最优SM数 | 说明 |
|---|---|---|
| 64-256 | 2-4 SM | 极小规模 |
| 512-8K | 4-8 SM | 典型范围 |
| 16K-64K | 8-16 SM | 大规模 |
仅2-8个SM即可饱和通信带宽,释放绝大部分SM用于计算。
选择性启用策略(Figure 3)
if (num_tokens >= threshold) {
    // 启用完整TokenWeave: 智能分割 + 重叠 + 融合核
    TokenWeave(smart_split=true, overlap=true, fuse=true);
} else {
    // 仅启用融合核,避免分割开销
    TokenWeave(smart_split=false, overlap=false, fuse=true);
}
阈值设定(基于离线分析):
- Dense模型(Llama, Qwen):1K tokens
- MoE模型(Mixtral):4K tokens
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Fused AllReduce-RMSNorm | 融合NVSHARP约简与RMSNorm,消除中间HBM访问 | 4-8 SM, bf16 |
| Smart-Splitting | 波感知的两路token分割,确保总wave数不增加 | offset通过离线profile确定 |
| Selective Enable | 根据token数量动态决定是否启用分割/重叠 | Dense: 1K, MoE: 4K |
| NVSHARP/Multimem | 利用NVSwitch的in-network reduction | PyTorch SymmetricMemory API |
四、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| RMSNorm识别与融合 | 首次发现RMSNorm是TP通信优化的关键,设计融合AllReduce-RMSNorm核 | 1.34-1.39×加速,消除中间HBM访问 |
| 波感知智能分割 | 通过调整split偏移量使last wave满occupancy,消除wave量化开销 | 在小序列长度下分割开销降至最低 |
| NVSHARP/Multimem高效利用 | 仅用2-8个SM完成通信+归一化,而非传统的16-20+ SM | 释放SM资源用于计算重叠 |
| 首个低延迟TP重叠系统 | 在低至1024 token下实现有效重叠(之前方案需8K+) | 覆盖低延迟推理的实际工作负载 |
| 选择性启用机制 | 根据批次大小动态选择最优策略 | 避免小批次的分割惩罚 |
五、实验结果
评估设置
- 硬件:8×H100 DGX(NVLink4/NVSHARP),以及8×B200 DGX验证
- 模型:Llama-3.3-70B, Qwen2.5-72B, Mixtral-8x22B, Qwen3-235B-A22B
- 基线:vLLM-Multimem(已优化AllReduce),vLLM-nocomm(理论下限)
- 对比:TileLink, NanoFlow
端到端延迟性能
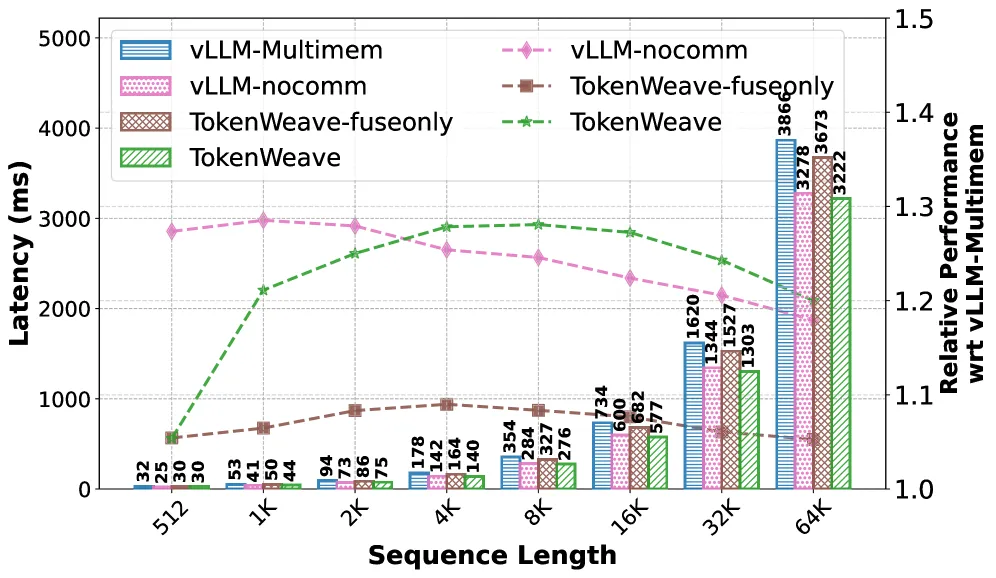
| 序列长度 | TokenWeave vs vLLM-Multimem | vs vLLM-nocomm |
|---|---|---|
| 64 tokens | ~1.04× | 接近 |
| 1K tokens | 1.20× | 接近/超越 |
| 4K tokens | 1.25× | 超越 |
| 8K tokens | 1.28× | 超越 |
| 32K tokens | 1.28× | 超越 |
关键发现:在≥4K序列长度时,TokenWeave不仅恢复所有通信开销,还因RMSNorm融合优化超越无通信的理论上限。
吞吐量增益
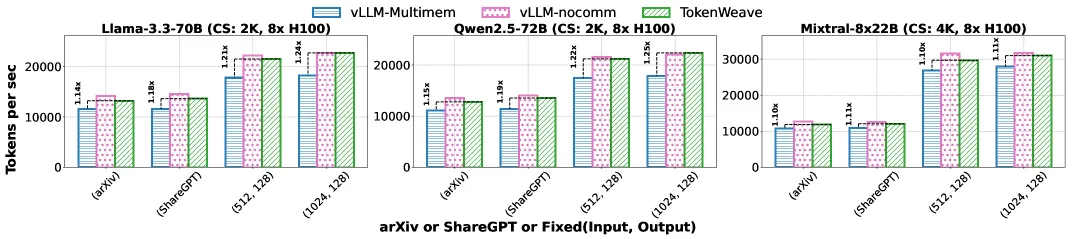
- ShareGPT trace:1.19× 吞吐量提升
- arXiv trace:1.15× 吞吐量提升
- 在不同chunk size(1024-8192)下均保持稳定增益
与现有方案对比
vs TileLink(Figure 14):
| 序列长度 | TileLink | TokenWeave |
|---|---|---|
| 256 | 降速(overhead) | 1.16× |
| 512 | 降速 | 1.22× |
| 1K | 降速 | 1.25× |
| 2K | 1.16× | 1.27× |
| 8K | 1.20× | 1.28× |
TileLink在≤2K时反而降速,TokenWeave在整个序列长度范围内稳定加速。
vs NanoFlow(Figure 15):
NanoFlow在高吞吐设置下有优势,但在低延迟场景(小chunk size)下TokenWeave表现更好。
消融实验
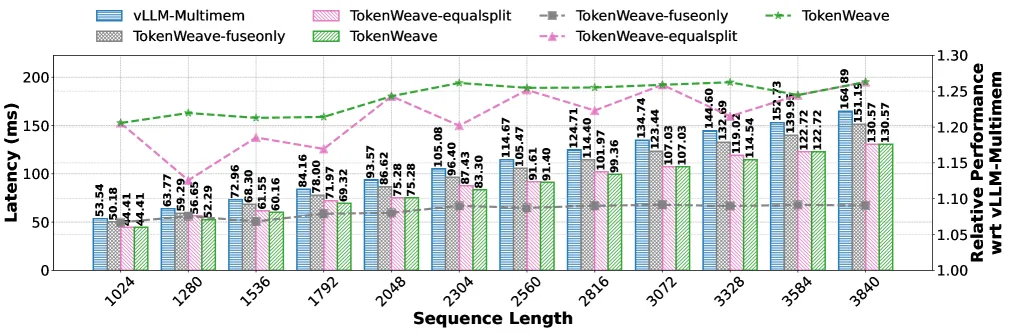
| 变体 | 64 tokens | 1K | 4K | 32K |
|---|---|---|---|---|
| vLLM-Multimem | 1.00× | 1.00× | 1.00× | 1.00× |
| TokenWeave-fuseonly | 1.04× | 1.04× | 1.04× | 1.04× |
| TokenWeave (full) | 1.04× | 1.20× | 1.27× | 1.28× |
- fuseonly:仅融合核,在所有序列长度下提供~4%的稳定增益
- full:融合核+智能分割+重叠,在小序列长度下增益主要来自融合核,大序列长度下重叠贡献显著
B200验证
在8×B200 DGX系统上的验证:
- Decode延迟:Llama-3.3-70B获得1.01-1.05×提升
- Prefill延迟:全TokenWeave实现最高1.22×加速
- 融合核:在B200上达到1.24-1.38×加速(Table 2)
融合核性能详情(B200,Table 2)
| 序列长度 | AR(us) | RMSNorm(us) | AR+RMSNorm(us) | Fused(us) | 加速比 |
|---|---|---|---|---|---|
| 32 | 26.08 | 14.46 | 40.54 | 30.46 | 1.33× |
| 128 | 32.29 | 14.67 | 46.96 | 34.14 | 1.38× |
| 1K | 60.26 | 21.12 | 81.38 | 63.62 | 1.28× |
| 4K | 166.61 | 53.66 | 220.27 | 170.14 | 1.29× |
| 64K | 2240.93 | 654.51 | 2895.44 | 2236.02 | 1.29× |
六、相关工作
| 工作 | 方法 | 局限 | TokenWeave优势 |
|---|---|---|---|
| Flux/TileLink | 细粒度tile-level融合,在GEMM内核中嵌入通信 | 仅适用于GEMM,小批次需8K+ tokens | 粗粒度token-level,低至1K tokens有效 |
| NanoFlow | nanobatch调度,按kernel粒度分割 | 依赖大批次,小批次开销大 | 智能分割消除wave量化开销 |
| DeepSeek | expert-parallel all-to-all重叠 | all-to-all开销50%+,易隐藏 | 针对AllReduce(~20%开销)优化 |
| GPipe | 训练中的pipeline parallelism | 不适用于推理的低延迟场景 | 专为低延迟推理设计 |
七、总结
核心贡献
- 发现RMSNorm的关键作用:识别RMSNorm为TP通信优化的关键瓶颈(4-9%开销),设计融合AllReduce-RMSNorm核
- 波感知智能分割:两路token分割确保总wave数不增加,消除wave量化开销
- NVSHARP/Multimem高效利用:仅2-8个SM完成通信+归一化,释放SM用于重叠
- 首个低延迟TP重叠系统:在低至1024 token下实现有效重叠,覆盖实际推理场景
- 广泛验证:在H100和B200平台上,多种模型和trace下验证了1.28×延迟改善和1.19×吞吐提升
技术影响
- TokenWeave已集成到vLLM-V1框架中,可直接惠及所有使用张量并行的LLM推理服务
- 融合核优化在不分隔预填充和解码的场景中直接受益小decode批次,在分隔场景中大prefill批次可获得更大增益
- 为NVSHARP/Multimem等新型硬件特性在ML推理中的高效利用提供了范例
局限性
- 依赖NVSHARP/Multimem:当前实现依赖Hopper/Blackwell架构的NVSHARP支持,AMD GPU或其他架构需要适配
- torch.compile限制:SymmetricMemory目前不被torch.compile支持,decode-only场景下需禁用torch.compile
- CUDA Graph不支持:完整TokenWeave方案(智能分割+重叠)不支持CUDA Graph
- B200上decode增益有限:由于上下文长度增加使RMSNorm占比下降,decode场景增益较小(1.01-1.05×)
八、参考资源
- 论文:https://arxiv.org/abs/2505.11329
- DOI:https://doi.org/10.48550/arXiv.2505.11329
- 代码:https://github.com/microsoft/tokenweave
- Zenodo存档:https://doi.org/10.5281/zenodo.18844243
- 发表:MLSys 2026
- 许可证:CC BY 4.0
- 依赖:PyTorch 2.6.0+, CUDA 12.4, vLLM 0.8.5+, 8×H100/B200 DGX