FAST: An Efficient Scheduler for All-to-All GPU Communication
针对MoE模型的高效All-to-All通信调度器,通过两阶段调度解决负载倾斜和incast问题
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FAST: An Efficient Scheduler for All-to-All GPU Communication |
| 作者 | Yiran Lei, Dongjoo Lee, Liangyu Zhao, Daniar Kurniawan, Chanmyeong Kim, Heetaek Jeong, Changsu Kim, Hyeonseong Choi, Liangcheng Yu, Arvind Krishnamurthy, Justine Sherry, Eriko Nurvitadhi |
| 机构 | Carnegie Mellon University, MangoBoost, University of Washington, University of Pennsylvania |
| 论文 | arXiv:2505.09764 |
| 代码 | GitHub (论文中提及) |
| 发布 | 2025-05-14 (v1), 2026-03-06 (v3) |
| 会议 | NSDI 2026 |
| 领域 | Distributed Computing (cs.DC), Networking (cs.NI) |
二、核心思想
问题定义
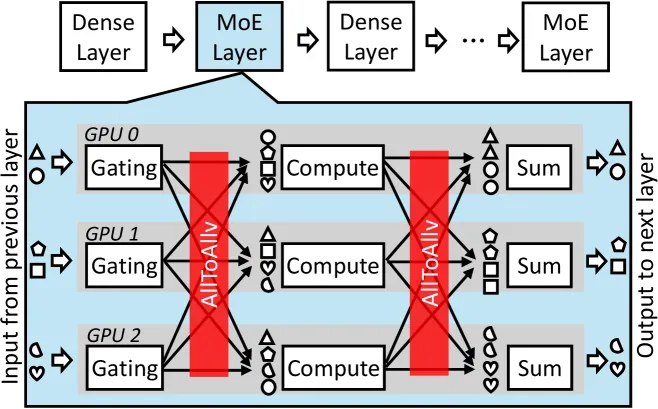
All-to-All(v)通信是现代机器学习工作负载(特别是MoE模型)中的关键原语。然而,高效调度面临三大挑战:
- 负载倾斜 (Skewness):MoE中某些专家被选择频率更高,导致对应GPU的数据传输量更大,某些GPU对交换超过中位数12倍的数据量
- 工作负载动态性 (Dynamism):MoE流量模式每几百毫秒变化一次,静态调度不实用
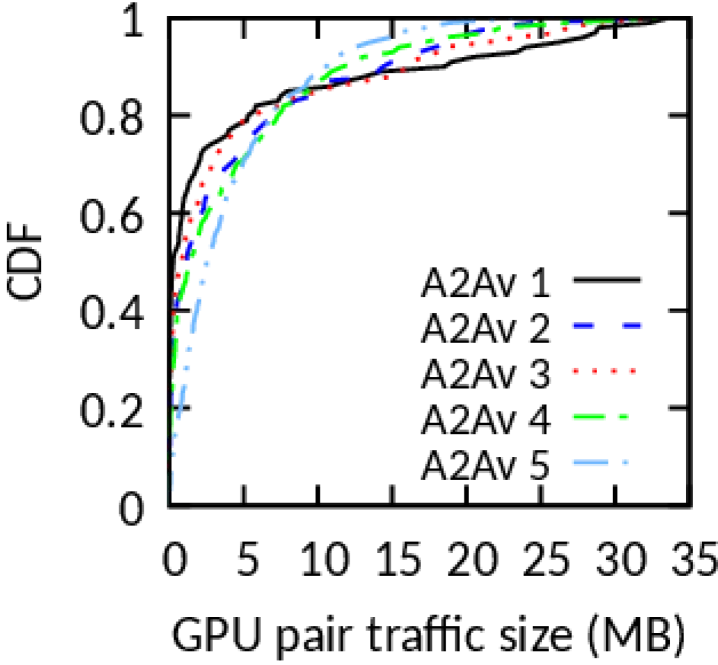
- 系统层挑战:
- 异构两层结构:快速scale-up链路(NVLink 900 GBps)vs 慢速scale-out链路(Ethernet 800 Gbps)
- Incast拥塞:密集通信模式导致多发送方同时拥塞同一接收方
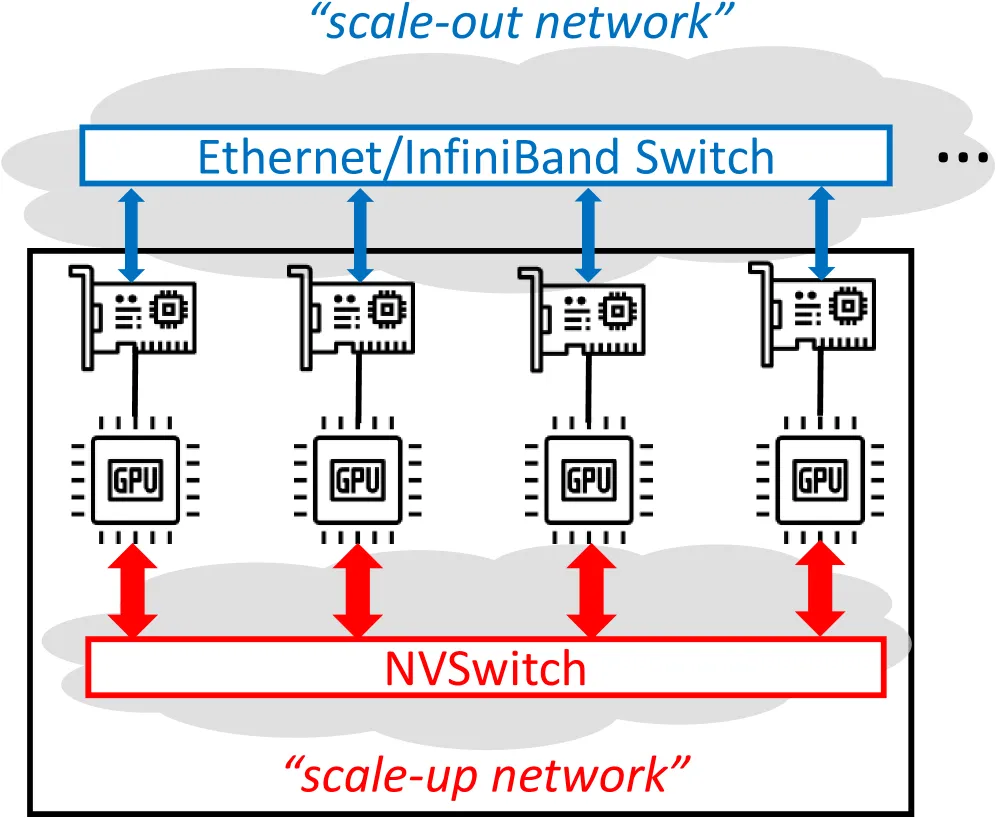
现有方案的局限:
- TACCL/TE-CCL:NP-hard问题,需要分钟到小时级调度时间
- SyCCL:最快但仍需秒到分钟级,对倾斜工作负载未解决
- NCCL:即时生成但使用固定调度,无法适应动态倾斜工作负载
解决方案概述
FAST是一个多项式时间、基于匹配的调度器,采用两阶段设计:
- 阶段一:服务器内调度 - 利用快速scale-up链路在数据离开节点前重新平衡负载
- 阶段二:服务器间调度 - 使用Birkhoff分解构建连续的一对一、平衡传输阶段
核心洞察: 优化scale-out层(真正的瓶颈)即可,快速的scale-up链路可以廉价地吸收服务器内的不平衡。
三、技术架构
整体框架图
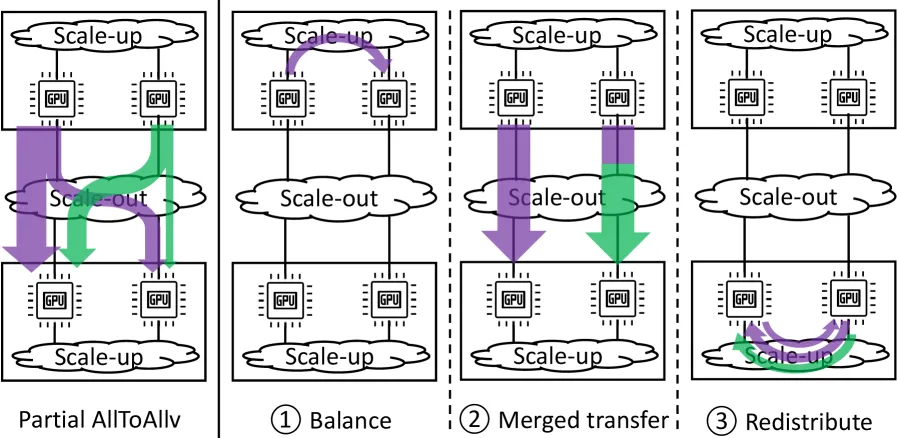
FAST的两阶段调度设计:
| 阶段 | 名称 | 目标 | 方法 |
|---|---|---|---|
| 阶段一 | 服务器内调度 | 消除发送方/接收方倾斜 | 利用scale-up链路重新平衡流量 |
| 阶段二 | 服务器间调度 | 避免incast,保持最优性 | Birkhoff分解实现一对一匹配 |
核心公式
Birkhoff分解定理:
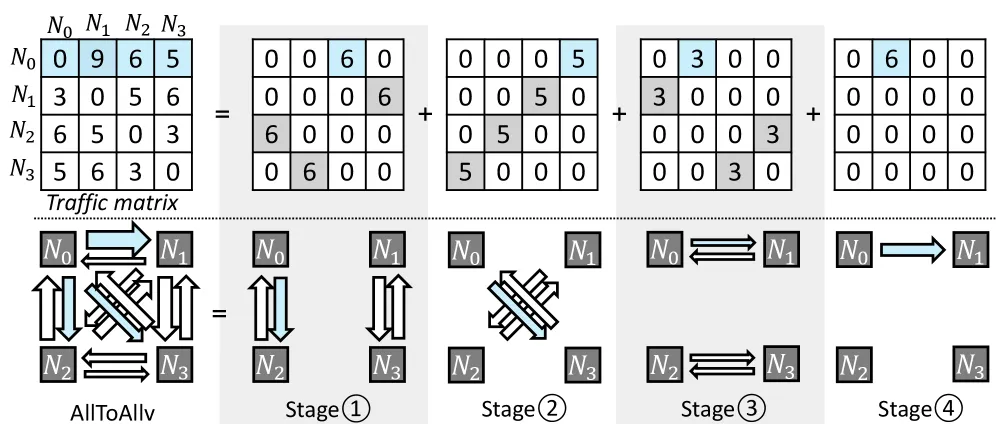
任何双随机矩阵可以表示为置换矩阵的加权和:
其中 是置换矩阵,,。
调度解释: 每个置换对应一个传输阶段:
- 每个活跃行(发送方)和列(接收方)恰好有一个等大小的非零条目
- 每个参与者与恰好一个伙伴交换数据
- 所有节点同时完成该阶段
完成时间下界:
其中 是第 行的和(发送方负载), 是第 列的和(接收方负载)。
服务器内调度
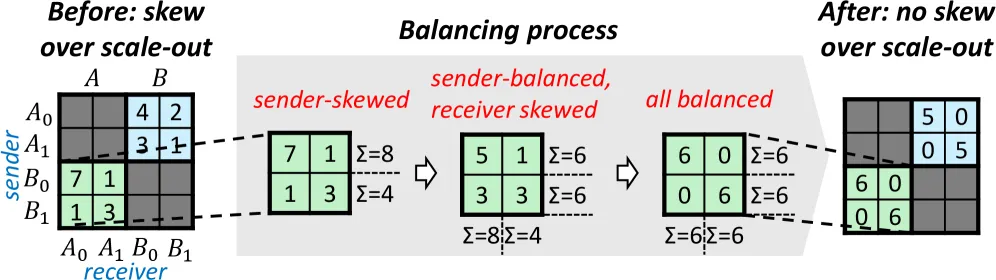
三步过程:
-
发送方平衡:重负载GPU将部分流量转移到轻负载GPU
- 目标:使每个NIC对目标服务器的出站负载相等
- 方法:通过scale-up链路在服务器内转移
-
合并对等传输:每个发送方将所有流量转发到具有相同本地索引的对等GPU
- ,
- 确保数据首先到达正确的服务器
-
重新分布:将代理GPU上的数据路由到真正的目标GPU
- 通过scale-up链路完成
- 开销很小(scale-up比scale-out快一个数量级)
矩阵变换: 将倾斜的tile转换为标量形式
服务器间调度
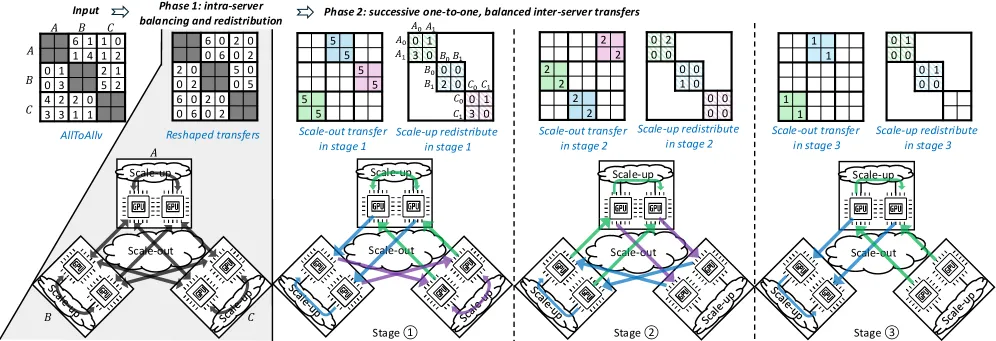
服务器级矩阵约简:
服务器内调度后,6×6 GPU级矩阵约简为3×3服务器级矩阵:
Birkhoff分解应用:
对服务器级矩阵应用Birkhoff分解,生成连续的一对一传输阶段:
- 每个阶段:一个发送方恰好与一个接收方配对
- 无incast:避免多发送方同时拥塞同一接收方
- 最优性:瓶颈服务器在每个阶段保持活跃
SpreadOut vs Birkhoff:
| 算法 | 特点 | 最优性 |
|---|---|---|
| SpreadOut | 循环移位对角线 | 不保证最优(瓶颈服务器可能空闲) |
| Birkhoff | 基于矩阵分解 | 保证最优(瓶颈服务器持续活跃) |
流水线设计
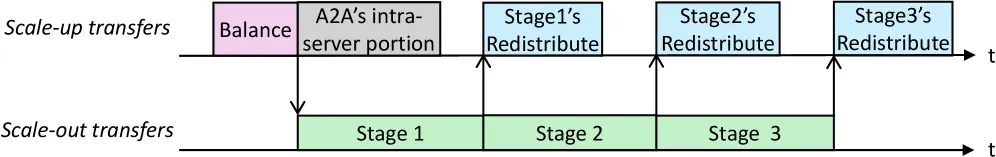
端到端流水线:
- Scale-out传输尽可能保持活跃
- Scale-up操作在后台重叠
- 箭头表示传输之间的触发关系
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 两阶段调度 | 服务器内平衡 + 服务器间Birkhoff分解 | 将NP-hard问题简化为多项式时间 |
| 服务器内重平衡 | 利用快速scale-up链路吸收倾斜 | 消除发送方/接收方straggler |
| Birkhoff分解应用 | 首次将Birkhoff分解应用于GPU端点集合通信调度 | 保证最优性和无incast |
| 服务器级约简 | 将GPU级矩阵约简为服务器级矩阵 | 问题规模降低一个数量级 |
| 多项式时间调度 | 64 GPU仅需221 μs | 适应MoE工作负载的动态性 |
五、实验结果
调度运行时间
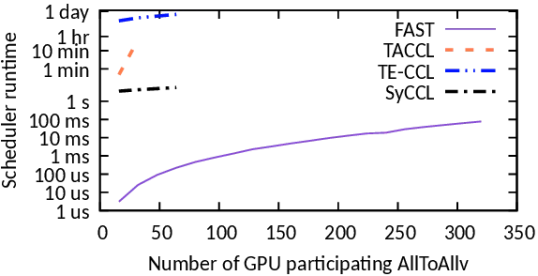
| GPU数量 | FAST | SyCCL | TACCL/TE-CCL |
|---|---|---|---|
| 64 GPUs | 221 μs | 秒到分钟 | 分钟到小时 |
| 扩展性 | 多项式时间 | 启发式 | NP-hard |
性能提升
NVIDIA H200集群:
- 倾斜工作负载:比最强基线快1.01–1.3×
AMD MI300X集群:
- 倾斜工作负载:比最强基线快1.5–2.8×
- 集成到Megatron-LM:MoE训练吞吐量提升4.48×(相比RCCL)
关键优势
- 适应动态工作负载:221 μs调度时间,足够快以适应MoE流量每几百毫秒的变化
- 消除incast:一对一匹配确保无网络拥塞
- 保持最优性:瓶颈服务器持续活跃直到完成
- 跨平台支持:在NVIDIA和AMD集群上均有效
六、相关工作
| 方向 | 代表工作 | FAST的优势 |
|---|---|---|
| 通用调度器 | TACCL, TE-CCL, SyCCL | 调度时间从分钟/小时降至微秒 |
| 生产库 | NCCL, RCCL | 适应动态倾斜工作负载 |
| MoE优化 | DeepEP | 更通用,跨平台支持 |
| 网络调度 | Birkhoff在交换机中的应用 | 首次应用于GPU端点集合通信 |
七、总结
核心贡献
- 高效All-to-All调度器:多项式时间(221 μs for 64 GPUs),适应MoE动态工作负载
- 两阶段设计:服务器内倾斜缓解 + 服务器间Birkhoff分解
- 跨平台实现:在NVIDIA H200和AMD MI300X上均有效
- 显著性能提升:倾斜工作负载下1.01–2.8×加速,MoE训练4.48×吞吐量提升
技术影响
- MoE训练效率:All-to-All占MoE训练时间的30-56%,FAST显著降低此开销
- 实时调度可行性:首次实现微秒级调度,适应MoE流量动态变化
- 理论贡献:将Birkhoff分解应用于GPU端点集合通信调度
- 工程价值:开源实现,易于集成
局限性
- 主要针对All-to-All(v)通信,其他集合通信需传统调度器
- 假设scale-up链路比scale-out快一个数量级
- 需要专用NIC支持(每GPU一个NIC)
八、参考资源
- 论文: arXiv:2505.09764
- 会议: NSDI 2026
- 相关技术: Birkhoff分解, All-to-All通信, MoE模型
- 应用场景: MoE训练、推荐系统、Gaussian Splatting、3D FFT