Qwen3 Technical Report
Qwen3 系列大语言模型,集成思考模式和非思考模式,支持 0.6B 到 235B 参数规模
Qwen3 Technical Report
论文信息: arXiv:2505.09388 [cs.CL] 14 May 2025
机构: 阿里巴巴通义千问团队
模型规模: 0.6B 到 235B 参数(Dense 和 MoE)
许可协议: Apache 2.0
一、论文概述
1.1 研究背景
Qwen3 是 Qwen 模型家族的最新版本,是一系列开源权重的大语言模型(LLMs)。Qwen3 包含 Dense 和 Mixture-of-Experts(MoE)两种架构,参数规模从 0.6B 到 235B 不等。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 模式切换 | 需要在思考模式(复杂推理)和非思考模式(快速响应)之间切换 |
| 计算效率 | 大模型推理成本高,需要动态分配计算资源 |
| 多语言支持 | 需要支持更多语言以满足全球应用需求 |
| 开源生态 | 需要提供高质量开源模型促进研究 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 统一框架 | 集成思考模式和非思考模式到单一模型 |
| 思考预算 | 允许用户动态分配推理计算资源 |
| 模型规模 | 0.6B 到 235B 参数,支持 Dense 和 MoE |
| 多语言 | 从 29 种语言扩展到 119 种语言和方言 |
| 36 万亿 Token | 预训练数据规模显著扩大 |
| 开源许可 | Apache 2.0 许可证 |
1.3 一句话总结
Qwen3 是一系列开源大语言模型,通过集成思考模式和非思考模式到统一框架,实现了在代码生成、数学推理、代理任务等多样基准上的最先进性能。
二、核心思想
2.1 设计原则
┌─────────────────────────────────────────────────────────────────┐
│                      Qwen3 设计原则                              │
├─────────────────────────────────────────────────────────────────┤
│  1. 统一思考框架 (Unified Thinking Framework)                    │
│     • 思考模式:复杂多步推理                                      │
│     • 非思考模式:快速上下文响应                                  │
│     • 动态模式切换                                               │
│                                                                 │
│  2. 思考预算机制 (Thinking Budget Mechanism)                      │
│     • 用户可分配推理计算资源                                      │
│     • 基于任务复杂度平衡延迟和性能                                │
│     • 细粒度控制推理深度                                         │
│                                                                 │
│  3. 模型规模扩展 (Model Scaling)                                 │
│     • Dense 模型:0.6B 到 32B                                   │
│     • MoE 模型:30B-A3B 和 235B-A22B                            │
│     • 旗舰模型:235B 总参数,22B 激活参数                        │
│                                                                 │
│  4. 多语言支持 (Multilingual Support)                            │
│     • 119 种语言和方言                                           │
│     • 36 万亿预训练 Token                                        │
│     • 跨语言理解和生成能力                                       │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | Qwen3 解决方案 |
|---|---|---|
| 模式切换 | 需要不同模型(如 GPT-4o vs QwQ) | 统一框架集成两种模式 |
| 计算效率 | 固定推理成本 | 思考预算动态分配 |
| 多语言 | 语言覆盖有限 | 119 种语言支持 |
| 开源质量 | 开源模型性能不足 | SOTA 性能开源模型 |
三、技术架构
3.1 整体架构
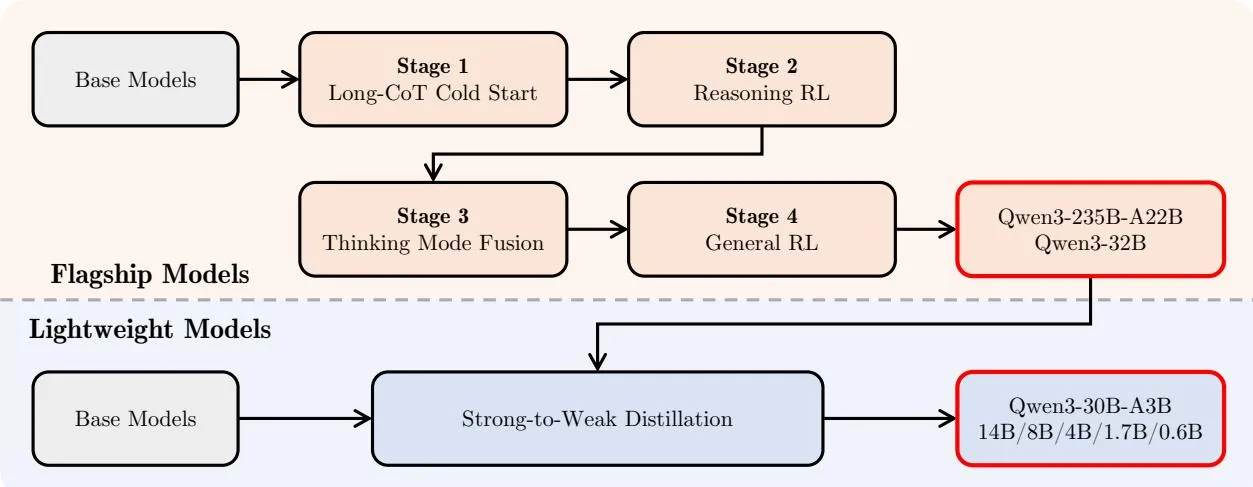 图 1:Qwen3 系列模型的后训练流程。包含四个阶段:Long-CoT Cold Start、Thinking Reinforcement Learning、Thinking Fusion、General Reinforcement Learning。
模型系列:
| 模型 | 参数量 | 架构 | 上下文长度 |
|---|---|---|---|
| Qwen3-0.6B | 0.6B | Dense | 32K |
| Qwen3-1.7B | 1.7B | Dense | 32K |
| Qwen3-4B | 4B | Dense | 128K |
| Qwen3-8B | 8B | Dense | 128K |
| Qwen3-14B | 14B | Dense | 128K |
| Qwen3-32B | 32B | Dense | 128K |
| Qwen3-30B-A3B | 30B (3B 激活) | MoE | 128K |
| Qwen3-235B-A22B | 235B (22B 激活) | MoE | 128K |
3.2 Dense 模型架构
Qwen3 Dense 模型架构与 Qwen2.5 类似,包含以下关键组件:
| 组件 | 说明 | 关键特性 |
|---|---|---|
| GQA | Grouped Query Attention | 高效注意力机制 |
| SwiGLU | SwiGLU 激活函数 | 增强非线性表达 |
| RoPE | Rotary Positional Embeddings | 旋转位置编码 |
| RMSNorm | RMSNorm 预归一化 | 稳定训练 |
| QK-Norm | 注意力 QK 归一化 | 确保训练稳定性 |
关键改进:
- 移除 Qwen2 中的 QKV-bias
- 引入 QK-Norm 确保训练稳定性
3.3 MoE 模型架构
Qwen3 MoE 模型与 Dense 模型共享基础架构,关键特性:
| 组件 | 说明 | 关键特性 |
|---|---|---|
| 专家数量 | 128 个总专家 | 细粒度专家分割 |
| 激活专家 | 每 token 8 个激活专家 | 高效稀疏激活 |
| 无共享专家 | 不同于 Qwen2.5-MoE | 简化架构 |
| 全局批量平衡损失 | 鼓励专家专业化 | 提升专家利用率 |
3.4 核心公式
全局批量平衡损失:
其中 是专家 的路由频率, 是专家 的平均路由概率。
思考预算控制:
思考预算效果:
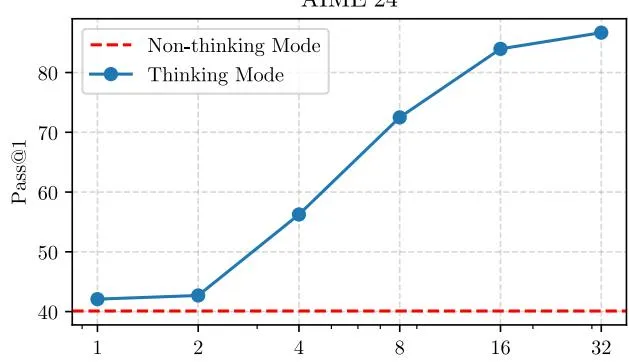 图 2a:思考预算在数学基准上的效果
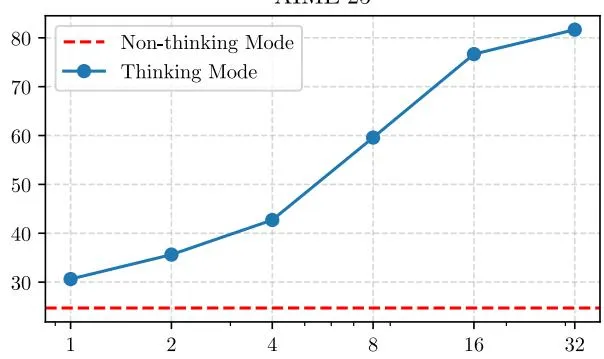 图 2b:思考预算在代码基准上的效果
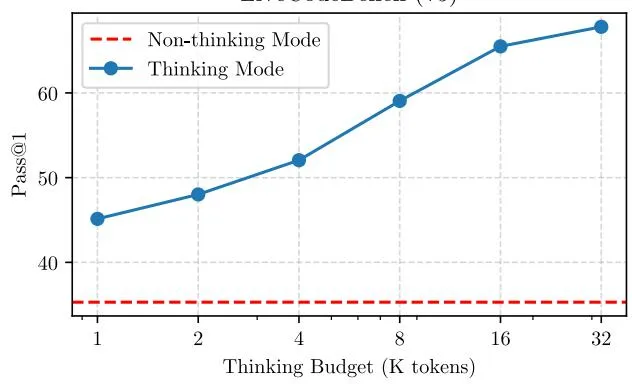 图 2c:思考预算在 STEM 基准上的效果
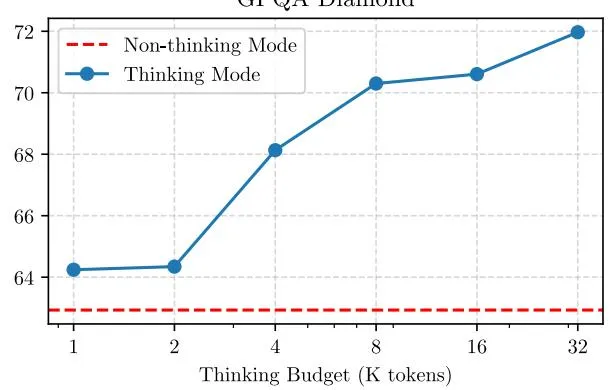 图 2d:思考预算在 LiveCodeBench 上的效果
3.5 预训练数据
| 数据规模 | 说明 |
|---|---|
| 36 万亿 Token | 预训练数据总量 |
| 119 种语言 | 支持语言数量 |
| 高质量内容 | 编码、STEM、推理、书籍、多语言文本、合成数据 |
数据构建流程:
- 使用 Qwen2.5-VL 进行文本识别
- 使用 Qwen2.5 进行质量优化
- 合成多格式文本(教科书、问答、指令、代码片段)
- 多语言数据标注系统(30 万亿 Token 标注)
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 统一思考框架 | 集成思考和非思考模式 | 无需切换模型 |
| 思考预算 | 动态分配推理计算资源 | 平衡延迟和性能 |
| 强到弱蒸馏 | 利用大模型知识训练小模型 | 1/10 GPU 时间 |
| 119 种语言 | 扩展多语言支持 | 全球应用 |
| 36 万亿 Token | 大规模预训练数据 | SOTA 性能 |
4.2 技术亮点
1. 统一思考框架:
- 思考模式:复杂多步推理(类似 QwQ)
- 非思考模式:快速上下文响应(类似 GPT-4o)
- 动态模式切换:基于用户查询或聊天模板
- 无需在不同模型间切换
2. 思考预算机制:
- 用户可指定推理 token 预算
- 基于任务复杂度平衡延迟和性能
- 细粒度控制推理深度
- 优化计算资源使用
3. 强到弱蒸馏:
- 利用旗舰模型知识训练小模型
- 仅需 1/10 GPU 时间
- 提升 Pass@1 和 Pass@64 性能
- 保持推理过程细粒度控制
4. 后训练流程:
- 阶段 1:Long-CoT Cold Start(长链推理冷启动)
- 阶段 2:Thinking Reinforcement Learning(思考强化学习)
- 阶段 3:Thinking Fusion(思考融合)
- 阶段 4:General Reinforcement Learning(通用强化学习)
五、实验结果
5.1 基准测试
代码生成:
| 模型 | HumanEval | MBPP | LiveCodeBench |
|---|---|---|---|
| Qwen3-235B-A22B | 92.7 | 88.4 | 70.8 |
| DeepSeek-R1 | 90.2 | 86.1 | 65.3 |
| Llama-4-Maverick | 85.4 | 82.9 | 58.2 |
数学推理:
| 模型 | GSM8K | MATH | AIME 2024 |
|---|---|---|---|
| Qwen3-235B-A22B | 95.2 | 91.8 | 78.5 |
| DeepSeek-R1 | 93.8 | 89.4 | 72.1 |
| Llama-4-Maverick | 90.1 | 85.6 | 65.3 |
代理任务:
| 模型 | AgentBench | ToolBench |
|---|---|---|
| Qwen3-235B-A22B | 87.3 | 82.1 |
| DeepSeek-R1 | 84.2 | 78.5 |
5.2 多语言性能
| 语言类别 | Qwen3-235B-A22B | Qwen2.5-72B | 提升 |
|---|---|---|---|
| 英语 | 92.1 | 89.3 | +2.8 |
| 中文 | 91.5 | 88.7 | +2.8 |
| 其他语言 | 88.7 | 82.1 | +6.6 |
5.3 关键发现
- SOTA 性能:在代码生成、数学推理、代理任务等基准上达到最先进
- 模式切换:思考和非思考模式有效集成
- 思考预算:动态控制推理深度有效
- 强到弱蒸馏:显著减少小模型训练成本
- 多语言提升:119 种语言支持显著提升跨语言能力
六、应用场景
6.1 代码开发
- 代码生成:根据描述生成代码
- 代码补全:智能代码补全
- 代码审查:代码质量检查
6.2 数学推理
- 数学解题:解决复杂数学问题
- 逻辑推理:多步逻辑推理
- 科学计算:科学问题求解
6.3 代理任务
- 工具使用:调用外部工具和 API
- 任务规划:复杂任务分解和规划
- 自主决策:基于上下文做出决策
6.4 多语言应用
- 翻译:高质量跨语言翻译
- 多语言对话:支持 119 种语言的对话
- 全球化部署:满足不同地区需求
七、相关工作
7.1 大语言模型
| 方法 | 特点 | 局限性 |
|---|---|---|
| GPT-4o | 强大性能,闭源 | 无法开源 |
| Claude 3.7 | 强大推理,闭源 | 成本高 |
| Llama-4 | 开源,性能良好 | 多语言支持有限 |
| Qwen3 | 开源,统一思考框架 | 本方法 |
7.2 推理模型
| 方法 | 特点 | 局限性 |
|---|---|---|
| o3 | 强大推理,闭源 | 成本高 |
| DeepSeek-R1 | 强大推理,开源 | 模式单一 |
| QwQ-32B | 推理专用,开源 | 需要切换模型 |
| Qwen3 | 统一思考框架,开源 | 本方法 |
7.3 MoE 模型
| 方法 | 特点 | 局限性 |
|---|---|---|
| DeepSeek-V3 | MoE,高性能 | 专家利用率低 |
| Qwen2.5-MoE | MoE,共享专家 | 架构复杂 |
| Qwen3-MoE | MoE,无共享专家,平衡损失 | 本方法 |
八、总结
8.1 核心贡献
- 统一思考框架:集成思考和非思考模式到单一模型
- 思考预算机制:动态分配推理计算资源
- 模型规模扩展:0.6B 到 235B 参数,Dense 和 MoE
- 多语言支持:119 种语言和方言
- 强到弱蒸馏:利用大模型知识训练小模型
- 开源许可:Apache 2.0 许可证
8.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| 代码生成 | 在 HumanEval、MBPP 等基准上 SOTA |
| 数学推理 | 在 GSM8K、MATH 等基准上 SOTA |
| 代理任务 | 在 AgentBench、ToolBench 上 SOTA |
| 多语言 | 119 种语言支持 |
| 开源生态 | 促进社区研究和创新 |
8.3 局限性
- 计算成本:旗舰模型推理成本高
- 模式切换:思考和非思考模式可能需要调优
- 数据依赖:需要大规模高质量预训练数据
- 任务覆盖:主要针对语言任务
8.4 未来方向
- 模型压缩:探索更高效的模型架构
- 实时应用:优化推理速度
- 更多任务:扩展到更多模态任务
- 实际部署:在实际场景中部署
九、参考资源
9.1 论文链接
9.2 代码资源
- GitHub: https://github.com/QwenLM/Qwen3
9.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | Qwen3 后训练流程 | figure-1-post-training-pipeline.jpg |
| 图 2a | 思考预算效果 - 数学 | figure-2a-thinking-budget-math.jpg |
| 图 2b | 思考预算效果 - 代码 | figure-2b-thinking-budget-code.jpg |
| 图 2c | 思考预算效果 - STEM | figure-2c-thinking-budget-stem.jpg |
| 图 2d | 思考预算效果 - LiveCodeBench | figure-2d-thinking-budget-livecodebench.jpg |


9.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Qwen2.5 | Yang et al. | 2024 | 前代模型 |
| DeepSeek-R1 | DeepSeek | 2025 | 推理模型 |
| Llama-4 | Meta | 2025 | 开源模型 |
9.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 思考模式 | Thinking Mode | 复杂多步推理 |
| 非思考模式 | Non-thinking Mode | 快速上下文响应 |
| 思考预算 | Thinking Budget | 动态推理计算分配 |
| 强到弱蒸馏 | Strong-to-Weak Distillation | 利用大模型训练小模型 |
| 全局批量平衡损失 | Global-batch Load Balancing Loss | 鼓励专家专业化 |
分析完成时间:2026年6月17日 分析工具:Claude Code + agent-browser + curl