Seed1.5-VL Technical Report
通用多模态理解与推理视觉语言基础模型,532M视觉编码器 + 20B活跃参数MoE LLM
Seed1.5-VL Technical Report
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Seed1.5-VL Technical Report |
| 作者 | Dong Guo, Faming Wu, Feida Zhu, Fuxing Leng, Guang Shi, et al. (140+ authors) |
| 机构 | ByteDance Seed |
| 论文 | https://arxiv.org/abs/2505.07062 |
| 模型 | Volcano Engine Model ID: doubao-1-5-thinking-vision-pro-250428 |
| 发布 | 2025年5月11日 |
| 许可 | 未明确 |
二、核心思想
问题定义
当前视觉语言模型(VLMs)在通用性方面仍与人类水平存在差距,特别是在以下任务中:
- 3D空间理解
- 物体计数
- 想象性视觉推理
- 交互式游戏
这些局限性源于:
- 高质量视觉-语言标注数据稀缺:不像LLM有丰富的文本语料,VLM缺乏同等丰富多样的视觉-语言标注
- 多模态数据的异构性:增加了训练和推理的复杂性
解决方案概述
Seed1.5-VL通过以下关键创新解决这些问题:
- 紧凑高效架构:532M参数视觉编码器(Seed-ViT) + 20B活跃参数MoE LLM
- 多样化数据合成管道:针对OCR、视觉定位、计数、视频理解、长尾知识等关键能力
- 多阶段训练流程:ViT预训练 → VLM预训练(3阶段) → 后训练(SFT + RL)
- 训练基础设施创新:混合并行策略、视觉token重分布、并行感知数据加载
核心成果:在60个公共基准中的38个上达到SOTA性能,包括MMMU 77.9分。
三、技术架构
整体框架图
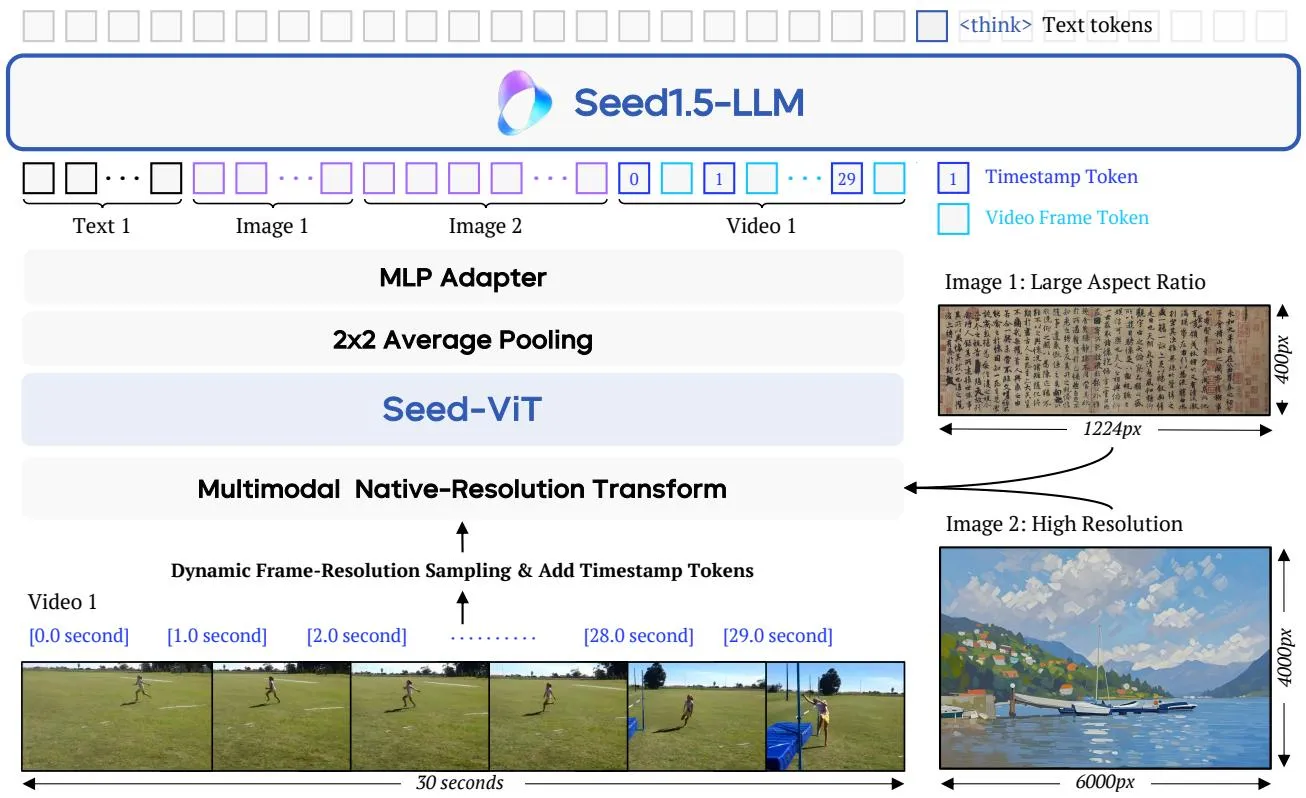
Seed1.5-VL由三个主要组件构成:
- SeedViT:编码图像和视频,原生支持动态分辨率,使用2D RoPE位置编码
- MLP Adapter:将视觉特征投影为多模态token,使用2×2平均池化
- Large Language Model:处理多模态输入的MoE架构LLM
视觉编码器 (Seed-ViT)
| 参数 | 值 |
|---|---|
| Patch size | 14 |
| 位置编码 | 2D RoPE |
| Head dim | 64 |
| Num heads | 20 |
| Embed dim | 1280 |
| MLP ratio | 4.0 |
| Depth | 27 |
| 总参数 | 532M |
Seed-ViT预训练三阶段:
| 阶段 | 方法 | 数据 | 关键特点 |
|---|---|---|---|
| Stage 1 | MIM with 2D RoPE | 2.2B无标签图像 | 使用EVA02-CLIP-E作为教师,75% mask率 |
| Stage 2 | 原生分辨率对比学习 | 4.8B图文对 | SigLIP损失 + SuperClass损失 |
| Stage 3 | 全模态预训练 | 65M视频-音频-文本 | MiCo框架,仅占4.8% token预算 |
视频编码
动态帧-分辨率采样策略:
- 默认采样率:1 FPS
- 详细时间信息任务:2 FPS
- 视频计数/运动跟踪:5 FPS
- 时间戳token:每帧前添加
[1.5 second] - 最大预算:81,920 tokens/视频
- 分辨率层级:{640, 512, 384, 256, 160, 128} tokens/帧
核心公式
缩放定律分析:
在log-log空间:
OCR数据缩放:
Grounding数据缩放:
下游任务性能预测(log-linear关系):
训练流程
VLM预训练三阶段
| 阶段 | 预算 | 序列长度 | 可训练组件 | Batch size | 最大学习率 |
|---|---|---|---|---|---|
| Stage 0 | 16B | 32,768 | MLP adapter | 8.4M | 2.52×10⁻⁴ |
| Stage 1 | 3T | 32,768 | 全部 | 71M | 5.22×10⁻⁵ |
| Stage 2 | 240B | 131,072 | 全部 | 71M | 5.22×10⁻⁶ |
关键设计决策:
- Stage 0仅训练MLP adapter(冻结ViT和LLM)
- Stage 1加入5%文本token保持语言能力
- Stage 2增加视频、编码、3D数据,序列长度增至131K
- 使用AdamW优化器,β₁=0.9, β₂=0.95, weight decay=0.1
后训练流程
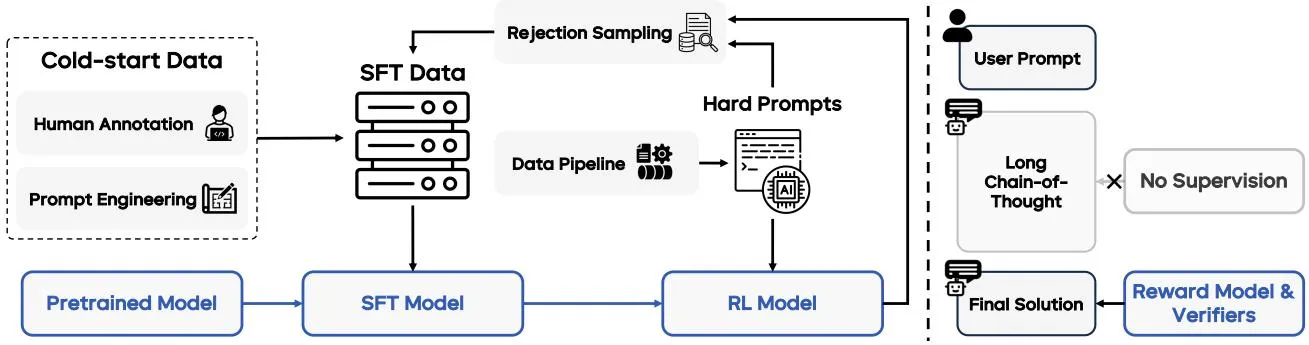
后训练包含迭代更新:
- SFT阶段:约50,000高质量样本 + LongCoT数据
- RLHF阶段:
- 人类标注偏好数据(5级评分系统)
- 合成偏好数据(基于ground-truth的正确性排序)
- VLM作为奖励模型(生成式分类器)
- RLVR阶段:可验证奖励的强化学习
- 混合RL:结合人类反馈和可验证奖励
- 迭代RFT:拒绝采样微调
关键创新:
- 监督仅应用于最终生成输出,不监督chain-of-thought推理过程
- 使用数据管道持续收集hard prompts用于RL和SFT
预训练数据
| 数据类别 | 规模 | 关键特点 |
|---|---|---|
| 通用图文对 & 知识 | 3T tokens总计 | 长尾分布平衡、VLM自动标注 |
| OCR | 10亿+样本 | 文档、场景文本、表格、图表、流程图 |
| 视觉定位 & 计数 | 248M样本 | 边界框、中心点、计数数据 |
| 3D空间理解 | 3.2B tokens | 深度排序、绝对深度估计、3D定位 |
| 视频 | 多类别 | 通用理解、时间定位、流式数据 |
| STEM | 1亿+练习 | 数学、物理、化学、生物 |
| GUI | 大规模 | UI-TARS数据,网页/应用/桌面 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 原生分辨率视觉编码 | Seed-ViT使用2D RoPE支持任意分辨率 | 零样本分类82.5%准确率,与6B参数模型相当 |
| 动态帧-分辨率采样 | 联合优化时间和空间维度 | 最大81,920 tokens/视频,6级分辨率分配 |
| 多模态缩放定律 | 发现训练损失与下游性能的log-linear关系 | 可预测ChartQA、InfoVQA、RefCOCO性能 |
| VLM作为奖励模型 | 生成式分类器直接输出偏好指示token | 比Bradley-Terry模型更鲁棒 |
| 不监督CoT的RL | 仅对最终输出施加监督 | 模型自然发展视觉CoT策略 |
| 混合并行策略 | 针对非对称架构的并行优化 | 解决ViT与LLM之间的计算不平衡 |
| 视觉token重分布 | 平衡GPU工作负载 | 提高训练吞吐量 |
五、实验结果
零样本分类(Seed-ViT)
| 模型 | 参数 | ImageNet-1K | ImageNet-V2 | ImageNet-A | ImageNet-R | ObjectNet | 平均 |
|---|---|---|---|---|---|---|---|
| OpenCLIP-G/14 | 1.8B | 80.4 | 73.6 | 69.3 | 92.8 | 73.0 | 76.5 |
| DFN-5B-CLIP-H/14++ | 632M | 84.3 | 78.3 | 79.6 | 94.9 | 78.0 | 81.4 |
| Seed-ViT | 532M | 83.6 | 77.6 | 85.5 | 95.2 | 79.2 | 82.5 |
| InternVL-C | 6B | 83.2 | 77.3 | 83.8 | 95.7 | 80.6 | 82.5 |
| EVA-CLIP-18B | 17.5B | 83.8 | 77.9 | 87.3 | 95.7 | 82.2 | 83.6 |
公共视觉-语言基准
多模态推理
| 基准 | Seed1.5-VL (thinking) | Gemini 2.5 Pro | OpenAI o1 | Claude 3.7 | GPT-4o | Qwen2.5-VL 72B |
|---|---|---|---|---|---|---|
| MMMU | 77.9 | 81.7 | 77.6 | 75.2 | 70.7 | 70.2 |
| MMMU-Pro | 67.6 | 68.8 | 66.4 | 50.1 | 54.5 | 51.1 |
| MathVision | 68.7 | 73.3 | 63.2 | 58.6 | 31.2 | 38.1 |
| MathVista | 85.6 | 82.7 | 71.8 | 74.5 | 63.8 | 74.8 |
| V* | 89.0 | 79.1 | 69.7 | 86.4 | 73.9 | 86.4 |
| VLM are Blind | 92.1 | 84.3 | 57.0 | 69.0 | 50.4 | 69.0 |
| VisuLogic | 35.0 | 31.0 | 29.0 | 24.8 | 26.3 | 28.0 |
文档与图表理解
| 基准 | Seed1.5-VL (thinking) | Gemini 2.5 Pro | Qwen2.5-VL 72B |
|---|---|---|---|
| TextVQA | 81.8 | 76.8 | 83.5 |
| DocVQA | 96.9 | 94.0 | 96.4 |
| InfographicVQA | 91.2 | 84.3 | 87.3 |
| ChartQA | 89.1 | 83.3 | 89.5 |
| OCRBench | 861 | 866 | 885 |
定位与计数
| 基准 | Seed1.5-VL (thinking) | Gemini 2.5 Pro | Qwen2.5-VL 72B |
|---|---|---|---|
| RefCOCO-avg | 91.3 | 74.6 | 90.3 |
| CountBench | 93.7 | 91.0 | 93.6 |
| FSC-147 ↓ | 17.9 | 24.5 | 28.6 |
| BLINK | 72.1 | 70.6 | 64.4 |
| LVIS-MG | 72.5 | 63.8 | - |
3D空间理解
| 基准 | Seed1.5-VL (thinking) | Gemini 2.5 Pro | Qwen2.5-VL 72B |
|---|---|---|---|
| DA-2K | 91.7 | 73.0 | 69.6 |
| NYU-Depth V2 ↓ | 13.6 | 27.5 | 35.5 |
| All-Angles Bench | 58.6 | 53.4 | 55.7 |
视频基准
| 类别 | 基准 | Seed1.5-VL (thinking) | 先前SOTA |
|---|---|---|---|
| 短视频 | MotionBench | 68.4 | 62.8 (GLM-4V) |
| 短视频 | TVBench | 63.6 | 62.6 (Gemini 2.5 Pro) |
| 短视频 | TempCompass | 83.7 | 75.8 (Gemini 2.5 Pro) |
| 长视频 | LongVideoBench | 74.0 | 66.7 (GPT-4o) |
| 长视频 | MLVU | 82.1 | 81.2 (Gemini 2.5 Pro) |
| 流式 | OVBench | 60.0 | 54.9 (PMB) |
| 流式 | StreamBench | 72.8 | 68.7 (GPT-4o) |
| 定位 | Charades-STA | 64.0 | 60.7 (SG-DETR) |
| 定位 | TACoS | 49.6 | 42.4 (SG-DETR) |
多模态Agent
GUI定位
| 基准 | Seed1.5-VL | OpenAI CUA | Claude 3.7 | UI-TARS 1.5 |
|---|---|---|---|---|
| ScreenSpot-V2 | 95.2 | 87.9 | 87.6 | 94.2 |
| ScreenSpot-Pro | 60.9 | 23.4 | 27.7 | 61.6 |
GUI Agent
| 基准 | Seed1.5-VL | OpenAI CUA | Claude 3.7 | UI-TARS 1.5 |
|---|---|---|---|---|
| OSWorld | 36.7 | 38.1 | 28.0 | 42.5 |
| WebVoyager | 87.2 | 87.0 | 84.1 | 84.8 |
| Online-Mind2Web | 76.4 | 71.0 | 62.9 | 75.8 |
| AndroidWorld | 62.1 | - | - | 64.2 |
游戏Agent(14个Poki游戏)
| 游戏 | Seed1.5-VL | UI-TARS-1.5 | OpenAI CUA | Claude 3.7 |
|---|---|---|---|---|
| 2048 (score) | 870.6 | 721.3 | 611.2 | 800.0 |
| Hex-Frvr (score) | 1414.0 | 1583.7 | 651.6 | 523.1 |
| Wood-Blocks-3d (score) | 864.0 | 213.3 | 18.1 | 0.0 |
缩放定律分析
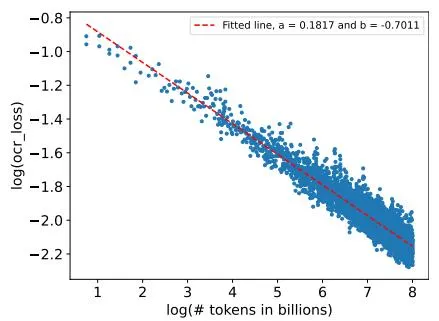
训练损失与训练token数遵循幂律关系。OCR损失与ChartQA/InfoVQA性能呈log-linear关系,可用于预测下游任务性能。
内部基准
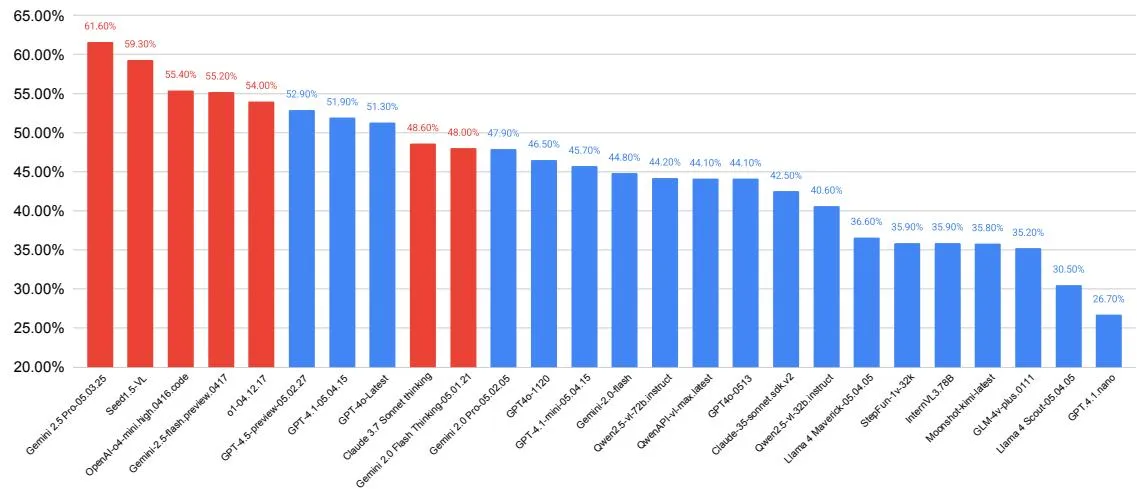
Seed1.5-VL在内部基准上排名第二,在OOD、Agent、原子指令跟随类别中达到SOTA。主要弱项相对于顶级模型在知识、推理、代码方面,部分原因是20B活跃参数的模型规模限制。
六、训练基础设施
大规模预训练创新
- 混合并行策略:针对ViT与LLM之间的非对称架构优化
- 视觉token重分布:平衡GPU工作负载,解决视觉编码器与语言模型之间的计算不平衡
- 并行感知数据加载:最小化3D并行下的I/O瓶颈
- 容错机制:支持大规模训练的故障恢复
系统级优化
- Kernel fusion
- Selective activation checkpointing
- Offloading
- 通信优化(FLUX)
七、相关工作
| 模型 | 规模 | 与Seed1.5-VL的区别 |
|---|---|---|
| GPT-4o | 未公开 | 通用多模态,Seed1.5-VL在定位/计数/3D更强 |
| Gemini 2.5 Pro | 未公开 | 推理能力更强,Seed1.5-VL在Agent/游戏更强 |
| Claude 3.7 Sonnet | 未公开 | Seed1.5-VL在GUI/游戏显著超越 |
| Qwen2.5-VL 72B | 72B dense | Seed1.5-VL用更少活跃参数(20B)达到可比性能 |
| InternVL-2.5 | 未公开 | 视频理解能力接近 |
| UI-TARS 1.5 | 未公开 | GUI专项模型,Seed1.5-VL为通用模型 |
八、总结
核心贡献
- 紧凑高效架构:532M视觉编码器 + 20B活跃参数MoE LLM,在60个基准中38个达到SOTA
- 多样化数据合成:针对OCR、定位、计数、视频、STEM、GUI的专门数据管道
- 多阶段训练流程:ViT预训练(3阶段) → VLM预训练(3阶段) → 后训练(SFT+RL)
- 缩放定律发现:训练损失与下游性能的log-linear关系可用于性能预测
- Agent能力突破:在GUI控制和游戏任务中超越OpenAI CUA和Claude 3.7
- 训练基础设施:混合并行、视觉token重分布、并行感知数据加载
技术影响
- 证明紧凑MoE架构可在多模态任务中达到SOTA
- 发现多模态训练损失与下游性能的可预测关系
- 在Agent任务中的突破为GUI自动化和游戏AI开辟新方向
- 训练基础设施创新为大规模多模态训练提供实用方案
局限性
- 细粒度视觉感知:不规则排列、相似颜色、遮挡物体的计数仍有困难
- 复杂推理:Klotski拼图、简单迷宫等对人类简单但对模型困难
- 组合搜索:需要程序化方法的推理任务仍是挑战
- 3D空间推理:3D物体操作和投影推理仍需改进
- 幻觉:视觉输入与语言先验冲突时仍会产生错误推理
- 时间推理:连续动作时序判断能力有限
- 模型规模:20B活跃参数限制了知识和推理能力,缩放定律显示未饱和
九、参考资源
- arXiv论文
- Volcano Engine API (Model ID: doubao-1-5-thinking-vision-pro-250428)