FloE: On-the-Fly MoE Inference on Memory-constrained GPU
面向内存受限GPU的即时MoE推理系统,通过混合压缩和稀疏预测实现48.7×加速
FloE: On-the-Fly MoE Inference on Memory-constrained GPU
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FloE: On-the-Fly MoE Inference on Memory-constrained GPU |
| 作者 | Yuxin Zhou, Zheng Li, Jun Zhang, Jue Wang, Yiping Wang, Zhongle Xie, Ke Chen, Lidan Shou |
| 机构 | Zhejiang University, Ant Group |
| 论文 | arXiv:2505.05950 |
| 代码 | - |
| 发布 | 2025-05-09 |
| 领域 | 机器学习 (cs.LG), 人工智能 (cs.AI) |
| 会议 | ICML 2025 |
二、核心思想
问题定义
MoE 模型(如 DeepSeek-R1、GPT-4、Mixtral)通过稀疏激活专家来降低推理成本,但未激活的专家占用大量 GPU 内存:
| 组件 | 内存占用 |
|---|---|
| Mixtral-8x7B FP16 总计 | 94GB |
| 激活参数 (30%) | 27.3GB |
| 未激活专家 | 66.8GB |
Offloading 技术将专家参数卸载到 CPU 内存,但 PCIe 带宽瓶颈严重制约性能:
| 带宽 | 速度 |
|---|---|
| DRAM→VRAM (PCIe 4.0) | 32GB/s |
| GPU 内存→片上计算 | 300GB/s |
关键问题:一个 Mixtral 专家 300MB+,传输需要 15ms,但计算仅需 5ms。
解决方案概述
FloE 提出即时 (on-the-fly) MoE 推理系统,核心洞察:
稀疏激活的专家内部存在大量未被利用的冗余
三大技术创新:
- 混合压缩:对不同投影矩阵采用不同压缩策略(稀疏 vs 量化)
- 双稀疏预测器:inter-expert 预测 + intra-expert 预测
- 系统协同优化:高效稀疏 GEMV 内核 + 紧凑异步传输
核心结果:
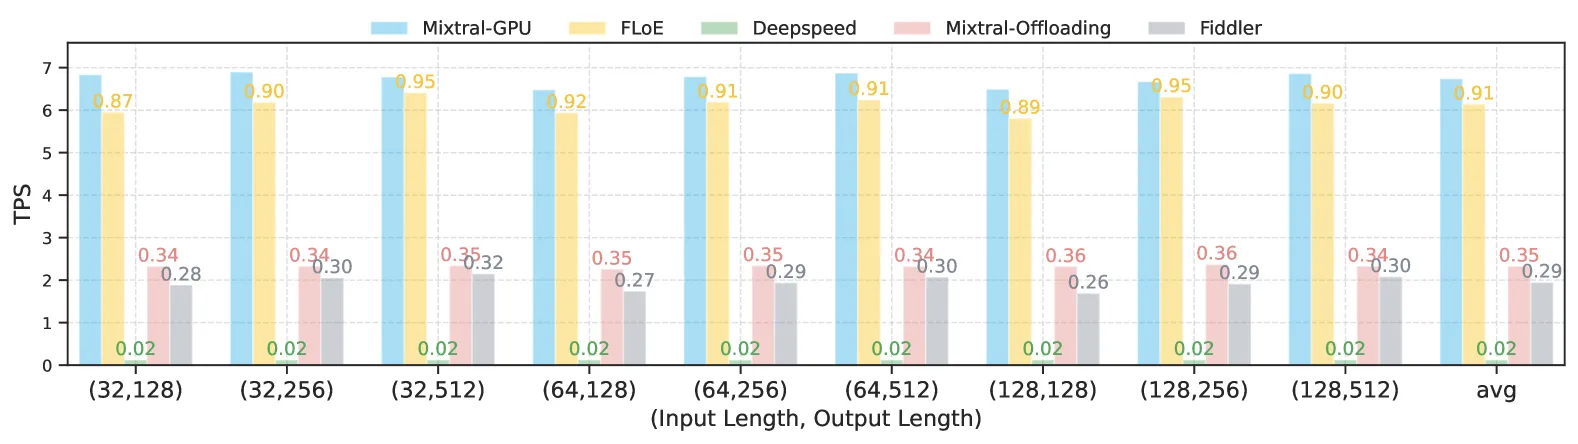
- 推理加速 48.7×(vs DeepSpeed-MII)
- 参数压缩 9.3×
- 内存占用减少 8.5×
- 仅需 11GB VRAM 即可部署
- 性能下降仅 4.4% ~ 7.6%
三、技术架构
系统对比
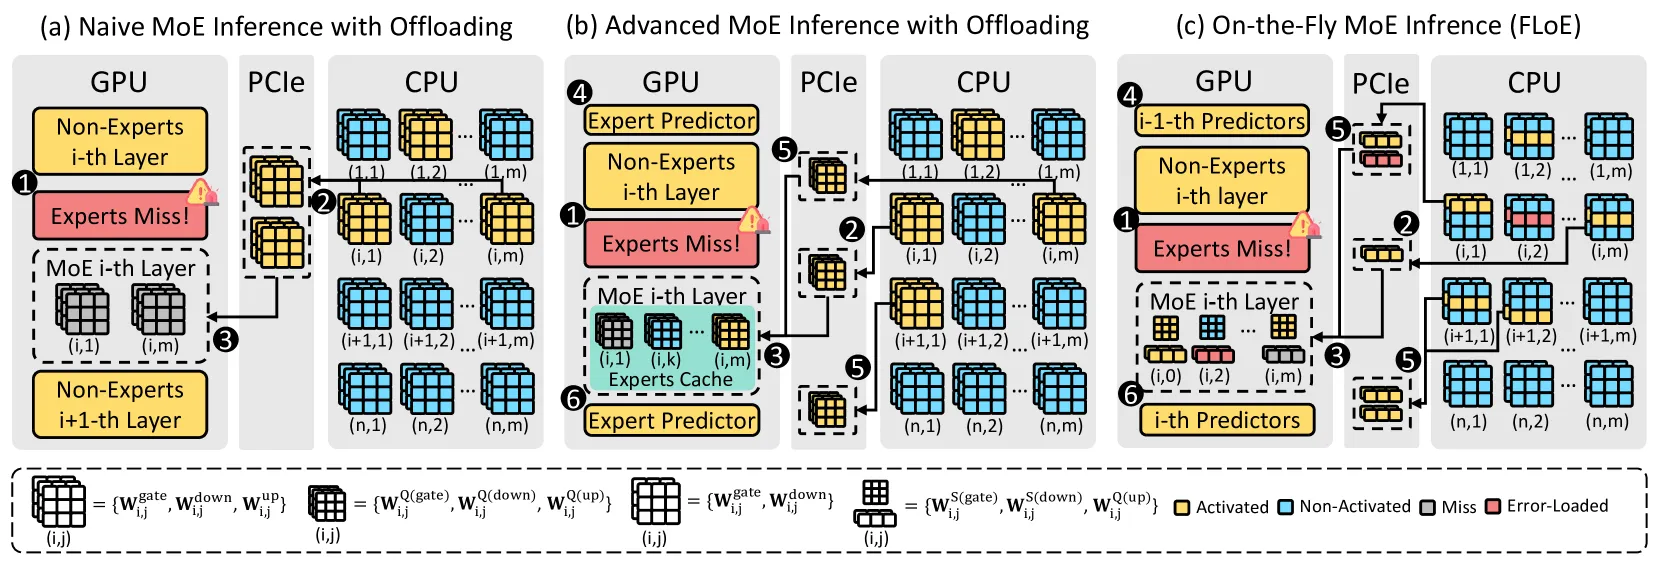
| 方案 | 特点 | 问题 |
|---|---|---|
| (a) Naive Offloading | 按需加载整个专家 | PCIe 带宽瓶颈 |
| (b) Advanced Offloading | 预取 + 缓存 | 仍需传输大量数据 |
| (c) FloE (On-the-Fly) | 压缩 + 预测 + 重叠 | 传输量大幅减少 |
MoE 专家前向计算
SwiGLU-based MoE 每个专家包含三个矩阵:
- W^gate (gate projection)
- W^down (down projection)
- W^up (up projection)
前向公式:
混合压缩策略
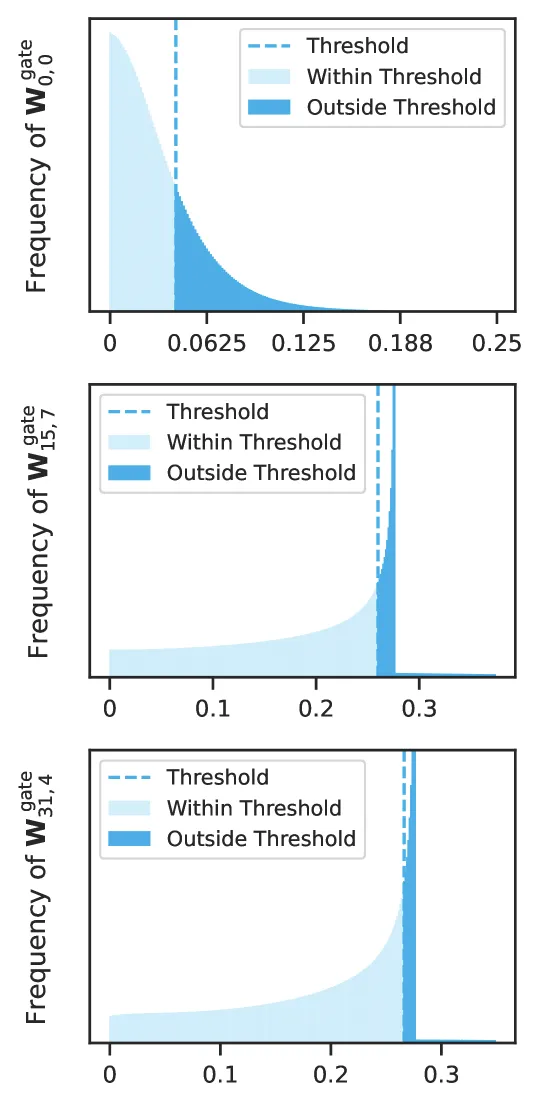
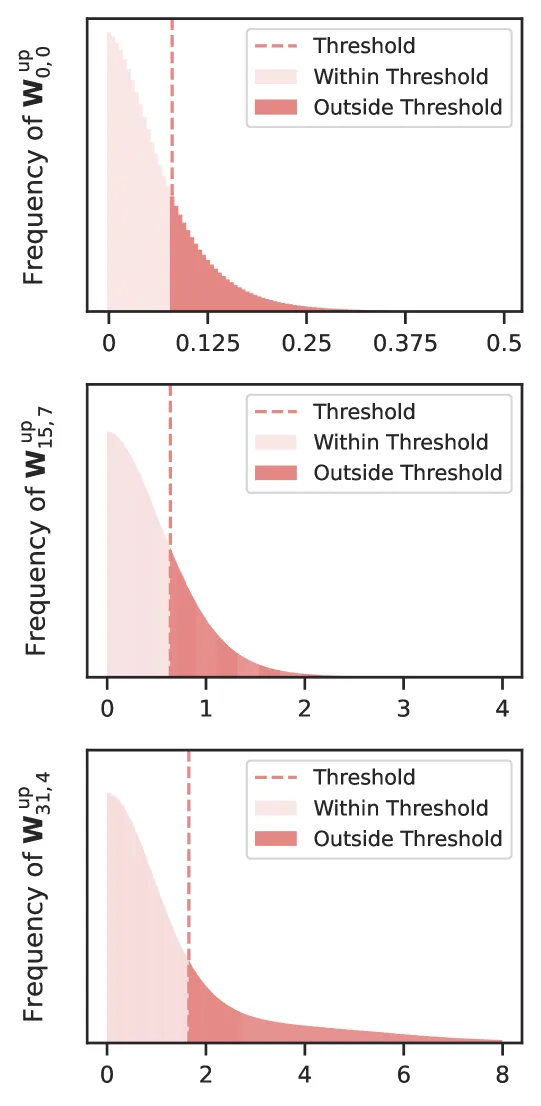
关键观察:
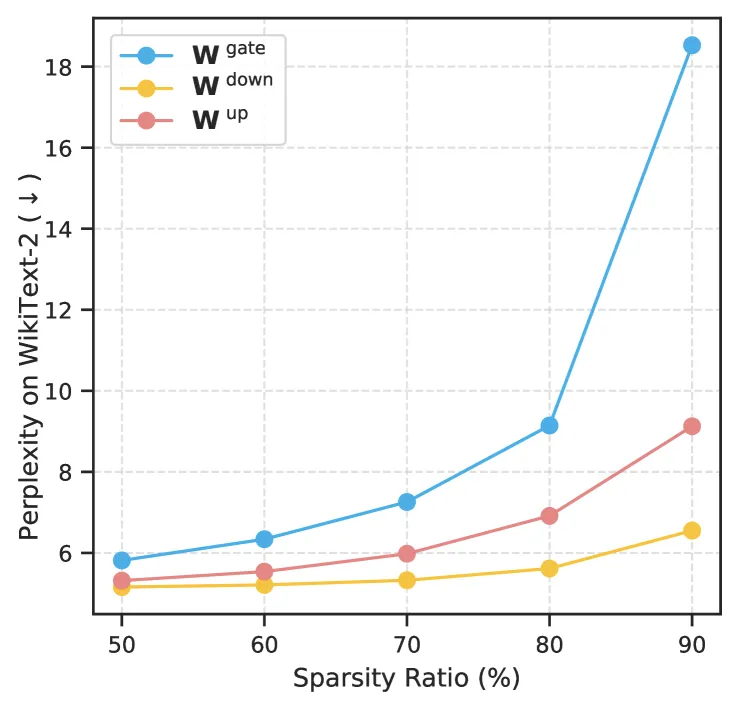
- 观察 1:专家内部保持高度稀疏性,激活值集中在零附近
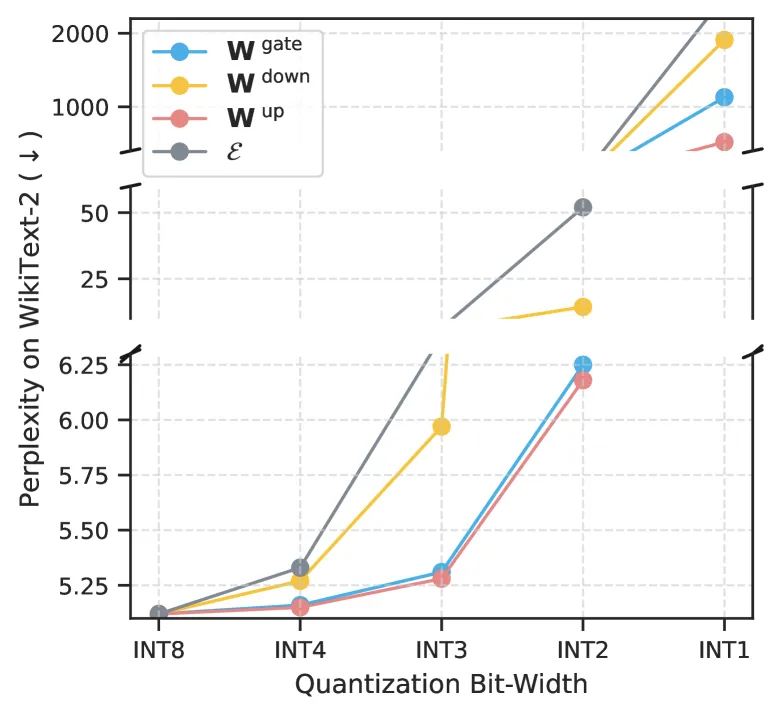
- 观察 2:up projection 对超低比特量化敏感度最低
混合压缩方案:
| 投影矩阵 | 压缩方法 | 原因 |
|---|---|---|
| Gate projection | 激活稀疏化 S(·) | 敏感度中等 |
| Down projection | 激活稀疏化 S(·) | 敏感度最高 |
| Up projection | INT2 量化 Q(·) | 敏感度最低 |
压缩后专家:
敏感度分析
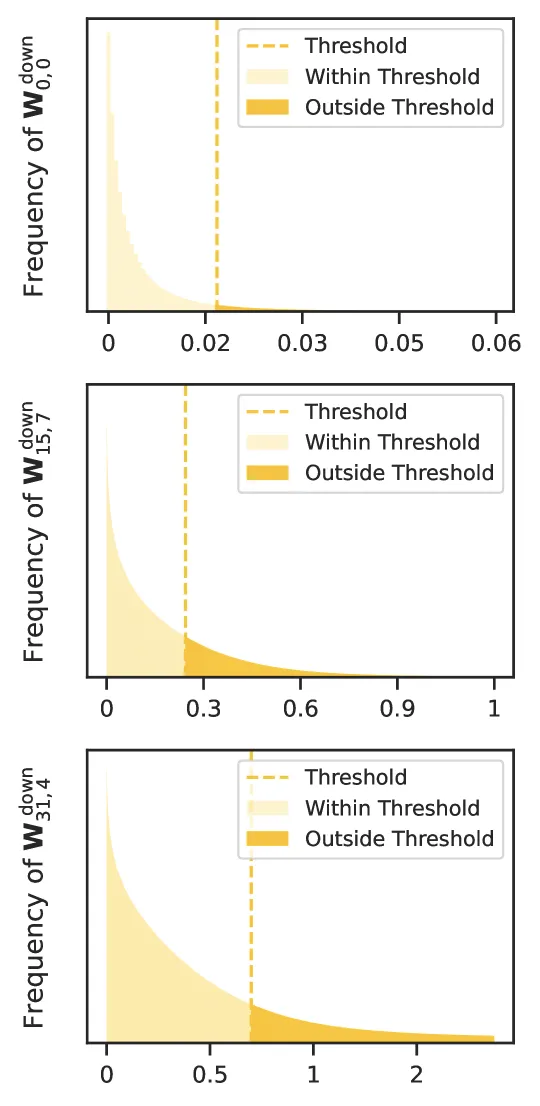
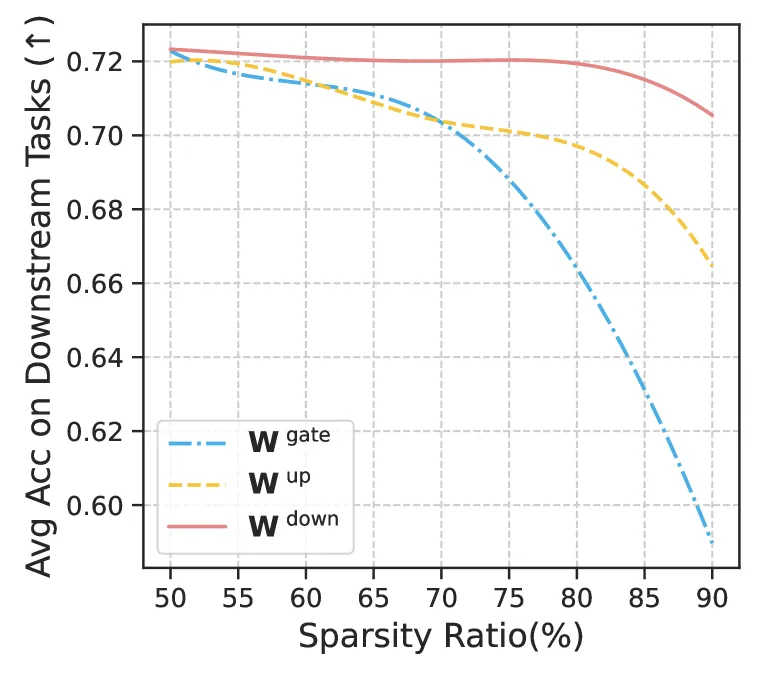
稀疏化敏感度:
| 投影 | 0% | 50% | 70% | 80% | 90% |
|---|---|---|---|---|---|
| Gate | 0.7247 | 0.7228 | 0.7035 | 0.6640 | 0.5897 |
| Up | 0.7199 | 0.7148 | 0.6971 | 0.6646 | - |
| Down | 0.7233 | 0.7210 | 0.7194 | 0.7054 | - |
量化敏感度:
- INT8/INT4:影响极小
- INT2:down 最敏感,up 最不敏感
- INT1:up 保持 gate 的 46%、down 的 27% 性能
双稀疏预测器
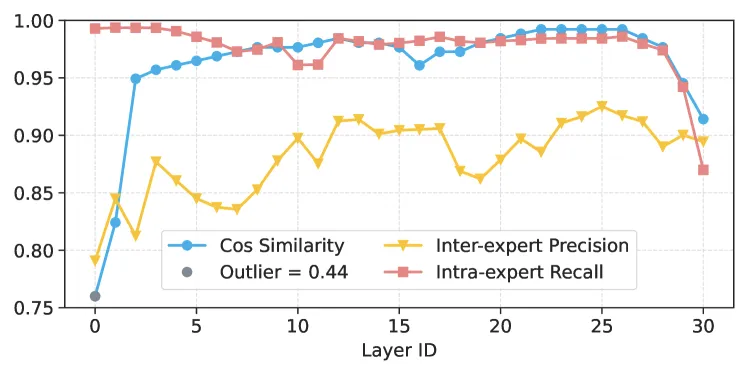
核心观察 3:连续 MoE 层的隐藏状态余弦相似度 > 0.95
Inter-expert Predictor(专家间预测)
| 特性 | 说明 |
|---|---|
| 类型 | 学习型 MLP |
| 输入 | 上一层隐藏状态 + 专家选择历史轨迹 |
| 参数量 | 浅层 32K,深层 2M |
| 精度 | 0.88 |
Intra-expert Predictor(专家内预测)
| 特性 | 说明 |
|---|---|
| 类型 | 无参数、基于复用 |
| 方法 | 隐藏状态 × 复用的 up projection 矩阵 |
| 参数量 | 0(无需额外内存) |
| 召回率 | 0.95 |
对比:PowerInfer/DEJAVU 预测器需要 9GB,SparseInfer 需要 2.19GB
系统协同优化
高效稀疏 GEMV 内核
Algorithm 1: Efficient Sparse Kernel
Input: hidden states x, threshold t_ij, E_ij = {W^gate_ij, W^down_T_ij, W^up_ij}

1: v ← x W^up_ij
2: mask ← (|v| > t_ij)
3: x' ← SiLU(x W^gate_ij[mask]) ⊙ v[mask]
4: output ← x' W^down_T_ij优化:
- 转置 W^down 并使用列主序存储
- 基于阈值选择性加载列
- 融合 SiLU 激活和逐元素乘法
加速:最高 2×
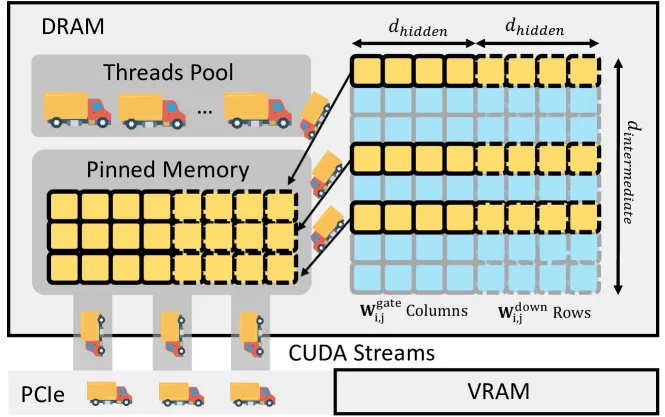
紧凑异步传输
- DRAM 中紧凑权重布局,减少访问延迟
- 多线程打包激活专家
- SIMD 异步数据传输,隐藏延迟于计算中
加速:比朴素方法快 12.6×
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 混合压缩 | Gate/Down 用稀疏,Up 用 INT2 量化 | 比统一压缩性能好 9.8% |
| Inter-expert Predictor | 学习型 MLP 预测下一层专家 | 精度 0.88 |
| Intra-expert Predictor | 无参数复用预测 | 召回率 0.95,零内存开销 |
| 稀疏 GEMV 内核 | Triton-based 高效实现 | 最高 2× 加速 |
| 紧凑异步传输 | 多线程 + SIMD 异步 | 12.6× 传输加速 |
五、实验结果
实验设置
硬件:
- GPU:GeForce RTX 3090 (24GB VRAM)
- CPU:64-core @ 2.3GHz
- DRAM:256GB
- 互联:PCIe 4.0
模型:Mixtral-8x7B
基线:DeepSpeed-MII, Mistral-Offloading, HQQ, CATS, Chess
端到端性能
| 指标 | FloE |
|---|---|
| vs DeepSpeed-MII | 48.7× |
| 参数压缩 | 9.3× |
| 内存减少 | 8.5× |
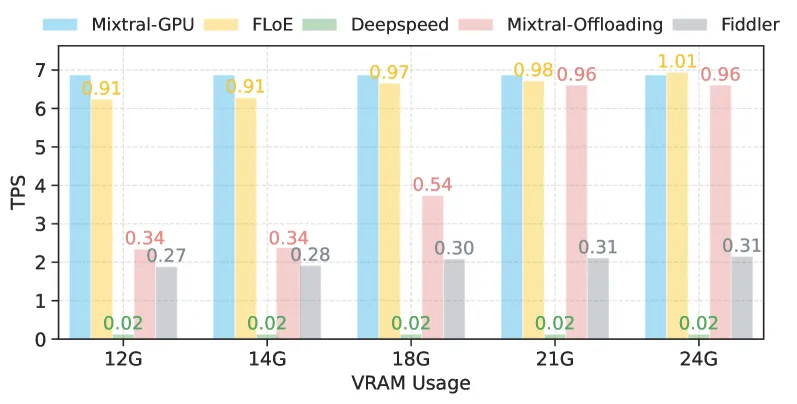
| 最低 VRAM | 11GB |
| 性能下降 | 4.4% ~ 7.6% |
单专家执行延迟
| GPU | 0% | 50% | 70% | 90% | 90% 加速 |
|---|---|---|---|---|---|
| H100 | 0.169ms | 0.134ms | 0.114ms | 0.103ms | 1.64× |
| A100 | 0.253ms | 0.195ms | 0.176ms | 0.155ms | 1.63× |
| A6000 | 0.524ms | 0.365ms | 0.305ms | 0.263ms | 1.99× |
| RTX-3090 | 0.542ms | 0.379ms | 0.316ms | 0.283ms | 1.92× |
传输效率
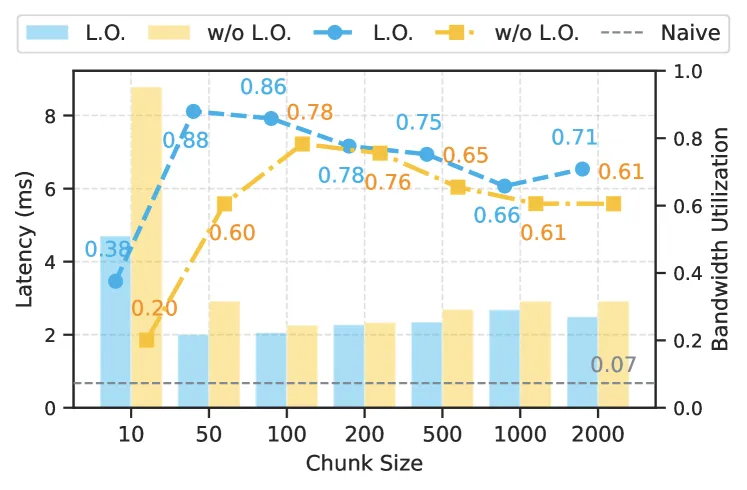
- 紧凑异步传输比朴素方法快 12.6×
- 接近 PCIe 4.0 实际峰值带宽
DRAM 使用影响
FloE 在不同 DRAM 使用量下均保持显著优势。
下游任务性能
| 方法 | MMLU@5 | BoolQ | SciQ | Arc-C | Arc-E | 平均 |
|---|---|---|---|---|---|---|
| Mixtral-8x7B (baseline) | 0.695 | 0.853 | 0.968 | 0.567 | 0.843 | 0.720 |
| HQQ int3 | 0.608 | 0.809 | 0.955 | 0.481 | 0.800 | 0.665 |
| CATS-80% | 0.617 | 0.792 | 0.903 | 0.515 | 0.782 | 0.657 |
| Chess-80% | 0.612 | 0.802 | 0.912 | 0.498 | 0.781 | 0.657 |
| FloE-80% | 0.605 | 0.810 | 0.951 | 0.509 | 0.803 | 0.676 |
| HQQ int2 | 0.234 | 0.485 | 0.331 | 0.212 | 0.279 | 0.311 |
| CATS-90% | 0.377 | 0.704 | 0.826 | 0.442 | 0.709 | 0.559 |
| Chess-90% | 0.424 | 0.727 | 0.839 | 0.410 | 0.694 | 0.568 |
| FloE-90% | 0.531 | 0.835 | 0.952 | 0.458 | 0.762 | 0.644 |
关键发现:
- 90% 稀疏度下,FloE 比其他方法高 9.8%
- 统一 INT2 量化 (HQQ) 性能灾难性下降 (0.311)
- FloE 的混合方法显著优于统一压缩
六、消融实验
压缩策略消融
| 策略 | 80% 平均性能 |
|---|---|
| FloE-W^up (仅稀疏 up) | 0.693 |
| FloE (混合压缩) | 0.676 |
| CATS | 0.657 |
| Chess | 0.657 |
预测器消融
- Inter-expert predictor 精度 0.88
- Intra-expert predictor 召回率 0.95
- 余弦相似度 > 0.95(除第 0 层)
传输消融
紧凑异步传输实现 12.6× 加速。
调度消融
调度策略对整体性能的影响。
七、相关工作
| 方法 | 特点 | FloE 优势 |
|---|---|---|
| DeepSpeed-MII | FP16 offloading | 48.7× 加速 |
| Mistral-Offloading | 层级缓存 | 混合压缩 + 预测 |
| HQQ | 统一量化 | 差异化压缩策略 |
| CATS | 上下文稀疏 | 双预测器 + 量化 |
| Chess | 稀疏方法 | 更高性能保持 |
| MoE-Lightning | CPU-GPU-I/O pipeline | 单 GPU 更简单高效 |
| MoE-Gen | Module-based batching | 在线推理更适用 |
八、总结
核心贡献
- 混合压缩方案:根据投影矩阵敏感度差异,对 gate/down 用稀疏化,对 up 用 INT2 量化
- 双稀疏预测器:
- Inter-expert:学习型 MLP,精度 0.88
- Intra-expert:无参数复用,召回率 0.95
- 系统协同优化:
- 高效稀疏 GEMV 内核(2× 加速)
- 紧凑异步传输(12.6× 加速)
- 实践价值:
- 仅需 11GB VRAM 即可运行 Mixtral-8x7B
- 48.7× 推理加速
- 性能下降仅 4.4% ~ 7.6%
技术影响
- 使大型 MoE 模型在消费级 GPU 上变得可用
- 为 MoE 推理的压缩策略提供了新思路
- 混合压缩 + 预测的范式可推广到其他模型
局限性
- 主要针对 decode 阶段,prefill 优化较少
- 预测器需要离线训练
- 极端稀疏度 (95%+) 下性能下降可能加剧
九、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 系统对比图 | system-comparison.png |
| Figure 2 | 激活分布 | activation-distributions.png |
| Figure 3 | 敏感度分析 | sensitivity-analysis.png |
| Figure 4 | 预测器性能 | predictor-performance.png |
| Figure 5 | 紧凑异步传输 | async-transfer.png |
| Figure 6 | 端到端加速 | end-to-end-speedup.png |
| Figure 7 | 传输延迟 | transfer-latency.png |
| Figure 8 | DRAM 使用影响 | dram-usage.png |
| Figure 9 | 压缩消融 | ablation-compression.png |
| Figure 10 | 预测器消融 | ablation-predictor.png |
| Figure 11 | 传输消融 | ablation-transfer.png |
| Figure 12 | 调度消融 | ablation-scheduling.png |