Prism: Cost-Efficient Multi-LLM Serving via GPU Memory Ballooning
Prism 通过 GPU 内存气球技术实现多 LLM 共享服务,统一时间共享和空间共享,SLO 达标率下支持 2.3-3.5x 更多请求,已在 10K+ GPU 生产环境部署
Prism: Cost-Efficient Multi-LLM Serving via GPU Memory Ballooning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Prism: Cost-Efficient Multi-LLM Serving via GPU Memory Ballooning |
| 作者 | Shan Yu, Yifan Qiao, Mingyuan Ma, Yangmin Li, Shuo Yang, Xinyuan Tong, Yang Wang, Zhiqiang Xie, Yuwei An, Shiyi Cao, Ke Bao, Deepak Vij, Xiaoning Ding, Yichen Wang, Qingda Lu, Zhong Wang, Gao Gao, Harry Xu, Junyi Shu, Jiarong Xing, Ying Sheng |
| 机构 | Sky Computing Lab, UC Irvine / Alibaba Cloud / NVIDIA |
| 论文 | arXiv:2505.04021 |
| 代码 | github.com/ovg-project/kvcached |
| 会议 | OSDI’26 |
| 发布 | 2025-05-06 (v1), 2026-06-10 (v3) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
多 LLM 服务面临 GPU 严重利用不足的挑战:
| 挑战 | 说明 | 现有方法的局限 |
|---|---|---|
| GPU 利用率低 | GPU duty cycle 常低于 30%,大量空闲内存浪费 | 静态分配导致资源碎片化 |
| 时间共享抖动 | 模型频繁换入换出导致 PCIe 传输瓶颈 | QLM 等时间共享方案在重叠活跃时 thrashing |
| 空间共享僵化 | 空闲模型权重锁定 GPU 内存 | MuxServe 等空间共享方案无法释放空闲资源 |
| 需求动态变化 | 突发模型组随时间快速转移 | 无原则性机制适应动态工作负载变化 |
核心观察:生产环境分析揭示了动态突发模式(bursty-group pattern),模型活跃组随时间转移,现有方法无法同时满足 SLO 和效率。
解决方案概述
Prism 采用内存气球(Memory Ballooning)技术统一时间和空间共享:
-
kvcached 驱动:GPU 内存层面的弹性管理
- 统一模型权重和 KV Cache 管理
- 跨模型透明内存重分配
- 快速模型加载(引擎池复用)
-
内存感知调度:
- KVPR(KV Pressure Ratio)驱动的模型放置
- Slack-aware 请求仲裁(Moore-Hodgson 算法)
- TTFT 优先的 SLO 优化
-
系统架构:
- 前端请求路由
- 全局调度器(模型放置决策)
- 本地调度器(请求调度)
- 弹性内存池(按需分配/回收)
三、技术架构
整体框架图
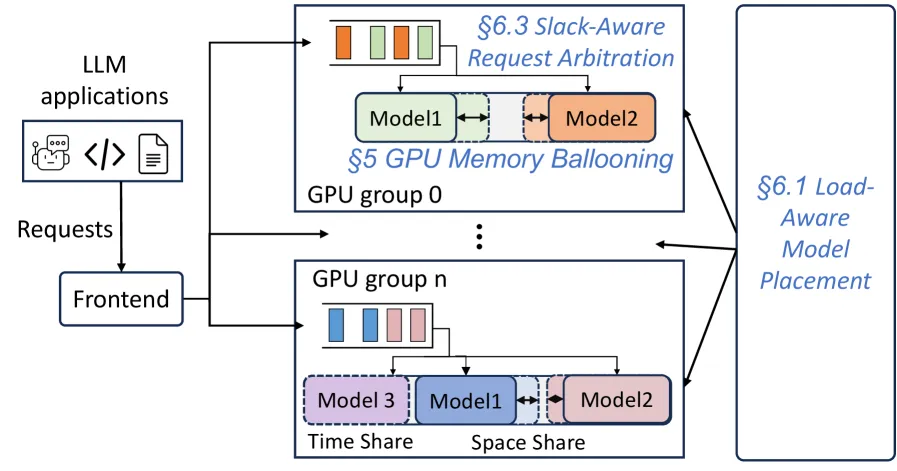
Prism Architecture
├── Frontend (请求路由)
│   ├── Request Router
│   └── Redis Queue (请求缓存)
├── Global Scheduler (全局调度)
│   ├── KVPR 模型放置算法
│   ├── 负载感知调度
│   └── ZeroMQ 通信
├── Local Scheduler (本地调度)
│   ├── Slack-aware Request Arbitration
│   ├── Moore-Hodgson 算法
│   └── Per-GPU 请求队列
├── kvcached (内存气球驱动)
│   ├── GPU 物理内存管理
│   ├── 虚拟地址空间映射
│   ├── 按需物理页创建
│   └── 弹性扩展/收缩
└── Engine Pool (引擎池)
    ├── 预初始化引擎
    ├── 虚拟地址空间复用
    └── 快速模型激活
生产环境负载分析
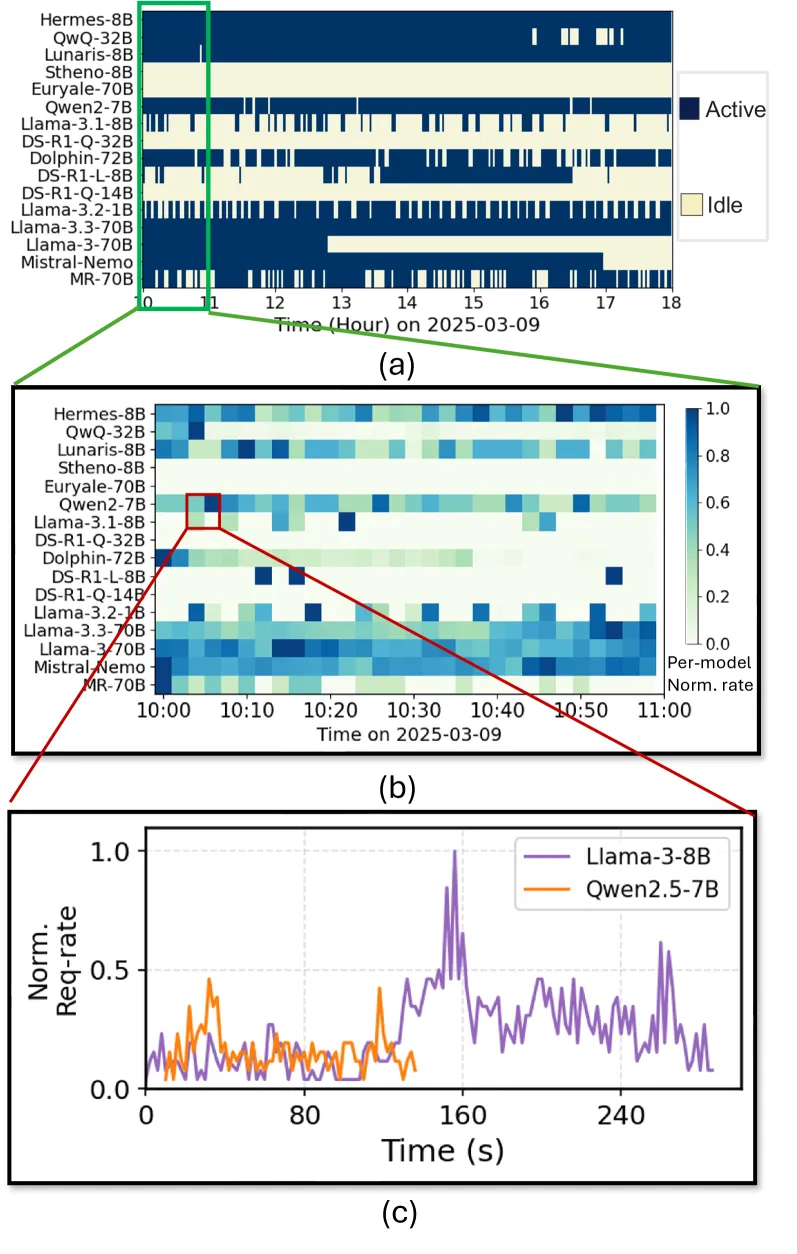
关键发现:
| 观察 | 说明 | 影响 |
|---|---|---|
| 突发模型组 | 仅 23%-50% 模型同时活跃,活跃组每小时变化 54-766 次 | 需要动态资源分配 |
| 请求速率极端波动 | CV > 1,每小时 40-100 次空闲区间 | 需要快速响应能力 |
| 模式突然切换 | 活跃组在无预警下转移 | 无法依赖历史稳定性预测 |
| 异构激活模式 | 部分模型持续活跃,部分仅偶尔激活 | 需要差异化服务策略 |
时间/空间共享失败案例
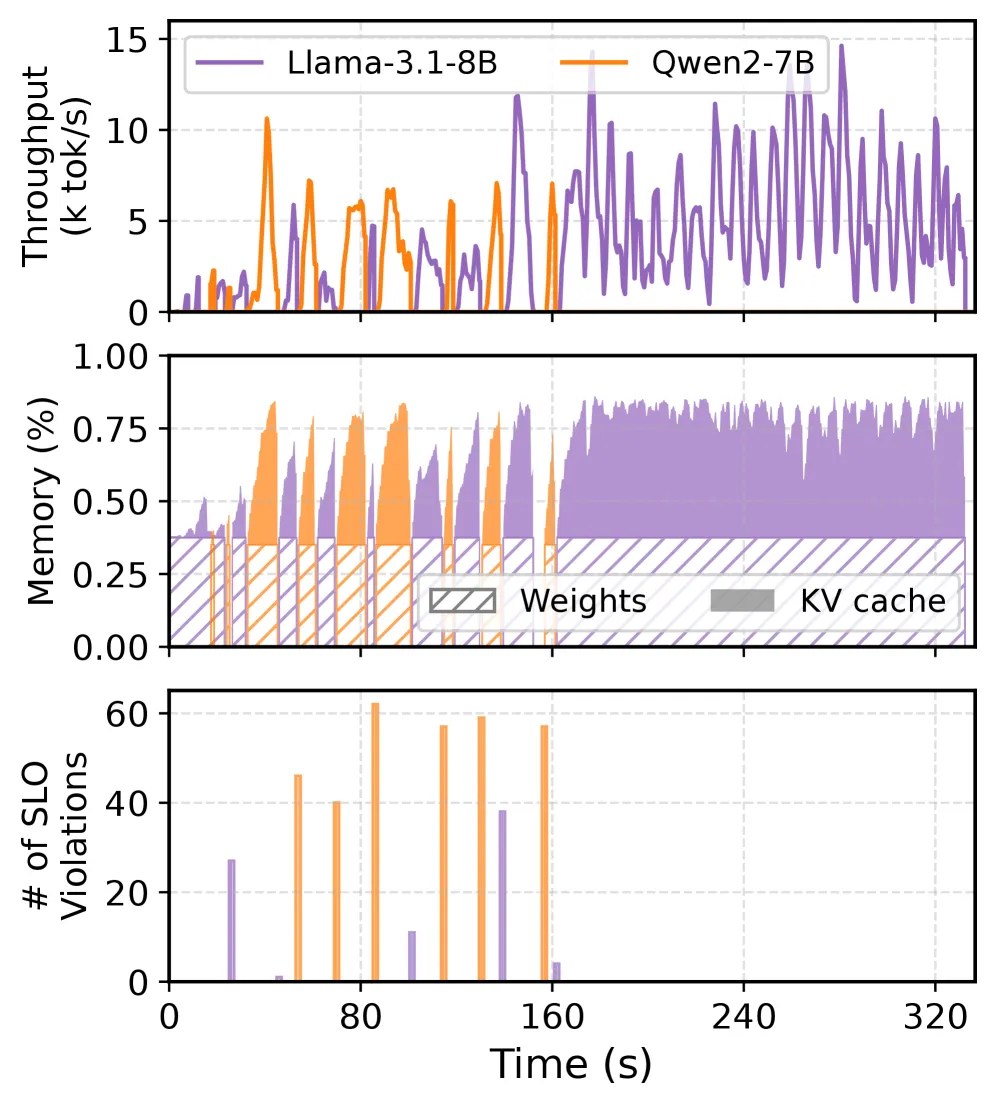
| 共享方式 | 问题 | 失败场景 |
|---|---|---|
| 纯时间共享 | 模型频繁换入换出 | 两模型同时活跃时 thrashing |
| 纯空间共享 | 空闲模型权重锁定 | 活跃模型突发时内存不足 |
GPU 内存气球机制
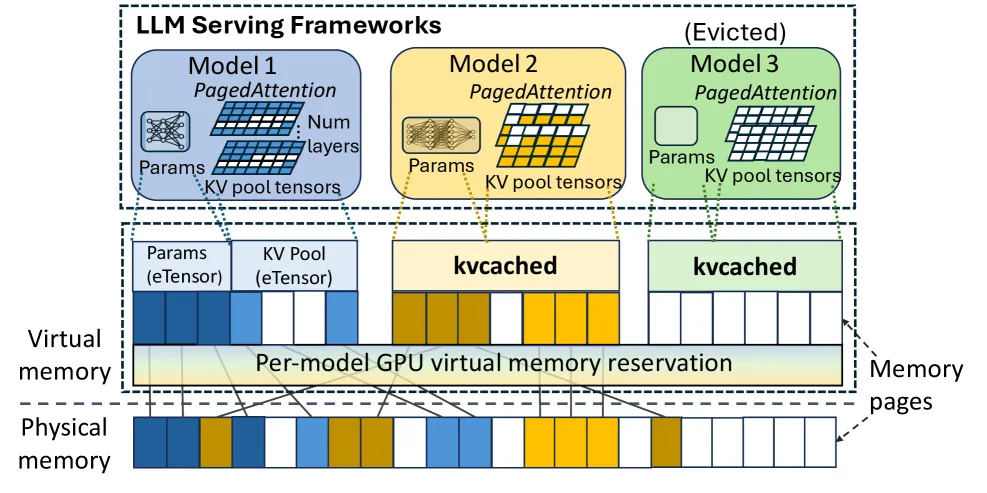
核心设计:
| 设计 | 说明 | 解决的问题 |
|---|---|---|
| D1: 统一管理 | 模型权重和 KV Cache 统一虚拟/物理内存管理 | 权重-KV Cache 快速重分配 |
| D2: 自动映射 | Token Block 自动映射到物理页 | 异构模型 KV Cache 共享 |
| D3: 弹性扩展 | 按需创建物理页,懒加载映射 | 动态工作负载适应 |
工作原理:
应用层 (Engine)
├── 虚拟地址空间 (连续)
│   ├── Model Weights
│   ├── KV Cache Pool
│   └── Intermediate Buffers
│
kvcached (Shim Layer)
├── 物理页管理
│   ├── 按需创建 (On-Demand)
│   ├── 懒加载映射 (Lazy Mapping)
│   └── 弹性扩展/收缩
│
GPU 物理内存
├── Page 0: [Weight Block 0]
├── Page 1: [KV Cache Block 0]
├── Page 2: [KV Cache Block 1]
├── Page 3: [Free]
└── ...
负载感知模型放置
KV Pressure Ratio (KVPR):
其中:
- (SLO 加权 token 内存使用率)
- :GPU 可用于 KV Cache 的内存
放置策略:
- 按 降序排序模型(优先高需求)
- 为每个模型选择 KVPR 最低的 GPU
- 确保高需求模型优先分配资源
Slack-Aware 请求仲裁
Moore-Hodgson 算法:最小化截止时间错过数
| 步骤 | 操作 |
|---|---|
| 1 | 按截止时间升序排序请求 |
| 2 | 逐个调度请求 |
| 3 | 若当前请求导致错过截止时间,替换已调度中执行时间最长的请求 |
关键特性:
- 利用精确时间松弛量(time slack)
- 超越简单截止时间优先级
- 最大化 SLO 达标率
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 内存气球 | GPU 内存层面弹性管理,统一时间和空间共享 | 图 4,§5 |
| kvcached 驱动 | GPU 运行时层内存管理,跨模型透明重分配 | 开源实现 |
| KVPR 放置 | 基于 KV 压力比的负载感知模型放置 | 图 7,§6.1 |
| Slack-aware 仲裁 | Moore-Hodgson 算法最大化 SLO 达标率 | §6.2 |
| 引擎池复用 | 解耦引擎和模型生命周期,快速模型激活 | 图 10,§5.3 |
| 突发模式分析 | 生产环境多 LLM 负载特征分析 | 图 1,§3 |
五、实验结果
端到端性能
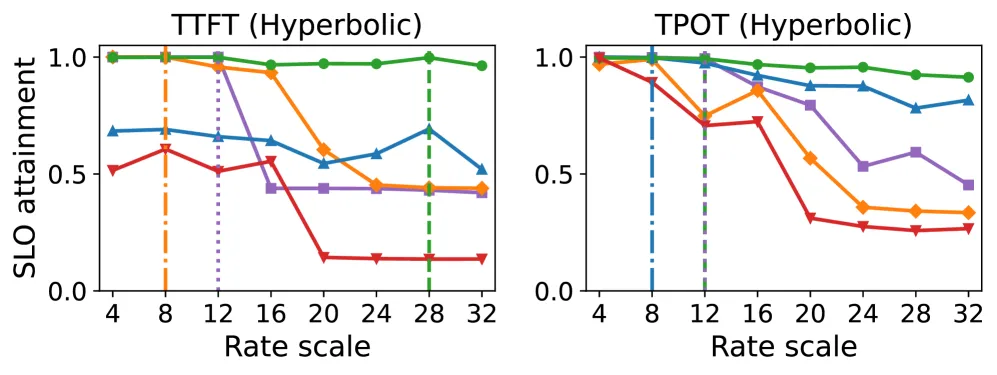
| 指标 | Prism vs MuxServe++ | Prism vs 静态分区 |
|---|---|---|
| 请求吞吐量 | +2.3x | +3.5x |
| TTFT SLO 达标率 | 显著更高 | 显著更高 |
| 99% 达标点 | 更高请求量 | 更高请求量 |
关键发现:
- Prism 在所有基准测试中一致超越所有 baseline
- 在 Hyperbolic trace 上,支持 2.3x-3.5x 更多请求仍保持 99% SLO 达标
- 在 Arena-Chat trace 上,处理 3x+ 更多请求
跨模型内存协调
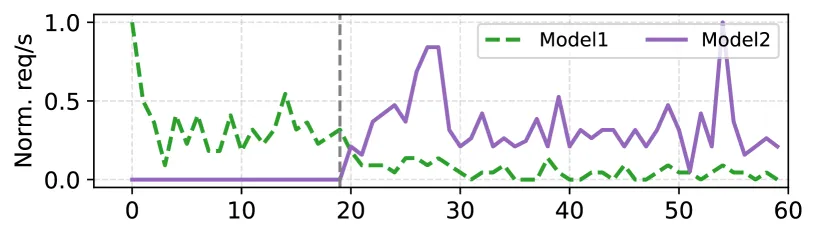
| 场景 | Prism | 静态分区 |
|---|---|---|
| Model1 空闲,Model2 突发 | 释放内存给 Model2 | 内存锁定无法重用 |
| KV Cache 使用 | 更高(弹性扩展) | 固定上限 |
| 吞吐量 | 更高 | 受限于内存碎片 |
大规模评估
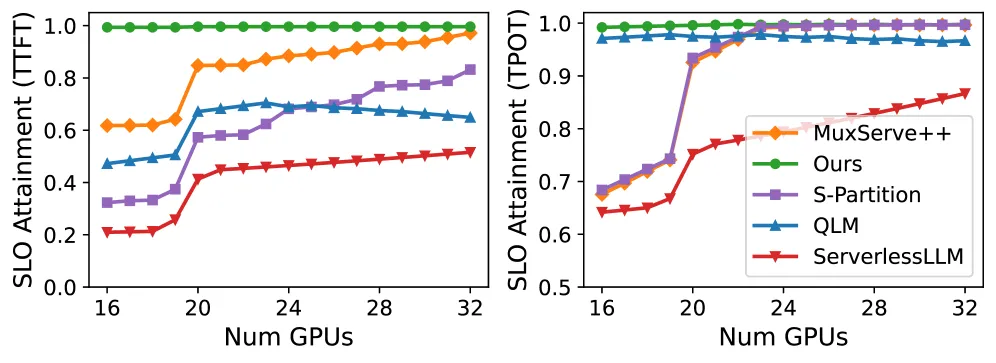
| 配置 | Prism | MuxServe++ | 静态分区 |
|---|---|---|---|
| 16 GPU 99% TTFT 达标 | 达标 | 未达标 | 未达标 |
| 32 GPU 99% TTFT 达标 | 达标 | 达标 | 需更多 GPU |
| GPU 节省 | 16 GPU | 32 GPU | 32+ GPU |
模型激活延迟
| 模型大小 | 激活时间 |
|---|---|
| 1B-8B | < 0.7s |
| 14B | 1.3s |
| > 70B | 1.5s |
生产环境部署
| 公司 | 指标 | 提升 |
|---|---|---|
| Company A | GPU 吞吐量 | 3.89x |
| Company B | 每 GPU 收入 | 2.86x |
部署规模:10K+ GPU 生产环境
系统开销
| 指标 | 数值 |
|---|---|
| TTFT 开销 | 3-4% (高负载) |
| TPOT 开销 | 7-13% (高负载) |
| 迁移频率 | 10 分钟内 3 次 GPU 间迁移 |
| 激活频率 | 10 分钟内 2 次空闲激活 |
六、系统配置
硬件环境
| 组件 | 配置 |
|---|---|
| GPU | 4 节点 × 8 NVIDIA H100-80G |
| 网络 | 600GB/s NVLink + 100Gbps Ethernet |
| CPU | 2× 52-core Intel Xeon Platinum 8480+ |
| DRAM | 1.7 TB |
| 接口 | PCIe Gen5 x16 |
模型配置
| 模型系列 | 参数规模 | 任务类型 |
|---|---|---|
| Llama-3.1/3.3 | 8B-70B | 文本生成 |
| Qwen2/2.5 | 7B-72B | 文本生成 |
| DeepSeek-R1 | 14B-70B | 推理/文本生成 |
| Distilled-DeepSeek | 14B | 文本生成 |
调度配置
| 策略 | 参数 |
|---|---|
| 内存共享 | 弹性气球扩展 |
| 模型放置 | KVPR 负载感知 |
| 请求仲裁 | Moore-Hodgson 算法 |
| SLO 优先级 | TTFT 优先 |
| 引擎池 | 预初始化复用 |
七、相关工作
| 工作 | 方法 | 与 Prism 的差异 |
|---|---|---|
| MuxServe | 空间共享 | 静态分区,无弹性 |
| QLM | 时间共享 | 频繁换入换出,thrashing |
| Aegaeon | 时间共享 | 模型卸载,无内存协调 |
| ServerlessLLM | 无服务器 | 冷启动延迟高 |
| vAttention | CUDA VMM | 单 LLM 优化,无跨模型 |
| DistServe | PD 分离 | 单模型优化 |
八、总结
核心贡献
- 内存气球:首次在 GPU 运行时层实现跨模型弹性内存管理
- kvcached:开源 GPU 内存管理驱动,统一时间和空间共享
- KVPR 放置:基于 KV 压力比的负载感知模型放置策略
- Slack-aware 仲裁:Moore-Hodgson 算法最大化 SLO 达标率
- 生产验证:10K+ GPU 部署,3.89x 吞吐量提升
- 开源贡献:kvcached 开源,可集成到 SGLang/vLLM
技术影响
- 成本效率:显著降低多 LLM 服务成本
- 资源利用:GPU 利用率从 <30% 提升到高效利用
- SLO 达标:在更高负载下保持严格 SLO
- 系统兼容:可与自动扩展系统无缝集成
- 开源生态:为社区提供弹性内存管理基础设施
局限性
- 实现复杂度:需要修改推理引擎集成 kvcached
- 模型规模:大模型(>70B)激活仍需 1.5s
- 评估范围:主要在 Hyperbolic/Novita/Chatbot Arena trace 验证
- 内存开销:kvcached 自身有少量内存开销
- 调度延迟:全局调度器决策有少量延迟
九、参考资源
- 论文: arXiv:2505.04021
- 代码: github.com/ovg-project/kvcached
- 相关工作:
- SGLang - LLM 推理引擎
- vLLM - PagedAttention 推理引擎
- MuxServe - 空间共享
- QLM - 时间共享
- ServerlessLLM - 无服务器推理