Faster MoE LLM Inference for Extremely Large Models
细粒度MoE模型推理优化分析,探索专家跳过和专家剪枝的效率与性能权衡
Faster MoE LLM Inference for Extremely Large Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Faster MoE LLM Inference for Extremely Large Models |
| 作者 | Haoqi Yang, Luohe Shi, Qiwei Li, Zuchao Li, Ping Wang, Bo Du, Mengjia Shen, Hai Zhao |
| 机构 | 未明确标注 |
| 论文 | arXiv:2505.03531 |
| 发布 | 2025-05-06 |
| 领域 | 计算与语言 (cs.CL) |
二、核心思想
问题定义
稀疏混合专家(SMoE)大语言模型正在成为超大规模模型的主流方法。然而,现有优化工作主要集中在粗粒度MoE架构上。随着DeepSeek系列模型的出现,细粒度MoE模型(6-8个活跃专家,64-256个总专家)日益流行,但相关研究有限。
核心发现
关键问题:
- 细粒度MoE在不同服务负载下的效率动态如何?
- 减少活跃专家数量()对效率和性能的影响?
- 减少总专家数量()对效率和性能的影响?
主要发现:
- MoE比FFN更难高效执行:尽管计算需求相同,但调度开销更大,批处理效果更弱
- 专家跳过可提升吞吐量:在低并发和高并发场景下效果显著
- 专家剪枝效果有限:减少总专家数量带来的效率增益有限,但性能下降严重
- 最佳方法:可在无性能损失的情况下提升至少**10%**吞吐量
解决方案概述
本文探索了两种优化策略:
-
推理时专家跳过(Inference Time Expert Skipping):
- 减少每个token激活的专家数量
- 在低并发和高并发场景下效果显著
-
预推理专家剪枝(Pre-Inference Expert Pruning):
- 在推理开始前移除部分专家,减少总专家数量
- 可提高计算强度,但性能损失较大
三、技术架构
FFN与MoE对比
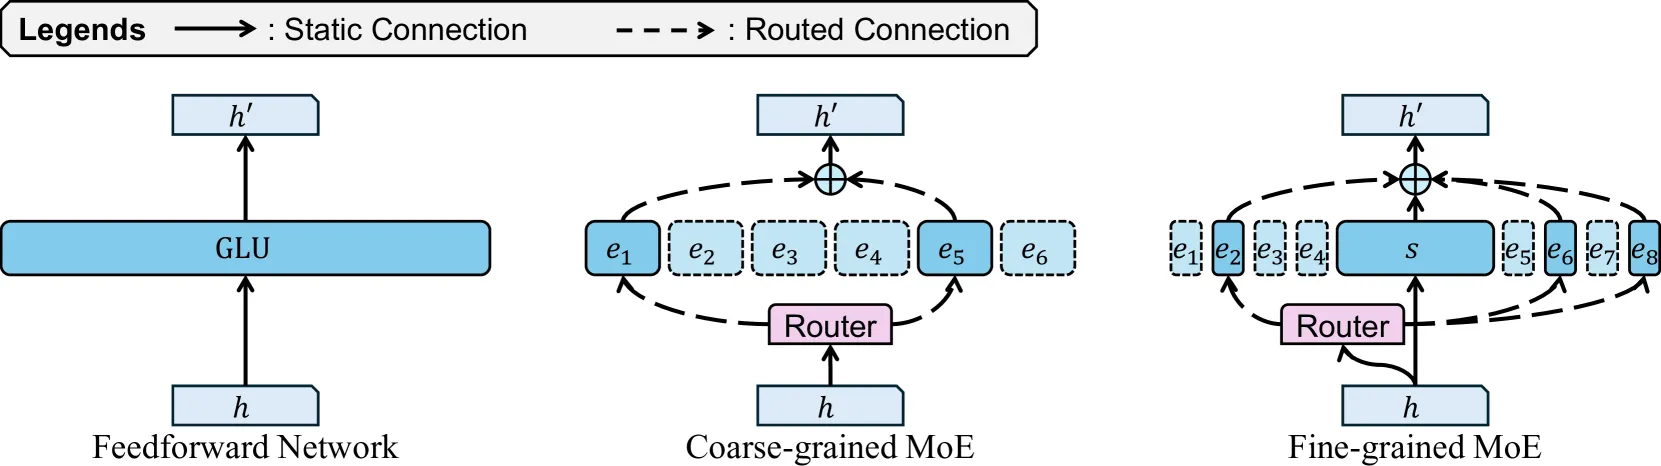
关键区别:
| 组件 | FFN | 粗粒度MoE | 细粒度MoE |
|---|---|---|---|
| 参数利用率 | 100% | 稀疏激活 | 更稀疏激活 |
| 批处理效果 | 强 | 弱 | 更弱 |
| 调度开销 | 无 | 中等 | 更高 |
| 计算强度 | 高 | 中等 | 较低 |
效率分析
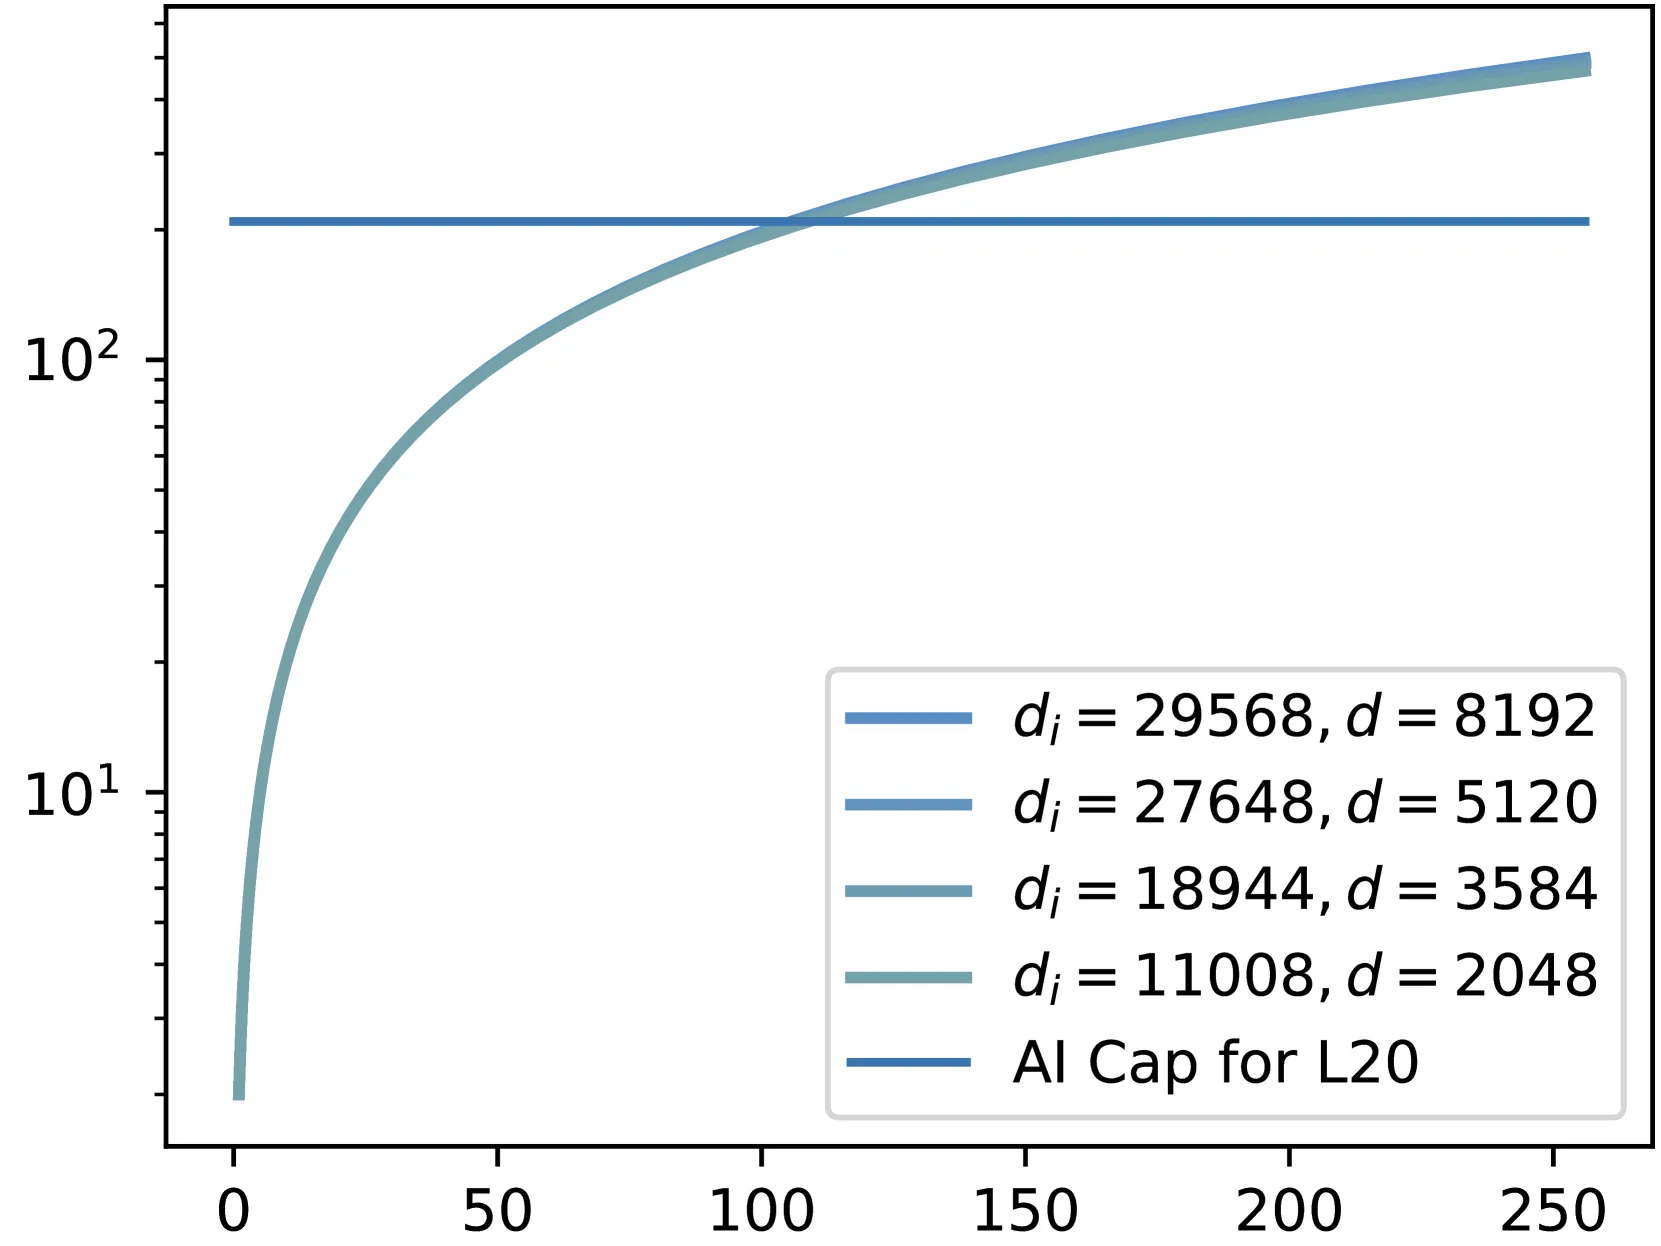
关键观察:
-
算术强度(Arithmetic Intensity):
- 随序列长度L增加,算术强度先升后降
- 在L≈150时达到峰值效率
-
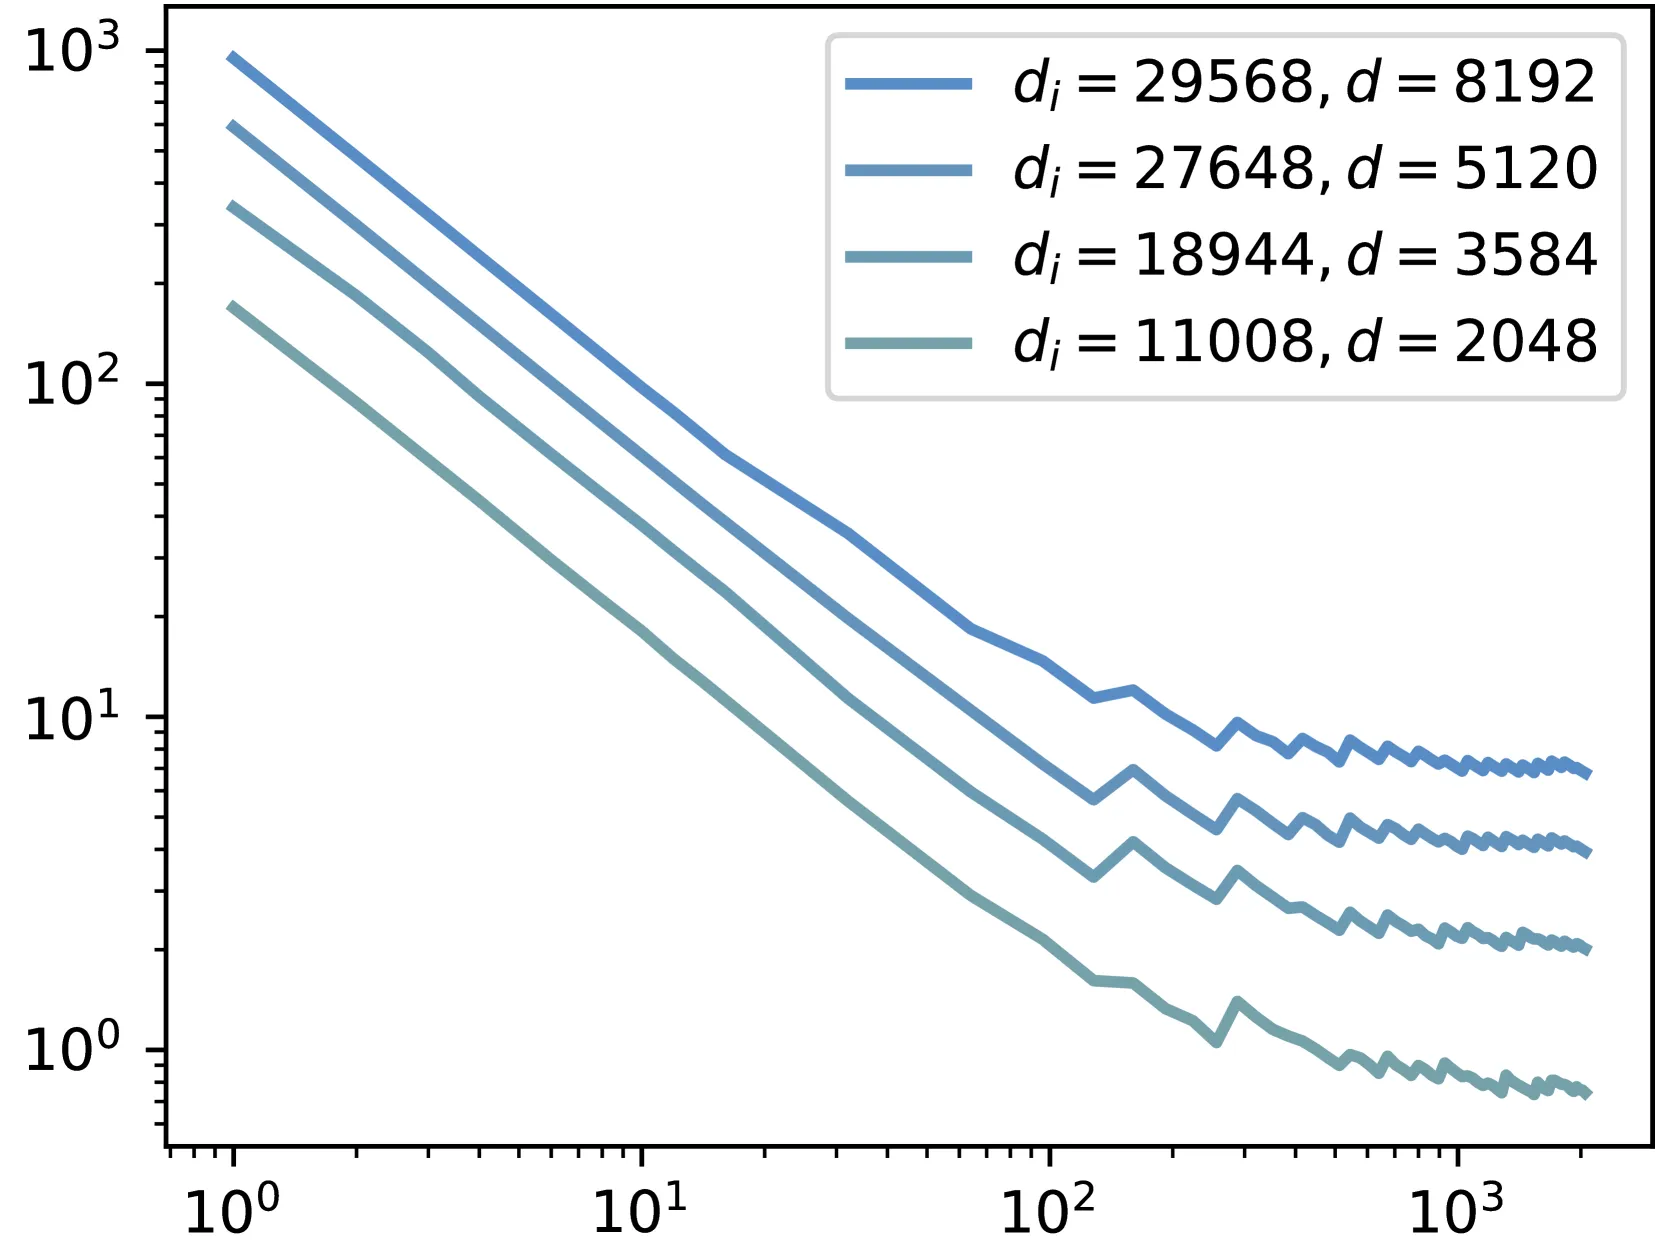
FFN每token延迟:
- 小batch时增加token几乎不增加延迟
- 参数加载成本被多个token分摊
-
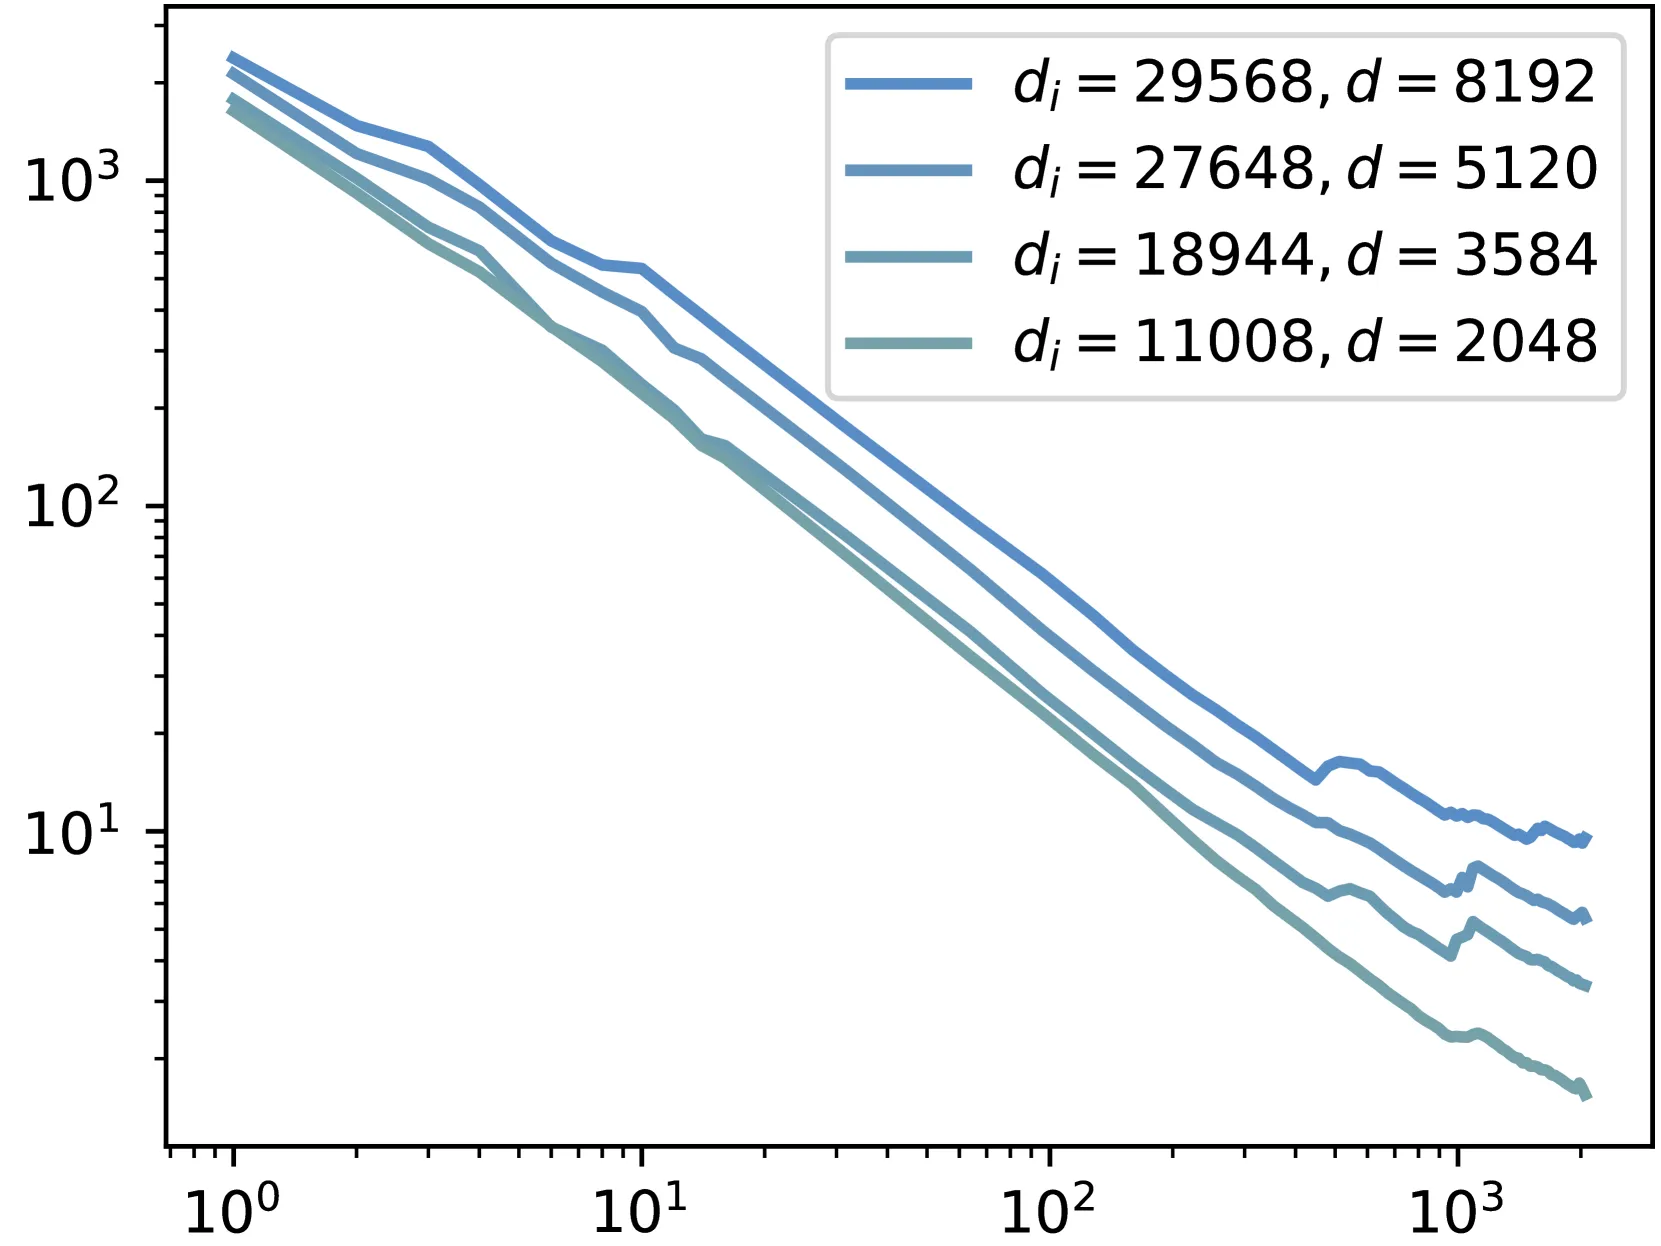
MoE每token延迟:
- 延迟更高,达到峰值效率更慢
- 大模型更容易达到最大效率(AI上限更高)
MoE效率问题根源:
- 稀疏激活减少了计算需求,但需要加载更多专家参数
- token在batch内很少复用相同专家
- 产生额外的内存访问开销
专家并行优势
MoE vs FFN的通信需求:
| 并行方式 | FFN通信量 | MoE通信量 |
|---|---|---|
| 张量并行(TP) | 更低 | |
| 专家并行(EP) | 不适用 | 显著降低 |
关键洞察:MoE虽然批处理效率较低,但在多设备部署时通信开销显著降低。
推理时专家跳过
效率分析:
-
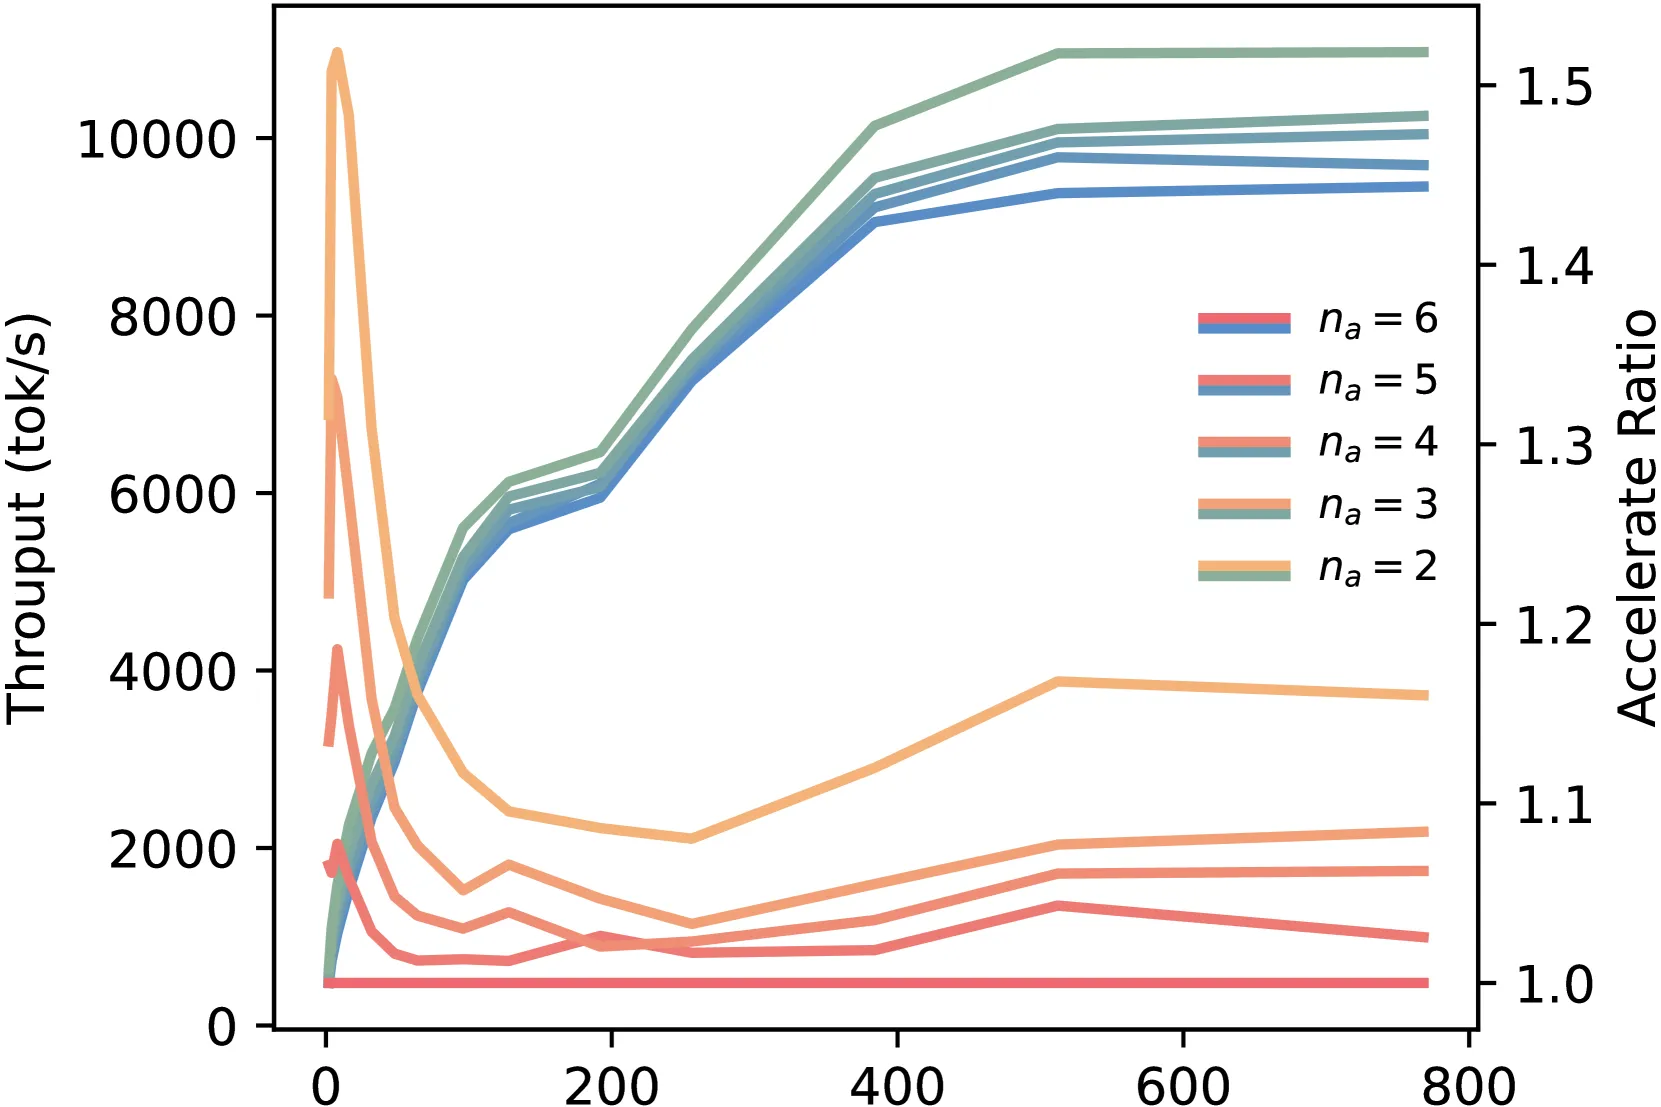
低并发场景:
- 系统处于内存I/O-bound状态
- 减少 立即降低参数加载需求
- 加速比可达50%(时)
-
中等并发场景:
- 系统仍为内存I/O-bound
- 但已有足够token同时处理
- 减少 对总专家选择数影响有限
- 加速效果有限
-
高并发场景:
- 系统转为compute-bound
- 减少 降低计算需求
- 吞吐量增益与计算减少比更接近
理论计算减少上限:(不考虑MLA层)
层间专家分配策略
四元组定义:
- :第一层选择的专家数
- :第 层选择的专家数
- :最后一层选择的专家数
- :特殊层索引
目标:在固定总激活专家数下,找到最大化模型性能的层间分配策略。
预推理专家剪枝
效率分析:
- 减少专家数量可提高计算强度
- 在低吞吐量时加速比显著(最高2.3×)
- 但加速效果在专家数最小时减弱
性能对比(Table 2):
| 方法 | ARC-C | ARC-E | BoolQ | OBQA | RTE | WinoGrande | 平均 | |
|---|---|---|---|---|---|---|---|---|
| Baseline | 64 | 52.9 | 80.6 | 83.1 | 35.8 | 73.3 | 71.4 | 66.0 |
| Random | 16 | 20.8 | 27.2 | 60.8 | 14.8 | 50.5 | 50.5 | 37.4 |
| Random | 32 | 19.2 | 31.1 | 59.4 | 15.2 | 50.5 | 51.2 | 37.7 |
| Random | 48 | 43.7 | 75.0 | 81.2 | 31.2 | 65.7 | 67.5 | 60.7 |
| Soft Count | 16 | 28.7 | 57.3 | 62.2 | 22.4 | 55.6 | 60.9 | 47.8 |
| Soft Count | 32 | 39.7 | 71.2 | 76.1 | 31.4 | 58.5 | 70.2 | 57.8 |
| Soft Count | 48 | 46.8 | 76.3 | 80.0 | 33.8 | 76.5 | 72.1 | 64.2 |
关键发现:
- Soft Count方法 consistently优于其他方法
- 减少25%专家时,最佳方法也有一定性能下降
- 减少50%专家时,最佳方法性能下降15%
- 仅保留25%专家时,随机选择完全失效
- 结构化移除(偶数索引/后半部分)优于随机选择,表明存在关键专家
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 细粒度MoE效率分析 | 揭示MoE比FFN更难高效执行的原因 | 算术强度和延迟分析 |
| 专家跳过策略 | 在不同并发场景下优化活跃专家数 | 低并发50%加速,高并发与计算减少比接近 |
| 层间专家分配 | 四元组定义层间策略 | 结构搜索实验 |
| 专家剪枝分析 | 评估减少总专家数的影响 | Soft Count方法最优,但性能损失大 |
| 无损优化 | 最佳方法可在无性能损失下提升10%吞吐量 | DeepSeek-V3实验验证 |
五、实验结果
实验设置
模型:
- DeepSeek-V2-Lite:细粒度MoE模型
- DeepSeek-V3:细粒度MoE模型
关键参数:
- :总专家数(64-256)
- :活跃专家数(6-8)
- :隐藏大小
- :专家中间大小
- :共享专家中间大小
硬件:NVIDIA GPU(详见Appendix)
测试配置:
- 输入:1024 tokens(随机采样)
- 输出:额外生成tokens
- 并发:不同并发级别
专家跳过效率
DeepSeek-V2-Lite和DeepSeek-V3结果:
| 并发级别 | 加速比 | 说明 |
|---|---|---|
| 低并发 | 50% | 内存I/O-bound,减少参数加载 |
| 中等并发 | 有限 | 内存I/O-bound,但token已充分并行 |
| 高并发 | 显著 | compute-bound,降低计算需求 |
关键发现:
- 减少 不影响达到峰值吞吐量所需的并发数
- 加速比曲线呈现复杂模式
- 低并发和高并发场景效果显著,中等并发效果有限
专家剪枝效率
吞吐量提升:
- 低吞吐量时:最高**2.3×**加速
- 高吞吐量时:加速效果减弱
- 原因:减少专家数提高计算强度
最佳方法性能
DeepSeek-V3结果:
- 可在无性能损失的情况下提升至少**10%**吞吐量
- 通过适当的跳过策略,性能退化可进一步缓解
六、相关工作
| 方法 | 特点 | 本文优势 |
|---|---|---|
| 粗粒度MoE优化 | 仅适用于2专家激活 | 适配细粒度MoE(6-8专家) |
| Mixtral专家剪枝 | 基于信息度量 | 发现结构化移除优于随机 |
| 张量并行 | 高通信开销 | MoE的专家并行通信更低 |
| 批处理优化 | 通用方法 | 揭示MoE批处理效果更弱 |
七、总结
核心贡献
- 细粒度MoE效率分析:揭示MoE比FFN更难高效执行的原因
- 专家跳过策略:在不同并发场景下优化活跃专家数,低并发50%加速
- 层间专家分配:四元组定义层间策略,最大化性能
- 专家剪枝分析:Soft Count方法最优,但性能损失大
- 无损优化:最佳方法可在无性能损失下提升10%吞吐量
技术影响
- 为细粒度MoE模型推理优化提供了系统性分析
- 揭示了MoE效率优化的关键瓶颈(批处理效果弱、调度开销高)
- 为DeepSeek系列模型的部署提供了实用指导
- 指出了未来研究方向:更高效的推理系统设计
局限性
- 主要关注吞吐量,未深入探讨延迟和SLO
- 专家剪枝的性能损失仍然较大
- 未探索与其他优化技术(如量化、蒸馏)的结合
- 结构化移除的发现需要进一步理论解释
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | FFN与MoE对比 | figure1-ffn-moe-comparison.png |
| Figure 2 | 模拟实验结果 | figure2-simulation.png |
| Figure 3 | 专家跳过吞吐量 | figure3-expert-skipping-throughput.png |
| Figure 4 | 专家跳过性能 | figure4-expert-skipping-performance.png |
| Figure 5 | 专家剪枝结果 | figure5-expert-pruning.png |