Unified Multimodal Understanding and Generation Models: Advances, Challenges, and Opportunities
统一多模态理解与生成模型综述:系统梳理三大架构范式(扩散/自回归/混合),数据集与基准测试
Unified Multimodal Understanding and Generation Models: Advances, Challenges, and Opportunities
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Unified Multimodal Understanding and Generation Models: Advances, Challenges, and Opportunities |
| 作者 | Shanshan Zhao, Xinjie Zhang, Jintao Guo, Jiakui Hu, Lunhao Duan, Minghao Fu, Yong Xien Chng, Guo-Hua Wang, Qing-Guo Chen, Zhao Xu |
| 机构 | 阿里巴巴集团 (Alibaba Group) |
| 论文 | arXiv:2505.02567 |
| 代码 | github.com/AIDC-AI/Awesome-Unified-Multimodal-Models |
| 发布 | 2025-05-05 (v1), 2026-01-26 (v6) |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
问题定义
多模态理解和图像生成是 AI 领域的两大核心能力,但长期以来沿不同路径发展:
| 领域 | 主导架构 | 核心特点 |
|---|---|---|
| 多模态理解 | 自回归 (AR) | decoder-only, next-token prediction |
| 图像生成 | 扩散模型 (Diffusion) | UNet/DiT, 前向加噪+反向去噪 |
核心矛盾:两种架构在表示空间、训练目标、推理方式上存在根本差异,如何统一成为关键挑战。
解决方案概述
本综述系统梳理了统一多模态模型的三大架构范式:
- 扩散模型 (Diffusion-based):在扩散过程中引入多模态条件
- 自回归模型 (AR-based):将图像 token 化后与文本统一建模
- 混合模型 (AR + Diffusion):文本自回归生成 + 图像扩散生成
三、技术架构
统一模型分类体系
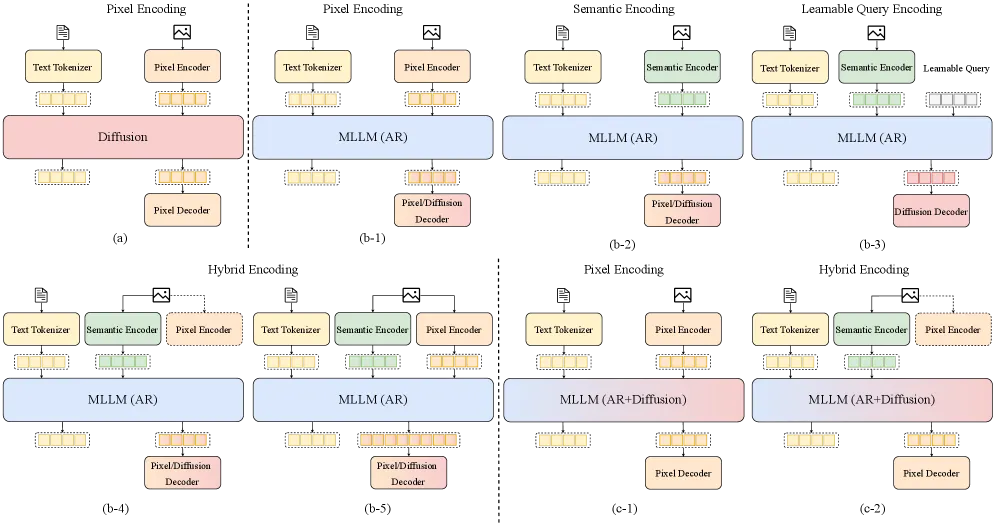
Unified Multimodal Models
├── 1. Diffusion-based
│   └── 多模态扩散过程,文本/图像联合去噪
├── 2. AR-based
│   ├── 2.1 Pixel-based Encoding (VQGAN)
│   ├── 2.2 Semantic-based Encoding (CLIP/T5)
│   ├── 2.3 Learnable Query-based Encoding
│   └── 2.4 Hybrid Encoding
└── 3. Fused AR + Diffusion
    ├── 3.1 Pixel-based Encoding
    └── 3.2 Hybrid Encoding
多模态理解模型架构
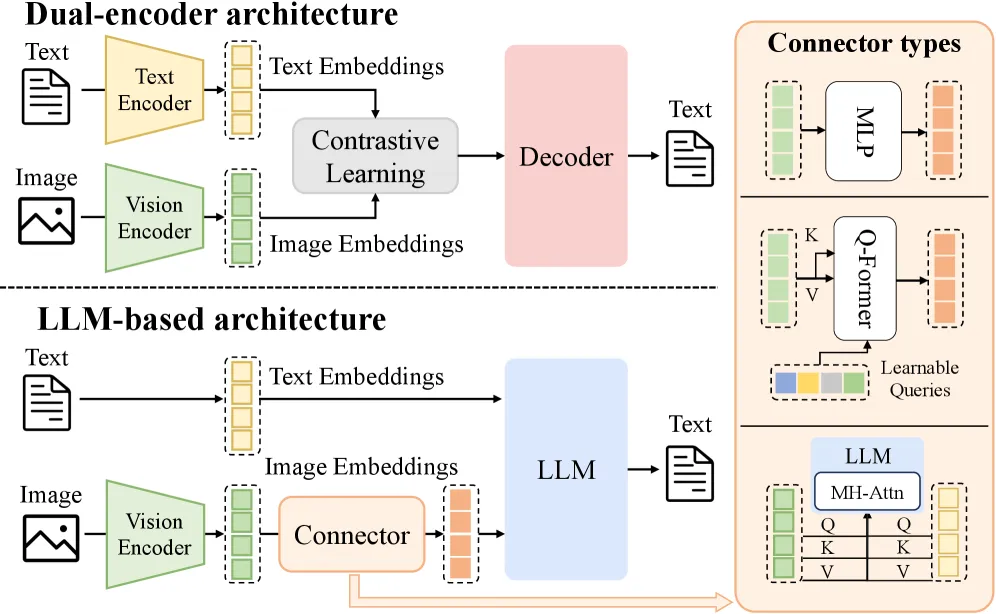
典型架构包含三个组件:
- 多模态编码器:将图像/音频/视频转换为特征
- 连接器 (Connector):投影/查询/融合方式对齐模态
- LLM 骨干:统一的序列建模和推理
连接器类型:
| 类型 | 代表工作 | 特点 |
|---|---|---|
| Projection-based | LLaVA, Qwen-VL | 简单线性投影 |
| Query-based | Flamingo, BLIP-2 | 可学习查询向量 |
| Fusion-based | GPT-4o | 深层特征融合 |
扩散模型基础
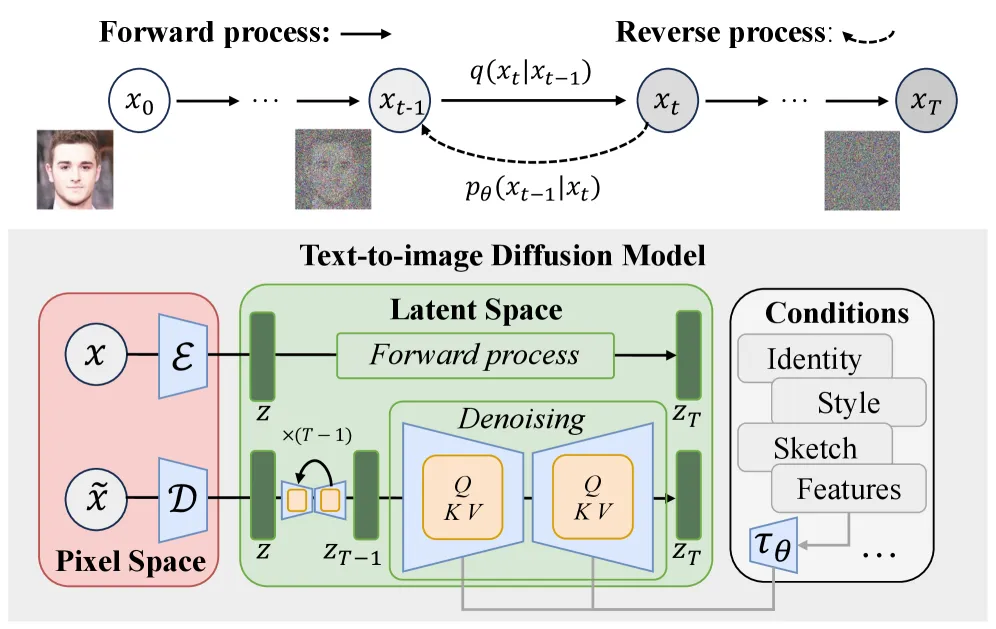
前向过程(加噪):
反向过程(去噪):
训练目标:
自回归模型基础
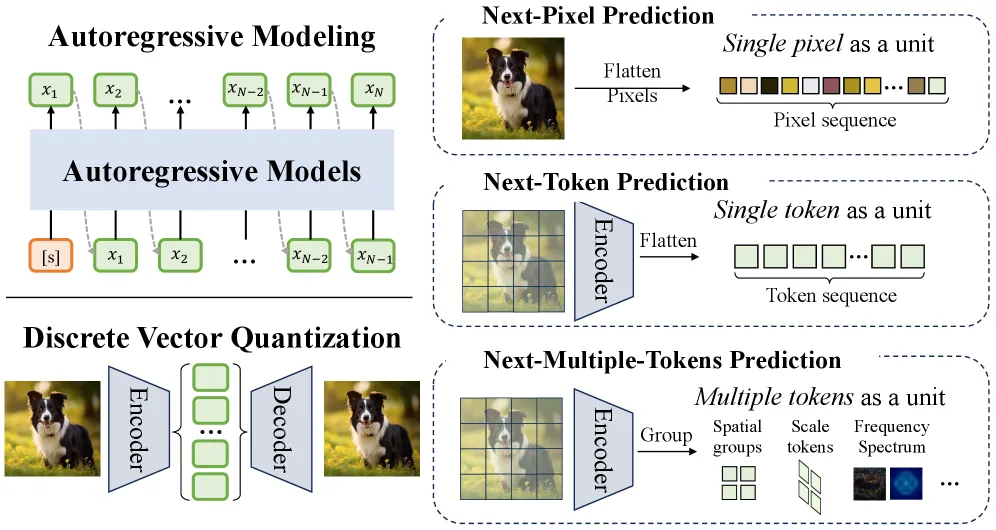
三种图像 token 化方式:
| 类型 | 方法 | 特点 |
|---|---|---|
| Next-Pixel Prediction | 原始像素序列 | 高维度,计算量大 |
| Next-Token Prediction | VQGAN/VAE token 化 | 离散 token,与文本统一 |
| Next-Multiple-Tokens | 多 token 并行预测 | 加速推理 |
三大架构范式详解
1. 扩散模型 (Diffusion-based)
核心思想:在扩散过程中引入多模态上下文作为条件
代表工作:
- Dual Diffusion:双分支扩散,文本 T5 编码 + 图像 VAE 编码
- SEED-X:使用 LLM 作为语义桥梁
优势:生成质量高,模式覆盖好 劣势:推理速度慢,多步采样
2. 自回归模型 (AR-based)
核心思想:将图像 token 化后与文本统一序列建模
四种编码策略:
| 策略 | 编码器 | 代表工作 |
|---|---|---|
| Pixel-based | VQGAN | LWM, Chameleon |
| Semantic-based | CLIP/T5 | Emu, SEED |
| Learnable Query | Q-Former | DreamLLM, Show-o |
| Hybrid | 组合编码 | Uni-MoE, Janus |
优势:与 LLM 架构兼容,推理效率高 劣势:图像质量受限于 tokenizer 精度
3. 混合模型 (AR + Diffusion)
核心思想:文本自回归生成 + 图像扩散生成
代表工作:
- Transfusion:AR 损失 + 扩散损失联合训练
- Show-o:单模型支持理解和生成
- MonoFormer:统一 Transformer 骨干
优势:兼顾文本推理能力和图像生成质量 劣势:架构复杂,训练成本高
Any-to-Any 多模态模型
核心思想:支持任意模态输入/输出
代表工作:
- OmniFlow:集成音频、图像、视频生成
- Spider/X-VILA:基于 ImageBind 的共享嵌入空间
- GPT-4o:原生多模态,支持文本/图像/音频/视频
四、数据集与基准测试
预训练数据集
| 类别 | 代表数据集 | 规模 | 时间 |
|---|---|---|---|
| 多模态理解 | LAION | 5.9B | 2022-03 |
| DataComp | 1.4B | 2023-04 | |
| LLaVA-OneVision | 4.8M | 2024-08 | |
| 文本到图像 | LAION-Aesthetics | 120M | 2022-08 |
| JourneyDB | 4M | 2023-07 | |
| FLUX-Reason-6M | 6M | 2025-09 | |
| 图像编辑 | UltraEdit | 4M | 2024-07 |
| SEED-Data-Edit | 3.7M | 2024-05 |
评估基准
| 任务 | 基准 | 说明 |
|---|---|---|
| 理解-感知 | MMBench, MMStar | 多模态问答 |
| 理解-推理 | MMMU, MathVista | 学科推理 |
| 生成-质量 | FID, CLIP Score | 图像保真度 |
| 生成-对齐 | TIFA, GenEval | 文本-图像对齐 |
| 编辑 | GEdit, ImgEdit | 指令编辑 |
| 统一 | UMI-Bench | 理解+生成综合 |
五、核心挑战与机遇
主要挑战
| 挑战 | 说明 | 潜在解决方案 |
|---|---|---|
| Tokenization 策略 | 视觉 token 高维度,序列过长 | 高效压缩,学习离散表示 |
| 跨模态注意力 | 长序列注意力计算瓶颈 | 稀疏注意力,层次化注意力 |
| 数据质量 | 噪声/偏差图文对 | 数据过滤,去偏,合成 |
| 评估协议 | 单任务评估,缺乏统一基准 | 综合评估,理解+生成联合测试 |
| CoT/RL 集成 | 复杂推理和长程优化 | 链式思维,强化学习 |
未来机遇
- 架构创新:更高效的跨模态融合机制
- 数据工程:高质量、大规模多模态数据
- 评估体系:统一的理解+生成评估基准
- 应用拓展:视频、3D、具身智能
- 效率优化:推理加速,模型压缩
六、总结
核心贡献
- 系统分类:提出统一多模态模型的三大架构范式(扩散/AR/混合)
- 详细分析:深入剖析每种范式的结构设计和创新
- 数据集汇总:整理适用于统一模型的数据集和基准
- 挑战识别:指出 tokenization、注意力、数据、评估等关键挑战
- 持续更新:GitHub 项目持续跟踪最新进展
技术影响
- 学术价值:为统一多模态研究提供全面参考
- 工业指导:帮助选择合适的架构和数据策略
- 社区资源:Awesome 列表促进开源生态发展
- 未来方向:指明 any-to-any、CoT、RL 等研究方向
局限性
- 快速迭代:领域发展迅速,综述可能很快过时
- 深度限制:覆盖面广但某些方向深度不足
- 评估缺失:统一评估基准仍在发展中
- 实证不足:主要是综述,缺乏原创实验验证
七、参考资源
- 论文: arXiv:2505.02567
- GitHub: github.com/AIDC-AI/Awesome-Unified-Multimodal-Models
- 相关模型:
- GPT-4o - 原生多模态
- LLaVA - 视觉语言理解
- Stable Diffusion - 扩散生成
- Chameleon - AR 统一模型
- Transfusion - AR+扩散混合
- 相关综述:
- 评估基准: