The Sparse Frontier: Sparse Attention Trade-offs in Transformer LLMs
最大规模的训练无关稀疏注意力经验分析,覆盖Qwen 2.5/Llama 3.1/Gemma 3三大模型家族(4B-72B)、16K-128K序列长度、稀疏度0-0.95,发现稀疏注意力Pareto前沿、prefill/decode两阶段行为差异、序列长度与稀疏容忍度关系
The Sparse Frontier: Sparse Attention Trade-offs in Transformer LLMs
一、论文概述
| 属性 | 内容 |
|---|---|
| 论文标题 | The Sparse Frontier: Sparse Attention Trade-offs in Transformer LLMs |
| 论文编号 | arXiv:2504.17768 (v1: 2025-04-24, v3: 2026-06-22) |
| 作者 | Piotr Nawrot, Robert Li, Renjie Huang, Sebastian Ruder, Kelly Marchisio, Edoardo M. Ponti |
| 机构 | University of Edinburgh, Cohere, Meta |
| 代码 | https://github.com/pnawrot/sparse-frontier |
| 会议/期刊 | arXiv preprint, TMLR 2026 (under review) |
| 图表 | 21 幅图 / 5 张表 |
| 主题分类 | cs.CL, cs.LG |
摘要:稀疏注意力为扩展 Transformer LLM 的长上下文能力提供了有前景的策略,但其效率-精度权衡仍不清晰,缺乏全面评估。本文是迄今为止最大规模的训练无关稀疏注意力实证分析,在 3 个模型家族(Qwen 2.5、Llama 3.1、Gemma 3)、多个模型规模、长达 128K token 的序列、稀疏度高达 0.95(即 1/20 注意力预算)以及 9 个多样化任务上评估了 6 种方法。本文首先将快速演进的稀疏注意力方法沿四个设计轴组织为分类法,然后得出可操作的洞见:(1) 稀疏注意力是有效的——在等价成本下,更大的稀疏模型优于更小的稠密模型,改进了 Pareto 前沿;(2) 对于所研究的训练无关方法,prefilling 期间细粒度的 per-query 重要性估计仍然不实用(由于估计成本和缺乏将细粒度稀疏转化为实际加速的稀疏核),迫使在 global-to-token 与 block-to-block 选择之间做任务依赖的取舍。Decoding 期间,token-to-page 选择变得可行,能实现更好的泛化与更高的稀疏容忍度;(3) 更长的序列容忍更高的稀疏度,暗示生产环境中的固定预算方法次优。
二、研究背景与动机
2.1 长上下文建模的计算瓶颈
Transformer LLM 的长序列建模能力是长上下文处理和推理时计算扩展的核心。自注意力机制是根本性瓶颈:
- Prefilling 阶段:计算复杂度相对于序列长度呈二次 ,导致 time-to-first-token 与部署成本急剧膨胀
- Decoding 阶段:KV 缓存相对于序列长度线性增长,每步生成时加载不断扩展的 KV 缓存主导运行时
2.2 稀疏注意力的现状
稀疏注意力机制通过仅计算 QK 交互的子集来近似稠密注意力输出,涵盖:
- 训练式变体:DMS、DeepSeek NSA、OpenAI gpt-oss、谷歌 Gemma 3 中的 SWA
- 训练无关方法:Vertical-Slash(已部署在 Qwen 2.5-1M 并集成 vLLM)
在 2025 年 1 月至 2026 年 1 月间,arXiv 提交了超过 150 篇标题含 “sparse attention” 的论文。然而,由于缺乏大规模全面评估,稀疏注意力的可行性与稳健性仍不清晰。
2.3 现有评估的局限
- Li et al. 2025 (SCBench):未控制序列长度,每个家族最多评估两个模型
- Liu et al. 2025b:仅考察 ≤10B 模型,未涉及 prefilling 阶段
- Yuan et al. 2024:序列长度仅至 32K,模型 ≤10B
本文是首个系统性地对稀疏注意力进行 isoCost 分析 的工作,提供效率-精度权衡与跨模型规模/序列长度/稀疏度的泛化新洞见。
三、四轴分类法
本文将快速演进的稀疏注意力方法沿四个设计轴系统化(Table 1):
3.1 稀疏化单元(Unit of Sparsification)
稀疏化单元是注意力矩阵中被剪枝或保留的结构单元。常见单元包括:
- 局部窗口(local windows):围绕每个 query 的连续区域
- 垂直列(vertical columns):所有 query 全局可访问的 token
- 斜线(slashes):距每个 query 固定偏移的 token
- 块(blocks):注意力矩阵的固定大小 tile(如 64×64 tokens)
块方法:Star Attention 用局部块+首前缀块近似;MInference 的 Block-Sparse 模式对每块 query token 增加动态选择的块;Quest、InfLLM 将 KV 缓存分为连续 page 并为每个解码 token 选择子集。
Vertical-Slash 模式:早期方法(LM-Infinite、StreamingLLM)用局部滑动窗口+前缀 attention sinks;Tri-shape 增加后缀 token 全注意力;SnapKV 引入动态选择的垂直列;MInference 通过任意偏移的对角斜线扩展局部窗口。
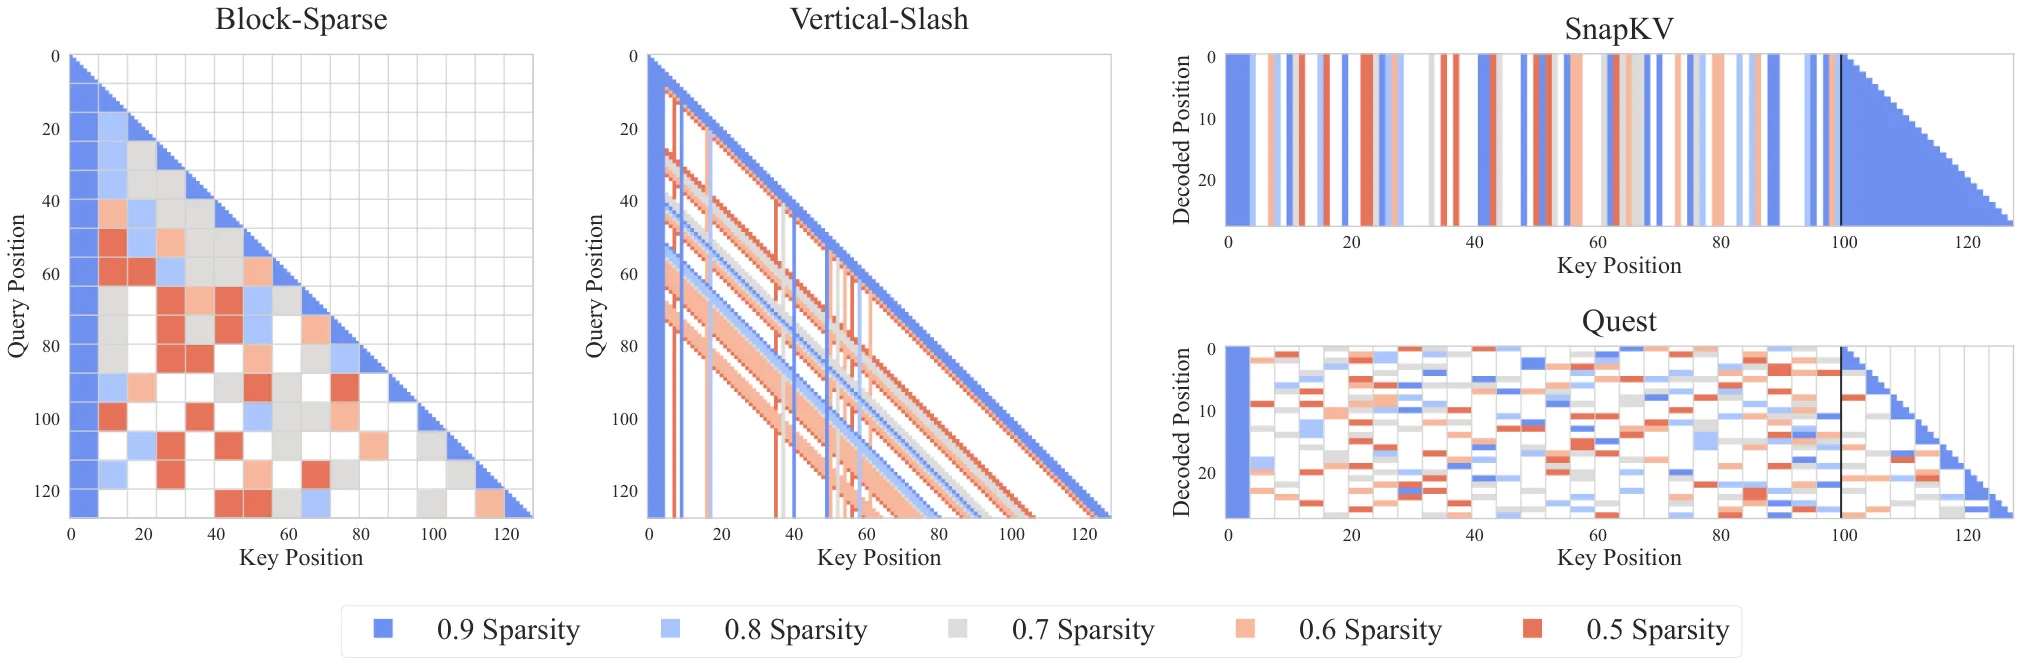
图 1 稀疏注意力模式可视化。Block-Sparse 与 Vertical-Slash 在 prefilling 期间操作(显示 query-key 注意力矩阵),SnapKV 与 Quest 在 decoding 期间操作(显示解码 token 关注 KV 缓存位置)。颜色表示从 0.5(红)到 0.9(蓝)的稀疏度。黑色竖线标记 prefill/decode 边界。
3.2 重要性估计(Importance Estimation)
- 固定模式(Fixed patterns):通过离线校准识别,跨所有输入一致应用
- StreamingLLM、LM-Infinite、MoA 确定初始 token 数(attention sinks)与局部窗口宽度
- 内容感知方法(Content-aware methods):估计 QK 单元重要性以保留 top-k
- SparQ 用最高幅度维度的近似注意力分数
- MInference 的 Vertical-Slash 用块级池化 token 表示
- SampleAttention 子采样 query
- SnapKV 同样子采样 query,但用于解码
- H2O、TOVA 用聚合注意力分数或最新 query 引导选择
- 补充启发式:key 范数(Devoto et al. 2024)、value 范数(Guo et al. 2024)
关键洞见:稀疏注意力的成本包括稀疏操作与重要性估计开销;已实现的速度提升不仅取决于节省的 FLOPs,还取决于核利用所得稀疏模式的效率。Prefilling 期间,精确 per-query 重要性估计是二次的,且细粒度选择产生不规则内存访问模式,与基于块的 FlashAttention 核不匹配。DeepSeek Sparse Attention (DSA) 通过学习 “lightning indexer” 绕过这些约束,但在训练无关领域中,没有方法结合高效细粒度估计器与将所得稀疏转化为墙钟收益的核——因此实际方法要么全局选择细粒度单元,要么使用较粗的 block-to-block 选择。Decoding 期间 per-query 选择可行,因为每步只处理一个 query。
3.3 预算分配(Budget Allocation)
在模型组件(层与头)上分配计算资源以达到目标稀疏度:
- 均匀分配(Uniform):如 Block-Sparse、SnapKV——简单但忽略层/头的差异贡献
- 自适应(Adaptive):
- PyramidKV、PyramidInfer:层越深,注意力分数熵越低,早期层分配更大预算
- Mixture of Sparse Attention (MoA):用 Taylor 近似优化全局预算跨层分配
- Ada-KV:按头灵活分配 top-(k×h) token
- 阈值方法:Twilight、FlexPrefill、Tactic、SampleAttention 设置覆盖阈值(如 95% 注意力质量),每个头动态选择
3.4 KV 缓存管理(KV Cache Management)
- 驱逐(Eviction):H2O、SnapKV——永久丢弃所选 token
- 完整保留(Full retention):Quest、SparQ——保留整个缓存但选择性加载
3.5 评估的 6 种方法
| 方法 | 阶段 | 单元 | 预算 | KV 缓存管理 |
|---|---|---|---|---|
| Vertical-Slash | Prefill | verticals + slashes | uniform | N/A |
| FlexPrefill | Prefill | verticals + slashes | threshold-based | N/A |
| Block-Sparse | Prefill | blocks | uniform | N/A |
| SnapKV | Decode | tokens | uniform | eviction |
| Ada-SnapKV | Decode | tokens | adaptive | eviction |
| Quest | Decode | pages | uniform | full cache |
Table 1 实验基准的 6 种内容感知稀疏注意力方法。
四、实验设置
4.1 模型
| 家族 | 规模 | 层数 | Q头 | KV头 | HuggingFace ID |
|---|---|---|---|---|---|
| Qwen 2.5 | 7B/14B/32B/72B | 28/48/64/80 | 28/40/40/64 | 4/8/8/8 | Qwen2.5-*-Instruct |
| Llama 3.1 | 8B/70B | 32/80 | 32/64 | 8/8 | meta-llama/Llama-3.1-*-Instruct |
| Gemma 3 | 4B/12B/27B | 34/48/62 | 8/16/32 | 4/8/16 | google/gemma-3-*-it |
Table 5 评估模型概览。Qwen 2.5 与 Llama 3.1 官方支持 128K 上下文;Gemma 3 在该长度表现近零,故仅评估至 64K。
Qwen 2.5 作为主要家族的理由(同时满足):
- 原生 128K 上下文支持
- 多个规模在所有序列长度上保持合理性能
- 有 instruction-tuned 版本以支持 CoT 评估
Gemma 3 特殊性:6 层中 5 层使用 1024 token 滑动窗口,每 6 层用全局注意力——已通过架构大幅稀疏化。
所有实验使用 vLLM 推理引擎,bf16 精度。
4.2 任务
9 个长上下文任务沿 3 个关键维度选择(Table 2):
| 任务 | 描述 | 分散度 | 范围 | 自然 |
|---|---|---|---|---|
| QA (SQuAD) | 在含干扰文档中开放式 QA | Low | Low | ✓ |
| QA (QuALITY, TOEFL) | 在含干扰文档中多选 QA | Low | Low | ✓ |
| Ruler NIAH | 在大量干扰键值对中提取指定键的 4 个值 | Low | Low | × |
| Ruler VT | 通过链式赋值识别解析为目标值的变量 | High | Low | × |
| Ruler CWE | 从含干扰词的列表中识别 10 个最频繁的词 | Low | High | × |
| Story Retrieval | 关于长叙事中特定章节回答 16 个 factoid 问题 | Low | Low | ✓ |
| Story Multi-hop | 跨章节识别目标物品之前立即获取的物品 | High | Low | ✓ |
| Story Filtering | 识别长叙事中无物品购买发生的章节 | Low | High | ✓ |
Table 2 9 个评估任务摘要。
分散度(Dispersion) 指定位所需信息的难度,范围(Scope) 指必须处理的信息量。自然性(Naturalness) 维度同样关键——合成任务产生与自然语言不同的 token 表示分布。
3 个新任务(Story 系列) 填补 RULER 任务(合成)与真实长上下文用例之间的空白。
4.3 评估配置
- 序列长度:16K、32K、64K(全部模型),128K(仅 Qwen、Llama,方法限于 Vertical-Slash 与 Quest)
- 稀疏度等级:0, 0.33, 0.5, 0.6, 0.7, 0.8, 0.87, 0.9, 0.93, 0.95(对应注意力预算 1/1.5, 1/2, 1/2.5, 1/3.33, 1/5, 1/7.5, 1/10, 1/15, 1/20)
- 样本数:Qwen 100/配置,Llama 与 Gemma 50/配置
- 总配置数:7065 个
- 计算资源:约 4 个节点,每节点 8 张 H100 GPU,运行 21 天
- 输入长度约束:95-100% 目标最大 token 长度
- 指标:Exact Match Accuracy / IoU / F1 score(均 [0,1])
五、计算成本建模
5.1 Prefilling FLOPs 分解
其中 序列长度, 隐藏维度, 与 query 与 KV 头数, 头维度, 层数, MLP 中间维度, 词汇表大小, 批大小, 注意力密度。
5.2 Decoding 内存访问分解
5.3 重要性估计开销
Vertical-Slash:
其中 用于重要性估计的 query 数,、 选择的 vertical/slash 模式数。
Quest:加载 page 表示
其中 page 大小(实验中为 16)。
六、核心结果
6.1 RQ1: isoCost 分析——稀疏注意力是否有效?
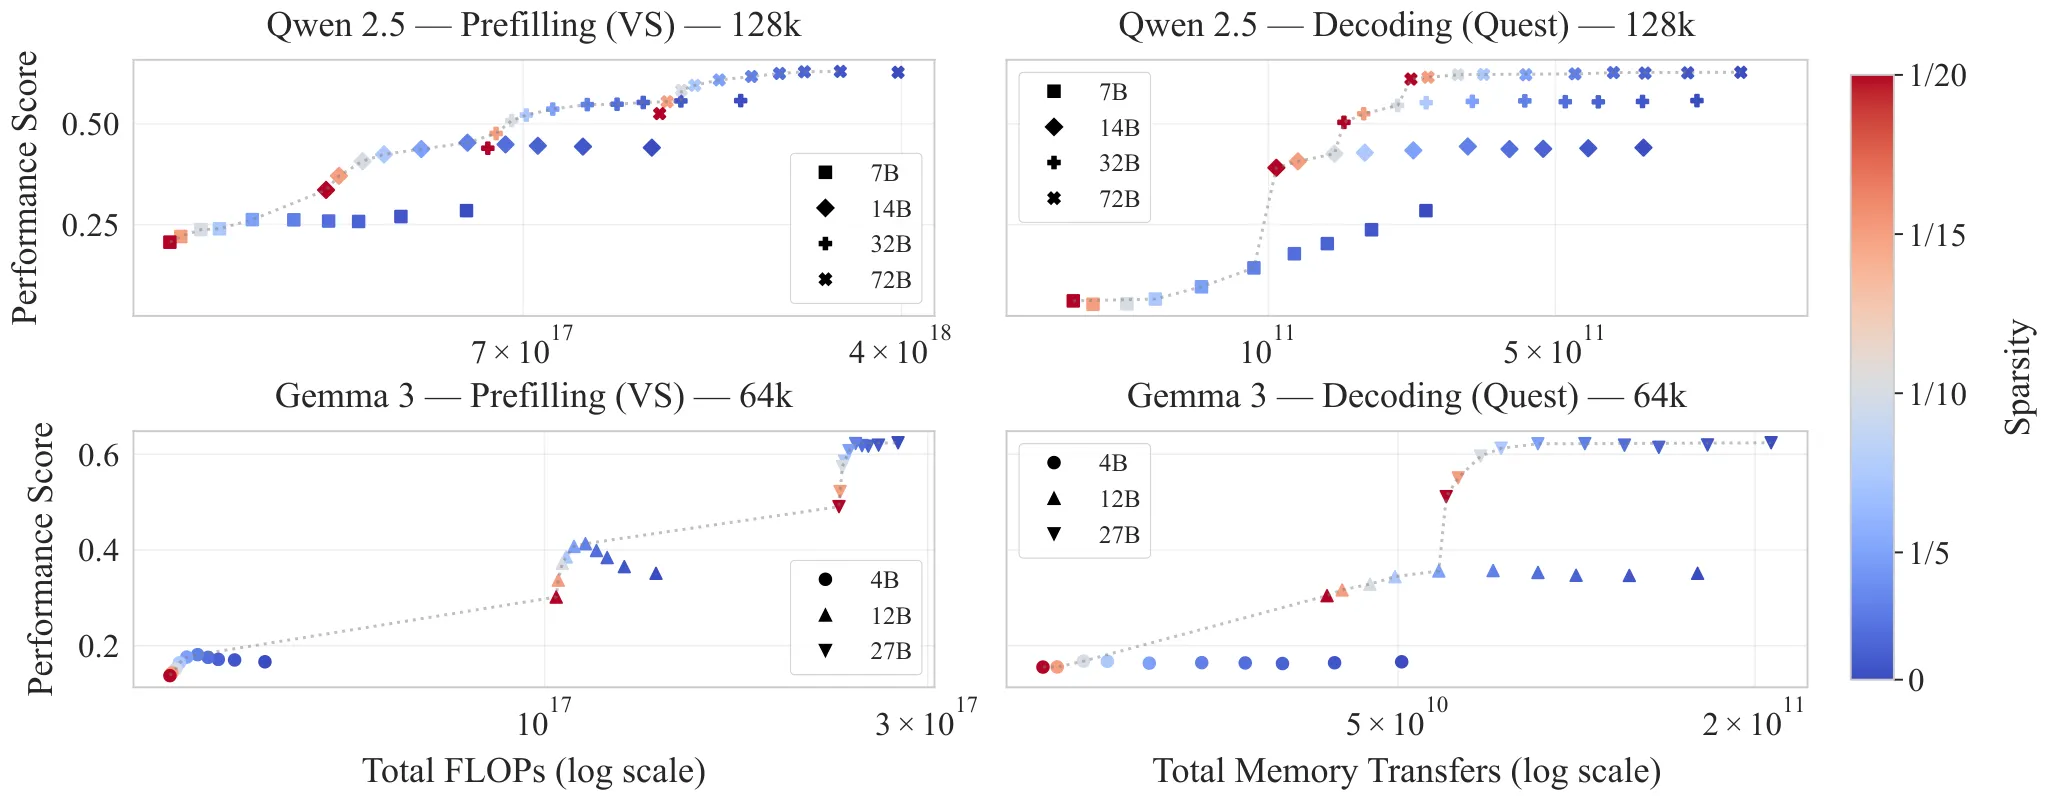
图 2 Qwen 2.5(128K tokens)与 Gemma 3(64K tokens)的 isoCost 分析。每个点对应一个 (模型规模, 稀疏度) 配置,性能聚合自 9 个任务。左列:Vertical-Slash(FLOPs)。右列:Quest(内存传输)。批大小 B=64。虚线显示 Pareto 前沿。
关键发现:
- 稀疏注意力改进了 Pareto 前沿:存在效率交叉点——在等价计算成本下,更大的稀疏模型优于更小的稠密模型
- Qwen 128K:仅高稀疏度配置位于 Pareto 前沿上;prefilling 期间 0.8-0.93 稀疏度(1/5 至 1/15 预算)保持最优,0.95(1/20 预算)低于最优边界
- Decoding 对高稀疏度更具弹性:即使 0.95 稀疏度配置也优于更小的稠密模型
- Gemma 趋势不同:由于滑动窗口架构注意力占比低,prefilling 期间配置无重叠
6.2 Prefilling 计算分解
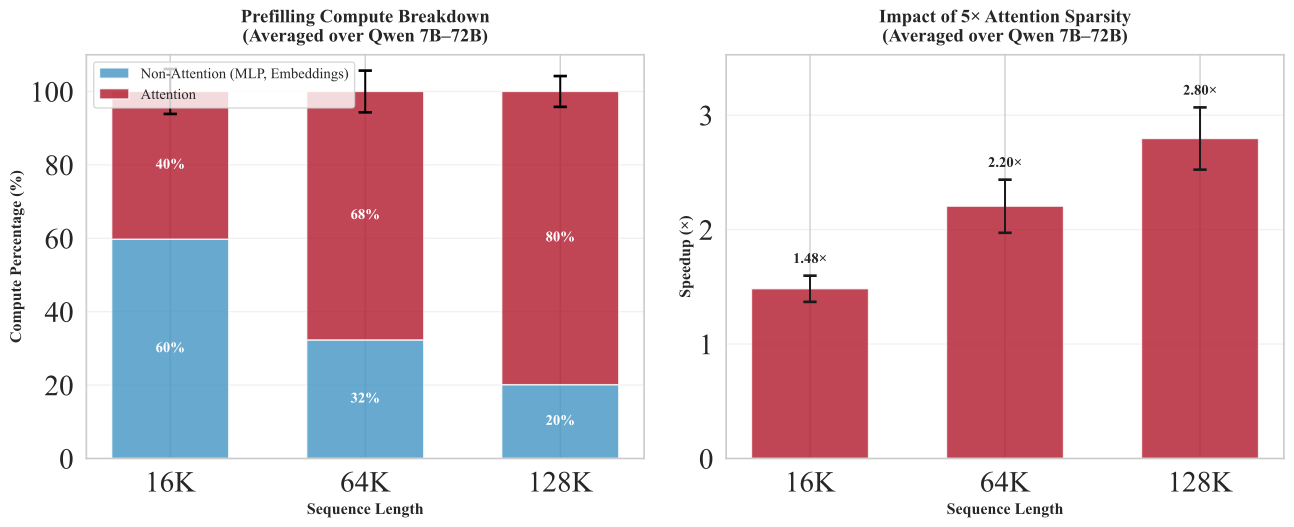
图 12 Prefilling 计算分解与稀疏度收益,平均自 Qwen 7B-72B。左:随序列长度从 16K 增至 128K,注意力占总 FLOPs 从 40% 升至 80%。右:相应地,5× 注意力稀疏度带来递增加速——从 16K 的 1.5× 到 128K 的 2.8×。
Prefilling 关键事实:
- 注意力 FLOPs 随序列长度二次缩放 ,非注意力成本(MLP、embeddings、logits)线性缩放
- 16K tokens:注意力占 40%,5× 稀疏度仅得 1.5× 加速
- 64K tokens:注意力占 68%,2.2× 加速
- 128K tokens:注意力主导 80%,2.8× 加速
- 标准差跨模型规模 ±4-6%,关系与规模无关
6.3 Decoding 计算分解
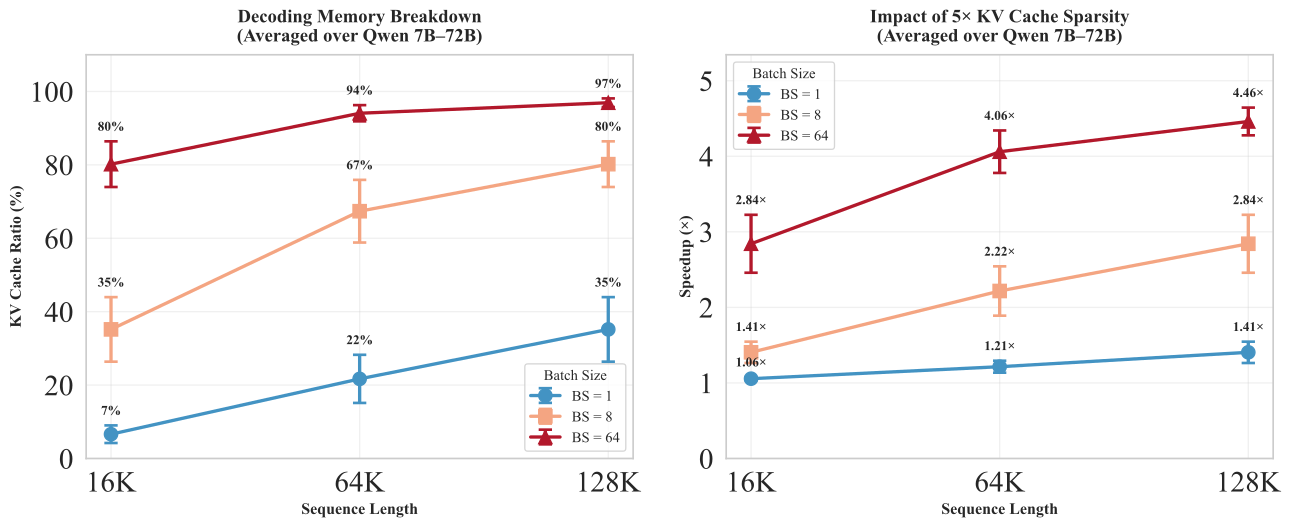
图 13 Decoding 成本分解与稀疏度收益,平均自 Qwen 7B-72B。左:KV 缓存比例随序列长度与批大小同时增加。右:5× KV 缓存稀疏度对应加速。批大小 1 时收益极小;批大小 64 时加速达 2.8-4.7×。
Decoding 关键事实:
- 与 prefilling 不同,decoding 成本依赖序列长度和批大小
- 批大小 1:KV 缓存仅占 7%(16K)至 35%(128K)——权重加载主导
- 批大小 8:KV 缓存达 35-80%
- 批大小 64:KV 缓存主导 80-97%,稀疏注意力变得高效,2.8-4.7× 加速
- 标准差 ±1-9%,跨模型规模稳健
6.4 滑动窗口架构的影响
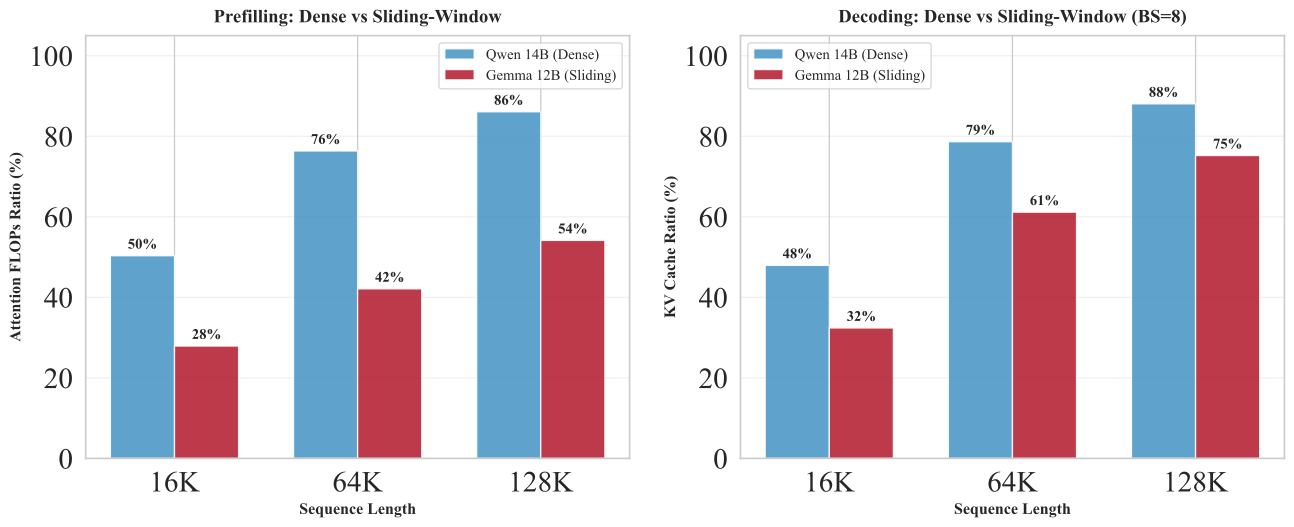
图 14 Qwen 14B(稠密注意力)与 Gemma 12B(滑动窗口注意力)在批大小 8 下的注意力成本比例对比。Gemma 的架构稀疏性导致明显更低的注意力比例,需要更长序列才能从额外稀疏注意力中获益。
具体数字(64K tokens, 批大小 8):
- Prefilling:Qwen 14B 76% vs Gemma 12B 42%
- Decoding:Qwen 79% vs Gemma 61%
- 128K tokens 时 Gemma 升至 54%(prefill)/ 75%(decode)
实际影响:Gemma 在 64K 注意力占比低,稀疏 prefilling 削减的 FLOPs 比例较小,故密集-稀疏前沿在更高成本/更长序列处重叠。
6.5 RQ2: Per-Task 分析——哪种方法应被使用?
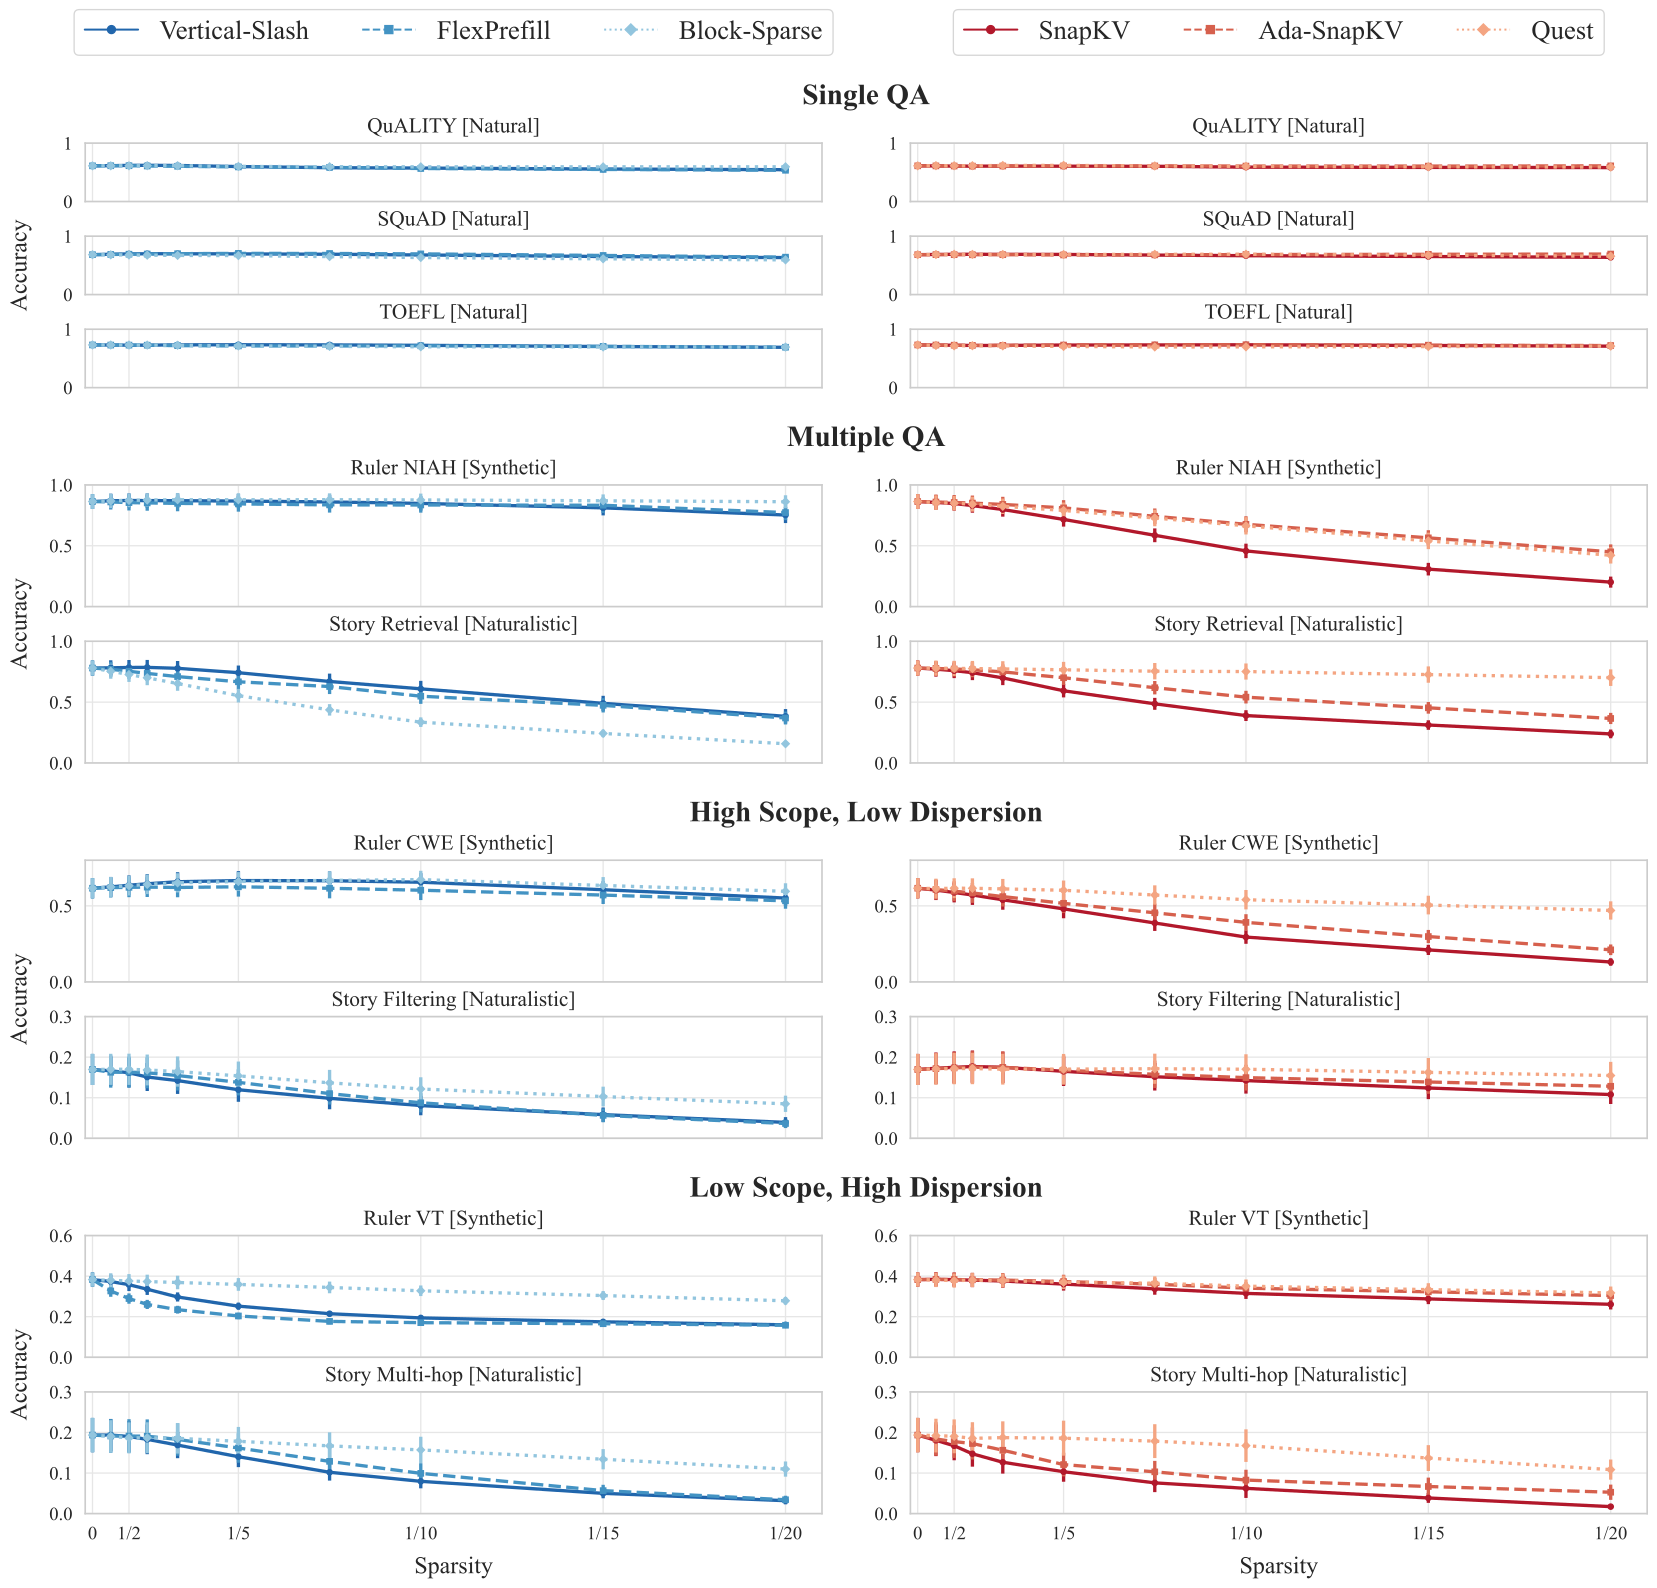
图 3 稀疏注意力方法的 per-task 性能对比,聚合自 Qwen 2.5、Llama 3.1、Gemma 3,序列长度 16K-64K。误差棒表示标准误。左列:prefilling(Vertical-Slash、FlexPrefill、Block-Sparse)。右列:decoding(SnapKV、Ada-SnapKV、Quest)。任务按信息检索特征分组。
6.5.1 Prefill 与 decode 阶段呈现不同灵活性
如 §2 所述,每个推理阶段的计算约束——重要性估计成本与核将稀疏转化为墙钟收益的能力——塑造了哪些模式是实用的,进而影响任务间泛化。
Prefilling 阶段:
- 训练无关领域中没有方法结合次二次(或近似二次)细粒度估计器与有效利用所得不规则稀疏的核
- 现有方法落入两种策略:全局细粒度单元选择(Vertical-Slash) 或 block-to-block 选择(Block-Sparse)
- 无一种主导——最优选择依赖任务
- Vertical-Slash 在检索任务(Low Scope, Low Dispersion)表现强,因支持细粒度 token 定位
- Block-Sparse 在需更广上下文或多步推理的任务(High Scope 或 Dispersion,如 Ruler VT、Story Filtering)有优势,可为每个 query 块选择不同 key-token 块
Decoding 阶段:
- token-to-page 选择变得便宜(每步仅一个 query)
- 更大灵活性使 Quest 跨任务泛化更好、容忍更高压缩,且保留完整 KV 缓存
- 驱逐式方法(SnapKV、Ada-SnapKV)展示永久丢弃 token 的代价——不可逆压缩在丢弃 token 后续变相关时有害
- Quest 在合成任务(如 Ruler NIAH)可能降级——随机符号序列产生与自然语言相比更不易区分的 key 表示(page 级粒度放大此效应)
6.5.2 动态预算分配收益依赖阶段
- Prefilling:FlexPrefill 匹配或低于 Vertical-Slash 均匀分配——可能由于 “attention sink 现象”:阈值选择捕获高注意力 token,但错过分布长尾中的信息
- Decoding:Ada-SnapKV 一致优于均匀 SnapKV,尤其在多 query 任务(Story Retrieval),但两者驱逐方法仍劣于 Quest 的完整缓存方法
6.5.3 稀疏容忍度跨任务差异巨大
- Single QA 任务(QuALITY、SQuAD、TOEFL):容忍 0.95 稀疏度(1/20 预算)且所有方法降级极小
- Multiple QA 任务(Ruler NIAH、Story Retrieval):在 0.8-0.9(1/5 至 1/10 预算)显著降级
- High Scope 或 High Dispersion 任务:即使在 0.5-0.67(1/2 至 1/3 预算)也对某些方法降级
部署风险:仅在 Single QA 基准上评估或跨任务类型求平均会掩盖这些脆弱性。仅在检索任务上安全的稀疏度可能在聚合或多跳推理任务上失败。
序列自然性不对称影响方法:Quest 在自然语言检索(Story Retrieval)优于 Ada-SnapKV,但在合成检索(Ruler NIAH)劣于——强调需要跨越自然与合成数据的基准。
6.6 RQ3: 序列长度对稀疏容忍度的影响
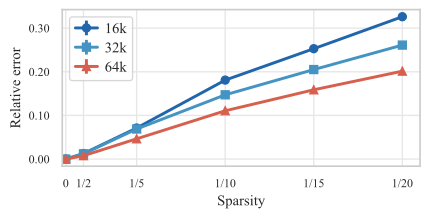
图 4 序列长度对稀疏容忍度的影响。相对误差为 , 表示平均性能。结果聚合自所有任务、方法、模型(Qwen 2.5、Llama 3.1、Gemma 3)。
关键发现:对于固定注意力预算比例,更长序列导致更小降级:
- 1/20 预算下,相对误差从 ≈0.33(16K)降至 ≈0.26(32K)和 ≈0.20(64K)
- 模式跨所有模型家族一致
解释:可能由 Herdan 定律 解释——新信息随距离变稀少,从而支持随序列长度的更高稀疏度。
转换为预算缩放(作为近似 iso-error 曲线解读):
- 目标相对误差 ≈0.2 时所需预算比例:1/10(16K)→ 1/15(32K)→ 1/20(64K)
- 对比固定 token 预算:随长度增长,比例变为 1/10 → 1/20 → 1/40——这在 32K 已超过 ≈0.2 误差目标
- 更严格目标 ≈0.1:1/5 在 16K 与 32K 都保持 <0.1,64K 仅需适度降低稀疏度
实际含义:最优 token 预算应随序列长度次线性增长——翻倍上下文不需要翻倍 token 预算,但保持预算恒定会导致降级递增。生产环境中的固定预算方法次优,未来设计应将稀疏度适配到序列长度。
6.7 跨家族结果
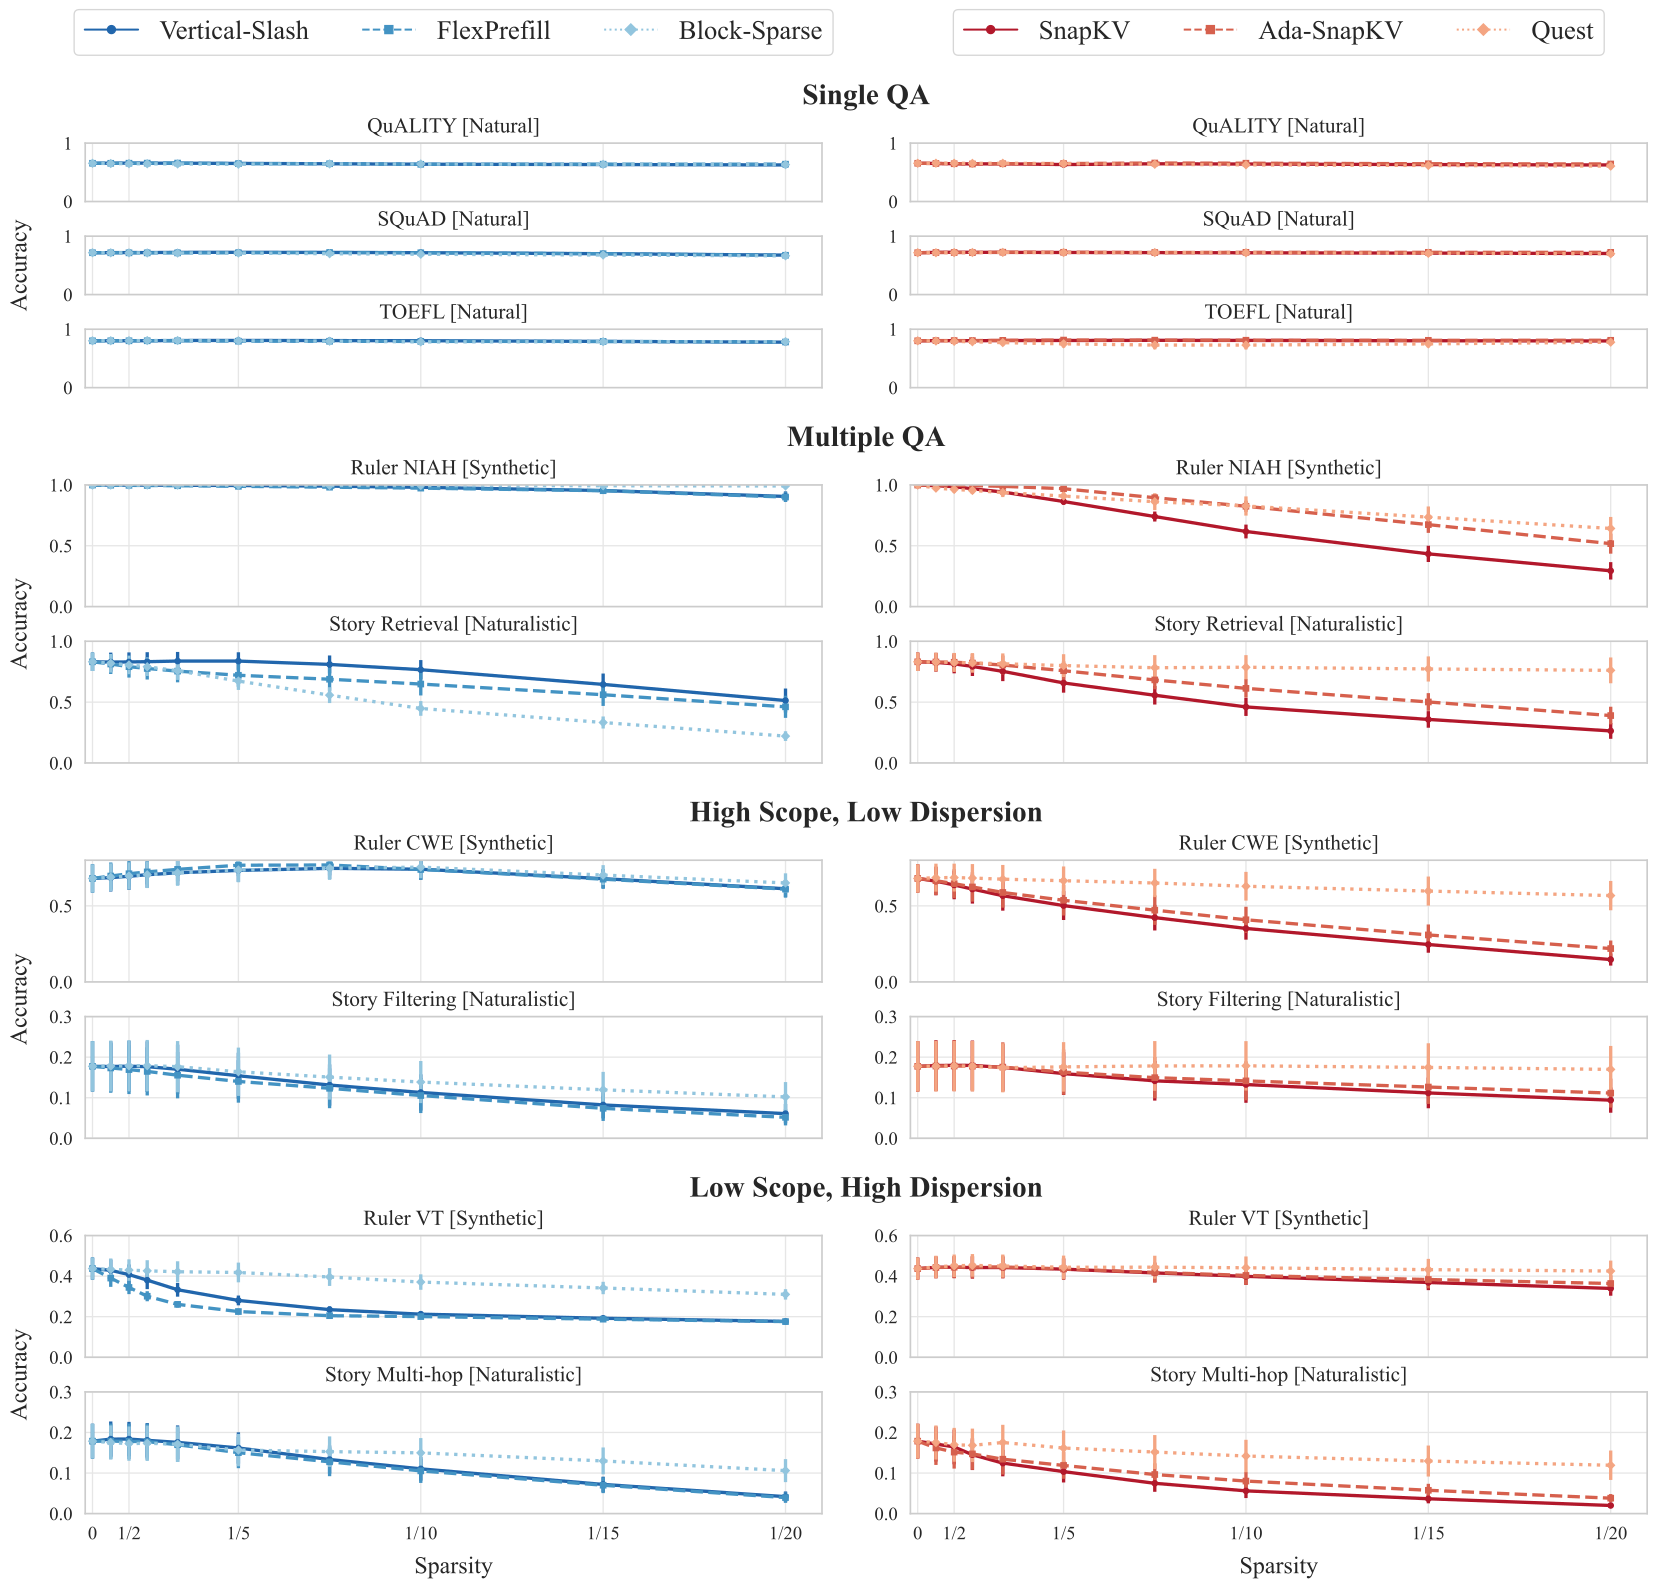 图 15 Qwen 2.5 模型(7B-72B)per-task 性能,序列长度 16K、32K、64K。左:prefilling 方法;右:decoding 方法。
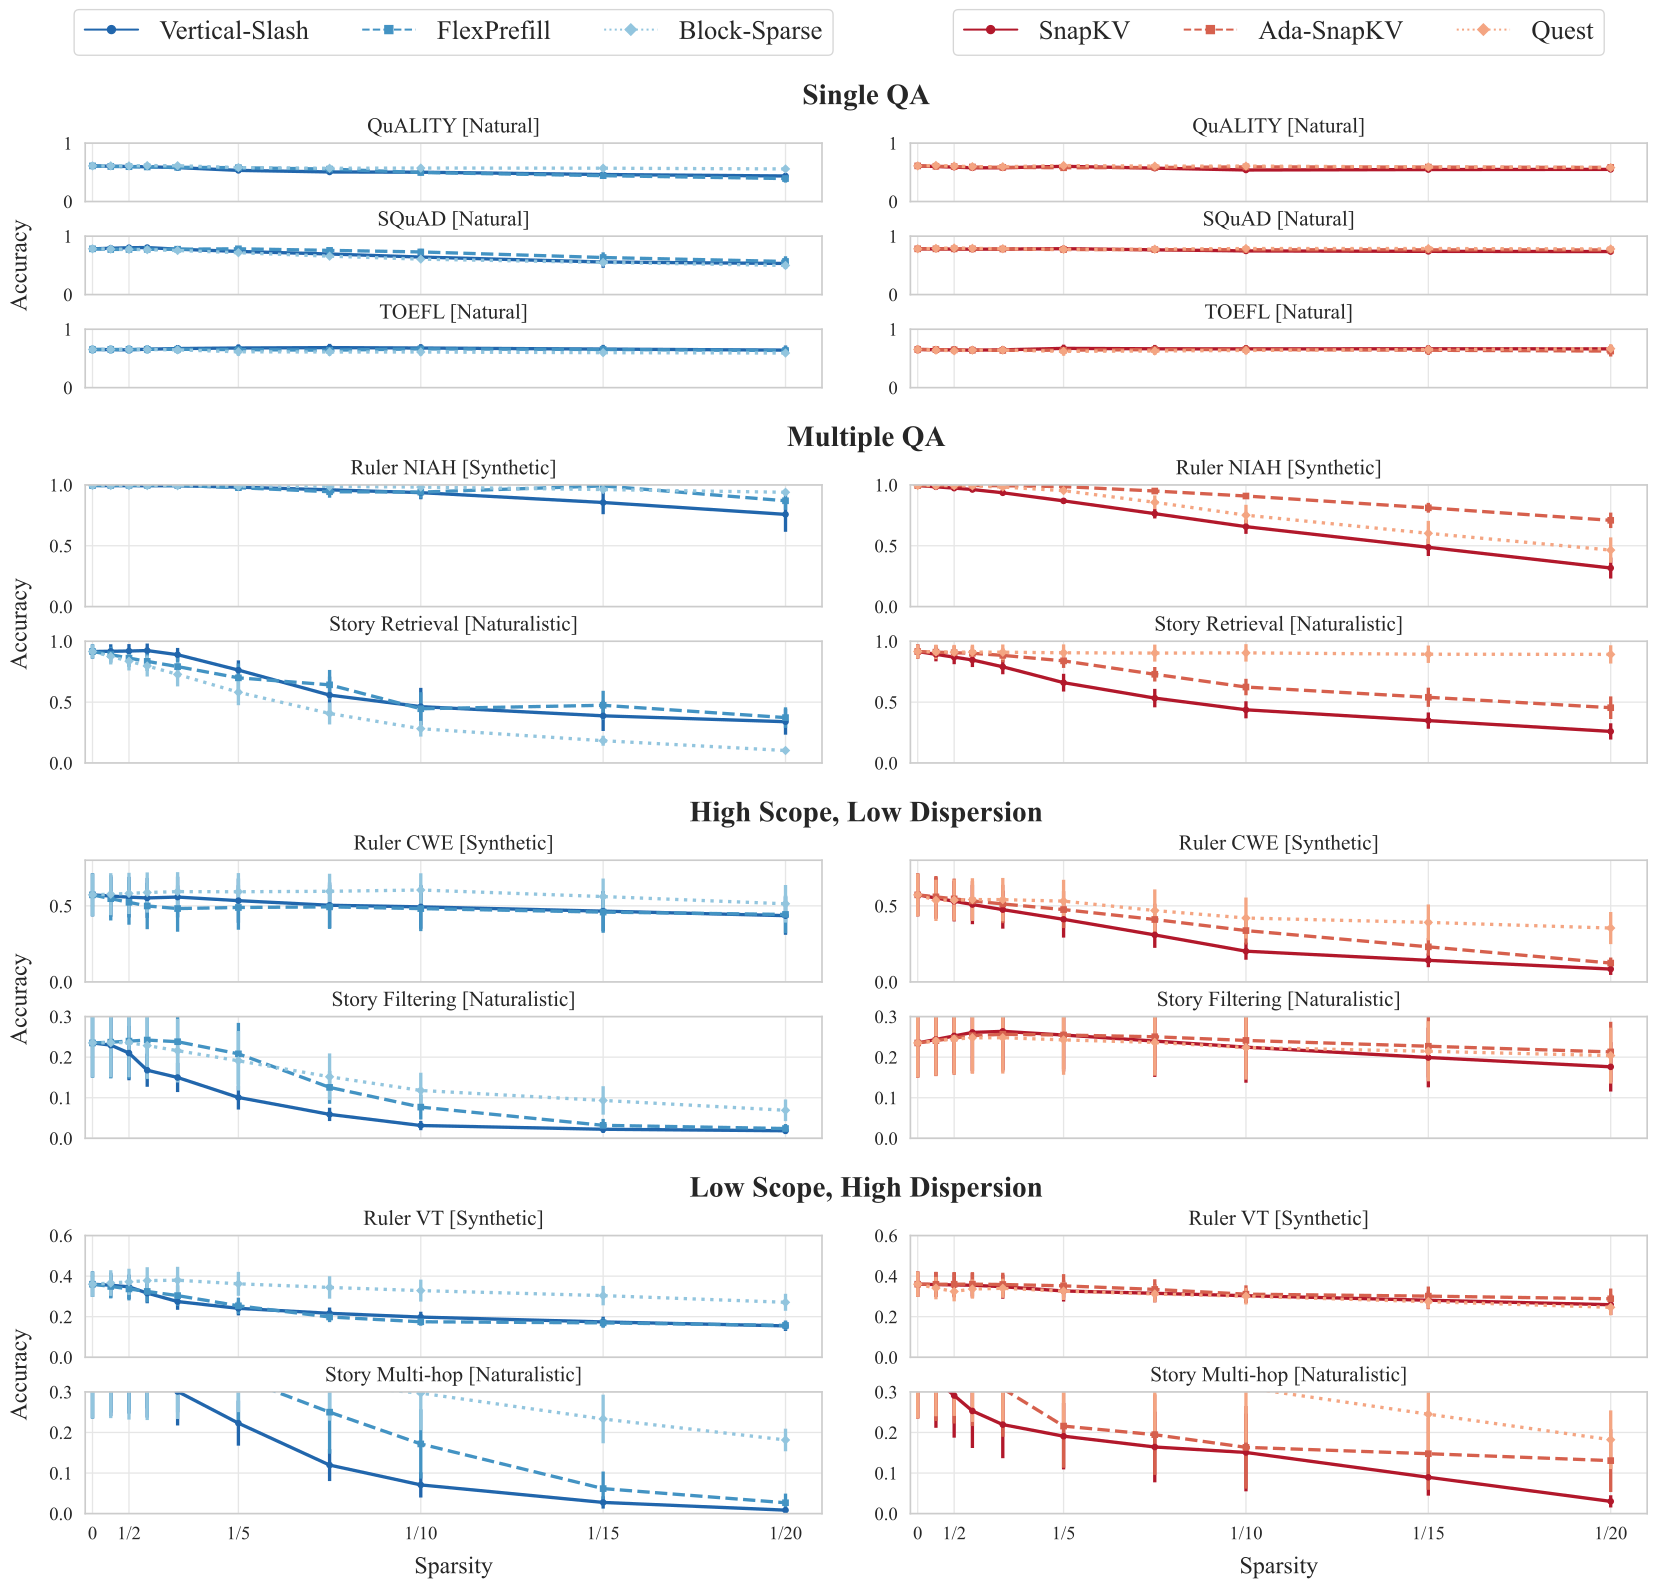 图 16 Llama 3.1 模型(8B、70B)per-task 性能。
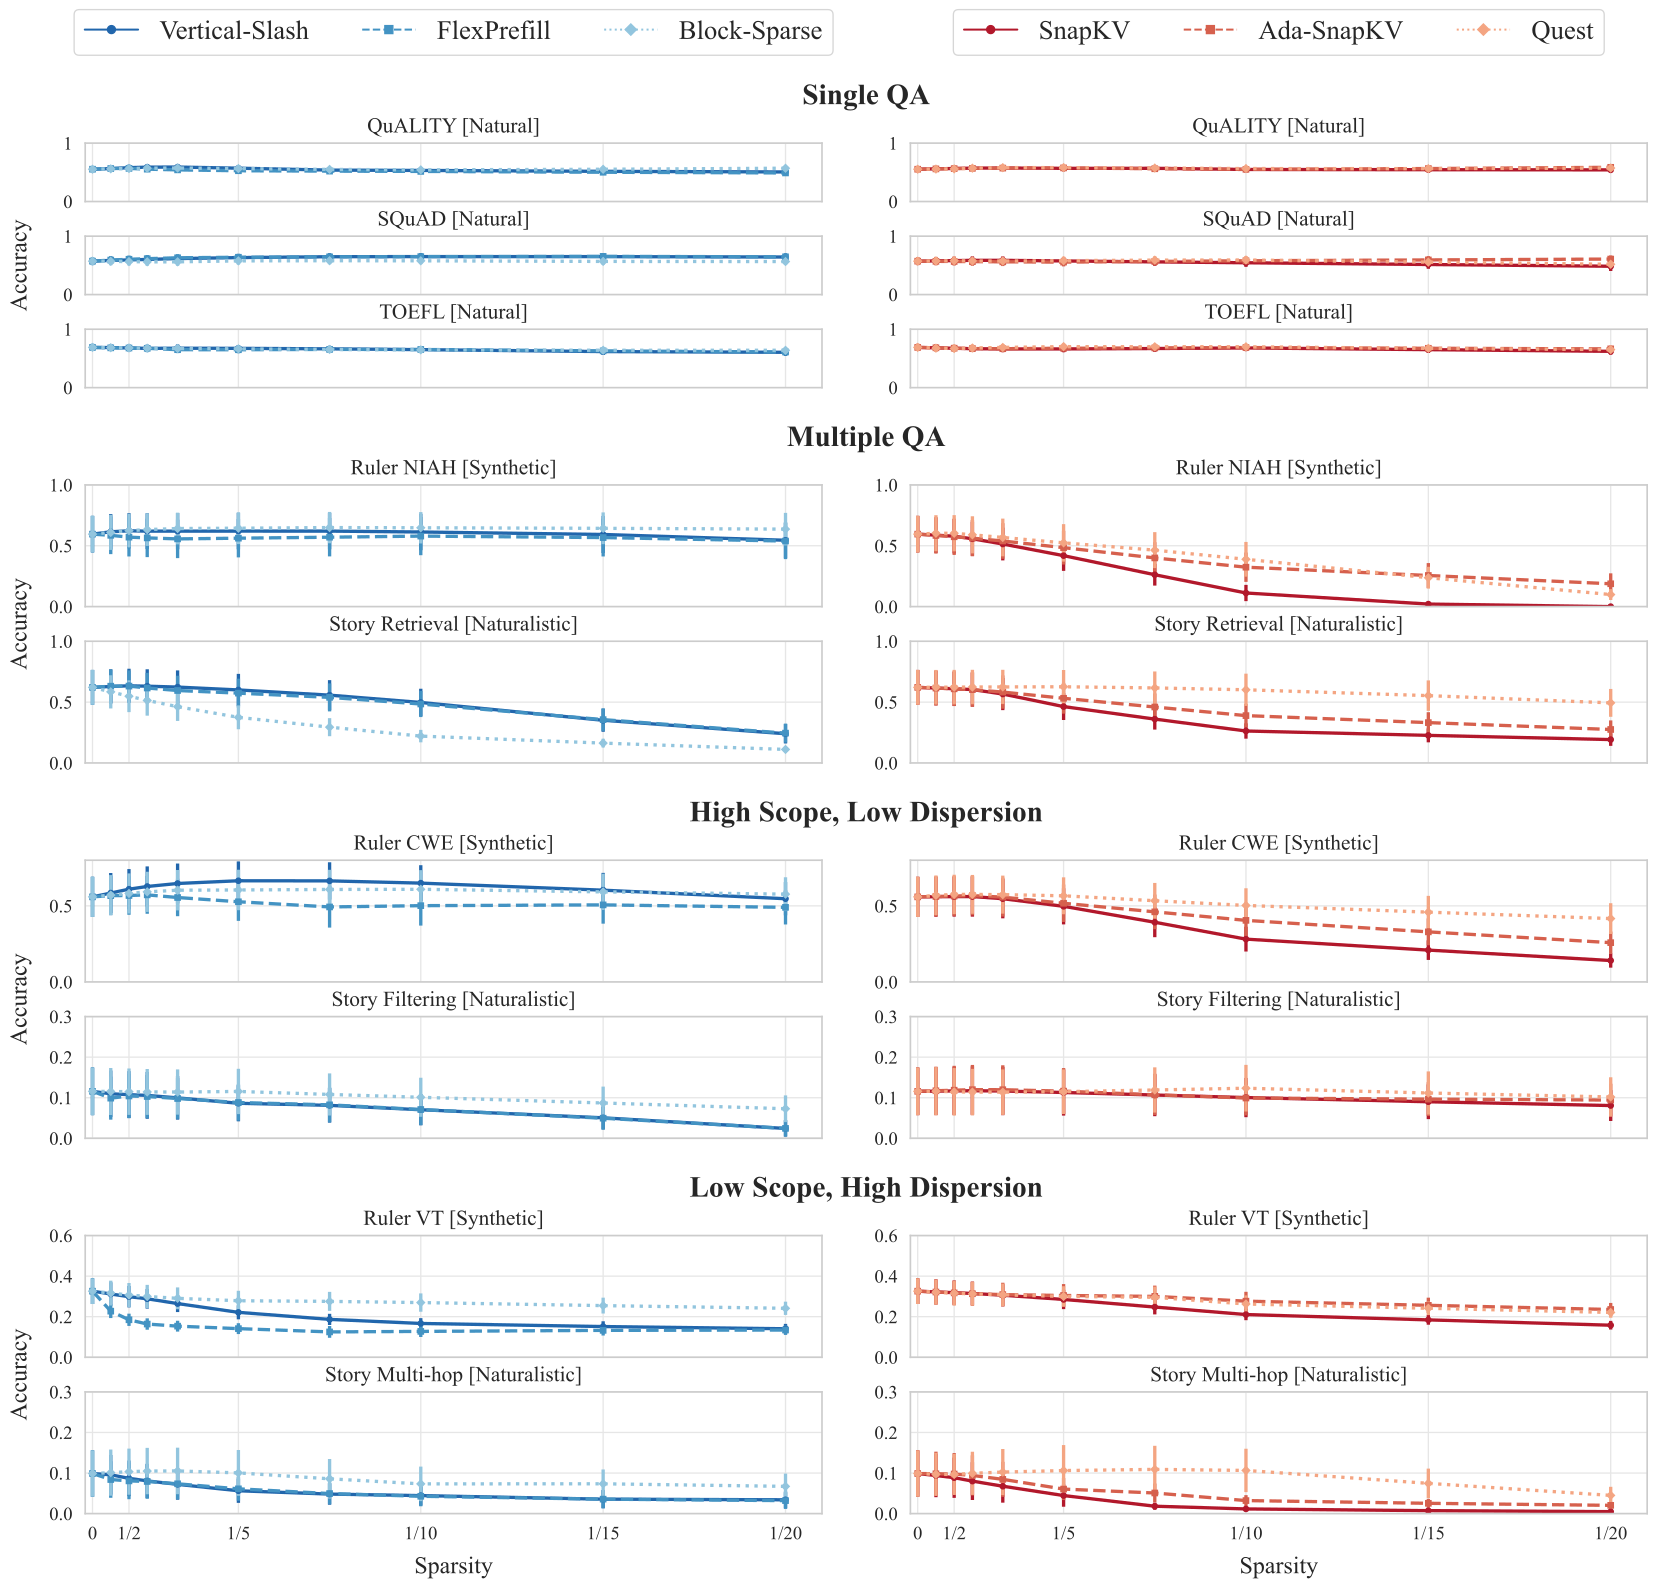 图 17 Gemma 3 模型(4B、12B、27B)per-task 性能。
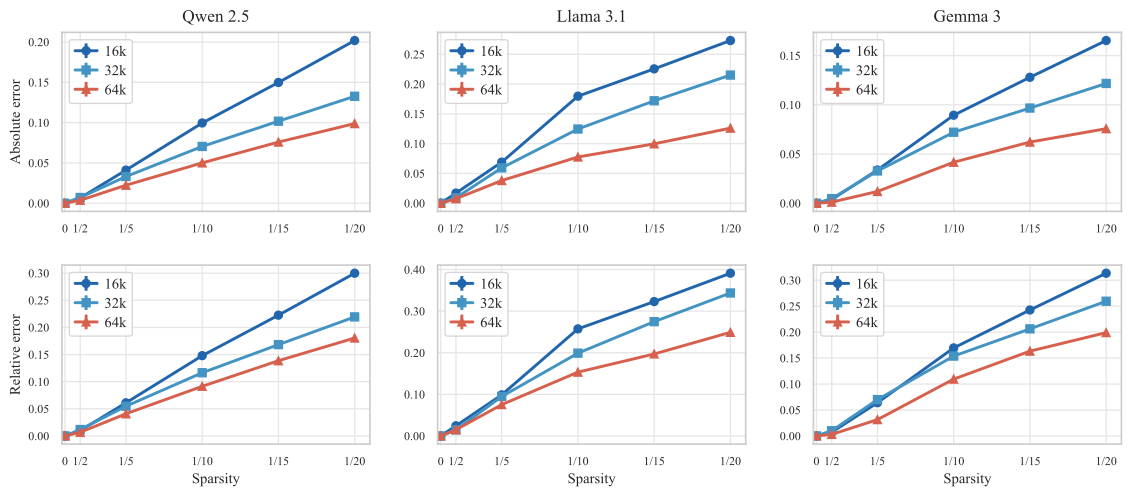 图 18 各模型家族的序列长度对稀疏容忍度影响。
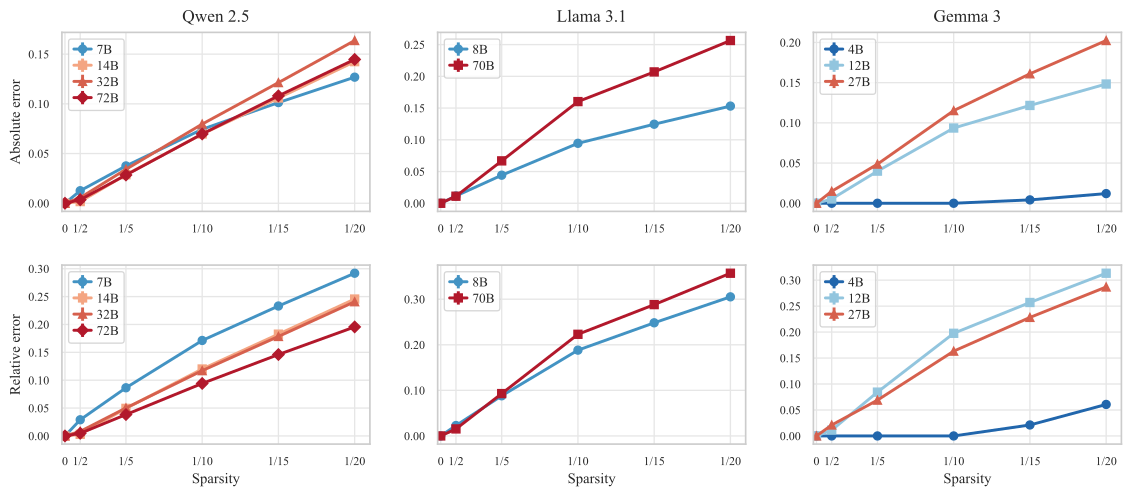 图 20 模型规模对稀疏容忍度的影响,聚合自所有任务。
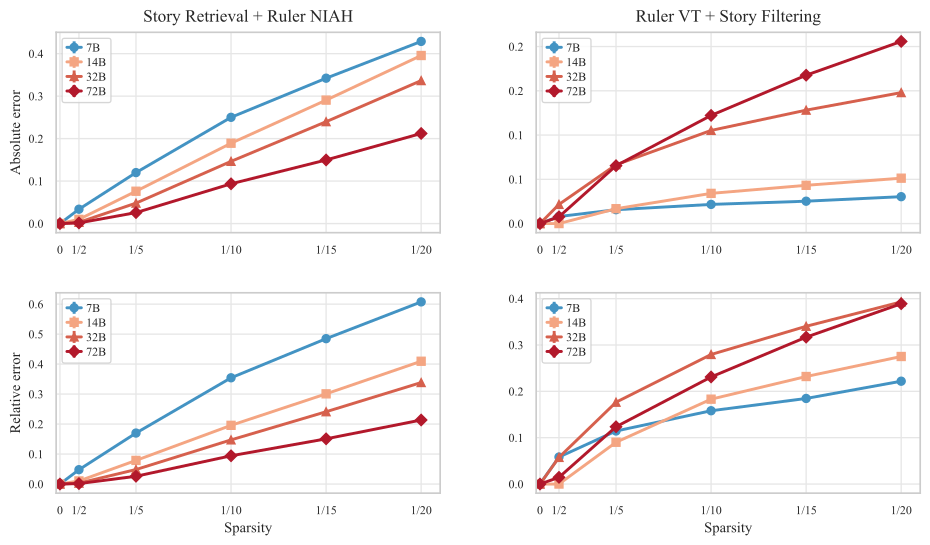 图 21 Qwen 2.5(7B-72B)的模型规模对稀疏容忍度影响。
七、实现细节
7.1 关键超参(A.1 节)
Block-Sparse:
- 块大小 16×16(基于 Qwen-7B 16K 消融)
- top-k 关键块,k 通过二分搜索确定
- 总是保留 attention sinks(首个 key 块)和局部上下文(对角 key 块)
Vertical-Slash:
- 统一分配 vertical + slash 预算
- 用近似窗口估计重要性;任务相关最优窗口:512 tokens(检索密集任务)、256 tokens(其他)
- 保留前 4 前缀 token + 最近 64 局部 token
FlexPrefill:
- 阈值参数 α + 最小预算 min_budget
- 设置 τ=0 禁用 Query-Aware 注意力(隔离动态预算分配机制评估)
- min_budget=512 显著提升性能
- 高压缩比时 α=0(回退为 Vertical-Slash 均匀分配)
SnapKV:
- 均匀 token 预算
- 近似窗口 256 tokens
- 1D 平均池化核大小 21
- 保留前 4 + 最近 128 tokens
Ada-SnapKV:
- 头级动态 token 预算
- 用 max-aggregation(而非平均)跨 query 位置和头计算分数
- 每头最小预算 20% 容量(最优),10-50% 范围稳定
- 接近 100% 时降级急剧(确认动态分配收益)
Quest:
- 页面大小 16 tokens(基于消融)
- 用 page 内 key 的最小和最大值表示 page
- 每步选择最相关 pages,始终包含当前 token 所在 page
7.2 任务 token 长度统计
| 任务 | 均值 | 最小-最大 |
|---|---|---|
| QA QuALITY | 243.63 | 196-423 |
| QA SQuAD | 217.08 | 210-235 |
| QA ToeflQA | 237.67 | 202-270 |
| RULER CWE | 227.00 | 227-227 |
| RULER NIAH | 337.74 | 330-350 |
| RULER VT | 230.00 | 230-230 |
| Story Filtering | 184.00 | 184-184 |
| Story Multi-hop | 192.97 | 192-195 |
| Story Retrieval | 457.54 | 452-462 |
Table 3 各任务问题与指令的 token 长度统计(100 样本)。该数据指导 Vertical-Slash 与 FlexPrefill 的近似窗口选择。
八、消融研究
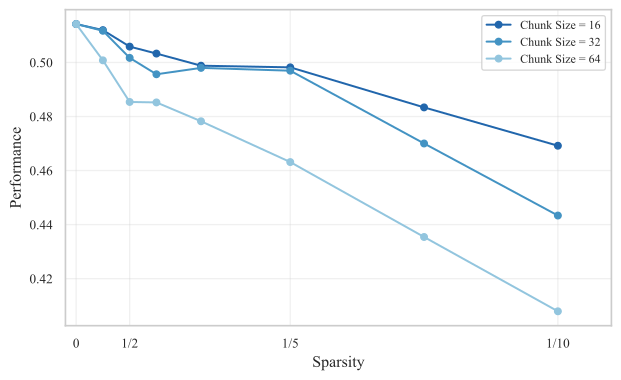 图 5 Block-Sparse 块大小消融(16×16 vs 其他)。
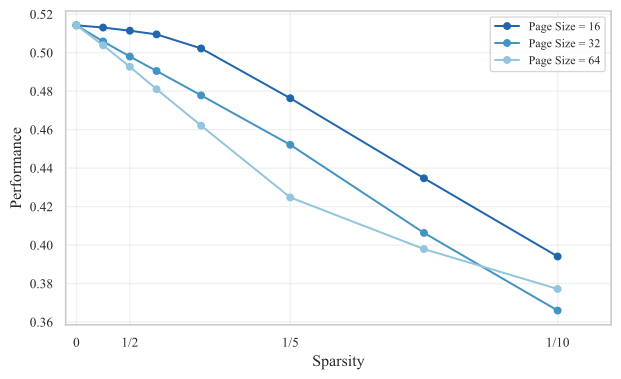 图 6 Quest 页面大小消融(16 tokens 为最优)。
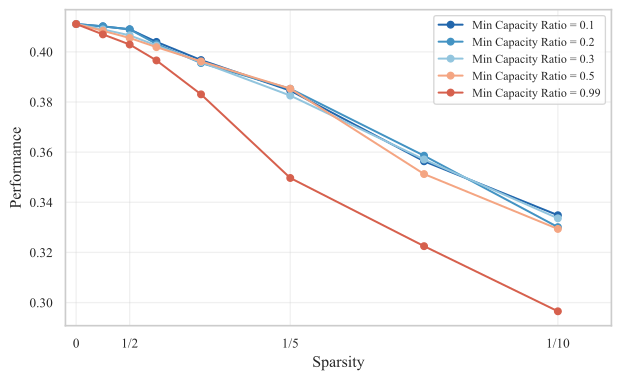 图 7 Ada-SnapKV 最小预算消融(20% 容量最优)。
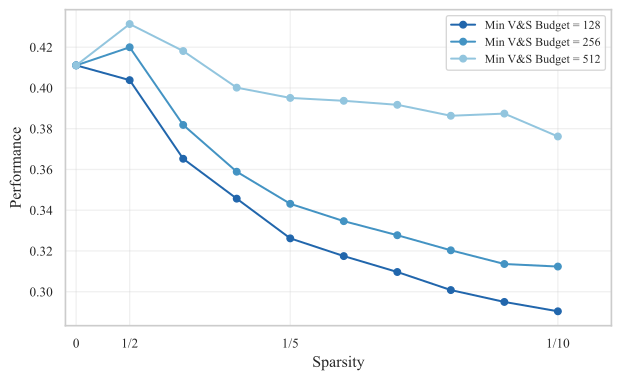 图 8 FlexPrefill 最小预算消融(512 显著提升)。
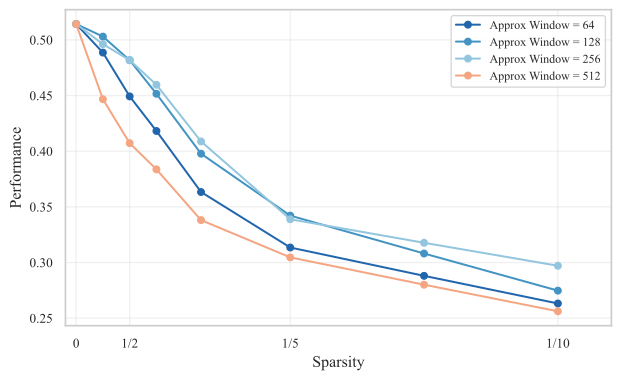 图 9 SnapKV/Ada-SnapKV 近似窗口消融(256 最优)。
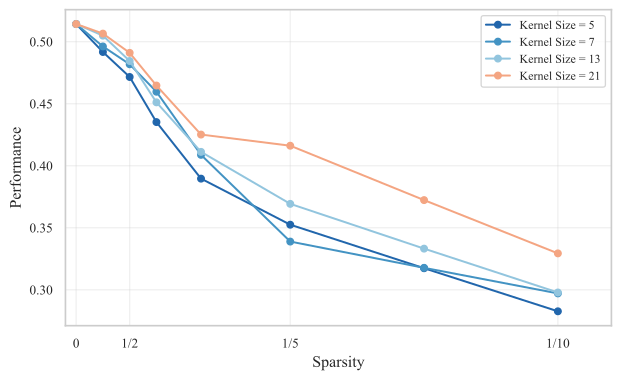 图 10 SnapKV/Ada-SnapKV 核大小消融(21 选中)。
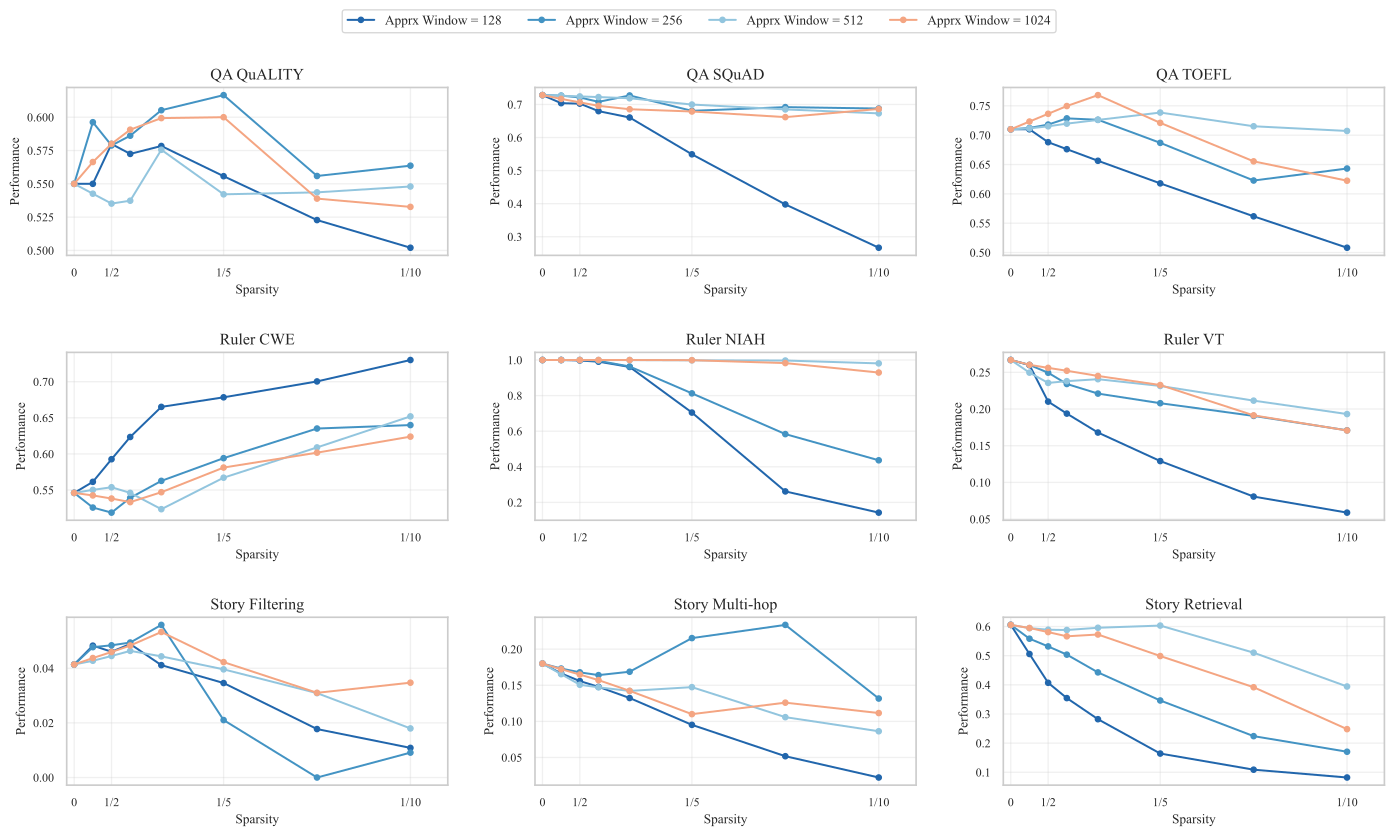 图 11 Vertical-Slash 近似窗口的 per-task 消融。
九、与现有研究比较(Appendix C)
| 工作 | 模型规模 | 序列长度 | Prefilling 评估 | 序列长度控制 |
|---|---|---|---|---|
| SCBench (Li et al. 2025) | 单家族 ≤2 个模型 | 未控制 | 无 | 无 |
| Liu et al. 2025b | ≤10B | - | 无 | - |
| Yuan et al. 2024 | ≤10B | ≤32K | - | - |
| 本文 (Sparse Frontier) | 4B-72B | 16K-128K | ✓ | ✓ 跨 4 个长度 |
Table 与现有稀疏注意力评估研究的比较。
本文是首个系统性进行 isoCost 分析 的工作,提供效率-精度权衡与跨模型规模/序列长度/稀疏度的泛化新洞见。
十、核心创新
| 创新点 | 描述 | 理论/实验依据 |
|---|---|---|
| 四轴分类法 | 沿 unit/estimation/budget/KV cache 四个轴组织方法景观 | 综述 150+ arXiv 论文 |
| isoCost 分析框架 | 在等价 FLOPs(prefill)或内存传输(decode)下比较方法 | Pareto 前沿揭示效率交叉点 |
| 9 任务基准 | 引入 3 个新 Story 任务填补合成-自然空白 | RULER 任务自然性不足 |
| 7065 配置实证 | 涵盖 3 家族、4 长度、10 稀疏度等级 | 4×8 H100 GPU × 21 天 |
| 首次量化两阶段不对称 | 揭示 prefill/decode 在稀疏模式选择上的根本差异 | per-task 性能对比 |
| Herdan 定律解释 | 序列长度-稀疏容忍度关系的语言学解释 | 跨家族一致趋势 |
十一、核心结论
11.1 RQ1 答案:稀疏注意力有效
在等价计算成本下,更大的稀疏模型优于更小的稠密模型。稀疏注意力改进了 Pareto 前沿。对于长序列,仅高稀疏度配置位于 Pareto 前沿。
11.2 RQ2 答案:阶段决定方法选择
Prefilling 阶段:训练无关方法中,没有方法结合细粒度估计器与将所得稀疏转化为墙钟收益的核——迫使在 global-to-token (Vertical-Slash) 与 block-to-block (Block-Sparse) 选择之间做任务依赖取舍。
Decoding 阶段:per-query 选择便宜,token-to-page 方法(如 Quest)实现更好泛化与更高压缩容忍度。
11.3 RQ3 答案:长序列容忍更高稀疏度
在固定注意力预算比例下,更长序列导致更小降级。模式跨所有模型家族一致。生产环境中的固定预算方法次优——未来设计应将稀疏度适配到序列长度(次线性增长)。
十二、局限性
- 仅评估训练无关方法:训练式方法可能减少训练-推理失配,但需大量计算资源与可能的专有数据访问
- 实验覆盖范围有限:3 个模型家族(满足受控缩放实验方法学要求);其他家族可能表现不同
- Gemma 3 在 128K 表现近零:限制了对该架构在超长序列上的洞见
十三、实用部署建议
基于本文发现,给出以下实践指导:
- Prefilling 阶段:
- 检索密集任务(低范围低分散度)→ 优先 Vertical-Slash
- 多跳推理或广上下文任务(高范围或高分散度)→ 优先 Block-Sparse
- Decoding 阶段:
- 优先 Quest(token-to-page 完整缓存)以实现更好泛化与更高压缩
- 内存受限时考虑 Ada-SnapKV,但需接受驱逐不可逆性
- 稀疏度选择:
- 短序列(16K):保守 ≤ 0.5(1/2 预算)
- 长序列(≥64K):可激进至 0.93-0.95(1/15 至 1/20 预算)
- 避免固定预算跨所有长度
- 评估建议:
- 跨多种任务类型评估,仅在 Single QA 基准评估会掩盖脆弱性
- 包含自然语言与合成数据——Quest 在自然语言优于 Ada-SnapKV,反之亦然
十四、参考资源
- arXiv: https://arxiv.org/abs/2504.17768
- HTML 版本: https://arxiv.org/html/2504.17768v3
- PDF 版本: https://arxiv.org/pdf/2504.17768
- 代码: https://github.com/pnawrot/sparse-frontier
- 作者机构: University of Edinburgh, Cohere, Meta
- 评估模型: Qwen 2.5 (7B-72B), Llama 3.1 (8B-70B), Gemma 3 (4B-27B)
- 对比方法: Vertical-Slash, FlexPrefill, Block-Sparse, SnapKV, Ada-SnapKV, Quest
- 计算资源: 4×8 H100 GPU × 21 天 ≈ 672 GPU-天
- ERC 项目: AToM-FM (101222956)