Lumos: Efficient Performance Modeling and Estimation for Large-scale LLM Training
Lumos提出高效的大规模LLM训练性能建模与估算方法,支持训练资源优化配置。
Lumos: Efficient Performance Modeling and Estimation for Large-scale LLM Training
一、论文概述 (Paper Overview)
基本信息
| 字段 | 内容 |
|---|---|
| 论文标题 | Lumos: Efficient Performance Modeling and Estimation for Large-scale LLM Training |
| arXiv ID | 2504.09307 |
| 作者 | Mingyu Liang, Hiwot Tadese Kassa, Wenyin Fu, Brian Coutinho, Louis Feng, Christina Delimitrou |
| 发表日期 | 2025年4月12日 |
| 会议 | MLSys 2025 (Accepted) |
| 领域分类 | cs.DD (Distributed, Parallel, and Cluster Computing), cs.AI (Artificial Intelligence) |
| 论文链接 | arXiv:2504.09307 |
| PDF链接 |
摘要
在分布式环境中训练大语言模型(LLM)面临着重大挑战,这些挑战源于模型执行的复杂性、部署系统以及可配置策略的庞大空间。尽管存在各种优化技术,但在实践中实现高效率仍然困难。准确的性能模型能够有效表征和预测模型行为,对于指导优化工作和系统级研究至关重要。
Lumos 是一个基于trace驱动的性能建模和估算工具包,专为大规模LLM训练设计,旨在准确捕获和预测现代LLM的执行行为。该工具在生产级ML集群上使用多达512个NVIDIA H100 GPU对各种GPT-3变体进行了评估,证明其可以在不同模型和配置下以仅3.3%的平均误差重放执行时间及其他运行时细节。此外,论文还验证了Lumos从现有trace估算新配置性能的能力,从而促进了模型和部署配置的高效探索。
二、核心思想 (Core Idea)
研究动机
大规模LLM训练面临的核心挑战包括:
- 执行复杂性:现代LLM训练涉及复杂的3D并行策略(数据并行DP、张量并行TP、流水线并行PP),导致执行行为难以预测
- 通信开销:跨多机部署引入大量通信开销,计算与通信的重叠优化增加了执行建模的复杂度
- 配置空间庞大:并行策略、模型架构等可配置选项的组合空间极其庞大,在真实硬件上进行实验成本高昂
- 现有工具不足:如dPRO等基于trace的性能建模工具无法准确捕获LLM执行的复杂依赖关系,误差可达21.8%
核心解决方案
Lumos提出了一种基于trace驱动的性能建模方法,其核心思想是:
- 利用内置profiling工具:仅使用PyTorch Kineto等框架的内置profiling工具,无需额外的框架或模型instrumentation
- 构建精细执行图:从profiling trace构建task级别的执行图,捕获CPU和GPU任务之间的四种依赖关系
- 图操作与模拟:支持对执行图进行修改以探索不同配置,通过模拟预测性能而无需在真实硬件上部署
三、技术架构 (Technical Architecture)
系统工作流程
Lumos的工作流程分为四个主要阶段:
Trace收集 -> 执行图构建 -> 图操作 -> 性能模拟1. Trace收集 (Traces Collection)
使用PyTorch Kineto收集profiling trace,捕获以下运行时信息:
- PyTorch算子信息
- CUDA运行时事件
- GPU内核信息
- 包括名称、开始时间、持续时间、CUDA stream ID、线程ID、相关ID等
关键优势:仅需在模型中添加约10行代码的profiler hooks,相比Daydream和dPRO等需要大量框架和模型instrumentation的方法,显著提高了易用性。
2. 执行图构建 (Execution Graph Construction)
执行图包含两种类型的节点(任务):
| 任务类型 | 描述 | 记录信息 |
|---|---|---|
| CPU任务 | 包括PyTorch算子和CUDA运行时事件 | 元数据 + CPU线程ID |
| GPU任务 | 主要包括GPU内核 | 元数据 + CUDA stream ID |
3. 四种依赖关系
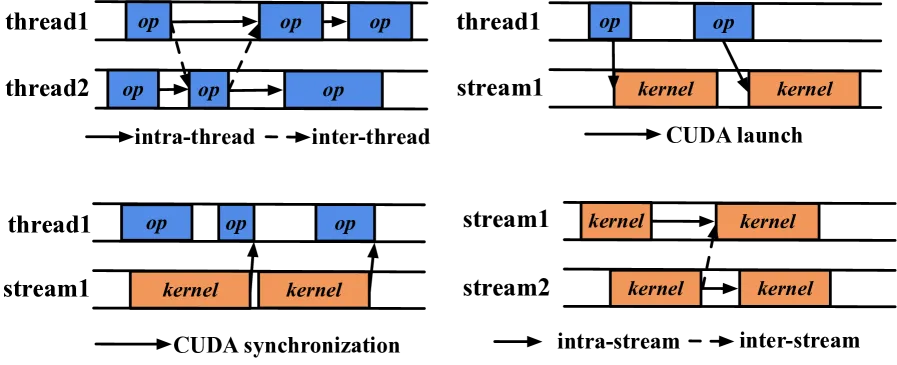 Figure 3: 任务间的四种依赖关系
| 依赖类型 | 描述 | 检测方法 |
|---|---|---|
| CPU到CPU | 包括线程内和线程间依赖 | 线程内:顺序执行;线程间:通过识别显著执行间隙并建立跨线程依赖 |
| CPU到GPU | CPU端CUDA事件启动GPU任务 | 利用Kineto trace中的correlation ID关联CPU事件和GPU内核 |
| GPU到CPU | CUDA同步事件(如cudaDeviceSync)阻塞CPU执行 | 创建从GPU任务到发起CPU任务的依赖 |
| GPU到GPU | 包括stream内和stream间依赖 | stream内:顺序执行;stream间:通过cudaEventRecord和cudaStreamWaitEvent机制捕获 |
关键创新:Lumos首次捕获了LLM训练中计算与通信重叠所产生的复杂stream间依赖关系,这是现有建模方法所忽视的。
4. 图操作 (Graph Manipulation)
支持两类配置修改:
并行策略调整:
- 数据并行:仅需调整通信任务的执行时间
- 流水线并行:更新流水线调度以适应新配置,根据调度策略确定新阶段中任务的执行顺序
模型架构调整:
- 层数变化:复制现有层及对应任务,插入到图中适当位置,按原始依赖模式重建依赖关系
- 隐藏层大小/FFN大小变化:调整所有相关算子和内核的输入张量维度
5. 性能模拟 (Simulation)
 Algorithm 1: Lumos的模拟算法
模拟器使用执行图来:
- 重放原始执行
- 预测替代配置下的性能
- 提供what-if场景的洞察
四、核心创新 (Key Innovations)
创新点总结
| 创新点 | 描述 | 与现有方法对比 |
|---|---|---|
| 精细依赖捕获 | 首次捕获LLM训练中计算与通信重叠的stream间依赖 | dPRO等方法无法准确建模这些依赖,导致误差高达21.8% |
| 最小化profiling开销 | 仅使用框架内置工具,约10行代码 | Daydream和dPRO需要大量框架和模型instrumentation |
| 图操作灵活性 | 支持并行策略和模型架构的修改 | 现有方法通常只支持固定配置的性能建模 |
| 细粒度性能重放 | 不仅重放整体执行时间,还重放详细的执行统计 | 提供SM利用率等细粒度指标 |
与dPRO的对比
| 特性 | Lumos | dPRO |
|---|---|---|
| 平均重放误差 | 3.3% | 14% |
| 最大误差 | <5% | 21.8% |
| stream间依赖捕获 | 完整 | 不完整 |
| 配置探索能力 | 支持 | 不支持 |
| Profiling开销 | 约10行代码 | 需要大量instrumentation |
五、实验结果 (Experimental Results)
实验设置
| 配置项 | 详情 |
|---|---|
| 硬件 | 最多512个NVIDIA H100 GPU(32台服务器) |
| 网络 | 每台主机8x 400Gbps RoCE DC-scale网络 |
| 软件栈 | CUDA 12.4, PyTorch 2.5, Transformer Engine 0.12.0, PyTorch Lightning 1.9.4 |
| 基准模型 | NVIDIA开源GPT-3实现(MLPerf Training Benchmarks) |
| 对比基线 | dPRO(state-of-the-art trace驱动性能建模工具) |
模型配置
| 模型名称 | 参数量 | 层数 | 隐藏维度 | FFN维度 | 注意力头数 | 头维度 |
|---|---|---|---|---|---|---|
| GPT-3 15B | 15B | 48 | 6144 | 12288 | 48 | 128 |
| GPT-3 44B | 44B | 48 | 12288 | 24576 | 48 | 128 |
| GPT-3 117B | 117B | 96 | 12288 | 24576 | 96 | 128 |
| GPT-3 175B | 175B | 96 | 12288 | 49152 | 96 | 128 |
实验结果
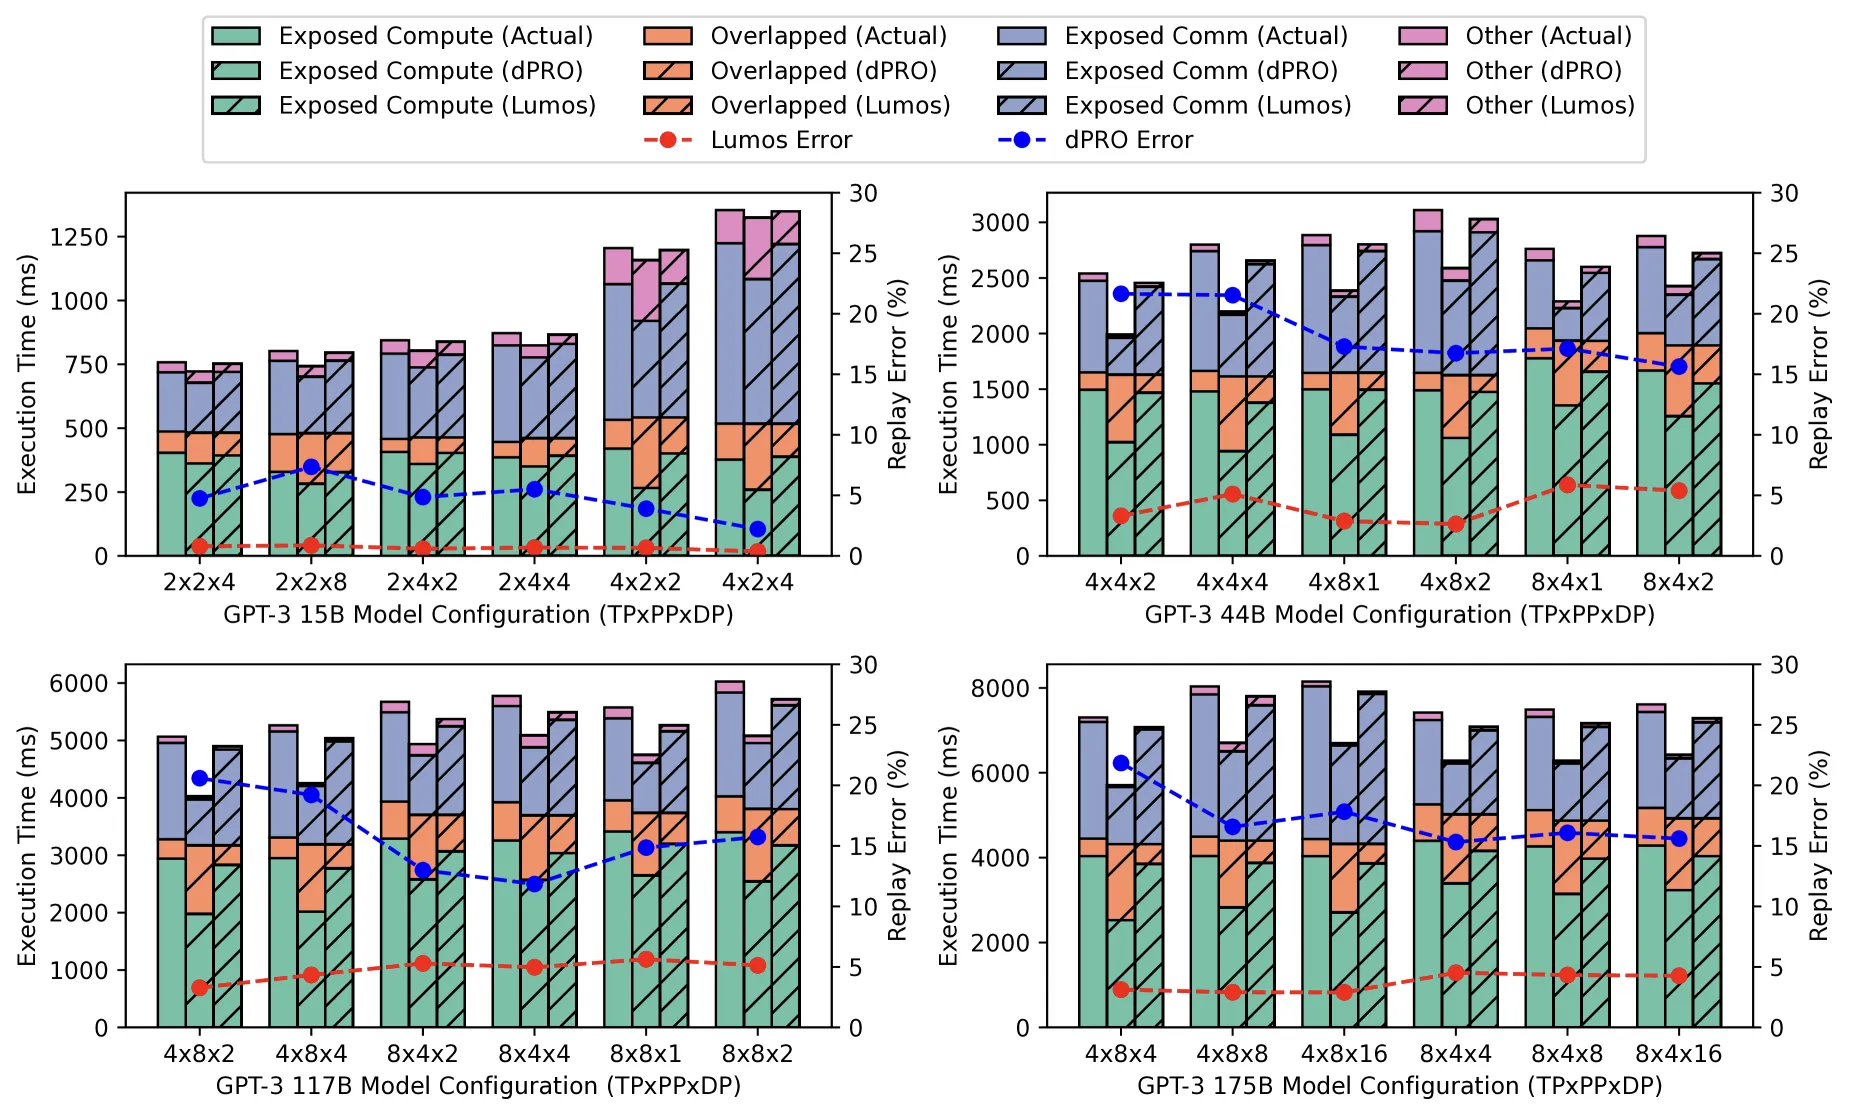
1. 重放准确性
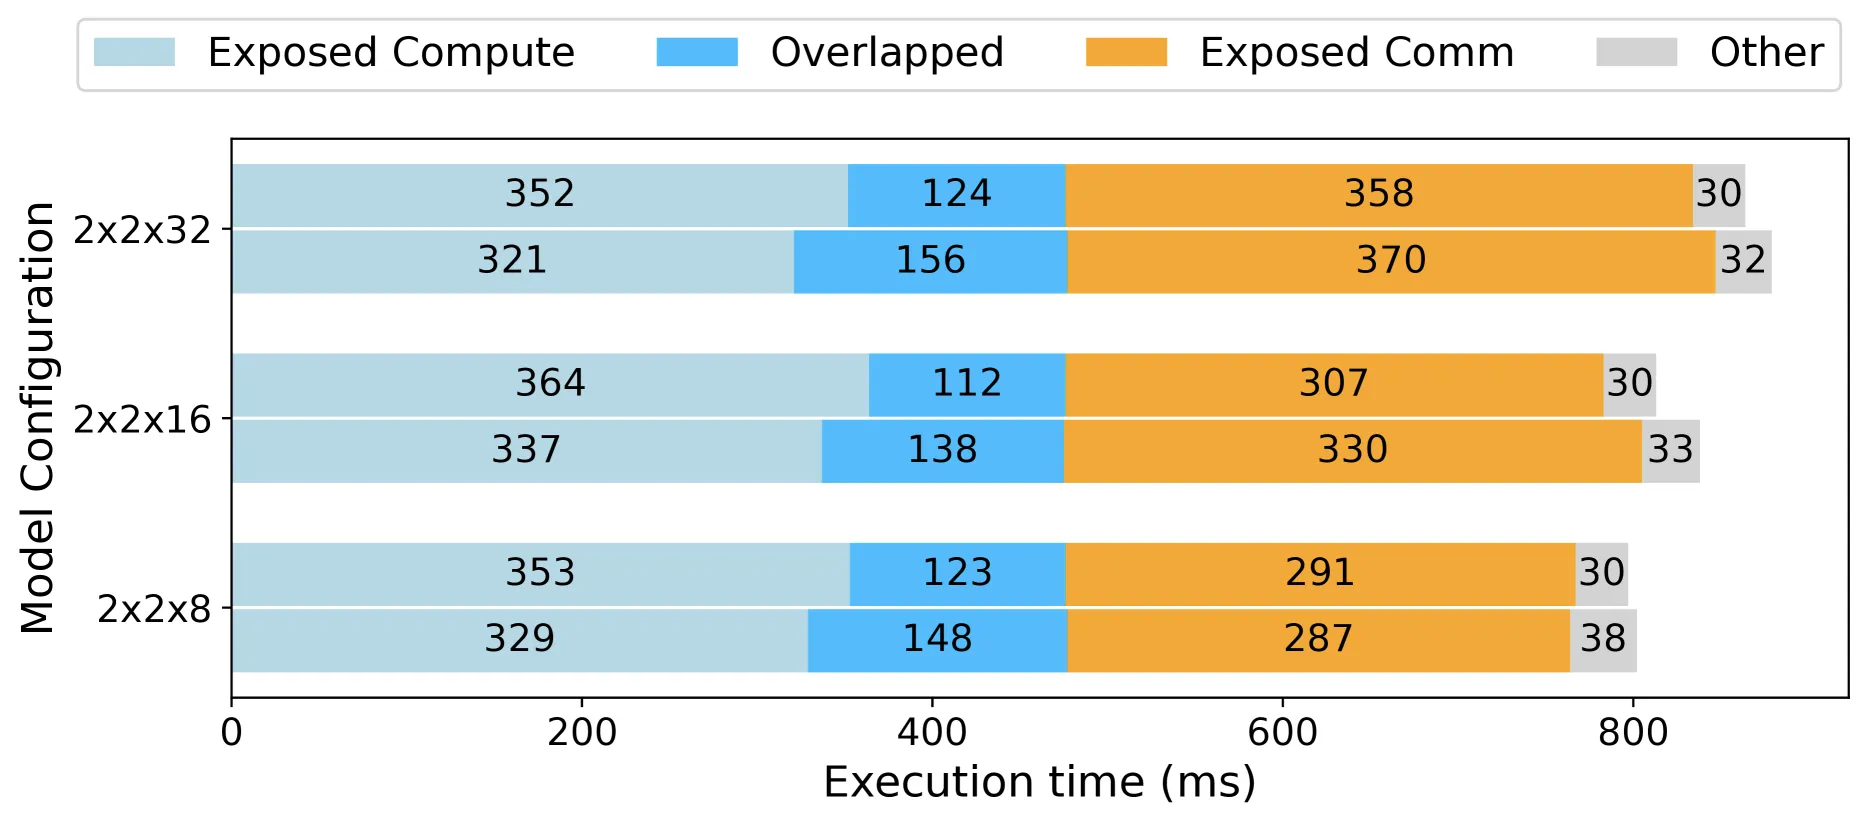 Figure 5: 不同模型大小和并行策略下的每次迭代训练时间分解:实际执行、dPRO和Lumos的对比
| 指标 | Lumos | dPRO |
|---|---|---|
| 平均重放误差 | 3.3% | 14% |
| 最大误差 | <5% | 21.8% |
| 执行分解准确性 | 高 | 低(高估重叠执行,低估总迭代时间) |
关键发现:
- Lumos在所有配置下保持低于5%的重放误差
- dPRO在模型大小和复杂度增加时准确性显著下降
- Lumos准确反映了计算与通信之间的动态交互
2. SM利用率
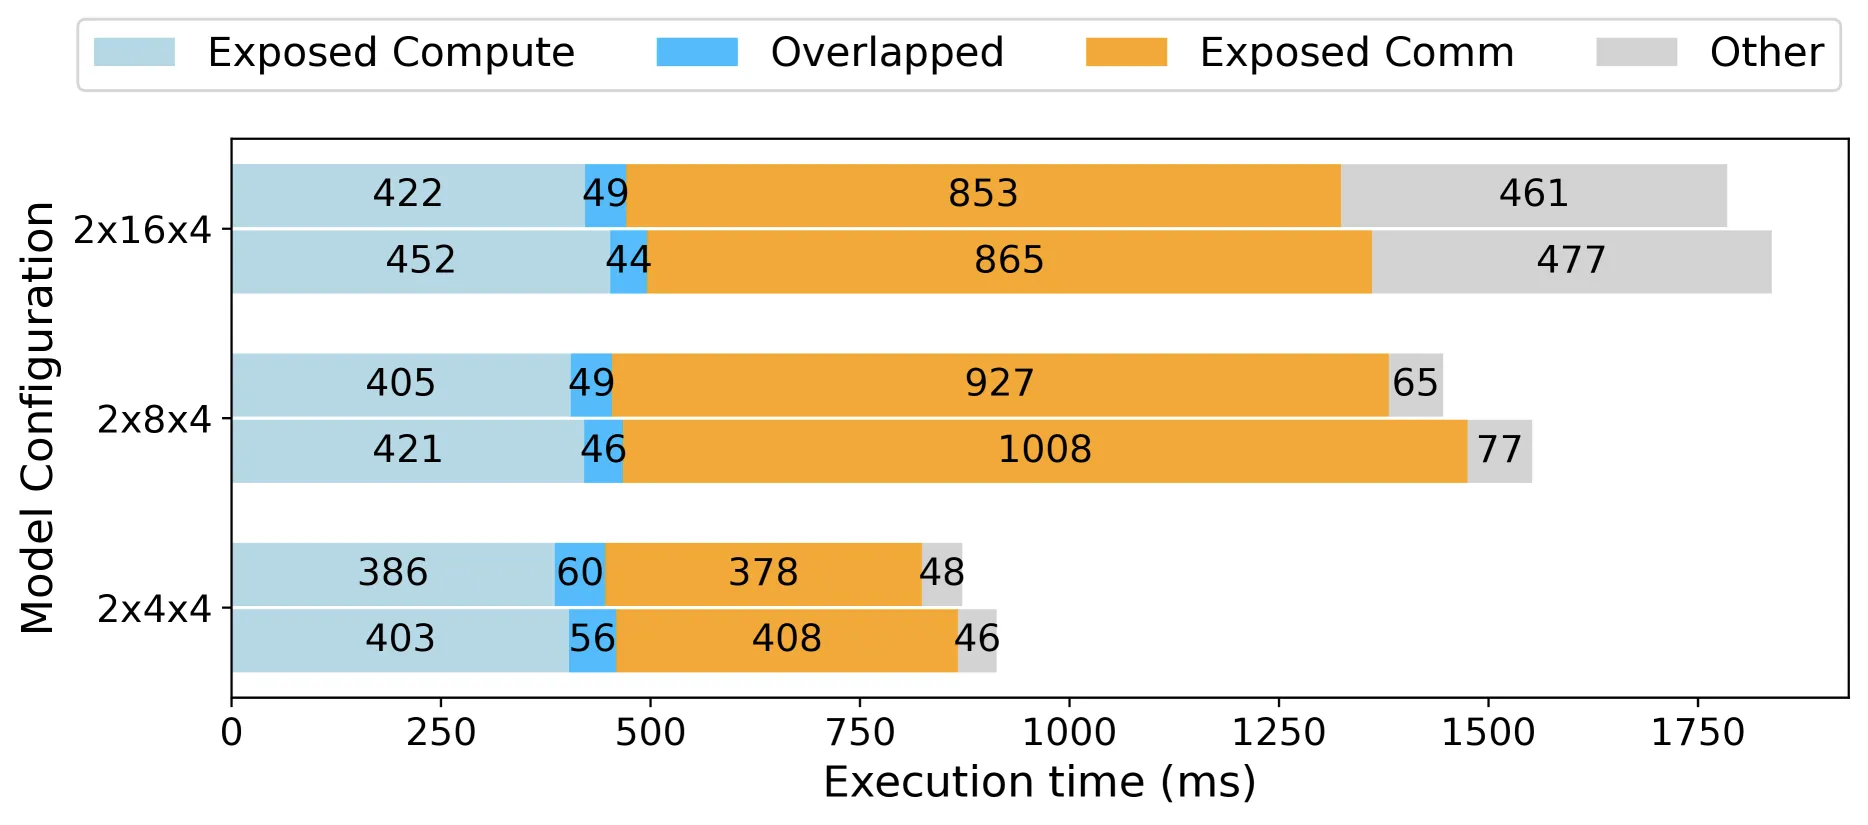 Figure 6: GPT-3 15B在TP=2, PP=2, DP=4配置下的单次迭代SM利用率
Lumos重放的SM利用率与实际测量值高度吻合,而dPRO表现出更多波动和显著差异。
3. 并行策略扩展
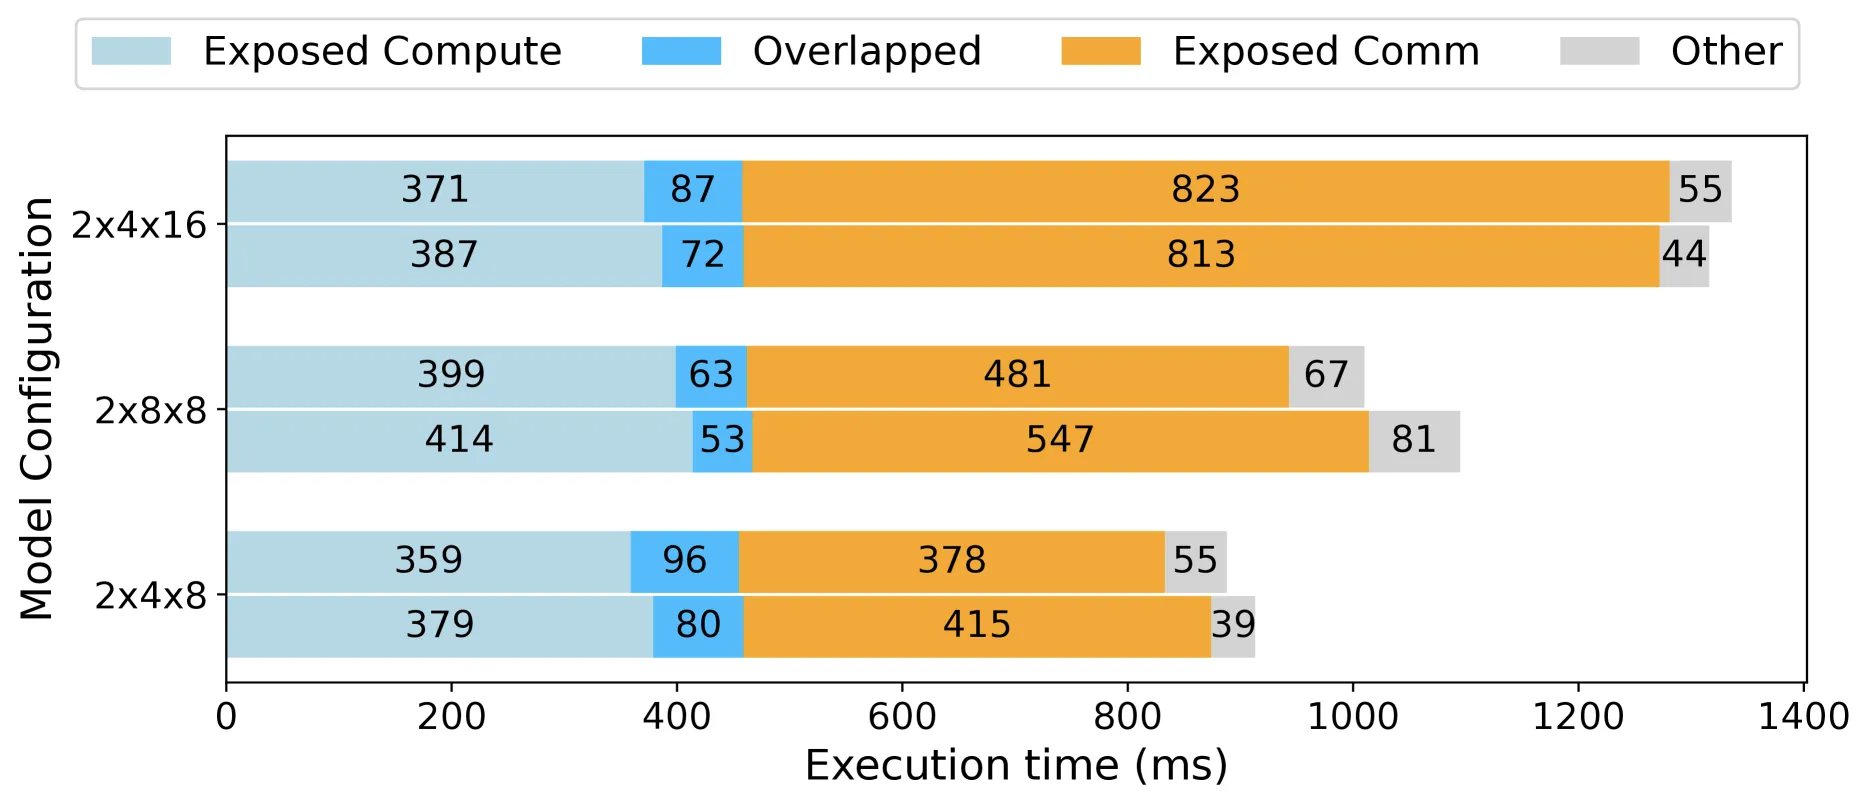 Figure 7: 扩展配置的运行时预测。每个配置(TPxPPxDP)由两个水平条表示:上条为Lumos预测值,下条为实际值
| 扩展场景 | Lumos平均误差 |
|---|---|
| 数据并行扩展(16->128 GPUs) | 准确 |
| 流水线并行扩展 | 准确 |
| DP+PP同时扩展 | 4.2% |
4. 模型架构变化
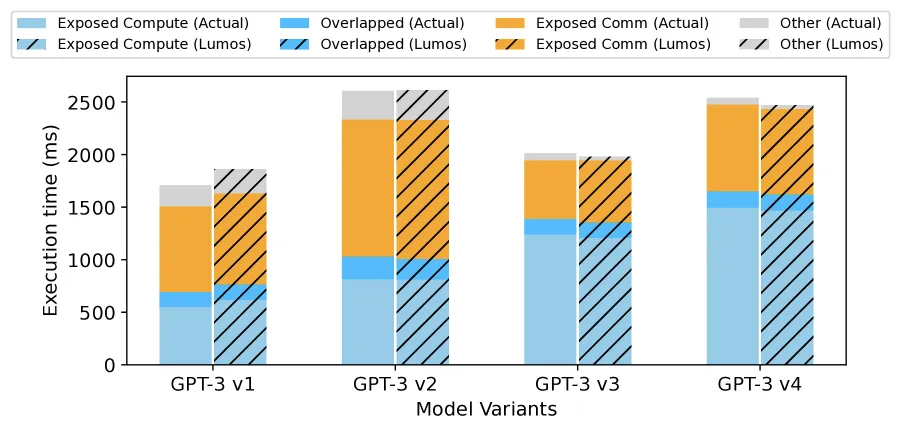 Figure 8: 模型变体的迭代时间分解。左条为实际值,右条(斜线填充)为预测值
| 模型变体 | 参数量 | 层数 | 隐藏维度 | FFN维度 |
|---|---|---|---|---|
| GPT-3 15B (基础) | 15B | 48 | 6144 | 12288 |
| GPT-3 v1 | 20B | 64 | 6144 | 12288 |
| GPT-3 v2 | 30B | 96 | 6144 | 12288 |
| GPT-3 v3 | 28B | 48 | 9216 | 18432 |
| GPT-3 v4 | 44B | 48 | 12288 | 24576 |
Lumos能够准确预测不同模型架构变化下的性能,预测值与实际测量值高度一致。
六、相关工作 (Related Work)
1. Profiling工具和Trace
| 工具/方法 | 类型 | 描述 |
|---|---|---|
| NVProf | 硬件级 | NVIDIA GPU性能分析工具 |
| CUPTI | 硬件级 | CUDA性能跟踪接口 |
| Nsight | 硬件级 | NVIDIA综合开发和分析工具 |
| PyTorch Kineto | 框架级 | 利用CUPTI捕获PyTorch算子、CUDA事件和GPU内核的运行时信息 |
2. LLM和并行策略
| 并行策略 | 描述 | 代表工作 |
|---|---|---|
| 数据并行(DP) | 分布训练批次到多个设备,同步梯度更新 | - |
| 张量并行(TP) | 在多个GPU上分割大张量,共享计算并频繁通信 | GSPMD |
| 流水线并行(PP) | 将模型分成顺序阶段,在不同设备上协调处理 | Megatron-LM |
| 3D并行 | 混合使用DP、TP和PP | Alpa, Galvatron |
| 序列并行 | 沿序列维度分布计算,减少内存开销和通信瓶颈 | DeepSpeed Ulysses |
3. 性能建模、模拟和优化
| 方法类别 | 代表工作 | 特点 | 局限性 |
|---|---|---|---|
| 分析模型 | AmPeD, Calculon | 基于模型参数和并行策略的参数化分析 | 针对特定实现和硬件,泛化能力有限;仅提供高层性能估计 |
| Trace驱动 | ASTRA-sim, Daydream, dPRO | 利用运行时trace模拟执行 | 无法完全捕获LLM执行的复杂性 |
| Lumos | 本文 | 基于trace的精细执行图建模 | 首次准确建模LLM复杂行为 |
七、总结 (Conclusion)
主要贡献
-
精确的LLM性能建模:Lumos是首个能够有效捕获LLM执行行为的性能建模系统,平均重放误差仅为3.3%
-
灵活的配置探索:通过对现有执行图的修改和模拟,支持并行策略和模型架构的what-if分析,无需在真实硬件上部署
-
最小化profiling开销:仅使用框架内置工具,约10行代码即可完成trace收集
-
细粒度性能分析:不仅重放整体执行时间,还准确重现执行分解、SM利用率等详细统计
局限性
- 当前仅关注执行时间建模,不包括FLOPS利用率、内存消耗、带宽使用或能效等系统级指标
- 在预测新配置性能时,假设模型在新设置下能正常运行,不考虑潜在的OOM等问题
- 新GPU内核的运行时预测依赖于外部性能模型
未来方向
- 扩展到更多系统级指标(内存、带宽、能效)
- 与其他工具(如ASTRA-sim、HeterSim)的集成
- 支持更多模型架构和领域
- 应用于LLM推理场景(分布式推理、SSD-based推理)
八、参考资源 (References)
论文资源
| 资源类型 | 链接 |
|---|---|
| arXiv页面 | https://arxiv.org/abs/2504.09307 |
| PDF下载 | https://arxiv.org/pdf/2504.09307 |
| HTML版本 | https://arxiv.org/html/2504.09307v1 |
| DOI | https://doi.org/10.48550/arXiv.2504.09307 |
论文图片
| 图片 | 描述 | 文件 |
|---|---|---|
| Figure 1 | GPT-3 175B单次训练迭代的执行时间分解,对比实际执行、dPRO和Lumos | x1.png |
| Figure 2 | Lumos工作流程概览 | x2.png |
| Figure 3 | 任务间的四种依赖关系 | x3.png |
| Figure 4 | 2x PP配置下rank_0的更新流水线调度 | x4.png |
| Figure 5 (Algorithm 1) | Lumos模拟算法 | x5.png |
| Table 1 (Figure 6) | 评估中使用的模型大小和架构 | x6.png |
| Figure 5 (Figure 7) | 不同配置下的每次迭代训练时间分解对比 | x7.png |
| Figure 6 (Figure 8) | GPT-3 15B的SM利用率对比 | x8.png |
| Figure 7(a) (Figure 9) | 数据并行扩展的执行分解 | x9.png |
| Figure 7(b,c) (Figure 10) | 流水线并行及DP+PP同时扩展的执行分解 | x10.png |


主要引用论文
| 论文 | 作者 | 年份 | 主题 |
|---|---|---|---|
| dPRO | Hu et al. | 2022 | 基于trace的DNN训练性能诊断和优化 |
| Daydream | Zhu et al. | 2020 | 基于CUPTI内核级依赖图的运行时预测 |
| ASTRA-sim | Rashidi et al. | 2020 | 分布式训练模拟器 |
| Calculon | Isaev et al. | 2023 | LLM系统和软件协同设计 |
| AmPeD | Moolchandani et al. | 2023 | 分布式Transformer训练性能分析 |
| Alpa | Zheng et al. | 2022 | 自动模型并行化 |
| Galvatron | Miao et al. | 2022 | 并行策略优化 |
| Megatron-LM | Narayanan et al. | 2021 | 大规模语言模型训练 |
| PyTorch Kineto | - | - | PyTorch性能分析工具 |
实验环境
| 组件 | 配置 |
|---|---|
| GPU | NVIDIA H100 (最多512个) |
| 服务器 | 32台 |
| 网络 | 8x 400Gbps per host, RoCE DC-scale |
| CUDA | 12.4 |
| PyTorch | 2.5 |
| Transformer Engine | 0.12.0 |
| PyTorch Lightning | 1.9.4 |
分析文档生成时间: 2025-05-30 数据来源: arXiv:2504.09307