Accelerating LLM Inference Throughput via Asynchronous KV Cache Prefetching
通过异步KV缓存预取技术加速LLM推理吞吐量,减少内存访问延迟。
Accelerating LLM Inference Throughput via Asynchronous KV Cache Prefetching
一、论文概述
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | Accelerating LLM Inference Throughput via Asynchronous KV Cache Prefetching |
| arXiv ID | 2504.06319 |
| 发表日期 | 2025年4月8日 (v1), 2025年11月8日 (v2) |
| 作者 | Yanhao Dong, Yubo Miao, Weinan Li, Xiao Zheng, Chao Wang, Jiesheng Wu, Feng Lyu |
| 会议/期刊 | AAAI (8页, 5图) |
| 代码仓库 | 未公开 |
1.2 研究背景
大语言模型(LLM)在推理阶段表现出显著的内存受限(memory-bound)特性,主要瓶颈来自高带宽内存(HBM)的带宽限制。在自回归解码过程中,每一步都需要从HBM加载Key-Value Cache(KV Cache)到计算单元寄存器,频繁的片外内存访问导致巨大的数据搬运延迟。
核心问题:
- vLLM的XFormers注意力内核存在严重的GPU缓存未命中:L1命中率仅0.75%,L2命中率仅0.06%
- 平均每条指令27.68个周期(CPI),其中77%消耗在Stall Long Scoreboard事件上
- 计算吞吐量利用率仅23.35%,内存吞吐量利用率47.10%
1.3 核心贡献
本文提出了一种面向L2缓存的异步KV Cache预取方法,通过计算-加载重叠突破LLM推理的内存带宽瓶颈:
- 系统性硬件性能剖析:揭示vLLM推理引擎中的关键瓶颈特征和KV Cache访问的异常缓存命中模式
- 软硬件协同设计的异步预取方法:通过计算-传输重叠机制有效隐藏HBM访问延迟
- 显著性能提升:在NVIDIA H20 GPU上实现注意力内核2.15x加速,端到端推理吞吐量1.97x提升
二、核心思想
2.1 问题根源分析
通过系统性硬件性能剖析,论文识别出XFormers内核的三个关键性能瓶颈:
| 瓶颈 | 描述 | 量化指标 |
|---|---|---|
| GPU利用率低下 | 计算和内存带宽利用严重不足 | 计算23.35%, 内存47.10% |
| 缓存命中率极差 | 缓存机制几乎完全失效 | L1: 0.75%, L2: 0.06% |
| 持续Warp停顿 | Stall Long Scoreboard成为绝对性能瓶颈 | CPI 27.68, 其中21.34周期停顿 |
2.2 Stall Long Scoreboard机制
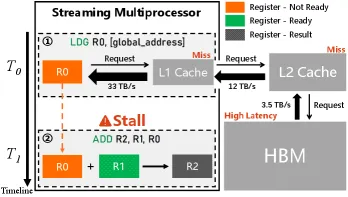
图1:NVIDIA GPU中Stall Long Scoreboard事件示意图
当Warp执行加载指令(LDG)将数据从HBM传输到寄存器时遇到缓存未命中,后续算术指令(如ADD)因寄存器数据依赖而无法执行,迫使Warp进入停顿状态直到HBM数据到达。XFormers内核接近零的缓存命中率意味着几乎所有内存请求都需要访问HBM,导致灾难性的GPU计算周期浪费。
2.3 核心洞察
关键发现:在KV Block加载阶段存在大量未被利用的内存带宽。通过战略性地利用这些闲置带宽资源,可以将HBM高延迟访问引起的停顿周期重映射为有效的计算周期,从而突破内存受限瓶颈。
优化思路:在计算单元执行当前迭代计算的同时,利用闲置带宽将下一迭代所需的KV Cache异步预取到L2缓存,实现计算-加载重叠。
三、技术架构
3.1 方法总览
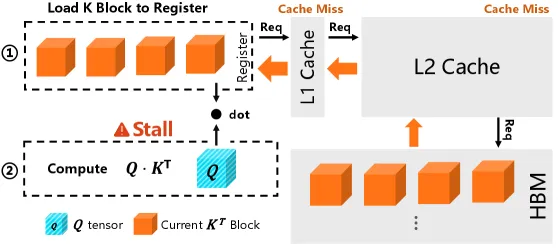
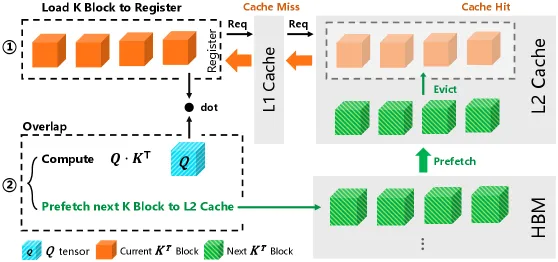
图2-3:原生XFormers与本文方法的Q*K^T计算流程对比(4 Warp线程块配置)
3.2 原生XFormers执行流程
原生XFormers采用逐块迭代加载机制,执行流程分为两个关键阶段:
- 每个Warp从全局内存加载当前K Block到寄存器
- 使用寄存器中预驻留的Q张量与当前K Block执行Q*K^T运算
当K Block缓存未命中时,触发高延迟HBM访问,导致Stall Long Scoreboard事件。
3.3 预取优化执行流程
本文方法的核心创新在于:
- 在Warp执行当前迭代Q*K^T运算的计算周期内,利用GPU异步预取能力将下一迭代所需的K Block从HBM预加载到L2缓存
- 当前迭代的K Block已加载到寄存器,其对应的L2缓存行可安全驱逐
- 确保后续迭代的K Block请求命中L2缓存,显著减少Warp停顿
3.4 算法实现
算法1:预取K Block到L2缓存
输入:块表 bt, Warp数 w, 块索引范围 [s, e)

1: block_idx = s
2: while block_idx < e do
3:   查找 bt[block_idx] -> k_ptr          // 当前块
4:   从k_ptr加载K Block到寄存器
5:   if block_idx + w < e then
6:     查找 bt[block_idx + w] -> next_k_ptr  // 下一块
7:     从next_k_ptr预取K Block到L2缓存
8:   end if
9:   计算当前K Block的 Q*K^T
10:  block_idx = block_idx + w
11: end while
3.5 GPU预取接口
NVIDIA CUDA通过PTX指令 cp.async.bulk.prefetch.L2 提供面向L2缓存的异步预取机制。该非阻塞指令从指定内存位置异步预取数据到L2缓存,需要Compute Capability 9.0或更高版本(Hopper架构GPU,如H100/H20)。
四、核心创新
4.1 异步KV Block预取
K Block预取:在Warp执行当前迭代Q*K^T计算时,异步预取下一迭代的K Block到L2缓存。由于预取与计算并行执行,HBM访问延迟被有效隐藏在计算周期内。
V Block预取:同样适用于V Block。在Warp执行当前迭代V Block加载时,异步预取下一迭代的V Block,实现logits*V计算与预取的并行执行。
4.2 预取收益与L2缓存容量分析
单个Block的内存占用公式:
M_block = b * d_h * T_block其中b为每模型参数的字节数,d_h为单注意力头维度,T_block为每Block包含的token数。
单次迭代处理的Block总内存占用:
M_total = M_block * (N_thread / 32) * H * B| 超参数 | 值 | 说明 |
|---|---|---|
| b | 2 | FP16精度 |
| d_h | 128 | 注意力头维度 |
| T_block | 16 | 每Block的token数 |
| N_thread | 128 | 线程数 |
| H | 32 | 注意力头数(Llama2-7B MHA) |
L2缓存容量约束:
- H100 GPU的60MB L2缓存理论上支持最多120个batch的K/V Block驻留
- 超过容量上限时,部分驻留的Block仍可通过缓存命中获得边际性能收益
- 通过调整缓存驱逐优先级可有效缓解容量溢出导致的缓存抖动
4.3 与现有优化的正交性
本文方法与以下优化技术正交,可集成使用:
| 优化技术 | 类型 | 与本文方法的关系 |
|---|---|---|
| FlashAttention-1/2/3 | 计算内核优化 | 正交,可叠加 |
| DeepSpeed-inference | 算子融合 | 正交,可叠加 |
| MQA/GQA/MLA | KV Cache结构优化 | 正交,但收益受GQA比例影响 |
| PagedAttention | 内存管理 | 正交,可叠加 |
五、实验结果
5.1 实验设置
| 配置项 | 详情 |
|---|---|
| CPU | 4x Intel Xeon Platinum 8469C (192核) |
| GPU | 8x NVIDIA H20 (96GB HBM, 60MB L2, 4.0TB/s带宽) |
| 架构 | Hopper (Compute Capability 9.0) |
| 精度 | FP16 |
| 基线 | vLLM v0.7.1 XFormers后端, FlashAttention-3 |
测试模型:
| 模型 | 注意力机制 | Q头:KV头比 |
|---|---|---|
| Llama2-7B | MHA | 32:32 (1:1) |
| Llama3-8B | GQA | 32:8 (4:1) |
| Qwen2.5-7B | GQA | 28:4 (7:1) |
| Qwen2.5-14B | GQA | 40:8 (5:1) |
5.2 注意力内核性能
| 指标 | Llama2-7B | Llama3-8B | Qwen2.5-7B | Qwen2.5-14B |
|---|---|---|---|---|
| 内核加速 | 1.84x | 1.89x | 2.15x | 1.89x |
| L2命中率提升 | 0.06% -> 43.70% | 38.35% -> 73.01% | 55.90% -> 82.66% | 51.43% -> 77.11% |
| Stall周期降低 | 21.34 -> 4.13 | 16.66 -> 2.05 | 16.38 -> 1.87 | 16.17 -> 1.96 |
| CPI降低 | 27.68 -> 9.28 | 21.42 -> 7.32 | 22.68 -> 7.36 | 20.94 -> 7.24 |
| 计算吞吐提升 | 23.35% -> 48.22% | 29.61% -> 61.15% | 25.29% -> 60.95% | 30.52% -> 63.49% |
| 内存吞吐提升 | 47.10% -> 86.88% | 23.44% -> 66.96% | 20.05% -> 63.50% | 24.16% -> 68.44% |
5.3 单GPU端到端推理吞吐量
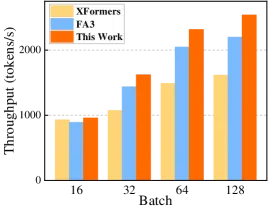
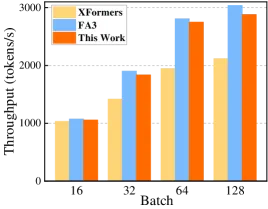
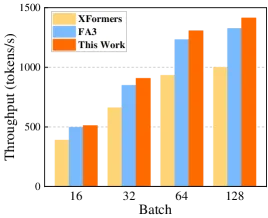
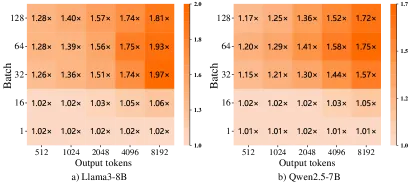
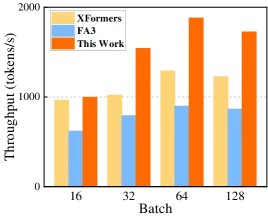
图3:单GPU端到端推理吞吐量对比(输出token固定为2048,H20 GPU)
| 模型 | vs XFormers最大提升 | vs FA3最大提升 |
|---|---|---|
| Llama2-7B | 51% | 110% |
| Llama3-8B | 57% | 15% |
| Qwen2.5-7B | 41% | -2%~-5% (回归) |
| Qwen2.5-14B | 41% | 7% |
注意:Qwen2.5-7B在vs FA3时出现2-5%性能回归,原因是其激进的GQA配置(7:1)严重限制了预取优化潜力。
5.4 Batch Size与序列长度影响
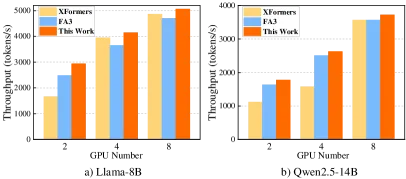
图4:不同batch size和输出序列长度下相对XFormers的加速比
关键发现:
- 固定batch size时,增加输出序列长度 -> 加速比单调递增
- 固定序列长度时,增加batch size -> 加速比持续提升
- 峰值加速偏离(8K, bs=128)组合,原因:(1) batch超过L2缓存性能加速边界; (2) KV Cache总量超出GPU物理内存,触发重计算
5.5 多GPU吞吐量
在2/4/8 GPU张量并行配置下,使用Llama3-8B和Qwen2.5-14B评估:
| 模型 | vs XFormers提升范围 |
|---|---|
| Llama3-8B | 4%-59% |
| Qwen2.5-14B | 4%-76% |
关键观察:
- 性能增益随TP规模增大而递减(注意力头被分割,可优化I/O空间减小)
- FA3在Llama3-8B的4/8 GPU配置下出现3-7%吞吐量回归,而本文方法通过KV Block预取保持加速
六、相关工作
6.1 注意力内核与KV Cache优化
| 方法 | 技术 | 局限性 |
|---|---|---|
| FlashAttention-1/2 | 分块和内核融合减少HBM访问 | 未实现计算-加载重叠 |
| FlashAttention-3 | 利用Hopper架构硬件特性 | 仍有优化空间 |
| DeepSpeed-inference | 深度融合技术,定制GeMM内核 | 面向小batch场景 |
| MQA/GQA/MLA | 共享KV Cache减少内存占用 | 结构级优化,非内核级 |
6.2 预取技术
| 方法 | 场景 | 局限性 |
|---|---|---|
| ZeRO-Infinity | CPU/NVMe到GPU异步预取 | 不适用于纯GPU推理 |
| DeepUM | GPU-CPU内存页迁移预取 | 不适用于纯GPU推理 |
| PRESERVE | 多GPU allReduce期间预取权重和KV Cache | 仅适用于多GPU场景,batch增大时效果衰减 |
| 本文方法 | CUDA内核级L2缓存异步预取 | 所有场景持续加速 |
6.3 本文方法的定位
本文方法在CUDA内核层面实现注意力分数计算加速,与上述所有优化技术正交,可形成协同优化组合。
七、总结
7.1 主要贡献
本文提出了一种基于L2缓存的异步KV Cache预取方法,通过计算-加载重叠有效缓解大模型推理的内存带宽瓶颈。
三个关键贡献:
-
系统性硬件性能剖析
- 揭示vLLM推理引擎的关键瓶颈特征
- 发现KV Cache访问的异常缓存命中模式(L2命中率仅0.06%)
-
软硬件协同设计的预取方法
- 利用NVIDIA Hopper架构的L2缓存异步预取能力(PTX指令)
- 在计算周期内预取下一迭代的KV Block到L2缓存
- 实现HBM访问延迟隐藏在计算周期内
-
显著性能提升
- 注意力内核加速:最高2.15x
- 端到端推理吞吐量:最高1.97x
- 超越SOTA基线FlashAttention-3
7.2 性能总结
| 指标 | 数值 |
|---|---|
| 注意力内核最大加速 | 2.15x (Qwen2.5-7B) |
| 端到端最大吞吐量提升 | 1.97x |
| L2缓存命中率提升 | 最高82.66% |
| Stall周期降低 | 最高89% (21.34 -> 1.87) |
| CPI降低 | 最高67.5% |
7.3 局限性与适用条件
| 条件 | 说明 |
|---|---|
| 硬件要求 | 需要NVIDIA Hopper架构GPU (Compute Capability 9.0+) |
| GQA影响 | KV头数越少,预取收益越低;7:1 GQA配置下可能回归 |
| L2缓存容量 | batch过大时超出L2缓存容量上限,收益递减 |
| 多GPU扩展 | TP规模增大时收益递减 |
7.4 未来方向
- 将预取方法扩展到更多GPU架构
- 优化GQA架构下的预取策略
- 与更多推理框架集成(当前基于vLLM)
- 探索与投机解码等技术的协同优化
八、参考资源
8.1 论文链接
- arXiv: https://arxiv.org/abs/2504.06319
- PDF: https://arxiv.org/pdf/2504.06319
- HTML: https://arxiv.org/html/2504.06319v2
8.2 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| KV Cache | Key-Value Cache | 存储历史token的Key和Value向量 |
| HBM | High Bandwidth Memory | 高带宽内存,GPU片外存储 |
| L2缓存 | L2 Cache | GPU二级片上缓存 |
| Warp | Warp | NVIDIA GPU的基本调度单位(32线程) |
| Stall Long Scoreboard | - | 因HBM访问延迟导致的Warp停顿事件 |
| MHA | Multi-Head Attention | 标准多头注意力机制 |
| GQA | Grouped-Query Attention | 分组查询注意力,多个Q头共享KV头 |
| MQA | Multi-Query Attention | 多查询注意力,所有Q头共享单个KV头 |
| MLA | Multi-Head Latent Attention | 多头潜在注意力(DeepSeek-V2) |
| PTX | Parallel Thread Execution | NVIDIA GPU的中间指令集 |
| PagedAttention | - | vLLM的分页KV Cache管理机制 |
| vLLM | - | 高性能LLM推理服务框架 |
| XFormers | - | Facebook的高效Transformer库 |
8.3 相关工具和框架
| 工具 | 用途 |
|---|---|
| vLLM | LLM推理服务框架(本文测试平台) |
| FlashAttention-3 | SOTA注意力内核(本文基线) |
| NVIDIA CUDA Toolkit | GPU编程工具链 |
| Hopper架构 | NVIDIA GPU架构(支持L2预取指令) |
8.4 关键图表索引
| 图表 | 描述 | 文件 |
|---|---|---|
| Figure 1 | Stall Long Scoreboard事件示意图 | figures/async-kv-prefetch/x1.png |
| Figure 2 | 原生XFormers计算流程 | figures/async-kv-prefetch/x2.png |
| Figure 3 | 本文方法计算流程 | figures/async-kv-prefetch/x3.png |
| Figure 3(a) | Llama2-7B单GPU吞吐量 | figures/async-kv-prefetch/x4.png |
| Figure 3(b) | Llama3-8B单GPU吞吐量 | figures/async-kv-prefetch/x5.png |
| Figure 3(c) | Qwen2.5-7B单GPU吞吐量 | figures/async-kv-prefetch/x6.png |
| Figure 3(d) | Qwen2.5-14B单GPU吞吐量 | figures/async-kv-prefetch/x7.png |
| Figure 4 | Batch size与序列长度加速比 | figures/async-kv-prefetch/x8.png |
| Figure 5 | 多GPU吞吐量对比 | figures/async-kv-prefetch/x9.png |