FlowKV: A Disaggregated Inference Framework with Low-Latency KV Cache Transfer and Load-Aware Scheduling
FlowKV 提出低成本低延迟的 KV Cache 传输方案和负载感知调度器,实现分离式 LLM 推理框架的 96% 传输延迟降低
FlowKV: A Disaggregated Inference Framework with Low-Latency KV Cache Transfer and Load-Aware Scheduling
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FlowKV: A Disaggregated Inference Framework with Low-Latency KV Cache Transfer and Load-Aware Scheduling |
| 作者 | Weiqing Li*, Guochao Jiang*, Xiangyong Ding, Zhangcheng Tao, Chuzhan Hao, Chenfeng Xu, Yuewei Zhang, Hao Wang† |
| 机构 | Alibaba Cloud Computing |
| 论文 | arXiv:2504.03775 |
| 发布 | 2025-04-03 |
| 领域 | cs.DC, cs.AI, cs.CL |
二、核心思想
问题定义
分离式推理(Disaggregated Inference)将 LLM 推理的 Prefill 和 Decode 阶段分离到不同节点上执行,以提升系统吞吐量。但该框架面临两个关键挑战:
- KV Cache 传输延迟高: Prefill 节点生成的 KV Cache 需要传输到 Decode 节点。现有方案使用 NCCL 逐层传输或合并离散张量,导致传输内核调用频繁,延迟显著(占总延迟约 1/4)
- P/D 节点负载不均衡: 固定比例的 P/D 节点分配在负载波动时导致计算资源失衡
解决方案概述
FlowKV 提出两个核心创新:
- 低延迟 KV Cache 传输: 通过 KV Cache 结构调整和段式内存分配器,将 NCCL 内核调用从 O(n) 优化到 O(1),传输延迟降低 96%(从 0.944s 到 0.053s)
- Load-Aware Scheduler: 负载感知调度器实时监控节点负载,支持正常负载、计算失衡、极端过载三种场景下的动态调度
三、技术架构
整体框架图
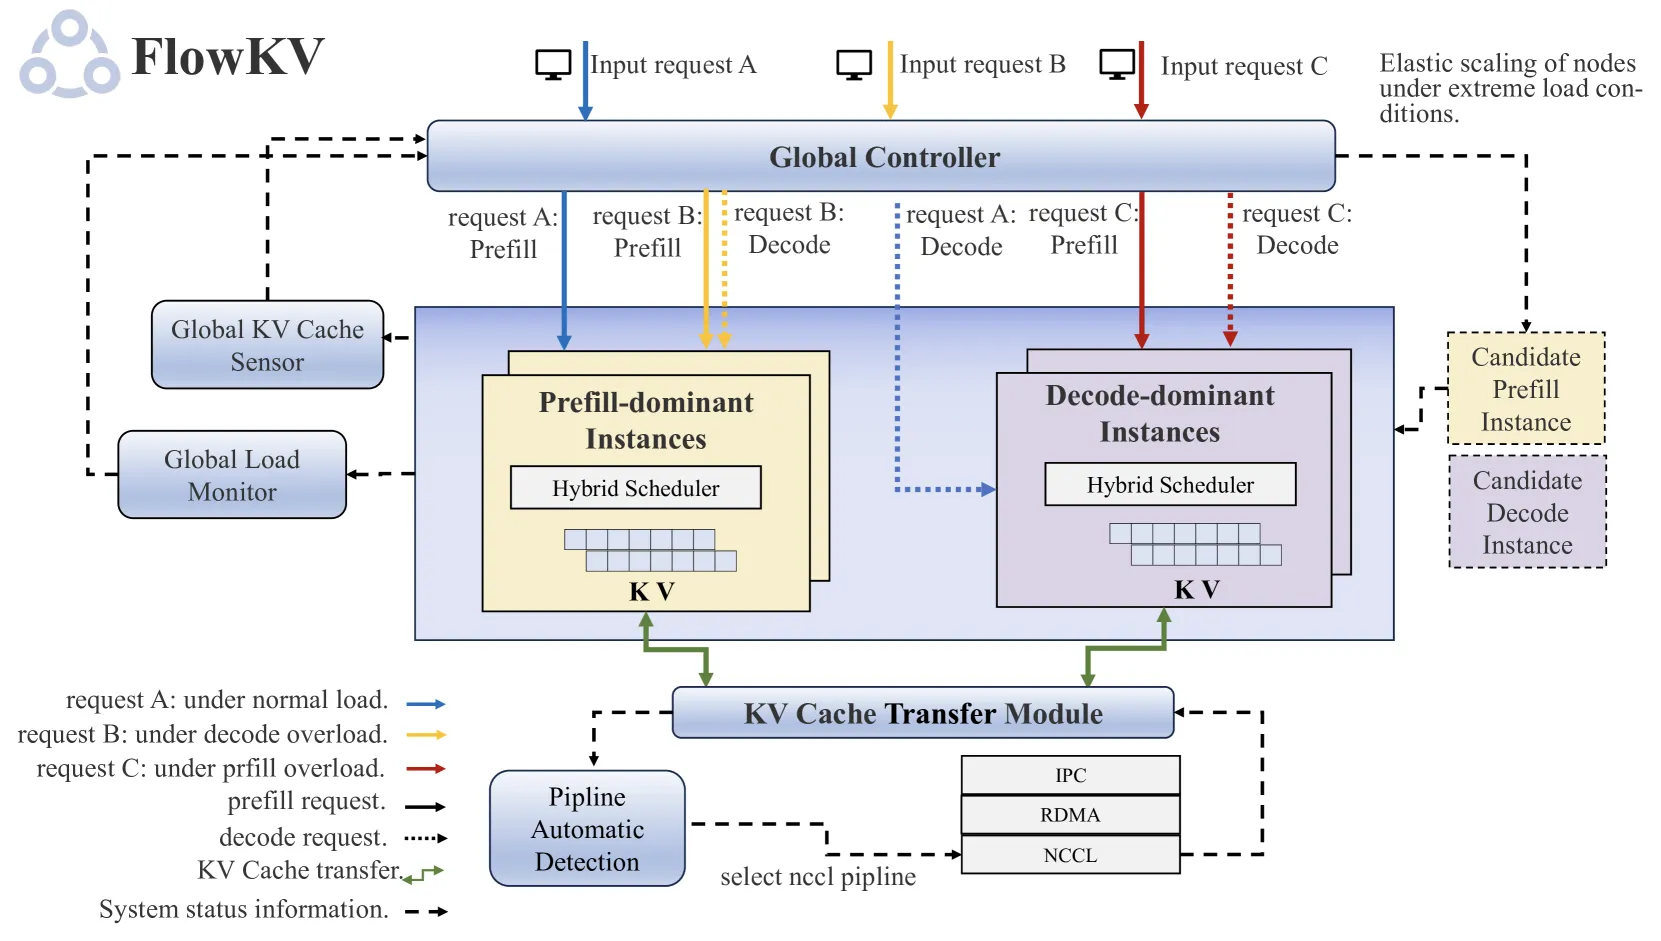
FlowKV 包含五个主要模块:
| 模块 | 职责 |
|---|---|
| Prefill 节点 | 执行 Prefill 计算,生成首个 token 和 KV Cache |
| Decode 节点 | 执行 Decode 计算,自回归生成后续 token |
| 全局控制器 | 监控所有节点负载和 KV Cache 状态,制定调度方案 |
| 混合调度器 | 每个 P/D 节点内的本地调度器,协调 Prefill 和 Decode 调度 |
| KV Cache 传输模块 | 根据硬件特性选择最优传输管道(NCCL/IPC/RDMA) |
核心公式
自回归生成过程:
Prefill 阶段:
Decode 阶段:
KV Cache 结构变换:
通过改变 KV Cache 在内存中的布局,将多层维度合并为连续张量:
其中 B 为 block 数量,L 为模型层数,H 为 KV Cache 向量维度。
优化效果: 每个 KV block 的 NCCL API 调用次数减少 L × 2 倍。
KV Cache 传输优化
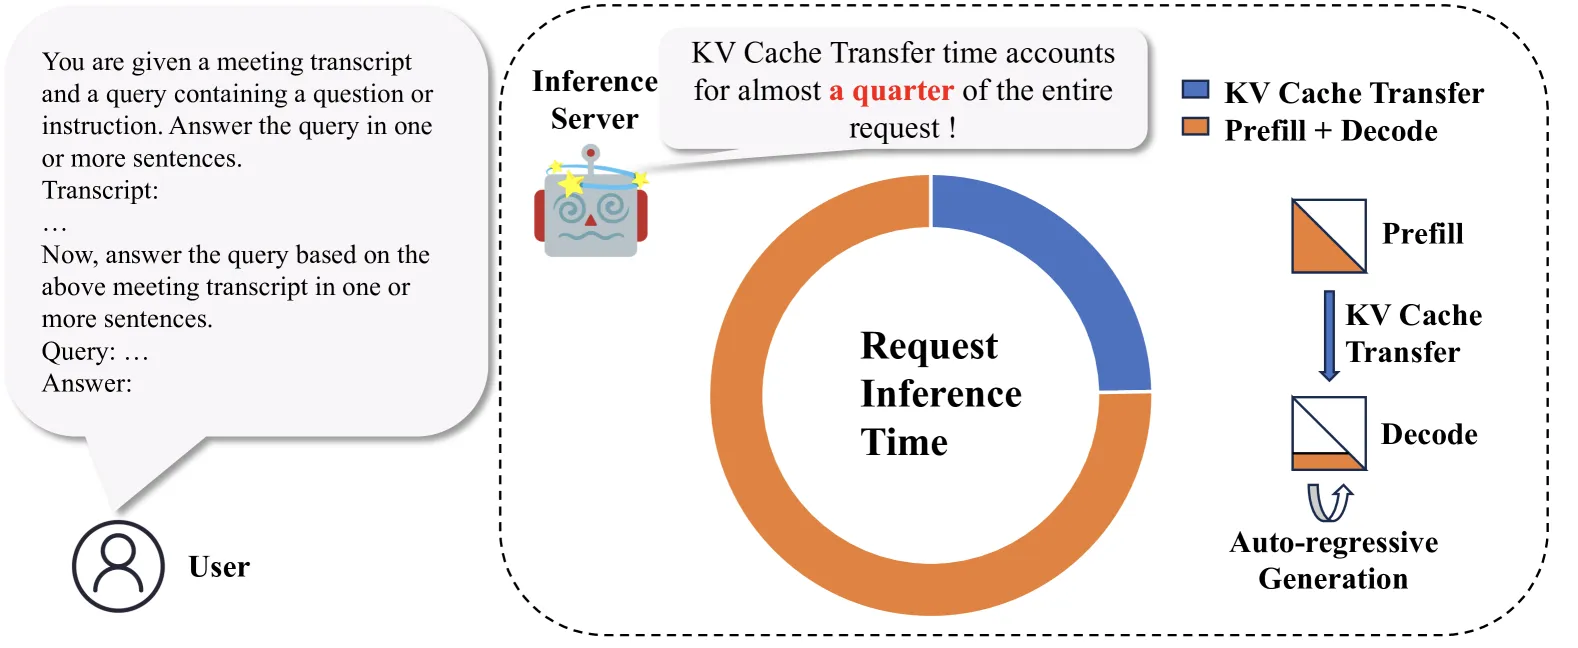
现有问题:
- PagedAttention 管理的 KV Cache 物理块不连续
- NCCL 仅支持连续内存地址传输
- 碎片化物理块导致大量小数据块传输
FlowKV 优化:
| 优化技术 | 说明 | 效果 |
|---|---|---|
| KV Cache 结构变换 | 将 (L,2,B,H) 布局改为 (B,L,2,H) | NCCL 调用减少 L×2 倍 |
| 段式内存分配器 | 使用操作系统段管理技术,分配连续内存段 | 减少传输内核调用次数 |
| 双向段对齐 | 传输前对齐发送端和接收端的 block ID 列表 | 合并可传输的 block,单次 NCCL 操作 |
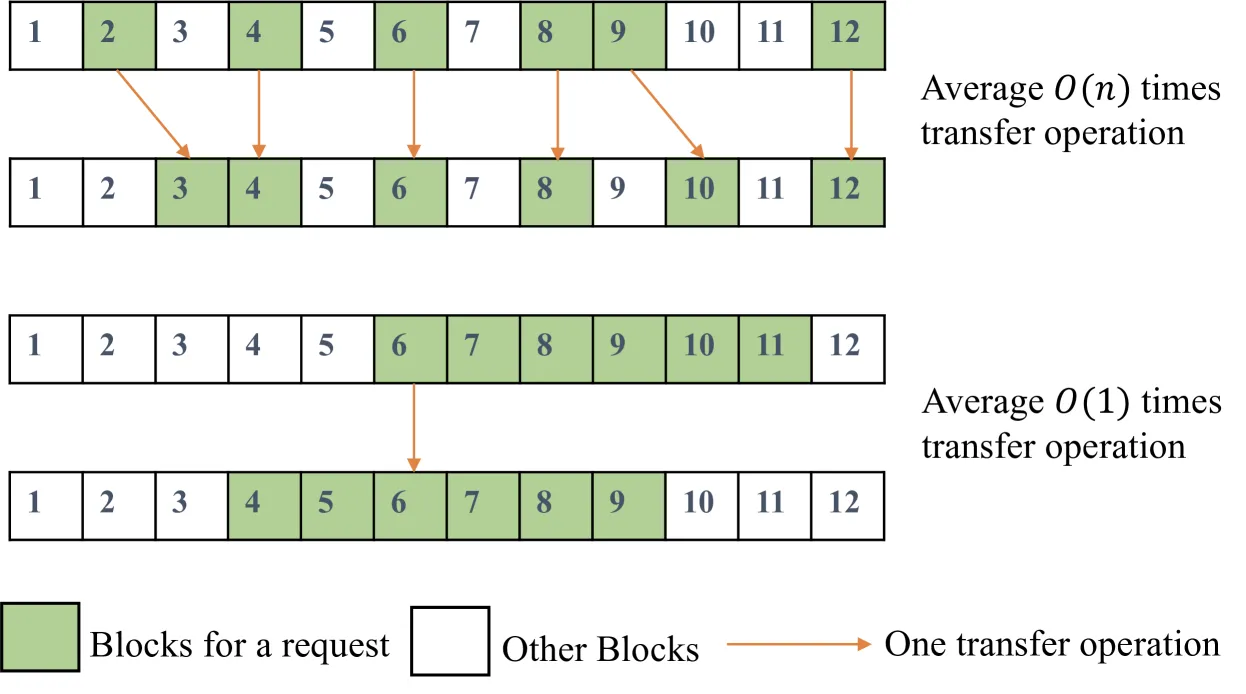
Load-Aware Scheduler
| 负载场景 | 调度策略 |
|---|---|
| 正常负载 | 全局控制器根据负载均衡分配请求 |
| 计算失衡 | P/D 节点执行混合计算,动态调整角色 |
| 极端过载 | 弹性节点扩展,增加资源处理请求 |
| 低负载 | 合并节点,减少资源浪费 |
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| KV Cache 结构变换 | 改变内存布局,合并多层维度为连续张量 | NCCL 调用从 23,469 次降至 1 次 |
| 段式内存分配器 | 分配连续内存段,减少碎片化 | 传输延迟降低 96% |
| 双向段对齐 | 传输前对齐 block ID,合并可传输 block | 单机加速 24×,多机加速 15× |
| Load-Aware Scheduler | 实时监控负载,三种场景动态调度 | 吞吐量提升 25% |
| 混合计算能力 | P/D 节点可在计算失衡时执行混合计算 | 异构部署 E2E 加速 15.2%-48.9% |
五、代码实现分析
FlowKV 基于开源推理框架构建,主要修改集中在以下方面:
KV Cache 传输管道:
- 支持 NCCL、IPC、RDMA 三种传输后端
- 单机默认使用 IPC,跨机使用 NCCL
- 自动检测硬件特性选择最优管道
内存管理:
- 段式最小堆管理空闲 block
- 分配时选择最优段,释放时合并相邻段
- 减少内存碎片,提升分配效率
六、实验结果
同构部署吞吐量对比
Llama-3.1-8B-Instruct (2 GPU, 1P1D):
| 方法 | 1K/256 吞吐 | 5K/256 吞吐 | 10K/256 吞吐 |
|---|---|---|---|
| DistServe | 254.04 | 115.63 | 21.94 |
| Mooncake | 206.38 | 356.28 | 171.07 |
| vLLM-Disagg | 208.00 | 331.12 | 171.11 |
| vLLM PD-colocated | 208.08 | 378.97 | 194.24 |
| FlowKV | 267.61 | 470.68 | 285.14 |
FlowKV 相比其他分离式框架提升 35%-95% 吞吐量。
Llama-3.1-70B-Instruct (8 GPU, 2 节点):
| 方法 | 1K/256 | 5K/256 | 10K/256 |
|---|---|---|---|
| DistServe | 222.84 | 9.69 | Failure |
| Mooncake | 221.42 | 182.81 | 97.75 |
| vLLM-Disagg | 216.44 | 178.95 | 96.79 |
| FlowKV | 248.03 | 233.93 | 123.43 |
异构部署 E2E 延迟对比
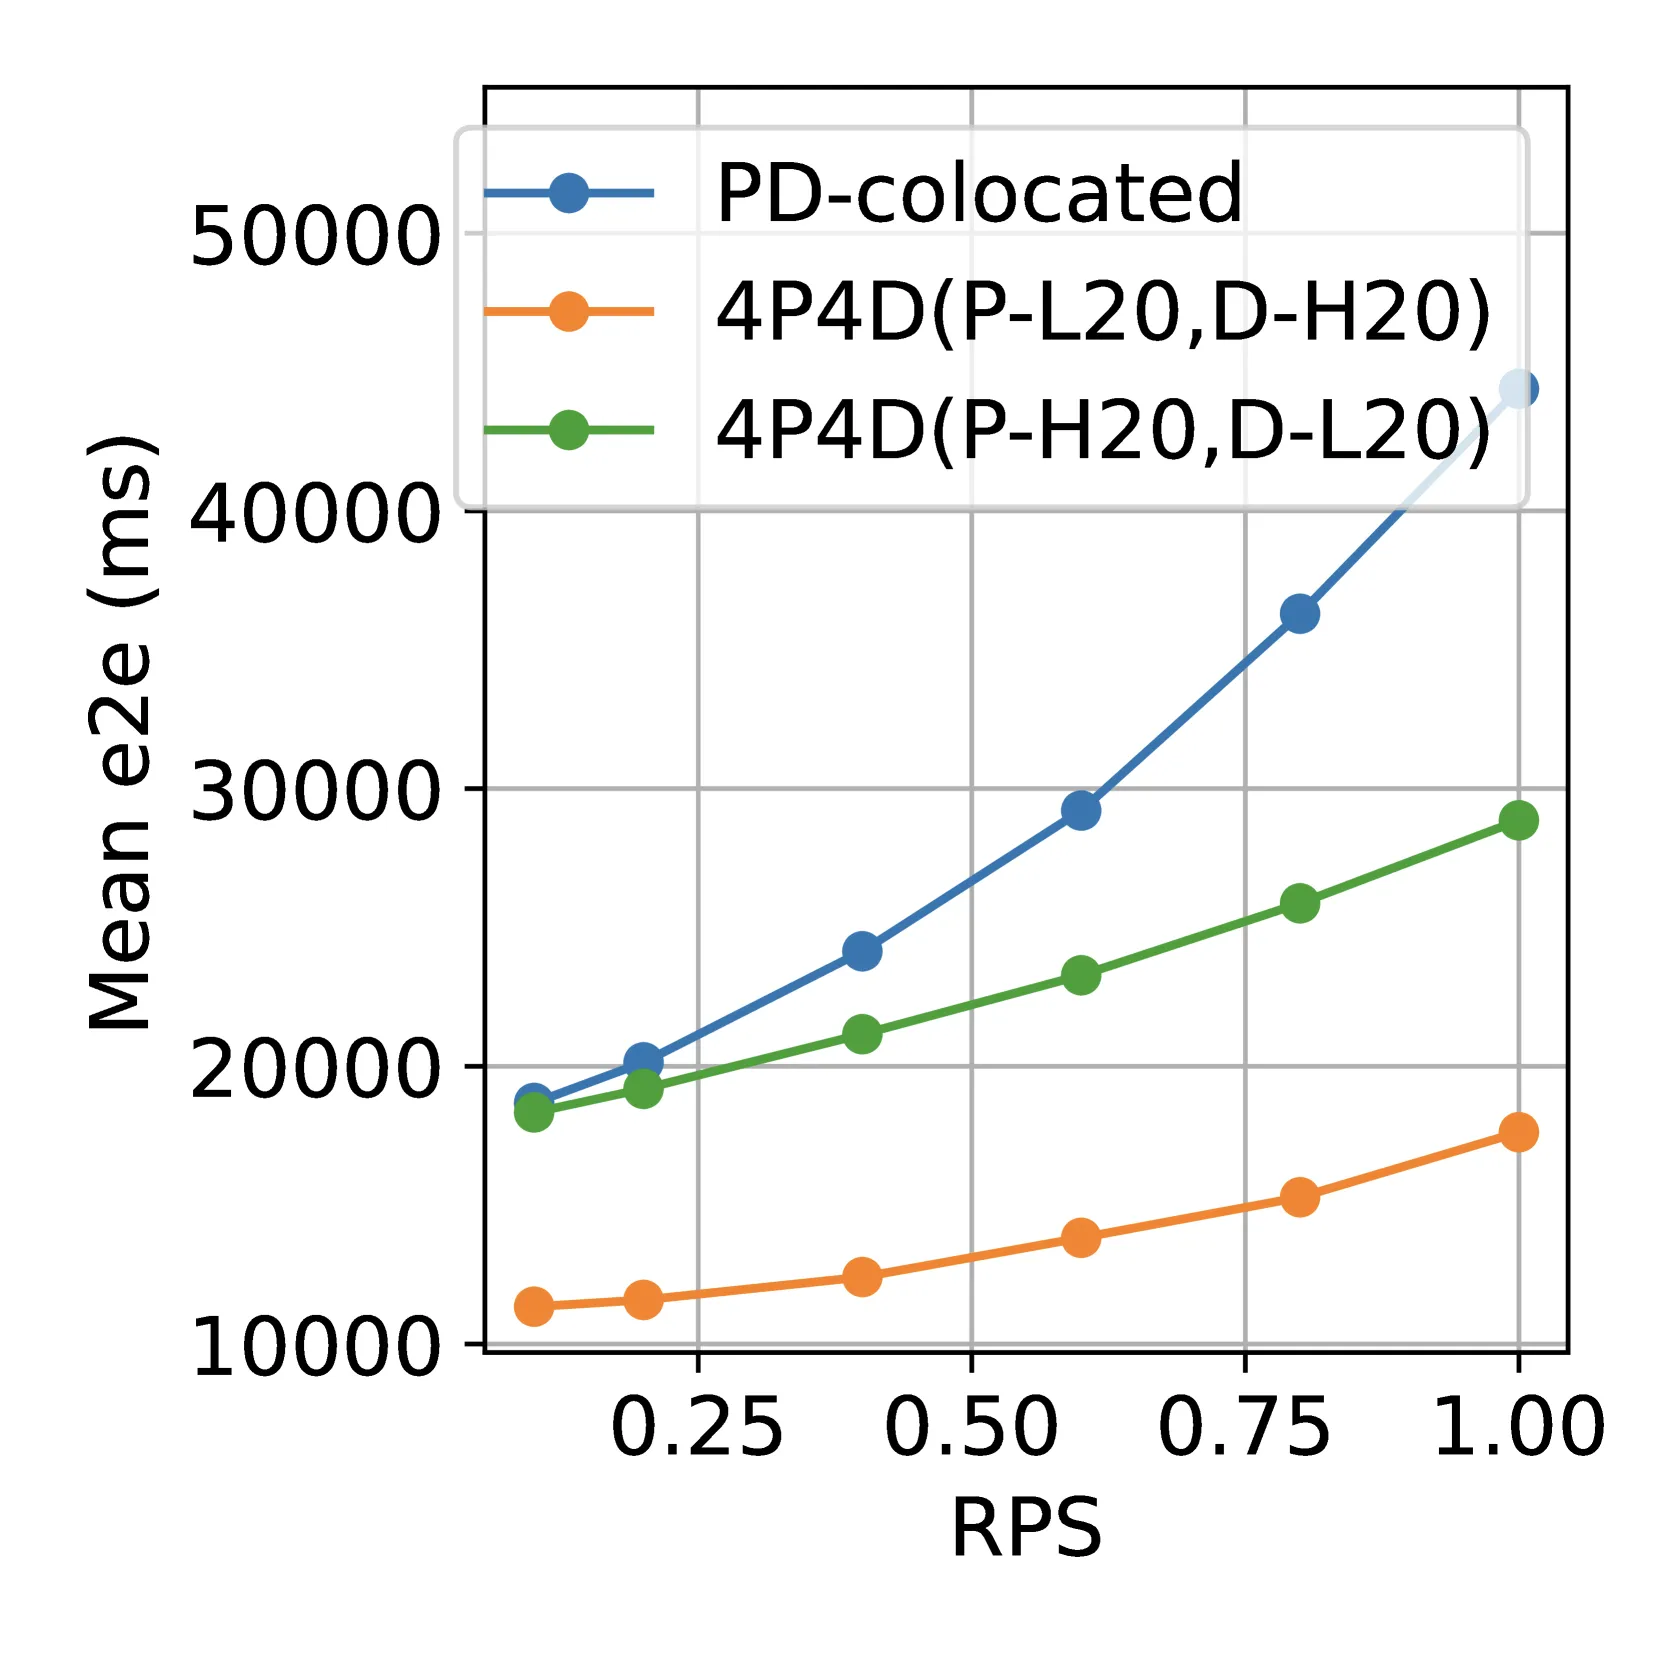
P-L20/D-H20 配置 vs vLLM PD-colocated:
| 数据集 | E2E 加速 | TPOT 改善 |
|---|---|---|
| gov_report | 48.9% | 44.57% |
| multi_news | 29.4% | 24.2% |
| qmsum | 15.2% | 15.0% |
KV Cache 传输延迟对比
| 部署方式 | 对比方法 | 延迟降低 | 加速倍数 |
|---|---|---|---|
| 单机 | vLLM-Disagg | 96.8% | 31.5× |
| 单机 | Mooncake | 98.2% | 55.2× |
| 多机 | vLLM-Disagg | 92.0% | 12.6× |
| 多机 | Mooncake | 96.3% | 55.3× |
| 单机 vs 层级传输 | - | - | 24× |
| 多机 vs 层级传输 | - | - | 15× |
消融实验
NCCL 管道优化:
- 基线:层级传输,每请求 23,469 次 NCCL 调用
- 优化后:单次 NCCL 调用完成传输
- 单机加速 24×,多机加速 15×
七、相关工作
| 工作 | 方法 | FlowKV 的改进 |
|---|---|---|
| vLLM | PagedAttention + 连续批处理 | FlowKV 支持分离式部署,减少 P/D 干扰 |
| Splitwise | NCCL 层级传输 | FlowKV 将调用次数从 O(n) 降至 O(1) |
| Mooncake | RDMA 传输 | FlowKV 兼容 NCCL,无需特定硬件 |
| DistServe | 分离式推理 | FlowKV 支持异构部署和负载感知调度 |
| MemServe | 内存池管理 | FlowKV 通过段式分配器减少碎片 |
八、总结
核心贡献
- KV Cache 传输优化: 通过结构变换和段式分配器,将 NCCL 调用从 23,469 次降至 1 次,传输延迟降低 96%
- Load-Aware Scheduler: 支持正常/失衡/极端三种负载场景的动态调度,吞吐量提升 25%
- 异构部署支持: P-L20/D-H20 配置在 LongBench 上实现 15.2%-48.9% E2E 加速
- 广泛兼容性: 支持 NCCL/IPC/RDMA 三种传输后端,适配不同硬件环境
技术影响
- 传输优化思路: KV Cache 结构变换和段式内存分配可推广到其他分布式推理框架
- 负载感知调度: 动态 P/D 角色切换为弹性推理服务提供参考
- 异构部署实践: 证明 GPU 特性与任务需求匹配可显著提升性能
局限性
- 仅评估 NCCL 后端: IPC 和 RDMA 的实际性能未详细报告
- 模型规模有限: 仅测试 8B 和 70B 模型,超大规模模型(400B+)未验证
- 场景覆盖: 未测试多轮对话、流式输出等场景
- 调度算法复杂度: Load-Aware Scheduler 的全局控制器可能存在扩展性瓶颈
九、参考资源
- 论文链接: arXiv:2504.03775
- PDF 下载: arXiv PDF
- 相关框架: vLLM, Splitwise, Mooncake, DistServe
- 测试模型: LLaMA-3.1-8B-Instruct, LLaMA-3.1-70B-Instruct
- 测试硬件: A100-SXM4-80GB, L20 (48GB), H20 (96GB)