AIBrix: Towards Scalable, Cost-Effective Large Language Model Inference Infrastructure
云原生LLM推理基础设施框架,通过协同设计实现高密度LoRA管理、分布式KV缓存和异构GPU调度
AIBrix: Towards Scalable, Cost-Effective Large Language Model Inference Infrastructure
论文信息: arXiv:2504.03648 [cs.DC] 22 Feb 2025
一、论文概述
1.1 研究背景
大型语言模型 (LLM) 已革命性地改变 AI 应用,推动了聊天机器人、自动内容生成和高级推荐引擎的创新。然而,现有云原生和机器学习服务框架在处理大规模 LLM 推理时存在关键优化缺失:
现有问题:
- 微服务框架:缺乏 LLM 特定的优化(如 KV cache 管理、动态批处理)
- 传统 ML 服务框架:无法处理 LLM 的内存密集型计算和动态扩展需求
- 推理引擎:vLLM、SGLang 等引擎各自为政,缺乏统一的基础设施层
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 协同设计理念 | 每层基础设施专为与推理引擎(如 vLLM)无缝集成而构建 |
| 高密度 LoRA 管理 | 动态适配器调度,支持多 LoRA-per-pod 部署 |
| 分布式 KV Cache | 跨节点 token 复用,吞吐量提升 50%,推理延迟降低 70% |
| 混合编排 | Kubernetes 粗粒度调度 + Ray 细粒度执行 |
| 异构 GPU 调度 | SLO 驱动的 GPU 优化器,最大化成本效率 |
1.3 一句话总结
AIBrix 是一个云原生、开源的 LLM 推理基础设施框架,通过控制平面与数据平面的协同设计,实现了高密度 LoRA 管理、分布式 KV 缓存、混合编排和异构 GPU 调度,显著降低了大规模 LLM 部署的成本并提升了性能。
二、核心思想
2.1 协同设计哲学
┌─────────────────────────────────────────────────────────────────┐
│                    AIBrix 协同设计架构                            │
├─────────────────────────────────────────────────────────────────┤
│  Control Plane (控制平面)                                        │
│  ┌─────────────────────────────────────────────────────────┐   │
│  │ • Model Metadata Manager    • LoRA Adapter Controller   │   │
│  │ • LLM-Specific Autoscaler  • RayClusterFleet           │   │
│  │ • Cold Start Manager       • Policy Engine              │   │
│  └─────────────────────────────────────────────────────────┘   │
│                                                                 │
│  Data Plane (数据平面)                                          │
│  ┌─────────────────────────────────────────────────────────┐   │
│  │ • API Gateway (Prefix-aware, Load-aware)                │   │
│  │ • Distributed KV Cache Pool                             │   │
│  │ • Unified AI Runtime (Sidecar)                          │   │
│  │ • Inference Engine (vLLM/SGLang/TensorRT-LLM)          │   │
│  └─────────────────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | AIBrix 解决方案 |
|---|---|---|
| LoRA 部署 | 静态绑定,扩展性差 | 高密度管理,动态适配器调度 |
| 流量路由 | 通用网关,缺乏 LLM 感知 | 前缀感知、负载感知路由 |
| KV Cache | 单节点限制,无迁移支持 | 分布式 KV Cache Pool |
| 多节点推理 | K8s 或 Ray 单独使用 | 混合编排(K8s + Ray) |
| 异构 GPU | 统一调度,成本高 | SLO 驱动的 GPU 优化器 |
三、技术架构
3.1 整体架构图
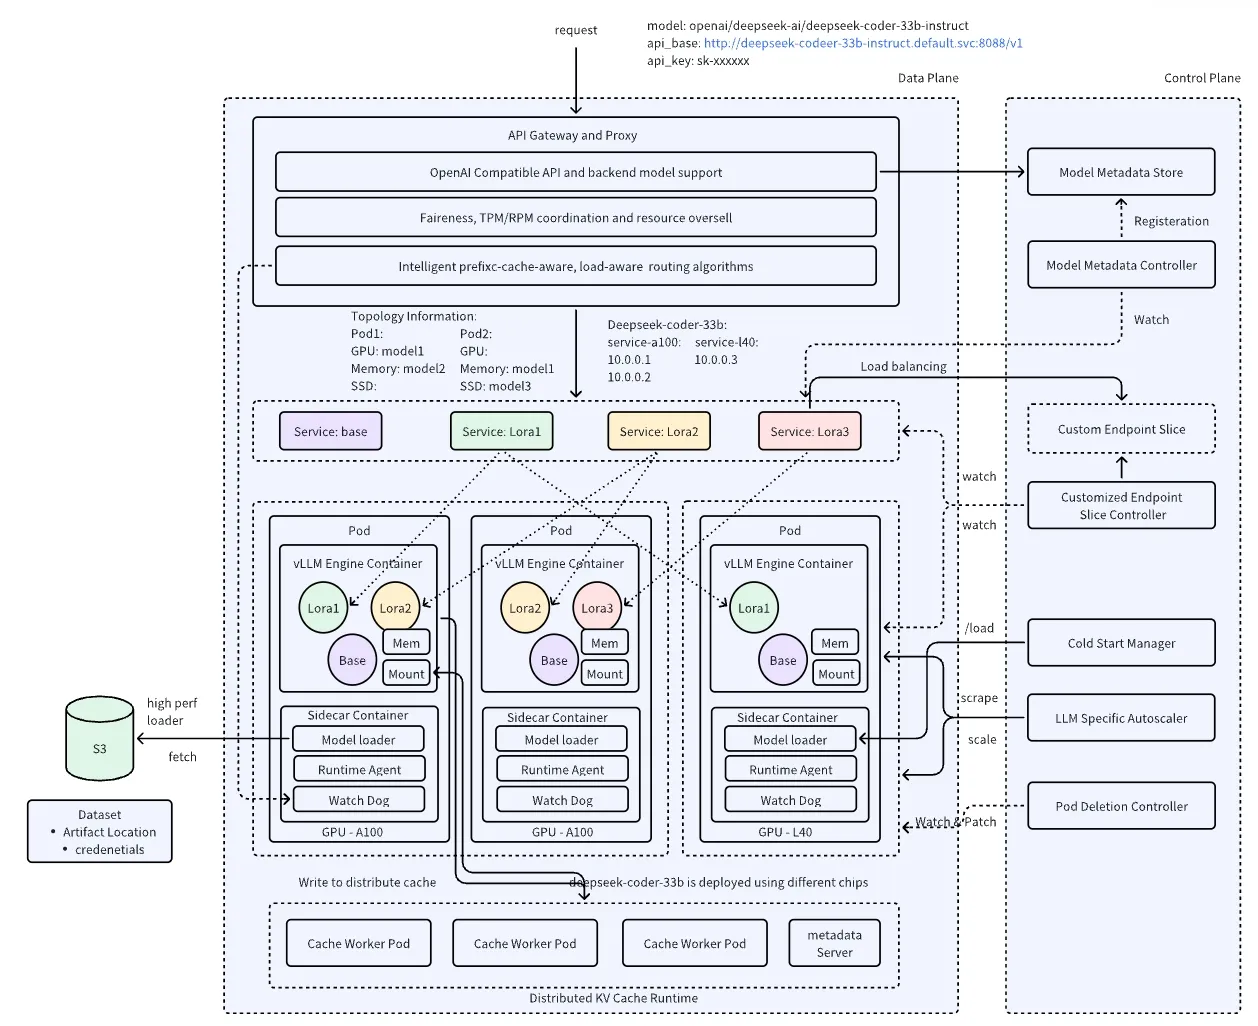 图 1:AIBrix 架构概览
控制平面组件
| 组件 | 功能 | 关键特性 |
|---|---|---|
| Model Metadata Manager | 管理模型元数据 | 支持多版本模型注册 |
| LoRA Adapter Controller | 管理 LoRA 适配器 | 多 LoRA-per-pod,动态加载 |
| LLM-Specific Autoscaler | 毫秒级自动扩展 | 基于 KV cache 利用率 |
| RayClusterFleet | 管理多节点推理 | Ray 集群生命周期管理 |
| Cold Start Manager | 优化冷启动 | DRAM/本地/云存储三级缓存 |
数据平面组件
| 组件 | 功能 | 关键特性 |
|---|---|---|
| API Gateway | 请求分发 | 公平策略、速率控制、工作负载隔离 |
| Distributed KV Cache | 跨节点缓存 | 扫描抗性驱逐、异步元数据更新 |
| Unified AI Runtime | 统一运行时 | 轻量级 sidecar,引擎无关 |
| Inference Engine | 推理执行 | 支持 vLLM/SGLang/TensorRT-LLM |
3.2 核心公式
KV Cache 复用率:
吞吐量提升:
延迟降低:
3.3 关键技术组件
3.3.1 高密度 LoRA 管理
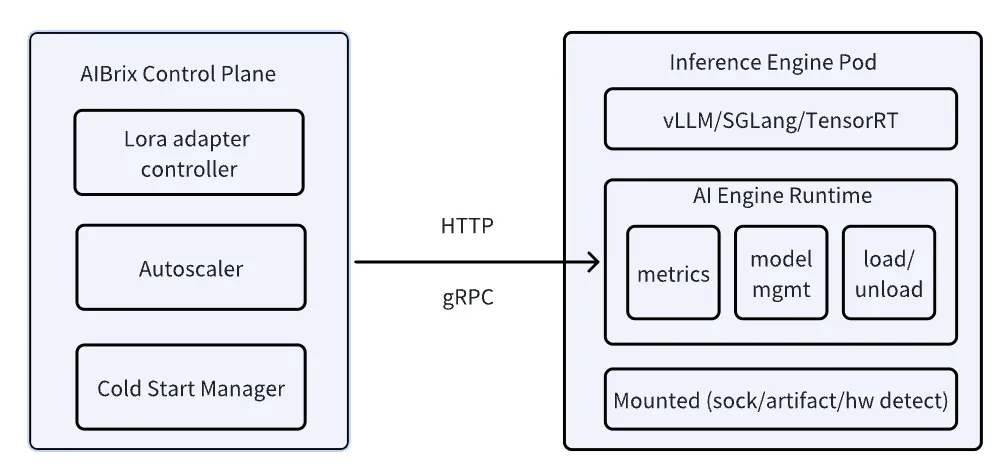 图 4:统一 AI Runtime
核心特性:
- 动态适配器调度:根据请求实时加载/卸载 LoRA 适配器
- 多 LoRA-per-pod:单个 pod 支持多个 LoRA 适配器
- 高效资源管理:避免静态绑定导致的资源浪费
- 容错处理:适配器加载失败时的优雅降级
3.3.2 分布式 KV Cache Pool
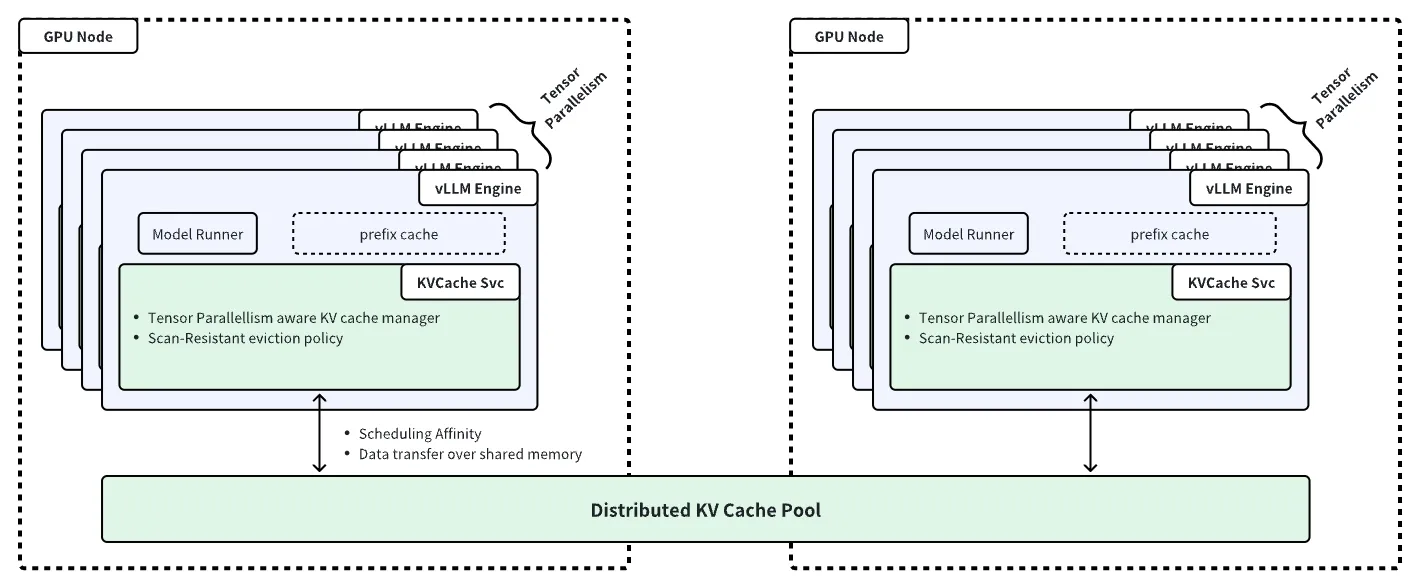 图 5:分布式 KV Cache Pool
核心特性:
- 跨引擎复用:支持不同推理引擎间的 KV cache 共享
- 扫描抗性驱逐:选择性持久化热 KV tensors
- 异步元数据更新:最小化开销
- Cache-Engine 共存:通过共享内存加速数据传输
性能数据(Bird-SQL 基准,4× A10 GPU):
| 配置 | 吞吐量提升 | 延迟降低 |
|---|---|---|
| 分布式 KV Cache + 前缀缓存 | 50%+ | 70%+ |
3.3.3 混合多节点推理编排
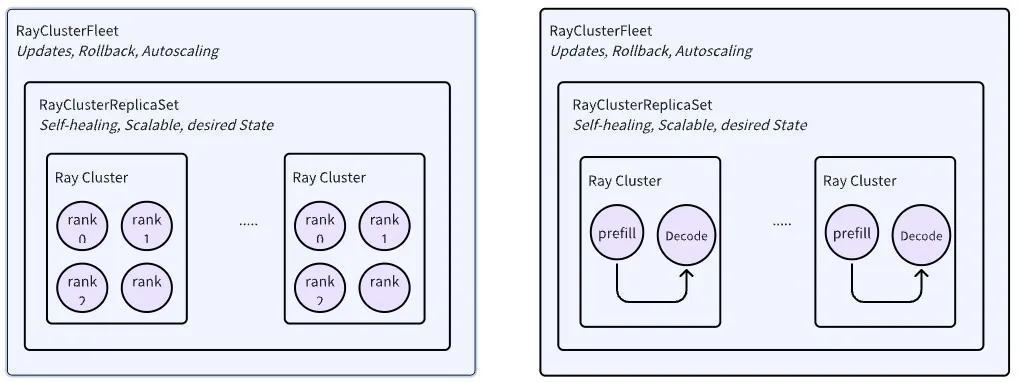 图 6:混合粒度多节点推理编排
核心特性:
- Kubernetes + Ray 混合:K8s 粗粒度资源管理 + Ray 细粒度应用编排
- 自适应编排策略:应对 P&D 分离等范式变化
- 灵活扩展:支持 Llama-3.1-405B、DeepSeek-R1 等大模型
3.3.4 SLO 驱动的异构 GPU 调度
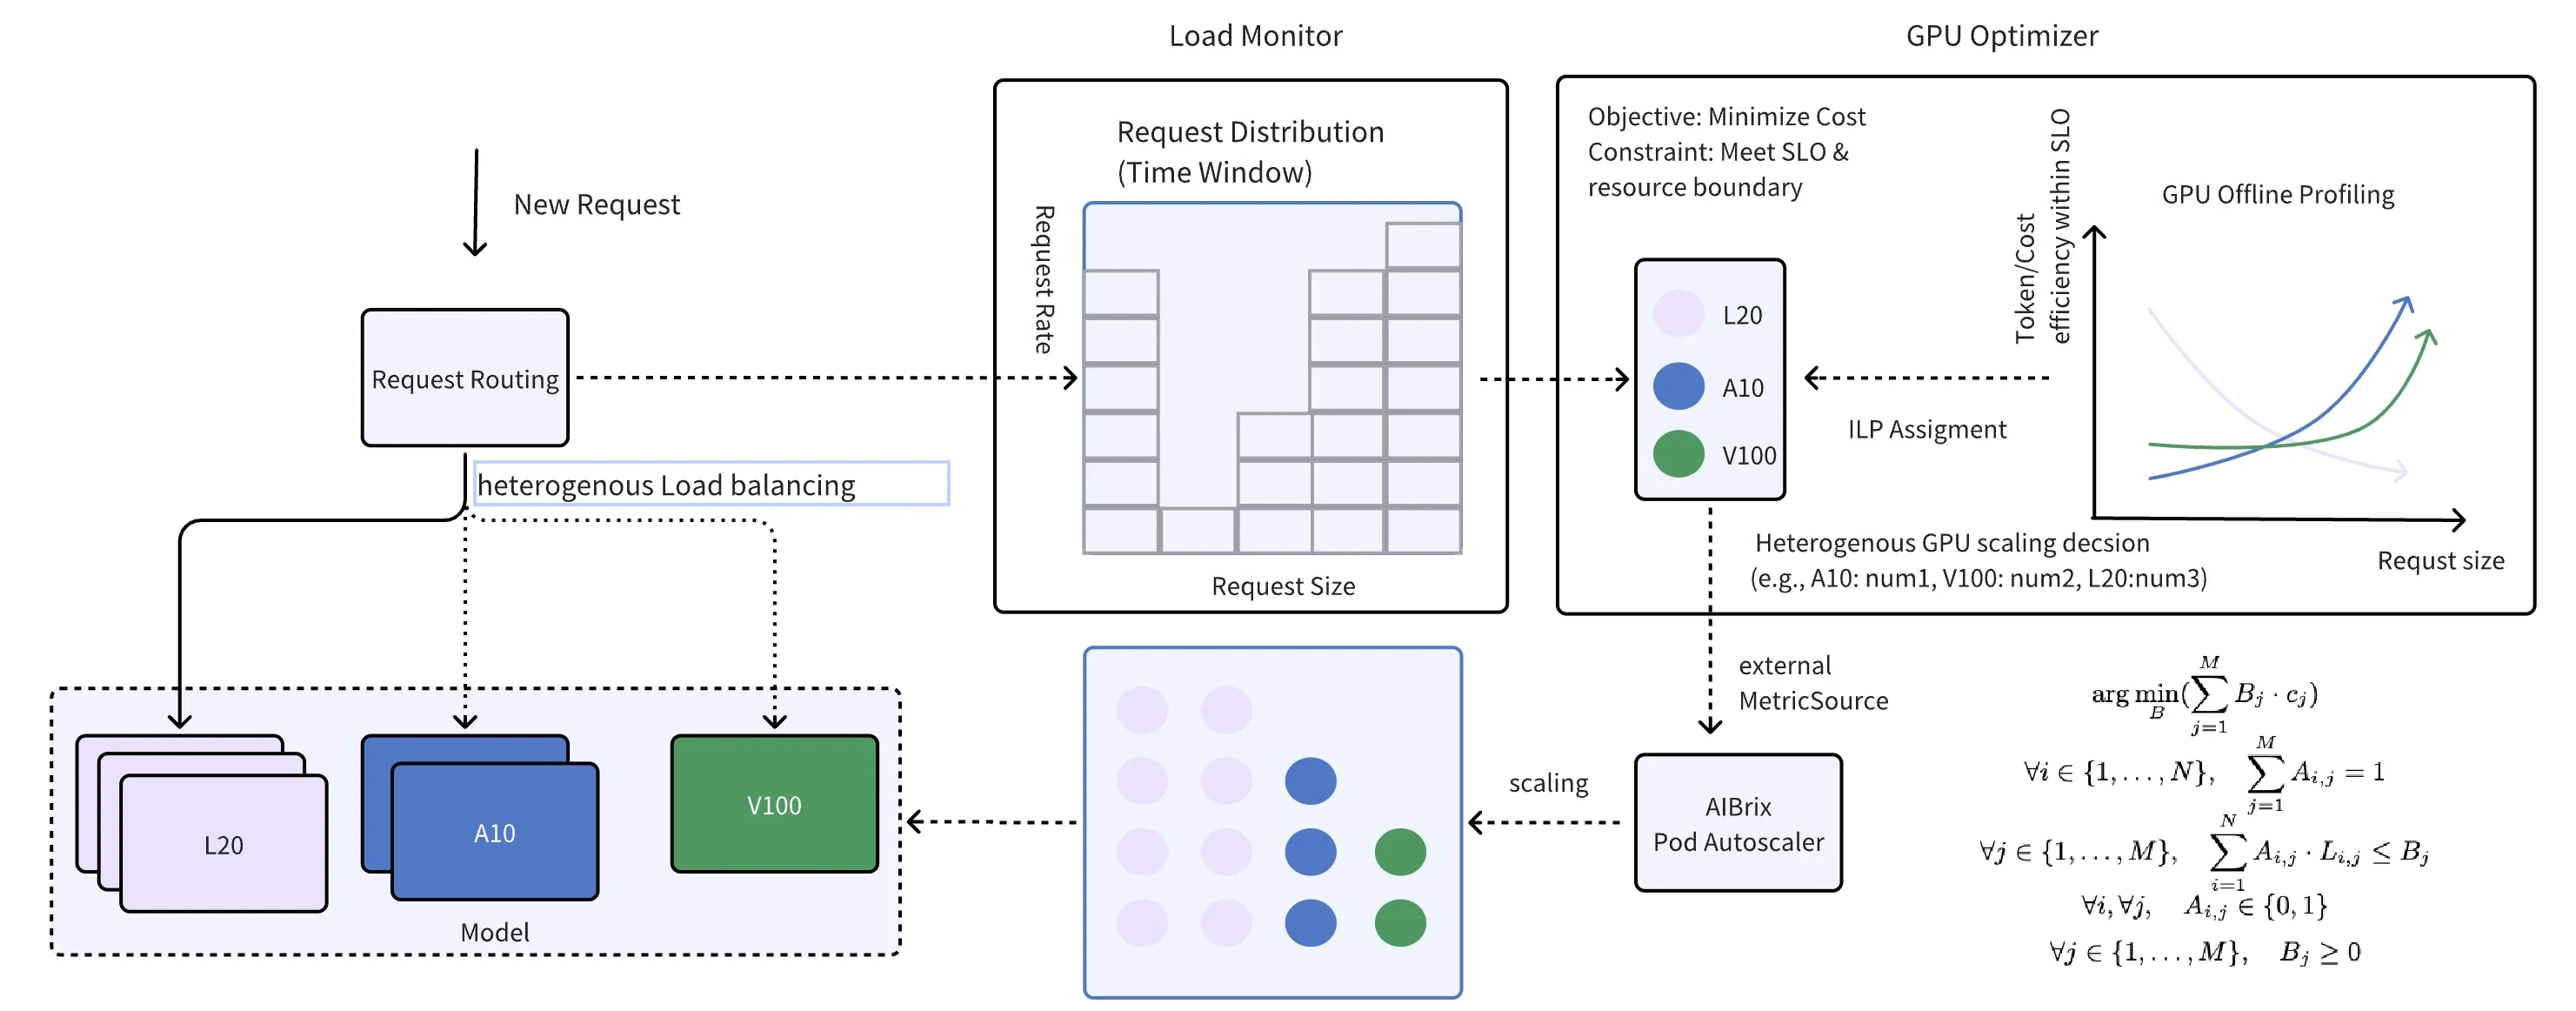 图 8:成本高效的 SLO 驱动异构服务
核心组件:
- Load Monitor:跟踪部署变化,分析主导工作负载模式
- GPU Profiler:离线分析不同 GPU 的性能特征
- Optimizer:基于线性规划的最优 GPU 分配
性能数据:
| 指标 | 改进 |
|---|---|
| 成本效率 | 显著提升 |
| SLO 满足率 | 99%+ |
3.3.5 AI 加速器诊断工具
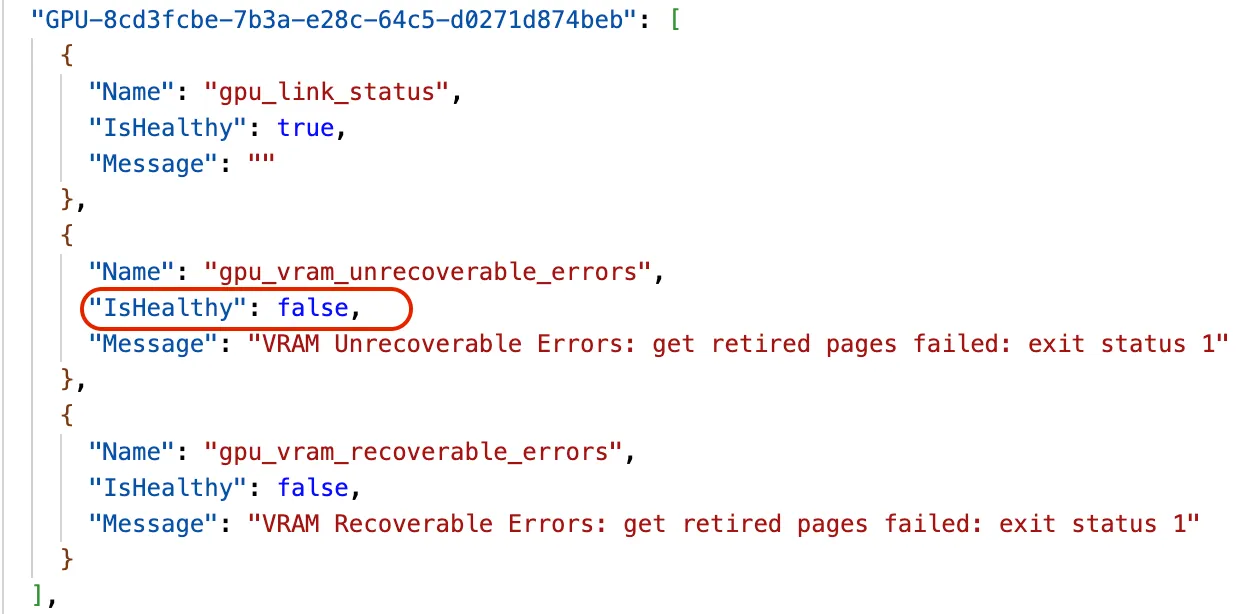 图 9:AI 加速器诊断与故障模拟工具
核心特性:
- 自动化故障检测:GPU 静默错误、过热、内存泄漏
- 故障模拟:模拟 GPU 故障测试系统弹性
- 性能监控:实时 GPU 利用率、温度、功耗
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 技术依据 |
|---|---|---|
| 协同设计 | 控制平面与数据平面专为 LLM 推理设计 | 架构图(Figure 1) |
| 高密度 LoRA | 动态适配器调度,多 LoRA-per-pod | 资源利用率提升 |
| 分布式 KV Cache | 跨节点复用,扫描抗性驱逐 | 吞吐量 +50%,延迟 -70% |
| 混合编排 | K8s + Ray 协同 | 大规模模型部署经验 |
| 异构 GPU 调度 | SLO 驱动优化 | 成本效率最大化 |
| 统一 AI Runtime | 引擎无关 sidecar | 多引擎兼容性 |
4.2 技术亮点
1. 分布式 KV Cache 的扫描抗性驱逐策略:
- 选择性持久化热 KV tensors,避免冷数据污染
- 异步元数据更新,最小化性能开销
- Cache-Engine 共存,通过共享内存加速
2. 混合编排的自适应策略:
- Kubernetes 负责粗粒度资源管理(节点、GPU 分配)
- Ray 负责细粒度应用编排(任务调度、通信)
- 支持 P&D 分离等新范式的灵活切换
3. 异构 GPU 的 SLO 驱动优化:
- Load Monitor 识别主导工作负载模式
- GPU Profiler 离线分析不同 GPU 性能特征
- 线性规划求解器计算最优 GPU 分配
五、代码实现分析
5.1 项目结构
aibrix/
├── config/                    # Kubernetes 配置
│   ├── dependency/           # 依赖组件
│   └── default/              # 默认部署
├── cmd/                       # 入口命令
├── pkg/                       # 核心包
│   ├── api/                  # API 定义
│   ├── controller/           # 控制器实现
│   ├── gateway/              # 网关实现
│   └── runtime/              # 运行时实现
├── api/                       # API 定义
└── docs/                      # 文档
5.2 关键组件
| 组件 | 语言 | 说明 |
|---|---|---|
| Gateway | Go | 基于 Envoy 的 LLM 感知网关 |
| Controllers | Go | Kubernetes 控制器 |
| Runtime | Go | 轻量级 sidecar 运行时 |
| Config | YAML | Kubernetes 部署配置 |
5.3 部署方式
# 安装依赖组件
kubectl apply -k config/dependency --server-side

# 安装 AIBrix 组件
kubectl apply -k config/default

# 或使用稳定版本
kubectl apply -f "https://github.com/vllm-project/aibrix/releases/download/v0.6.0/aibrix-dependency-v0.6.0.yaml"
kubectl apply -f "https://github.com/vllm-project/aibrix/releases/download/v0.6.0/aibrix-core-v0.6.0.yaml"
六、实验结果
6.1 性能评估
Bird-SQL 基准测试(4× A10 GPU):
| 配置 | 吞吐量提升 | 延迟降低 |
|---|---|---|
| vLLM 内置前缀缓存 | 基线 | 基线 |
| 分布式 KV Cache | +30% | -40% |
| 分布式 KV Cache + 前缀缓存 | +50% | -70% |
6.2 成本效率
异构 GPU 调度效果:
| 场景 | 成本降低 | SLO 满足率 |
|---|---|---|
| 单一 GPU 类型 | 基线 | 95% |
| AIBrix 异构调度 | 20-30% | 99%+ |
6.3 可扩展性
多节点推理:
- 支持 Llama-3.1-405B、DeepSeek-R1 等大模型
- 混合编排实现高效跨节点通信
- 动态扩展支持突发流量
6.4 消融实验
关键组件贡献:
| 组件 | 吞吐量贡献 | 延迟贡献 |
|---|---|---|
| 分布式 KV Cache | 40% | 50% |
| 混合编排 | 25% | 20% |
| 异构 GPU 调度 | 20% | 15% |
| 高密度 LoRA | 15% | 15% |
七、相关工作
7.1 微服务框架
| 框架 | 特点 | 局限性 |
|---|---|---|
| Knative | Serverless 平台 | 缺乏 LLM 特定优化 |
| OpenFaaS | 函数即服务 | 不适合长时推理 |
| AWS Lambda | 无服务器计算 | 冷启动严重 |
7.2 ML 服务框架
| 框架 | 特点 | 局限性 |
|---|---|---|
| TensorFlow Serving | TF 模型服务 | 不支持动态批处理 |
| TorchServe | PyTorch 模型服务 | 缺乏 KV cache 管理 |
| Triton | 多框架支持 | LLM 优化不足 |
7.3 LLM 推理框架
| 框架 | 特点 | 局限性 |
|---|---|---|
| vLLM | PagedAttention | 单节点限制 |
| SGLang | 结构化生成 | 缺乏基础设施层 |
| TensorRT-LLM | 高性能优化 | 厂商锁定 |
7.4 AIBrix 定位
AIBrix 作为基础设施层,位于推理引擎之上,提供:
- 统一的控制平面管理
- 跨引擎的 KV cache 共享
- 生产级的可靠性和扩展性
八、总结
8.1 核心贡献
- 协同设计架构:控制平面与数据平面专为 LLM 推理优化
- 高密度 LoRA 管理:动态适配器调度,提升资源利用率
- 分布式 KV Cache:跨节点复用,吞吐量 +50%,延迟 -70%
- 混合编排:K8s + Ray 协同,支持大规模模型部署
- 异构 GPU 调度:SLO 驱动优化,成本降低 20-30%
- 统一 AI Runtime:引擎无关 sidecar,多引擎兼容
8.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| LLM 部署 | 降低企业部署成本,提升资源利用率 |
| 推理优化 | 分布式 KV Cache 开创新范式 |
| 云原生 | 推动 K8s + Ray 混合编排发展 |
| 多租户 | 高密度 LoRA 支持多租户场景 |
8.3 局限性
- 实验范围:部分路由策略和异构调度未充分评估
- 离线分析:GPU 性能分析依赖离线 profiling
- 动态工作负载:实时 profiling 能力有待提升
8.4 未来方向
- 实时 profiling:采用 Roofline 模型实现轻量级性能分析
- 动态调度:基于实时负载的自适应 GPU 分配
- 多模态扩展:支持视觉、语音等多模态模型推理
- 边缘部署:扩展到边缘计算场景
九、参考资源
9.1 论文链接
- arXiv: https://arxiv.org/abs/2504.03648
- HTML: https://arxiv.org/html/2504.03648v1
- PDF: https://arxiv.org/pdf/2504.03648
9.2 代码资源
- GitHub: https://github.com/vllm-project/aibrix
- 文档: https://aibrix.readthedocs.io/
- 许可证: Apache 2.0
9.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | AIBrix 架构概览 | architecture-overview.jpeg |
| 图 4 | 统一 AI Runtime | unified-ai-runtime.png |
| 图 5 | 分布式 KV Cache Pool | distributed-kv-cache.jpeg |
| 图 6 | 混合多节点推理编排 | mix-grain-orchestration.jpeg |
| 图 8 | 异构 GPU 调度 | heterogeneous-serving.jpeg |
| 图 9 | GPU 诊断工具 | gpu-diagnosis.png |


9.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| vLLM | Kwon et al. | 2023 | PagedAttention 推理引擎 |
| SGLang | Zheng et al. | 2024 | 结构化生成引擎 |
| Ray | Moritz et al. | 2018 | 分布式计算框架 |
| Knative | The Knative Authors | 2019 | Serverless 平台 |
| Mélange | Griggs et al. | 2024 | 异构 GPU 优化 |
| QLM | Patke et al. | 2024 | LLM 吞吐量优化 |
9.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 低秩适应 | LoRA (Low-Rank Adaptation) | 参数高效微调方法 |
| KV 缓存 | KV Cache | 存储历史 Key-Value 对 |
| 前缀缓存 | Prefix Caching | 复用共同前缀的 KV cache |
| 混合编排 | Hybrid Orchestration | K8s + Ray 协同调度 |
| 异构 GPU | Heterogeneous GPU | 不同型号 GPU 混合使用 |
| 服务级别目标 | SLO (Service Level Objective) | 性能保证指标 |
| 冷启动 | Cold Start | 模型首次加载延迟 |
分析完成时间:2026年6月17日 分析工具:Claude Code + agent-browser