Rethinking Key-Value Cache Compression Techniques for Large Language Model Serving
从生产实践角度重新审视KV缓存压缩技术,揭示吞吐量、响应长度和负样本三个被忽视的关键维度
Rethinking Key-Value Cache Compression Techniques for Large Language Model Serving
论文信息: arXiv:2503.24000 [cs.LG] 31 Mar 2025 | MLSys 2025
一、论文概述
1.1 研究背景
Key-Value cache (KV cache) 压缩已成为优化大语言模型 (LLM) 服务的重要技术。然而,尽管已开发出众多压缩算法,其在生产环境中的应用仍然不普遍。本文从生产实践角度重新审视主流 KV cache 压缩方案,揭示了现有评估中的三个被忽视的关键维度。
KV cache 的内存挑战:
- 以 LLaMA3-70B 为例:FP16 格式、batch size 512、prompt 长度 2048
- 模型权重:130GB
- KV cache:额外 512GB
- 总内存需求远超单卡容量
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| 综合文献综述 | 系统梳理现有 KV cache 压缩算法和基准测试研究 |
| 三个关键维度 | 识别被忽视的吞吐量、响应长度分布、负样本分析 |
| 深入实验评估 | 在生产级框架(FlashAttention、PagedAttention)上评估压缩算法 |
| 开源工具集 | 提供吞吐量预测器、长度预测器和负样本评估基准 |
1.3 一句话总结
本文揭示了 KV cache 压缩在生产部署中的三个关键问题:(1) 压缩带来的吞吐量收益在 FlashAttention/PagedAttention 下大幅缩水;(2) 压缩导致响应变长,反而增加端到端延迟;(3) 负样本分析揭示了压缩算法对特定任务的脆弱性。
二、核心思想
2.1 两类压缩方法
量化方法 (Quantization):
量化: X_quant = ⌊(X - ℓ) / Δ⌉,  Δ = (u - ℓ) / (2^b - 1)
反量化: X̂ = X_quant · Δ + ℓ- 降低精度(如 INT8/FP16)减少内存占用
- 代表算法:KIVI, GEAR, KVQuant, ZipCache
稀疏方法 (Sparsity):
- 驱逐不重要的 KV pairs,保留重要 token
- 代表算法:StreamingLLM, H2O, SnapKV, Quest
- 关键挑战:如何准确评估 token 重要性
2.2 生产部署的核心问题
┌─────────────────────────────────────────────────────────────┐
│                    LLM 推理流程                               │
├─────────────────────────────────────────────────────────────┤
│  Prefill Stage:  Prompt → KV Cache(一次性计算)              │
│  Decoding Stage: 逐 token 生成,更新 KV Cache                │
├─────────────────────────────────────────────────────────────┤
│  加速技术:                                                    │
│  • FlashAttention: IO-aware 分块计算,减少内存访问             │
│  • PagedAttention: 虚拟内存管理,动态分配 KV cache 块          │
└─────────────────────────────────────────────────────────────┘
2.3 三个被忽视的关键维度
| 维度 | 现有问题 | 本文发现 |
|---|---|---|
| 吞吐量 | 仅在 TRL 框架测量 | FlashAttention/PagedAttention 下收益大幅缩水 |
| 响应长度 | 假设固定长度评估 | 压缩导致响应变长,抵消吞吐量收益 |
| 负样本 | 仅报告整体准确率 | 压缩对特定任务类型(摘要、QA)具有脆弱性 |
三、技术架构
3.1 KV Cache 压缩算法分类
量化方法设计要素
| 设计要素 | 说明 | 代表算法 |
|---|---|---|
| 量化粒度 | per-channel / per-token / 混合精度 | KIVI, ZipCache, MiKV |
| 量化误差校正 | 低秩矩阵近似、异常值保留 | GEAR, IntactKV, QuaRot |
| 动态量化 | 自适应比特分配 | SKVQ, QAQ |
问题:更细粒度的量化可能保留精度,但引入不规则计算模式,限制 GPU 并行效率。
稀疏方法设计要素
| 设计要素 | 说明 | 代表算法 |
|---|---|---|
| 驱逐粒度 | token/layer/head/channel 级别 | Scissorhands, SqueezeAttention, ThinK |
| 重要性指标 | 注意力分数累积 | H2O, StreamingLLM |
| 驱逐范围 | 局部窗口约束 | Quest, TOVA |
| 预算分配 | 固定/动态跨层分配 | PyramidKV, Ada-KV |
问题:细粒度驱逐和复杂驱逐策略导致不规则计算,与 FlashAttention/PagedAttention 不兼容。
3.2 兼容性问题分析
FlashAttention 兼容性:
- FlashAttention 使用分块计算,不保存注意力分数
- 稀疏方法需要计算注意力分数作为重要性指标
- 需要额外两次数据加载和一次注意力计算
PagedAttention 兼容性:
- PagedAttention 假设 KV cache 长度单调递增
- 稀疏方法定期驱逐 token,长度波动
- 量化方法需要管理全精度和量化两种页面类型
3.3 评估框架对比
| 框架 | PagedAttention | FlashAttention | 生产就绪 |
|---|---|---|---|
| TRL (Transformers) | ✗ | ✗ | ✗ |
| TRL + FlashAttn | ✗ | ✓ | 部分 |
| LMDeploy | ✓ | ✓ | ✓ |
| vLLM | ✓ | ✓ | ✓ |
四、核心创新与实验发现
4.1 吞吐量分析 (Throughput Analysis)
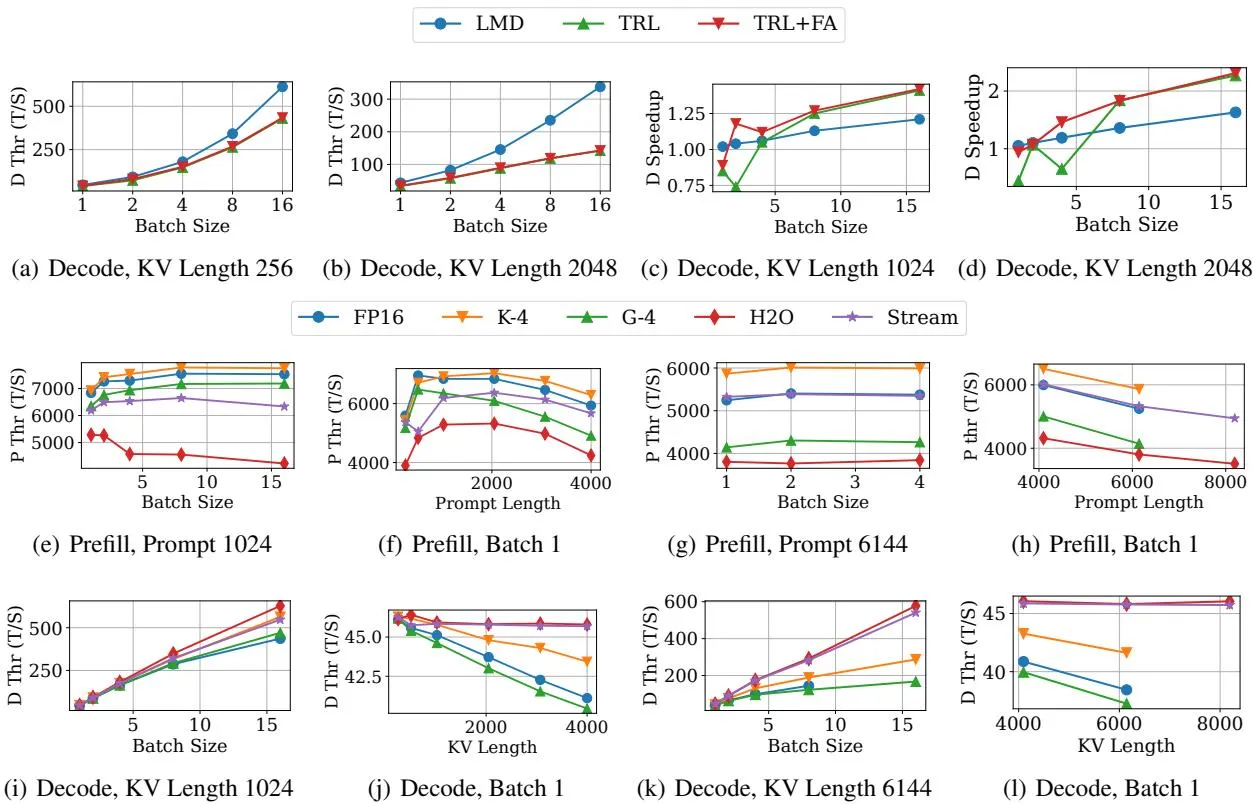 图 1:LLaMA-7B 在不同框架和配置下的吞吐量分析
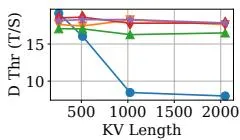 图 2:LLaMA-70B 在 H800 GPU 上的吞吐量分析
关键发现:
| 观察 | 说明 |
|---|---|
| Observation 1 | TRL 框架上的吞吐量结果不可靠,应在 LMDeploy 等生产框架上测量 |
| Observation 2 | 压缩方法在特定 batch size、序列长度和张量并行度下呈现负面计算效率 |
Prefill 阶段吞吐量:
- KIVI 和 StreamingLLM 接近或优于 FP16 基线
- GEAR 和 H2O 一致降低 prefill 吞吐量,且随 prompt 长度增加差距扩大
Decoding 阶段吞吐量:
- 小 batch size 和短 KV 长度时,各方法差异不显著
- 重负载下(长 KV 长度 + 高 batch size),稀疏方法保持优势
- 量化方法在 KV 长度达 8192 时可能 OOM
4.2 响应长度分布分析 (Length Distribution Analysis)
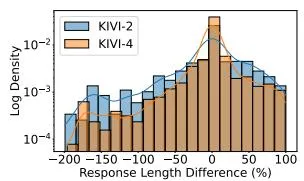 图 4(a):KIVI 不同配置下的响应长度差异分布
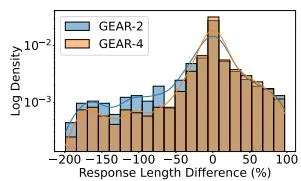 图 4(b):GEAR 不同配置下的响应长度差异分布
响应长度差异定义:
- : 无压缩时的响应长度
- : 使用压缩时的响应长度
- D < 0 表示压缩导致更长输出
关键发现:
| 观察 | 说明 |
|---|---|
| Observation 3 | 有损压缩导致响应长度大幅变化,压缩算法倾向于产生冗长响应 |
| Observation 4 | 端到端延迟分析揭示压缩方法在实践中仍有很长的路要走 |
实验数据(LLaMA-3.1-8B-instruct + ShareGPT):
| 指标 | FP16 | KIVI-4 | GEAR-4 | H2O-512 | Stream-512 |
|---|---|---|---|---|---|
| 语义分数 | 49.6 | 50.7 | 46.2 | 46.2 | 46.3 |
| 长度增加 | - | 1.69× | 1.70× | 1.55× | 1.76× |
重要发现:
- 超过 20% 的样本响应长度至少增加 1.5×
- 压缩方法无法在多数场景下实现超过 1.5× 的 decoding 吞吐量提升
- 这些样本将因响应变长而遭受端到端延迟增加
4.3 端到端延迟分析
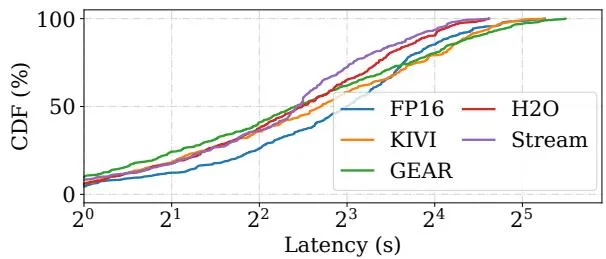 图 5:各压缩算法的端到端延迟累积分布函数
关键发现:
- 结合吞吐量和响应长度分析,压缩方法的性能增益并不显著
- GEAR 甚至导致更长的尾延迟
- 仅测量固定响应长度的吞吐量无法说服 LLM 从业者部署压缩算法
4.4 负样本分析 (Negative Sample Analysis)
负样本定义:当 KV cache 压缩导致相对准确率损失超过给定阈值时,该样本被视为负样本。
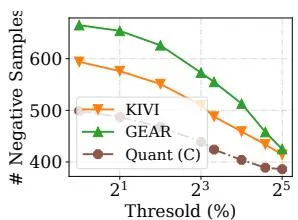 图 6(a):量化方法的阈值与负样本数量关系
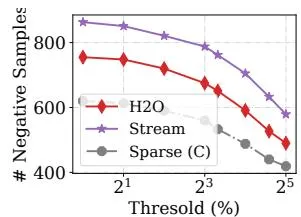 图 6(b):稀疏方法的阈值与负样本数量关系
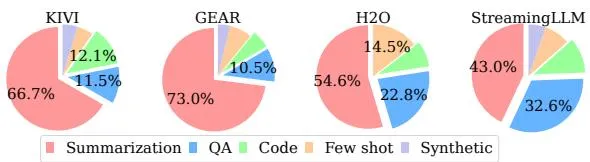 图 7:各压缩算法负样本的任务类型分布
关键发现:
| 观察 | 说明 |
|---|---|
| Observation 5 | KV cache 压缩算法天然存在负样本,准确率提升可减少但难以根除 |
| Observation 6 | 不同任务类型受压缩影响程度不同,摘要和 QA 任务最脆弱 |
负样本在不同任务类型的分布(阈值 10%):
| 算法 | 摘要 (%) | QA (%) | 代码 (%) |
|---|---|---|---|
| KIVI | 66.7 | 11.5 | 12.1 |
| GEAR | 73.0 | 10.5 | - |
| H2O | 54.6 | 22.8 | 14.5 |
| StreamingLLM | 43.0 | 32.6 | - |
分析:
- 摘要任务:严重依赖上下文信息,信息丢失导致不良响应
- QA 任务:早期丢失的信息在后期被放大
- 代码任务:相对鲁棒,但仍有显著性能下降
4.5 张量并行度分析
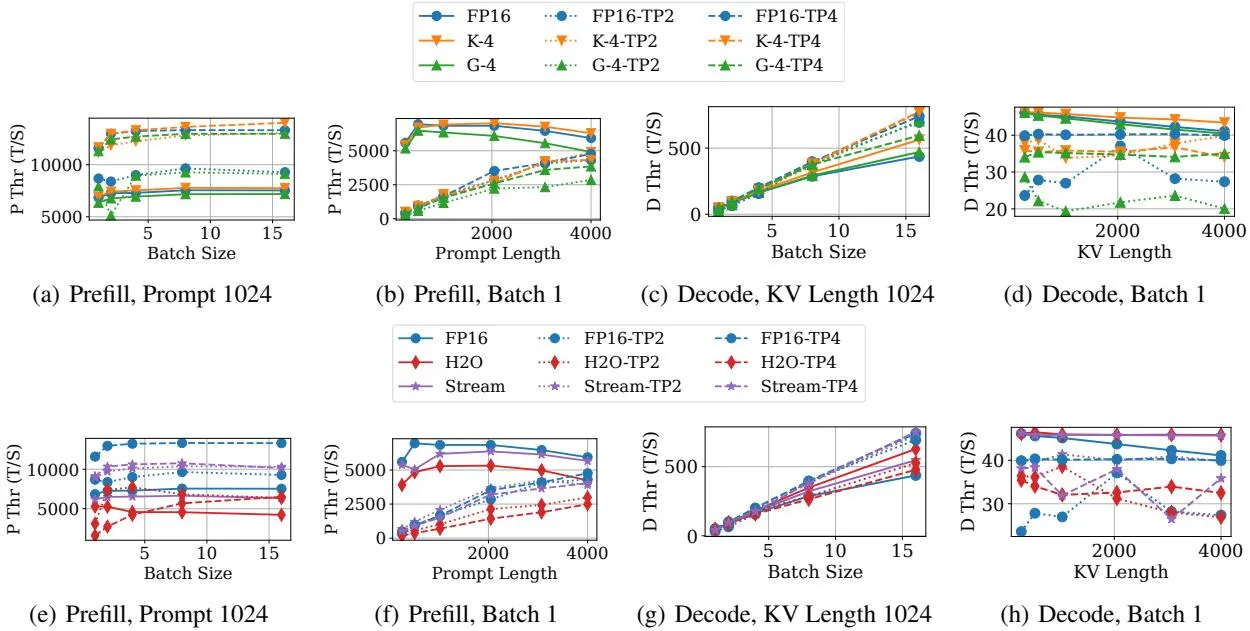 图 11:不同张量并行配置下的吞吐量分析
关键发现:
- 增加张量并行度可缓解单卡内存带宽压力
- 但也削弱了 KV cache 压缩带来的内存访问减少优势
- 某些情况下甚至对整体吞吐量产生负面影响
五、开源工具集
5.1 吞吐量预测器 (Throughput Predictor)
- 功能:离线分析注意力层在不同序列长度和 batch size 下的吞吐量
- 集成:结合 Vidur 运行时预测器,为调度决策提供信息
- 准确率:85.8% - 88.5%(不同压缩技术)
5.2 长度预测器 (Length Predictor)
- 功能:使用 BERT 分类器预测压缩算法生成的响应长度
- 用途:通知在线服务系统是否对传入请求应用压缩
- 准确率:87.8% - 95.7%(不同压缩技术)
5.3 负样本评估器 (Negative Sample Evaluator)
- 功能:基于 10% 阈值收集负样本,编译为基准数据集
- 评估结果(LongBench + LLaMA-3.1-8B-instruct):
| 任务类型 | Baseline | KIVI | GEAR | H2O | Stream |
|---|---|---|---|---|---|
| 摘要 | 31.6 | 24.8 | 23.7 | 24.7 | 24.3 |
| QA | 52.0 | 28.8 | 28.7 | 33.8 | 30.4 |
| 代码 | 97.0 | 30.0 | 30.0 | 57.2 | 61.3 |
5.4 请求路由器 (Request Router)
结合吞吐量和长度预测器,实现智能请求路由:
| 路由策略 | FP16 | KIVI | GEAR | H2O | Stream |
|---|---|---|---|---|---|
| Baseline | 11.4s | 9.1s | 13.4s | 10.6s | 10.3s |
| w/ Throughput | - | 7.7s | 9.1s | 8.3s | 8.2s |
| w/ Length | - | 10.9s | 13.0s | 11.2s | 11.3s |
| w/ Both | - | 6.3s | 7.4s | 6.9s | 6.6s |
加速效果:
- 吞吐量预测器:1.18-1.48× 加速
- 长度预测器单独使用:0.83-1.03×(可能反而变慢)
- 两者结合:1.45-1.80× 加速
六、相关工作
6.1 KV Cache 压缩算法
| 类别 | 代表算法 | 特点 |
|---|---|---|
| 量化 | KIVI, GEAR, KVQuant, ZipCache | 降低精度减少内存 |
| 稀疏 | StreamingLLM, H2O, SnapKV, Quest | 驱逐不重要 token |
| 混合 | Q-Hitter | 结合量化和稀疏 |
6.2 基准测试研究
| 基准 | 任务 | 模型 | 指标 |
|---|---|---|---|
| QLLM-Eval | NLP、信任度、对话 | OPT, LLaMA2, Falcon | Acc |
| LLM-QBench | WikiText2, C4, Exam | LLaMA2, ChatGLM | Acc, Throughput |
| LongCTX-Bench | 长上下文任务 | Mistral, LLaMA | Acc |
6.3 LLM 服务框架
| 框架 | PagedAttention | FlashAttention | 适用场景 |
|---|---|---|---|
| TRL | ✗ | ✗ | 研究实验 |
| DeepSpeed | 部分 | ✓ | 训练 + 推理 |
| FlashInfer | ✓ | ✓ | 推理优化 |
| vLLM | ✓ | ✓ | 生产服务 |
| LMDeploy | ✓ | ✓ | 生产服务 |
七、总结
7.1 主要贡献
- 文献综述:系统梳理 50+ KV cache 压缩算法,识别评估空白
- 三个关键维度:提出吞吐量、响应长度、负样本三个被忽视的评估维度
- 深入实验:在生产级框架上揭示压缩算法的实际局限性
- 开源工具:提供吞吐量预测器、长度预测器和负样本基准数据集
- 实践指导:为 LLM 从业者提供部署压缩算法的决策依据
7.2 关键发现
| 发现 | 影响 |
|---|---|
| TRL 框架吞吐量不可靠 | 应在 LMDeploy/vLLM 等生产框架评估 |
| 压缩导致响应变长 | 抵消吞吐量收益,增加端到端延迟 |
| 负样本普遍存在 | 摘要和 QA 任务最脆弱 |
| 张量并行削弱压缩收益 | 多卡场景需重新评估压缩价值 |
7.3 局限性
- 评估范围:主要评估 LLaMA 和 Mistral 家族,其他模型家族未覆盖
- 压缩算法:仅选择 4 种代表性算法,更多算法待评估
- 硬件平台:主要在 A6000 和 H800 上测试,其他硬件平台待验证
7.4 未来方向
- 任务感知压缩:开发根据任务类型自适应选择压缩策略的方法
- 动态压缩比:根据请求特征动态调整压缩比
- 框架集成:将压缩算法深度集成到 vLLM/LMDeploy 等生产框架
- 多模态扩展:将分析扩展到多模态模型的 KV cache 压缩
八、参考资源
8.1 论文链接
- arXiv: https://arxiv.org/abs/2503.24000
- HTML: https://arxiv.org/html/2503.24000v1
- PDF: https://arxiv.org/pdf/2503.24000
8.2 代码资源
8.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | LLaMA-7B 吞吐量分析 | figure-1-throughput-llama7b.jpg |
| 图 2 | LLaMA-70B H800 吞吐量分析 | figure-2-throughput-llama70b.jpg |
| 图 3 | 注意力层执行时间 | figure-3-attention-execution-time.jpg |
| 图 4 | 响应长度分布 | figure-4a-length-distribution-kivi.jpg |
| 图 5 | 端到端延迟 CDF | figure-5-end-to-end-latency.jpg |
| 图 6 | 负样本分析 | figure-6a-negative-samples-quant.jpg |
| 图 7 | 负样本任务分布 | figure-7-negative-samples-task-breakdown.jpg |
| 图 11 | 张量并行度分析 | figure-11-tensor-parallelism-llama7b.jpg |


8.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| FlashAttention | Dao et al. | 2022 | IO-aware 注意力优化 |
| FlashAttention-2 | Dao | 2024 | FlashAttention 改进版 |
| vLLM/PagedAttention | Kwon et al. | 2023 | 虚拟内存管理 KV cache |
| KIVI | Liu et al. | 2024 | 量化方法代表 |
| GEAR | Kang et al. | 2024 | 量化误差校正 |
| StreamingLLM | Xiao et al. | 2023 | 稀疏方法代表 |
| H2O | Zhang et al. | 2024 | 注意力分数驱逐 |
| SnapKV | Li et al. | 2024 | 聚类重要 token |
| Quest | Tang et al. | 2024 | Query-aware 驱逐 |
8.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| KV 缓存 | KV Cache | 存储历史 Key-Value 对避免重复计算 |
| 量化 | Quantization | 降低数值精度减少内存占用 |
| 稀疏 | Sparsity | 驱逐不重要的 KV pairs |
| 负样本 | Negative Samples | 压缩导致准确率显著下降的样本 |
| 端到端延迟 | End-to-End Latency | 从请求到完整响应的总时间 |
| 吞吐量 | Throughput | 单位时间处理的 token 数量 |
| 张量并行 | Tensor Parallelism | 将模型分布到多个 GPU |
分析完成时间:2026年6月17日 分析工具:Claude Code + MinerU API