Injecting Adrenaline into LLM Serving: Boosting Resource Utilization and Throughput via Attention Disaggregation
Adrenaline提出注意力分离与卸载机制,将解码阶段的注意力计算卸载到预填充实例,解决PD分离导致的资源利用率低下问题,最高提升1.68×推理吞吐。
Injecting Adrenaline into LLM Serving: Boosting Resource Utilization and Throughput via Attention Disaggregation
一、论文概述 (Overview)
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | Injecting Adrenaline into LLM Serving: Boosting Resource Utilization and Throughput via Attention Disaggregation |
| arXiv ID | 2503.20552 |
| 作者 | Yunkai Liang (Sun Yat-sen Univ.), Zhangyu Chen (Huawei Cloud), Pengfei Zuo (Huawei Cloud), Zhi Zhou (Sun Yat-sen Univ.), Xu Chen (Sun Yat-sen Univ.), Zhou Yu (Huawei Cloud) |
| 机构 | 中山大学, 华为云 |
| 论文 | https://arxiv.org/abs/2503.20552 |
| 发布日期 | 2025-03-27 |
1.2 摘要
在LLM推理服务系统中,每个请求的执行包含两个阶段:计算密集型的预填充(prefill)阶段和内存密集型的解码(decoding)阶段。为防止性能干扰,当前系统通常采用预填充-解码分离(PD disaggregation),将两个阶段分配到不同的机器上。然而,我们发现这种方法导致显著的资源利用率低下:预填充实例(计算密集型)的内存利用率低,而解码实例(内存密集型)的计算利用率低。
本文提出 Adrenaline——一种注意力分离与卸载机制,旨在提升LLM服务系统的资源利用率和性能。Adrenaline的核心创新在于将解码阶段的部分注意力计算分离并卸载到预填充实例。由于解码阶段注意力计算本质上是内存绑定的,这种卸载策略天然有效,带来两个互补优势:
- 提升预填充实例的内存容量和带宽利用率
- 增加解码实例的批处理大小,从而提高计算利用率
Adrenaline通过三项关键技术实现这些增益:低延迟解码同步、资源高效的预填充共存、负载感知的卸载调度。实验结果表明,Adrenaline在预填充实例中实现2.28×更高的内存容量和2.07×更好的内存带宽利用率,解码实例的计算利用率提升最高达1.67×,整体推理吞吐比最先进系统提升1.68×。
1.3 核心贡献
- 问题发现: 首次系统性揭示PD分离系统中的实例内资源利用不均衡问题
- 注意力分离架构: 提出将解码阶段的注意力计算分离到预填充实例的新范式
- 低延迟解码同步: 通过2D CUDA图技术和工作流编排,消除CPU调度开销
- 资源高效的预填充共存: 基于SM比例的自适应资源分区,确保性能隔离
- 负载感知卸载调度: 全局调度器 + 上下界约束的细粒度自适应决策
- 原型实现与评估: 基于vLLM实现,在Llama-2 7B/13B上验证
二、核心思想 (Core Ideas)
2.1 问题定义
LLM推理服务中,每个请求包含两个阶段:
| 阶段 | 特性 | 延迟指标 | 瓶颈 |
|---|---|---|---|
| Prefill | 计算密集型(并行处理多个prompt token) | TTFT (Time-to-First-Token) | GPU计算资源 |
| Decoding | 内存密集型(自回归逐token生成,频繁加载KV cache) | TPOT (Time-per-Output-Token) | HBM带宽/容量 |
由于两个阶段的SLO差异显著(TTFT通常长于TPOT),且在同一GPU上运行会导致严重干扰,现代LLM服务系统普遍采用PD分离——将两个阶段分配到不同的GPU上。
2.2 PD分离的资源利用困境
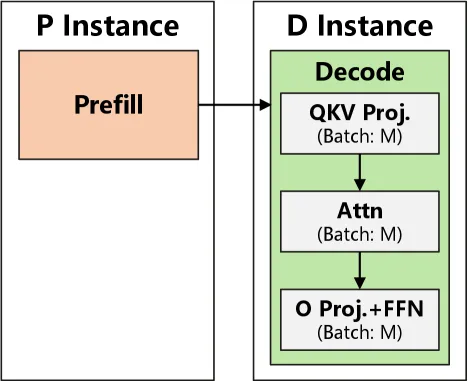
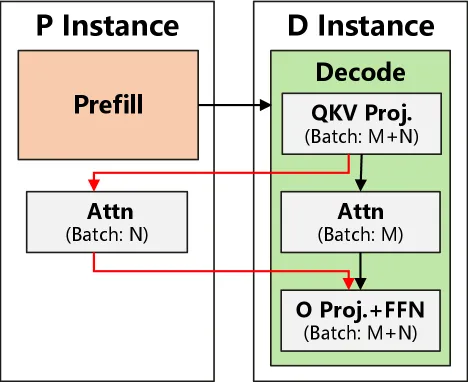
关键观察: PD分离虽然消除了阶段间干扰,但导致实例内资源利用不均衡:
预填充实例:
- QKV投影、注意力计算、输出投影、FFN四个主要核函数均为计算密集型
- HBM带宽利用率极低(Figure 5)
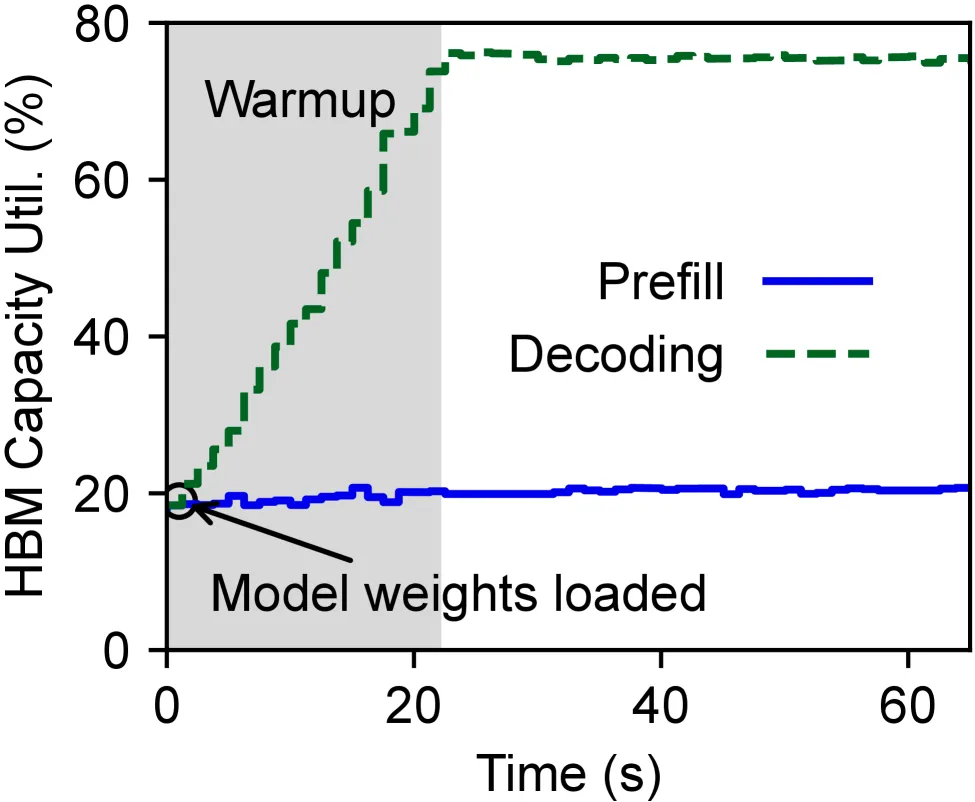
- KV缓存一旦生成立即发送到解码实例,导致HBM容量利用率低(Figure 2)
解码实例:
- 自回归特性导致GPU核函数的算术强度低
- 计算利用率远低于预填充实例(Figure 6)
- 随着批处理大小增加,注意力计算核函数主导执行时间(batch=80时占69.5%)
- 注意力计算是HBM容量和带宽的主要消耗者


2.3 Adrenaline的核心思路
将解码阶段的注意力计算分离并卸载到预填充实例:
- 注意力计算本质上是内存绑定的,预填充实例有大量空闲的HBM资源可以利用
- 卸载后,解码实例可以增大批处理大小,提升计算利用率
- 预填充实例的注意力执行器利用空闲内存容量和带宽
- 两者互补,共同提升整体系统性能
三、技术架构 (Technical Architecture)
3.1 系统架构总览
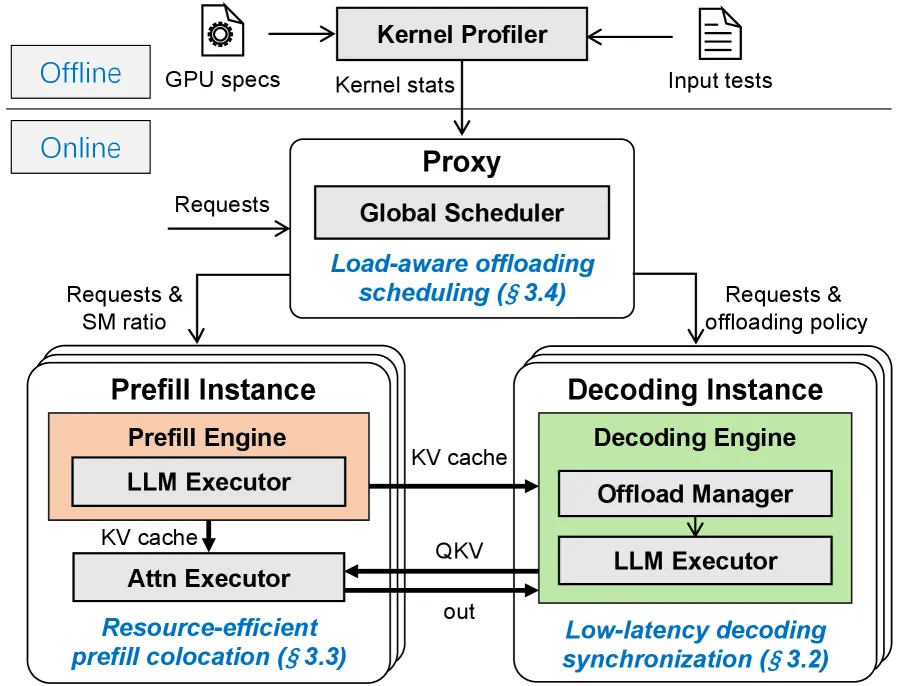
Adrenaline由三个主要模块组成:
| 模块 | 职责 |
|---|---|
| Proxy | 路由推理任务到预填充和解码实例,管理运行时元数据 |
| Prefill Instance | 执行预填充引擎 + 远程注意力执行器(colocated) |
| Decoding Instance | 执行解码引擎,将部分注意力计算卸载到远程执行器 |
3.2 低延迟解码同步 (Low-latency Decoding Synchronization)
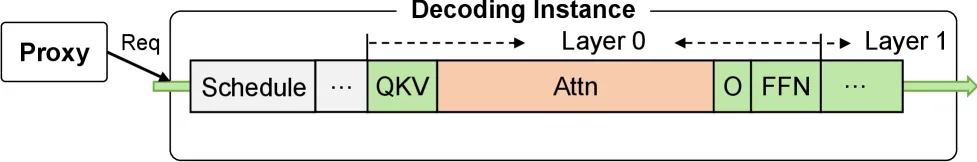
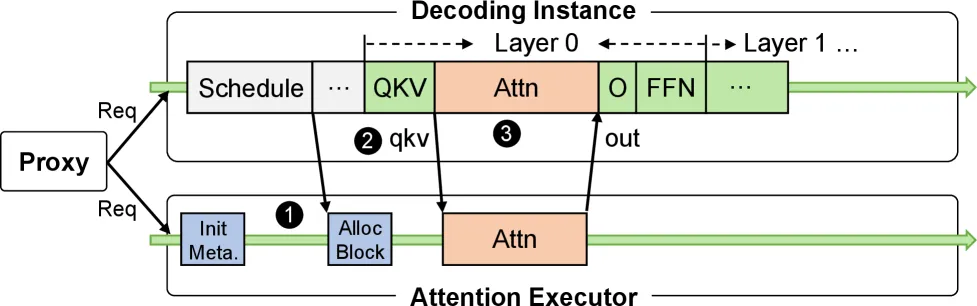
挑战: 每个transformer层需要额外的同步步骤(发送qkv → 执行远程注意力 → 接收输出),CPU干预导致的同步开销在每个层积累会显著增加TPOT。
解决方案:
3.2.1 工作流编排
| 优化 | 方法 | 效果 |
|---|---|---|
| 元数据外置 | 将运行时元数据初始化和资源管理操作移出关键路径 | 减少关键路径延迟 |
| 聚合传输 | 将分散的q/k/v输入聚合成单次操作发送 | 降低通信成本 |
| 时间重叠 | 调度算法确保远程注意力GPU时间与本地注意力GPU时间重叠 | 减少空闲等待 |
3.2.2 二维CUDA图 (2D CUDA Graph)
问题: vLLM的CUDA图技术对注意力卸载无效——未知且动态的本地/远程请求数量违反了静态张量形状要求。
Adrenaline方案: 采用二维CUDA图:
- 维度1: 解码实例的原始批处理大小容量 ()
- 维度2: 卸载注意力计算任务的容量 ()
- 组合产生 个CUDA图
优化: 通过可配置间隔限制捕获的CUDA图总数。给定卸载比例,选择能同时容纳本地和远程注意力批处理的最小二维CUDA图。
效果: 在Llama-2 7B(batch=8, seq=1K)上,每transformer层平均GPU时间0.38ms,但CPU时间1.137ms,浪费0.76ms GPU时间。CUDA图技术显著提升性能。
3.3 资源高效的预填充共存 (Resource-efficient Prefill Colocation)
挑战: 注意力执行器与预填充实例共享GPU资源,可能导致性能干扰。
3.3.1 资源利用画像
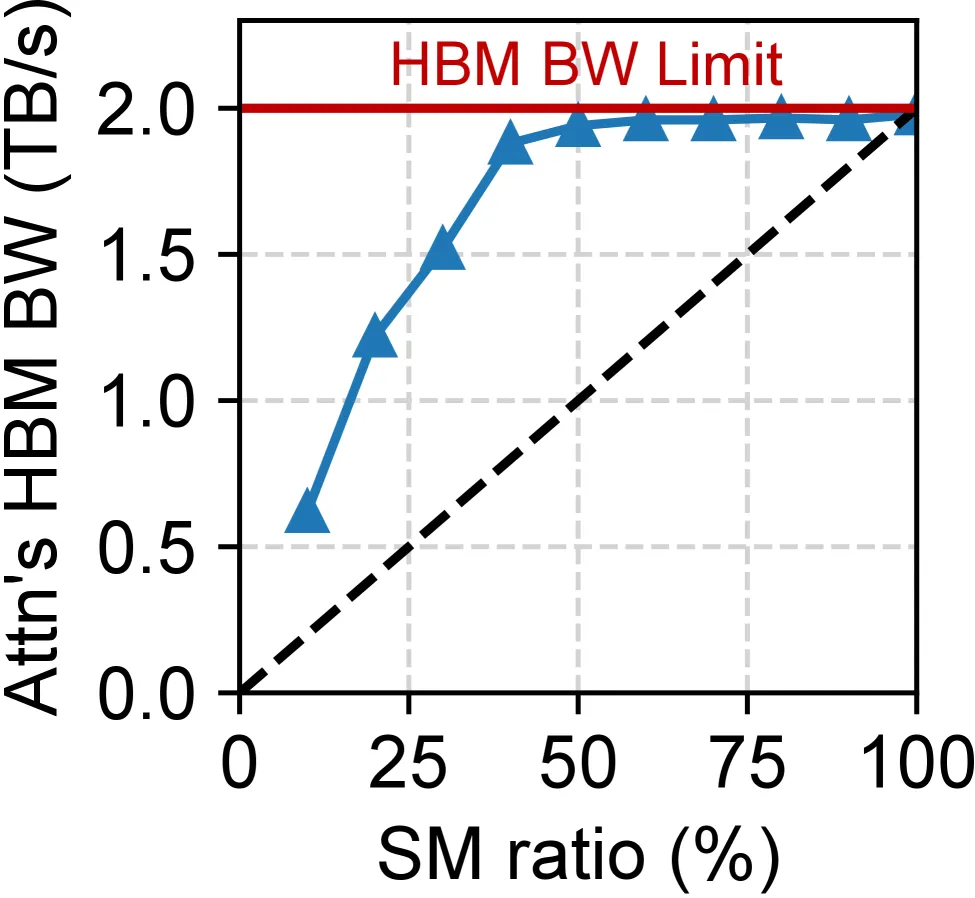
关键观察1: 随着SM数量增加,注意力计算的HBM带宽利用率超线性增长。
- 即使20%的SM也能达到A100 HBM带宽的60%
- 注意力核函数是内存绑定的,具有多级并行性(SM-parallel, warp-parallel, thread-parallel)
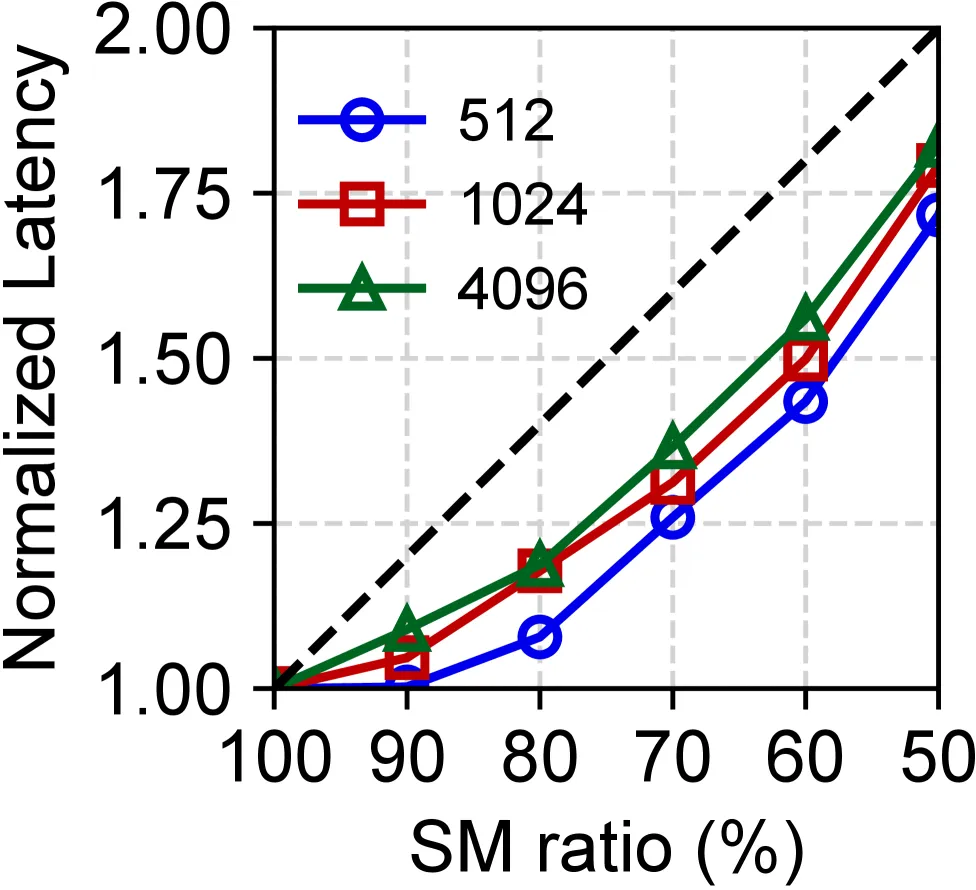
关键观察2: 随着SM数量减少,预填充延迟以亚线性水平增加。
- 预填充阶段的某些子步骤(请求路由、调度、KV缓存传输)不依赖GPU计算资源
- 可以通过限制SM比例来约束预填充性能下降
3.3.2 自适应资源分区
基于上述观察,Adrenaline采用基于SM比例的资源分区:
- 离线分析阶段: 使用kernel profiler测量不同SM比例下各种prompt长度的预填充延迟
- 在线服务阶段: 根据TTFT SLO和离线分析结果,计算最小SM比例,通过NVIDIA MPS约束后续预填充的计算资源
3.4 负载感知卸载调度 (Load-aware Offloading Scheduling)
两个核心问题:
- 能卸载多少解码注意力任务?(卸载比例上界)
- 给定理想卸载比例,如何动态判断是否需要对某个请求进行卸载?
3.4.1 卸载比例上界建模
其中为每个解码实例分配的预填充实例数,为预填充实例分配给注意力执行器的HBM容量/带宽。
对于非注意力核函数(FFN、QKV投影、输出投影),随着解码批处理大小增加,算术强度增加:
其中为隐藏状态大小(模型常量),为批处理大小。当非注意力核函数从计算绑定转变为内存绑定时,达到第二个上界:
最终上界:
3.4.2 负载感知
采用全局调度器(在proxy中)管理运行时元数据:
- 追踪解码阶段的活动请求数和对应序列长度
- 计算和
- 感知可用的预填充实例数量,动态更新
3.4.3 细粒度自适应调度
算法1: 负载感知卸载调度
输入: 新请求req, 卸载比例上界OB(n, B_max), 本地运行请求集LR, 已卸载请求集OR

need_offload ← 0
attn_max_tokens ← Σ_{r∈OR} r.max_token
attn_used_tokens ← Σ_{r∈OR} r.used_token
decode_used_tokens ← Σ_{r∈LR} r.used_token

// 条件C1: 新请求的最大token不会超出上界
if attn_used_tokens + req.max_token < decode_used_tokens × OB(n, B_max) then
    need_offload ← 1
// 条件C2: 新请求的已使用token不会超出上界,且卸载请求数不超过上限
else if (attn_used_tokens + req.used_token < decode_used_tokens × OB(n, B_max)) && (|OR| + 1 < |LR| × OB(n, B_max)) then
    need_offload ← 1

return need_offload核心原则: 仅在卸载比例不超过上界时才卸载请求。
四、核心创新 (Key Innovations)
| 创新点 | 说明 | 效果 |
|---|---|---|
| 注意力分离卸载 | 首次将解码阶段的注意力计算分离到预填充实例 | 提升预填充内存利用率2.28×,解码计算利用率1.67× |
| 二维CUDA图 | 解决动态批处理大小导致的CUDA图失效问题 | 消除CPU调度开销,每层节省0.76ms |
| SM比例自适应分区 | 基于超线性带宽/亚线性延迟的非线性关系 | 确保预填充性能隔离的同时最大化内存利用 |
| 全局负载感知调度 | Proxy管理运行时元数据,计算卸载比例上下界 | 动态适应工作负载波动 |
| 预填充+注意力共存 | 利用预填充实例的闲置HBM资源 | 无需额外硬件,提升整体系统效率 |
五、实验结果 (Experimental Results)
5.1 实验设置
| 配置项 | 详情 |
|---|---|
| 硬件 | 8× NVIDIA A100-80GB GPUs, 600 GB/s NVLink |
| 模型 | Llama-2 7B, Llama-2 13B (FP16) |
| 基线 | vLLM (支持PD分离的v6.3.0) |
| 工作负载 | ShareGPT (聊天场景), OpenThoughts (推理场景) |
| 指标 | TTFT, TPOT, P99 TPOT, 输出token吞吐 |
5.2 端到端性能
TTFT表现:
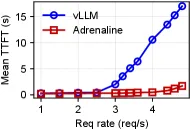
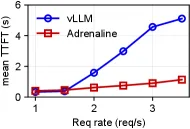
- 低请求率下: Adrenaline与vLLM的TTFT相近
- 高请求率下: vLLM的解码实例HBM耗尽,阻塞新解码请求,队列时间大幅增加
- ShareGPT + Llama-2 7B, 请求率=4时: vLLM的TTFT是Adrenaline的22倍
- Adrenaline通过卸载注意力任务增大解码批处理大小,缓解队列时间
TPOT表现:
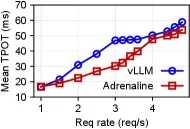
- 低请求率: Adrenaline利用预填充实例的空闲HBM带宽执行卸载注意力任务,聚合HBM带宽降低注意力执行时间
- 高请求率: 当解码实例HBM空间耗尽时,卸载注意力批处理大小受本地注意力计算时间限制,TPOT优势减弱
- Adrenaline缓解preemption/swapping的影响
输出吞吐:
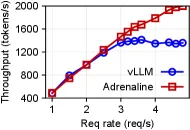
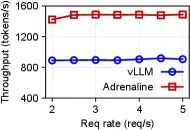
- Adrenaline整体实现更高的输出token吞吐
- 在稳定状态下(解码实例HBM饱和时)表现最佳
5.3 卸载比例选择

- 卸载比例过低: 未能充分利用预填充实例的闲置GPU内存资源
- 卸载比例过高: 注意力执行器运行时间长,无法被本地注意力完全重叠(如80%卸载性能低于70%)
- Adrenaline根据离线profile和工作负载模式自动找到拐点
5.4 资源利用率
HBM容量利用率:
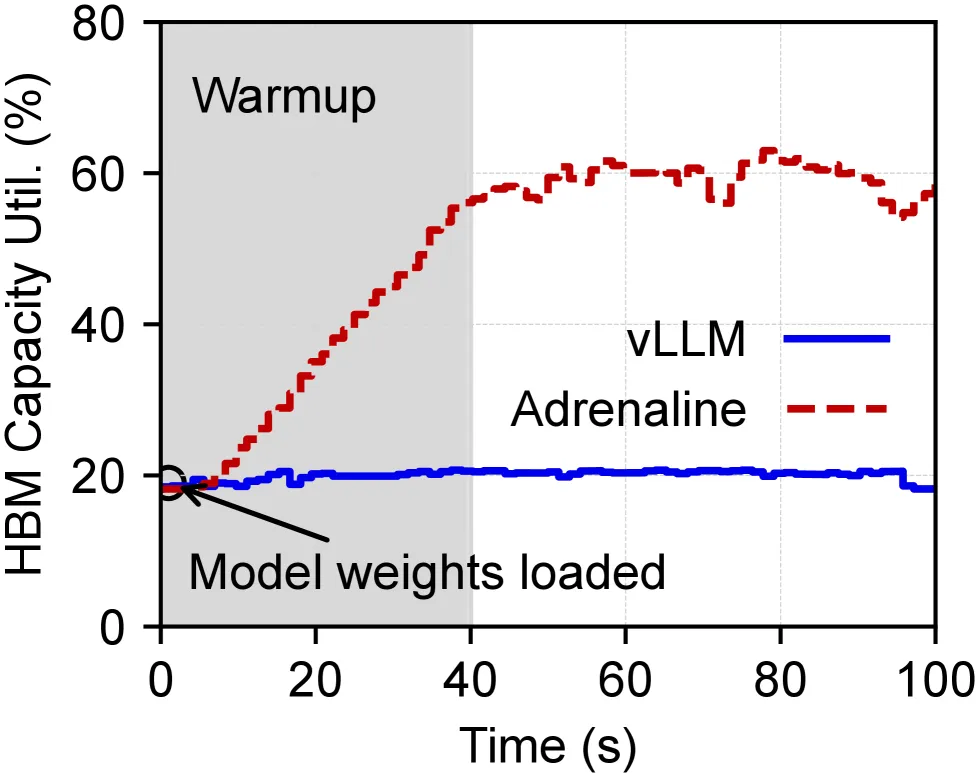
- vLLM预填充实例加载模型权重后HBM利用率约20%
- Adrenaline注意力执行器利用闲置HBM存储卸载注意力的KV缓存
- 预热后HBM利用率提升2.28×
HBM带宽利用率:

- Llama-2 7B预填充实例: 1.49× ~ 2.07× HBM带宽提升
- Llama-2 13B预填充实例: 1.37× ~ 1.93× HBM带宽提升
- 注意力执行器运行时平均获得3.76× HBM带宽(达到带宽容量限制的83.0%)
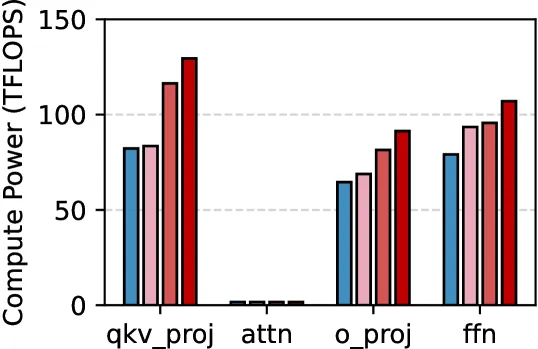
解码实例计算利用率:
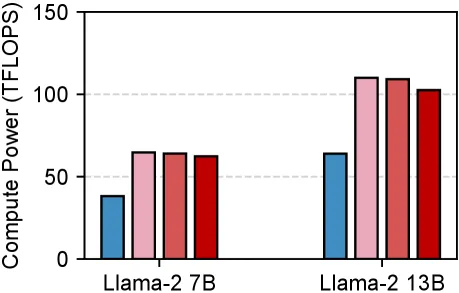
- 通过分离注意力计算,Adrenaline将解码批处理大小增加到原系统的2.25倍
- 非注意力核函数的计算利用率提升最高达1.67×

六、相关工作 (Related Work)
PD分离LLM推理
| 系统 | 关键思想 | 与Adrenaline区别 |
|---|---|---|
| DistServe | 分配预填充/解码到独立GPU | 未解决实例内资源利用不均衡 |
| Splitwise | 优化成本、吞吐和功耗 | 未解决资源利用率问题 |
| Mooncake | 利用CPU/DRAM/SSD实现 disaggregated KV cache pool | 需要额外硬件资源 |
注意力卸载
| 系统 | 关键思想 | 与Adrenaline区别 |
|---|---|---|
| Lamina | 将注意力从高端加速器卸载到消费级GPU | 需要额外硬件 |
| NEO | 将部分注意力和KV cache从GPU卸载到CPU | 需要CPU资源 |
| InstInfer | 利用计算存储设备(CSD)设计专用注意力引擎 | 需要CSD硬件 |
Adrenaline的独特性: 不依赖额外硬件资源,而是通过利用LLM服务系统内部的闲置资源来实现注意力卸载。
七、总结 (Conclusion)
7.1 核心成就
- 问题发现: 系统性揭示PD分离系统中的实例内资源利用不均衡
- 架构创新: 注意力分离与卸载机制,将解码注意力计算卸载到预填充实例
- 低延迟同步: 二维CUDA图 + 工作流编排,消除CPU调度开销
- 资源高效共存: 基于SM比例的自适应分区,确保性能隔离
- 负载感知调度: 全局调度器 + 上下界约束,动态适应工作负载
- 性能突破: 预填充内存利用率2.28×提升,解码计算利用率1.67×提升,整体吞吐1.68×提升
7.2 适用场景
- 已部署PD分离架构的LLM推理服务系统
- 预填充和解码实例存在资源利用不均衡的生产环境
- 需要在不增加硬件的情况下提升推理吞吐的服务提供商
- 工作负载具有动态批处理和可变序列长度的场景
7.3 局限性
- 当前基于vLLM实现,需要适配其他推理框架
- 依赖NVLink高速互联进行qkv传输,对网络带宽有要求
- 二维CUDA图的存储开销()需要权衡
- 未评估多模型多租户场景下的性能
- 注意力执行器与预填充共存时,极端情况下可能影响TTFT SLO
八、参考资源 (References)
论文链接
关键参考文献
| 编号 | 论文 | 关键贡献 |
|---|---|---|
| [DistServe] | Zhong et al. | PD分离推理系统 |
| [Splitwise] | Patel et al. | 优化PD分离的成本/吞吐/功耗 |
| [Mooncake] | Qin et al., 2024 | 利用CPU/DRAM/SSD实现disaggregated KV cache |
| [Lamina] | Chen et al., 2024 | 注意力操作卸载到消费级GPU |
| [NEO] | Jiang et al., 2024 | GPU到CPU的注意力卸载 |
| [InstInfer] | Pan et al., 2025 | CSD专用注意力计算引擎 |
| [vLLM] | Kwon et al., 2023 | 主流LLM推理框架,支持PD分离 |
| [MPS] | NVIDIA | Multi-Process Service资源隔离 |
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | 预填充/解码阶段工作流程 | figure-1a-prefill-phase.png, figure-1b-decoding-phase.png |
| Figure 2 | HBM利用率对比 | figure-2-hbm-utilization.png |
| Figure 3 | 解码注意力执行时间 | figure-3-decoding-attention-time.png |
| Figure 4 | PD分离 vs Adrenaline架构对比 | figure-4a-pd-disaggregation.png, figure-4b-adrenaline.png |
| Figure 5 | 预填充实例资源利用率 | figure-5a-compute-utilization-prefill.png, figure-5b-hbm-bandwidth-prefill.png |
| Figure 6 | 解码实例资源利用率 | figure-6a-compute-utilization-decode.png, figure-6b-hbm-bandwidth-decode.png |
| Figure 7 | Adrenaline架构总览 | figure-7-architecture-overview.png |
| Figure 8 | 带/不带卸载的解码流程对比 | figure-8a-original-decoding.png, figure-8b-offloading.png |
| Figure 9 | SM比例 vs 注意力HBM带宽 | figure-9-max-memory-bandwidth-sm-ratios.png |
| Figure 10 | SM比例 vs 预填充吞吐 | figure-10-normalized-prefill-throughput.png |
| Figure 11 | ShareGPT + Llama-2 7B 端到端性能 | figure-11a-d.png (TTFT/TPOT/P99/Throughput) |
| Figure 12 | OpenThoughts + Llama-2 7B 端到端性能 | figure-12a-d.png |
| Figure 13 | OpenThoughts + Llama-2 13B 端到端性能 | figure-13a-d.png |
| Figure 14 | ShareGPT + Llama-2 13B 端到端性能 | figure-14a-d.png |
| Figure 15 | 不同卸载比例的TTFT/TPOT/吞吐 | figure-15a-c.png |
| Figure 16 | 预填充实例HBM使用 | figure-16-hbm-use-prefill.png |
| Figure 17 | 资源利用率(HBM带宽 + 计算) | figure-17a-b.png |
| Figure 18 | 资源利用率分解 | figure-18a-b.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer