TileLink: Generating Efficient Compute-Communication Overlapping Kernels using Tile-Centric Primitives
基于Tile-Centric原语的编译器框架,高效生成计算-通信重叠内核
TileLink: 基于 Tile 中心原语生成高效计算-通信重叠核函数
论文信息: arXiv:2503.20313 [cs.DC]
一、论文概述
1.1 研究背景
大型深度学习模型在自然语言处理、视觉处理和推理等多个领域取得了最先进的性能。这些模型的庞大规模和巨大的计算需求使得分布式系统上的并行执行成为必需。在分布式模型执行中,层内并行算子(intra-layer parallel operators)是基本构建模块。
提升层内并行算子性能的最有效方法是计算与通信重叠(overlapping computation with communication)。然而,现有的两种主要方法都存在局限:
| 方法 | 优点 | 缺点 |
|---|---|---|
| 算子分解 (Operator Decomposition) | 实现简单,兼容现有框架 | 性能次优,需要主机干预同步,缓存利用率低 |
| 核函数融合 (Kernel Fusion) | 性能优异 | 需要高级硬件专业知识,开发困难且易出错 |
1.2 研究目标
本文提出 TileLink 框架,旨在通过编译技术实现高效的计算-通信重叠核函数的自动生成,在保持高性能的同时显著提升开发效率。
1.3 核心贡献
- Tile 中心原语:提出一套新的抽象原语,用于管理通信和计算之间的信号控制和数据传输
- 解耦设计空间:将通信和计算的设计空间解耦,允许独立优化
- Tile 中心映射:将前端原语编译为底层硬件指令的技术
- 高性能实现:在 8×H800 GPU 上实现 1.17× 到 20.76× 的加速
二、核心思想
2.1 问题本质
在分布式深度学习中,通信开销即使在配备高速互连的机器上也占总执行开销的相当比例。重叠通信与计算的核心思想是将通信和计算映射到不同的硬件单元,使它们能够并发执行。
2.2 现有方法的局限
算子分解方法:
- 将通信和计算核函数分解为更小的同质核函数
- 分解后的核函数可以分派到不同的流上
- 但同步需要主机干预,引入运行时开销
- 缓存利用率低,资源量化效率低
核函数融合方法:
- 将通信和计算核函数融合为一个核函数
- 通信映射到 DMA 引擎或处理核心
- 使用设备端屏障管理数据依赖
- 但需要高级硬件专业知识,开发困难
2.3 TileLink 的创新思路
TileLink 提出了一种编译驱动的方法:
前端原语 → Tile 中心映射 → 底层硬件指令
   ↓              ↓              ↓
抽象语义      形状/秩/通道映射    重叠执行
核心创新在于:
- 使用 Tile 中心原语 替代算子中心原语
- 解耦通信和计算的设计空间
- 通过编译自动将高层原语转换为高效底层代码
三、技术架构
3.1 整体架构
TileLink 由前端和后端两部分组成:
┌─────────────────────────────────────────────────────────────┐
│                        TileLink 框架                         │
├─────────────────────────────────────────────────────────────┤
│  前端 (Frontend)                                             │
│  ┌─────────────────┐  ┌─────────────────┐                   │
│  │  信号原语        │  │  数据原语        │                   │
│  │  (Signal)        │  │  (Data)          │                   │
│  └─────────────────┘  └─────────────────┘                   │
├─────────────────────────────────────────────────────────────┤
│  后端 (Backend)                                              │
│  ┌─────────────────────────────────────────────────────┐    │
│  │  Tile 中心映射 (Tile-Centric Mapping)                 │    │
│  │  ┌──────────┐  ┌──────────┐  ┌──────────┐          │    │
│  │  │ 形状映射  │  │ 秩映射    │  │ 通道映射  │          │    │
│  │  │ Shape    │  │ Rank     │  │ Channel   │          │    │
│  │  └──────────┘  └──────────┘  └──────────┘          │    │
│  └─────────────────────────────────────────────────────┘    │
│  ┌─────────────────────────────────────────────────────┐    │
│  │  编译优化                                              │    │
│  │  • 内存一致性  • 资源映射  • 循环优化                    │    │
│  └─────────────────────────────────────────────────────┘    │
└─────────────────────────────────────────────────────────────┘
3.2 前端原语
TileLink 提供两类原语:
信号原语 (Signal Primitives)
| 原语 | 说明 |
|---|---|
producer_tile_notify(tile_id, mode) | 标记生产者 tile 完成并通知消费者 |
consumer_tile_wait(tile_id) | 消费者 tile 阻塞直到所有依赖的生产者完成 |
peer_tile_notify(tile_id, rank) | 标记当前 tile 完成并通知其他秩的 peer tile |
peer_tile_wait(tile_id, rank) | 阻塞直到其他秩的 peer tile 完成 |
rank_notify(tile_id, rank) | 通知另一个秩指定 tile 的数据已就绪 |
rank_wait(rank) | 阻塞当前秩直到另一个秩完成 |
数据原语 (Data Primitives)
| 原语 | 说明 |
|---|---|
tile_push_data(tensors, tile_id, data) | 发送一个 tile 的数据到远程张量 |
tile_pull_data(tensors, tile_id) | 从远程张量加载一个 tile 的数据 |
rank_copy_data(src, dst) | 从源秩复制数据到目标秩 |
3.3 解耦设计空间
TileLink 将设计空间分为三个子空间:
- Tile 大小子空间:通信和计算可以选择不同的 tile 大小
- Tile 顺序子空间:通信和计算可以选择不同的 tile 处理顺序
- 资源绑定子空间:通信和计算可以映射到相同或不同的硬件单元
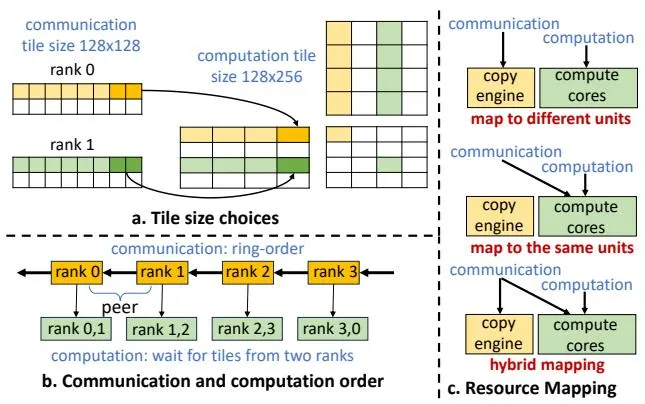 图 2:通信和计算的三个设计子空间示例
四、核心创新
4.1 Tile 中心映射
TileLink 使用三种映射将前端原语编译为底层代码:
- 形状映射 (Shape Mapping):将
tile_id映射到具体的张量形状切片 - 秩映射 (Rank Mapping):将
tile_id映射到设备秩 - 通道映射 (Channel Mapping):将
tile_id映射到通信屏障
映射可以是:
- 静态映射:在编译时通过仿射变换确定
- 动态映射:在运行时动态计算
4.2 内存一致性编译
TileLink 的信号原语提供严格的内存一致性语义:
- Notify 原语携带 release 语义:确保 notify 之前的内存访问不会在其之后执行
- Wait 原语携带 acquire 语义:确保 wait 之后的内存访问不会在其之前执行
4.3 Pull 与 Push 模式
TileLink 支持两种数据传输模式:
| 模式 | 工作方式 | 适用场景 |
|---|---|---|
| Pull 模式 | 生产者从所有其他秩读取数据,使用本地屏障通知消费者 | 数据形状和分片策略固定 |
| Push 模式 | 生产者将本地数据写入所有其他秩,远程通知消费者 | 需要灵活的数据分发 |
4.4 编程效率提升
与 FLUX 库的对比:
| 指标 | FLUX | TileLink |
|---|---|---|
| 代码量 | ~2000 行 CUDA 代码 | ~200 行 Python 代码 |
| 编程效率 | 基准 | 10× 提升 |
| 性能 | 基准 | 相当或更优 |
五、实验结果
5.1 实验设置
- 硬件: 8×H800 GPU 集群
- 基准测试: MLP 层、MoE 层、自注意力层
- 基线方法:
- Non-Overlap: cuBLAS + NCCL
- Decomposition: Async-TP PyTorch
- Fusion: FLUX 库
5.2 MLP 层性能
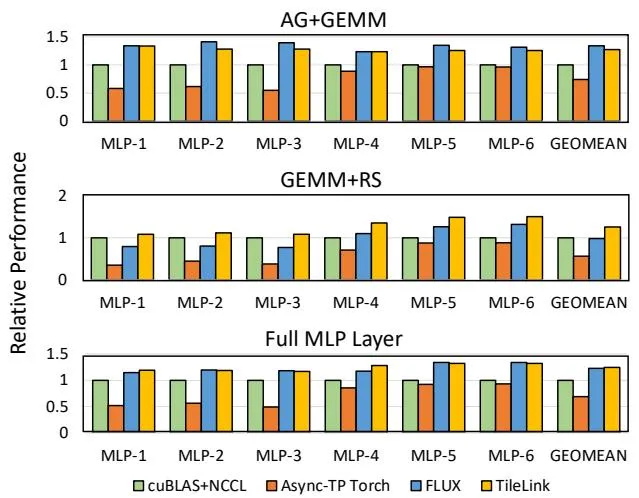 图 8:MLP 层在 8×H800 上的性能结果
| 部分 | TileLink vs cuBLAS+NCCL | TileLink vs Async-TP | TileLink vs FLUX |
|---|---|---|---|
| AG + GEMM | 1.27× | - | 94.5% |
| GEMM + RS | 1.25× | 2.22× | 1.28× |
| 完整 MLP | 1.24× | - | 101.4% |
关键发现:
- TileLink 在 GEMM + ReduceScatter 部分取得最佳性能
- 解耦设计空间使各部分能找到最优优化
- 整体 MLP 性能达到 FLUX 的 101.4%
5.3 MoE 层性能
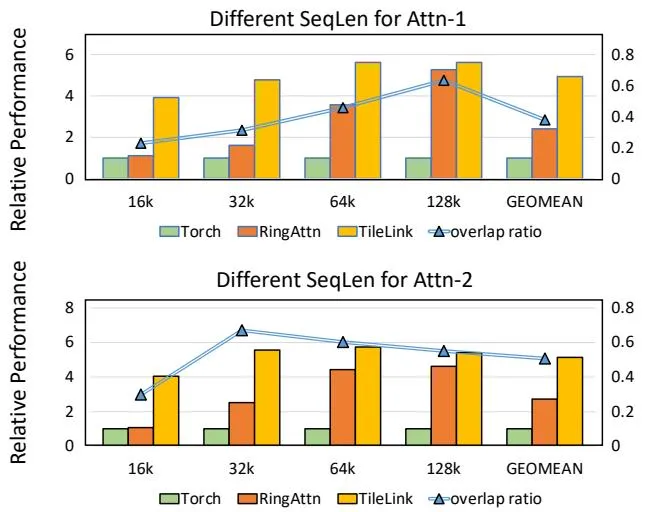 图 9:MoE 层在 8×H800 上的性能结果
| 部分 | TileLink vs vLLM | TileLink vs CUTLASS+NCCL |
|---|---|---|
| AG + Gather + GroupGEMM | 1.51× | - |
| GroupGEMM + Scatter + Topk Reduce + RS | 1.31× | 10.56× |
| 完整 MoE | 1.14× | 最高 20.76× |
关键发现:
- 现有库(FLUX、Async-TP PyTorch)不支持 MoE 层重叠
- TileLink 的灵活原语和动态映射支持 MoE
- 最大加速比达到 20.76×
5.4 自注意力层性能
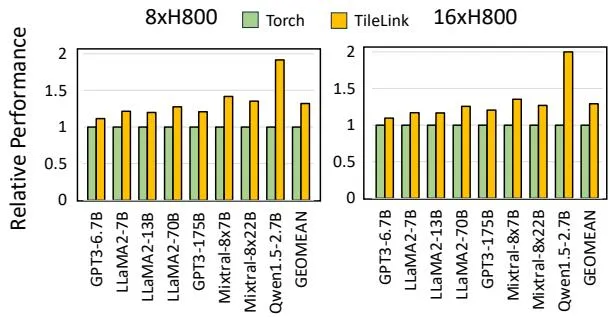 图 10:自注意力层在 8×H800 上的性能结果和重叠比率
| 指标 | 结果 |
|---|---|
| vs PyTorch (Torch) | 5.04× 加速 |
| vs RingAttention | 1.97× 加速 |
| 平均重叠比率 | 43.9% |
关键发现:
- 在不同序列长度(16k 到 128k)上均有一致加速
- 有效隐藏了 43.9% 的通信开销
5.5 端到端性能
图 11:端到端模型在 8×H800 和 16×H800 上的性能结果
| 配置 | 平均加速比 | 密度模型 | MoE 模型 |
|---|---|---|---|
| 8×H800 (单节点) | 1.32× | 1.20× | 1.54× |
| 16×H800 (双节点) | 1.29× | - | - |
测试的 8 个 LLM 模型:
- 密度模型:5 个
- MoE 模型:3 个(包括 Qwen1.5 共享专家支持)
六、相关工作
6.1 基于分解的重叠方法
| 方法 | 特点 |
|---|---|
| Dist-Einsum | 在 Google TPU 上实现 MLP 层重叠 |
| Async-TP PyTorch | 提供 AllGather GEMM 和 GEMM ReduceScatter 的重叠实现 |
| Centauri | 系统探索模型、层、操作三级设计空间 |
共同特点:
- 快速开发,兼容现有框架
- 但性能受限于分解带来的开销
6.2 基于融合的重叠方法
| 方法 | 特点 |
|---|---|
| CoCoNet | 首次提出融合 CUTLASS GEMM 与 NCCL 核函数 |
| FLUX | 在 A100 和 H800 上实现高性能重叠核函数 |
| AMD Fusion Library | 在 AMD GPU 上实现各种重叠核函数 |
共同特点:
- 性能优异
- 但开发周期长,缺乏高层可编程原语
6.3 重叠编译器
| 方法 | 特点 |
|---|---|
| CoCoNet | 编译高层算子到底层 CUTLASS/NCCL 调用 |
| Dist-Einsum | 通过分解和同步编译 DNN 图 |
| Pallas | 分布式编译器,目前仅支持 Google TPU |
TileLink 的优势:
- 提供灵活的 Tile 中心原语
- 自动编译为设备代码
- 支持广泛的 GPU 工作负载
6.4 特性对比
| 特性 | CoCoNet | Dist-Einsum | Centauri | Async-Torch | TileLink |
|---|---|---|---|---|---|
| 编译 | ✓ | ✓ | ✓ | ✗ | ✓ |
| 融合方法 | Fusion | Decompose | Decompose+Fusion | Decompose | Fusion |
| 原语类型 | - | operator-centric | operator-centric | operator-centric | tile-centric |
七、总结
7.1 主要贡献
- Tile 中心原语:提出了一套新的抽象原语,用于管理分布式计算中的通信和计算同步
- 解耦设计空间:允许通信和计算独立优化,找到各自的最优配置
- 高效编译:通过 Tile 中心映射自动将高层原语编译为高效底层代码
- 广泛适用性:支持 MLP、MoE、自注意力等多种工作负载
- 编程效率:相比 FLUX 实现 10× 的代码量减少
7.2 性能总结
| 场景 | 加速比 |
|---|---|
| 单层 MLP | 1.24× vs cuBLAS+NCCL |
| 单层 MoE | 最高 20.76× vs cuBLAS+NCCL |
| 自注意力 | 5.04× vs PyTorch, 1.97× vs RingAttention |
| 端到端 (8 GPU) | 1.32× vs PyTorch |
| 端到端 (16 GPU) | 1.29× vs PyTorch |
7.3 局限性与未来方向
- 硬件支持:目前仅针对 NVIDIA GPU,可通过扩展底层编译器支持更多硬件
- 模型级并行:可扩展支持流水线并行等模型级并行
- 更多工作负载:可应用于更多类型的分布式计算场景
八、参考资源
8.1 论文链接
- arXiv: https://arxiv.org/abs/2503.20313
- PDF: https://arxiv.org/pdf/2503.20313
- HTML: https://arxiv.org/html/2503.20313v1
8.2 代码资源
8.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 层内并行 FFN 示例 | figures/2503.20313-tilelink/figure-1-intra-layer-parallel.jpg |
| 图 2 | 设计子空间示例 | figures/2503.20313-tilelink/figure-2-design-spaces.jpg |
| 图 3 | Tile 中心原语 | figures/2503.20313-tilelink/figure-3-tile-centric-primitives.jpg |
| 图 7 | 编译和运行时 | figures/2503.20313-tilelink/figure-7-compilation-runtime.jpg |
| 图 8 | MLP 性能结果 | figures/2503.20313-tilelink/figure-8-mlp-performance.jpg |
| 图 9 | MoE 性能结果 | figures/2503.20313-tilelink/figure-9-moe-performance.jpg |
| 图 11 | 端到端性能 | figures/2503.20313-tilelink/figure-11-end-to-end-performance.jpg |
8.4 相关论文
- FLUX - Fast software-based communication overlap on GPUs through kernel fusion (Chang et al., 2024)
- Centauri - Enabling efficient scheduling for communication-computation overlap (Chen et al., 2024)
- CoCoNet - Fusing CUTLASS GEMM with NCCL kernels
- RingAttention - Ring attention for sequence parallel self-attention
- Dist-Einsum - Overlapping kernels for MLP layers on Google TPUs
8.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 层内并行 | Intra-layer Parallelism | 在同一层内的并行计算 |
| 算子分解 | Operator Decomposition | 将大算子分解为小算子 |
| 核函数融合 | Kernel Fusion | 将多个核函数融合为一个 |
| Tile 中心原语 | Tile-Centric Primitives | 以 Tile 为粒度的抽象原语 |
| 形状映射 | Shape Mapping | 将 tile_id 映射到张量形状 |
| 秩映射 | Rank Mapping | 将 tile_id 映射到设备秩 |
| 通道映射 | Channel Mapping | 将 tile_id 映射到通信屏障 |
| 内存一致性 | Memory Consistency | 多进程间内存访问顺序的约束 |
本文档基于 arXiv:2503.20313v3 生成,最后更新于 2025-04-03