PyGraph: Robust Compiler Support for CUDA Graphs in PyTorch
针对 PyTorch 中 CUDA Graph 部署困难的编译器框架。提出三项优化:CGCT(自动代码变换使 ML 程序兼容 CUDA Graph)、PI(参数间接寻址将数据拷贝转为指针拷贝,最高减少 99% 拷贝量)、SCG(基于成本效益分析的有选择部署)。在 25 个 ML 工作负载上,PyGraph 比 PyTorch2-CG 平均提速 29%,最高 3.36×,且在分布式 Tensor Parallelism 下表现更强。
PyGraph: Robust Compiler Support for CUDA Graphs in PyTorch
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | PyGraph: Robust Compiler Support for CUDA Graphs in PyTorch |
| 作者 | Abhishek Ghosh, Ajay Nayak, Ashish Panwar, Arkaprava Basu |
| 机构 | (印度)印度理工学院德里分校 IIT Delhi |
| 论文 | arXiv 2503.19779(v3) |
| 代码 | 无(编译器研究论文) |
| 发布 | 2025-03-25 |
| 学科 | Machine Learning (cs.LG) |
| 定位 | 首个针对 PyTorch 中 CUDA Graph 部署问题的编译器框架 |
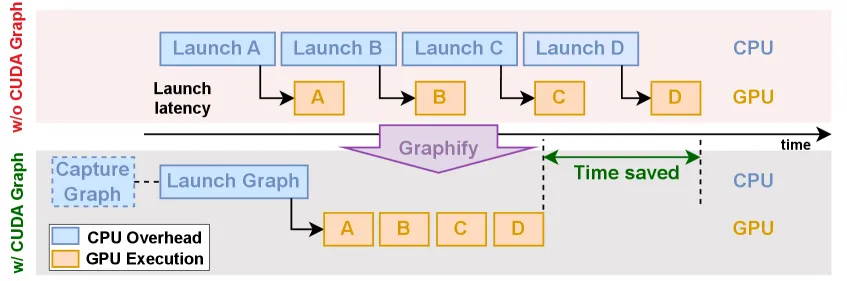
二、核心思想
问题定义
现代 GPU 计算吞吐量飞速增长(A100 FP16 312 TFLOP/s → H100 ≈1 PFLOP/s → B200 ≈4 PFLOP/s),但 CPU 频率停滞、核心数仅翻倍。ML 应用每迭代启动数百到数千个短 GPU kernel,每个 kernel 从 CPU 启动增加 5-10 μs 延迟。GPU 执行完 kernel 后等待 CPU 提交下一个,导致 GPU 利用率通常低于 50%(Alibaba/Azure 报告)。分布式 ML(特别是 Tensor Parallelism)使每个 kernel 更快但引入更多 collective kernel 启动,进一步放大此问题。
CUDA Graphs 的潜力与困境
CUDA Graph 允许将 kernel 启动捕获为有向无环图(DAG),CPU 只需启动图一次,GPU 硬件内部调度 constituent kernels。但部署困难:
- 参数在 capture 时被硬编码为值,replay 时需处理可变参数
- 禁止同步操作(cudaMemcpy、cudaMalloc 等)
- 高语义距离:PyTorch 程序与硬件执行之间差距大
解决方案:PyGraph
PyGraph 构建于 PyTorch2 编译框架之上,无需程序员干预,通过三项核心优化解决上述问题:
- CUDA Graph-aware Code Transformation (CGCT):自动代码变换使 ML 程序兼容 CUDA Graph
- Parameter Indirection (PI):消除 kernel 参数拷贝开销,将数据拷贝转为指针拷贝
- Selective CUDA Graphs (SCG):基于成本效益分析有选择地部署 CUDA Graph
三、技术架构
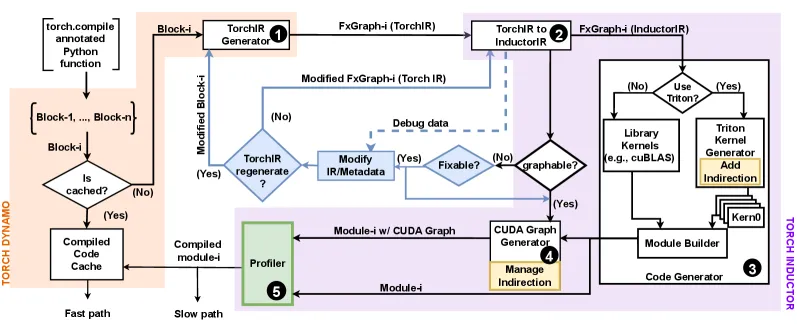
PyTorch2 编译流水线与 PyGraph 扩展
┌─────────────────────────────────────────────────────────────────┐
│  PyTorch2 编译流水线 (Slow Path → Fast Path)                     │
│                                                                 │
│  Layer 1: Computation Graph Construction (Torch Dynamo)         │
│    → PyGraph 扩展: 从修改后的代码块重新生成 TorchIR             │
│         [CGCT: 字节码重写将 scalar 转为 GPU tensor]             │
│                                                                 │
│  Layer 2: IR Lowering & Optimization (Torch Inductor)           │
│    → PyGraph 扩展: 增强 CG 资格判定                             │
│         [CGCT: 回溯 InductorIR → 修改设备放置/输出元数据]       │
│                                                                 │
│  Layer 3: Kernel Generation (Triton / Vendor Libraries)         │
│    → PyGraph 扩展: 参数间接寻址                                 │
│         [PI-JIT: LLVM pass 重写 PTX 为 pointer-to-pointer]      │
│         [PI-Vendor: 插入 prelude kernel + NVRTC 编译]           │
│                                                                 │
│  Layer 4: Graph Capture                                         │
│    → PyGraph 扩展: 为指针分配静态占位符 + 注入 pointer copy     │
│         [PI-Graph: 分配 pointer 占位符而非 data 占位符]          │
│                                                                 │
│  Profiler (SCG): 编译阶段测量 3 种配置的执行时间,缓存最佳模块   │
│    [CG无 / CG+无PI / CG+有PI]                                   │
└─────────────────────────────────────────────────────────────────┘
三项优化详解
1. CUDA Graph-aware Code Transformation (CGCT)
问题: 许多 ML 程序因以下原因无法部署 CUDA Graph:
- CPU 内存中的 tensor 在 replay 前可能被 GC 释放 → 崩溃
- CPU-resident scalar 参数在 replay 时得到过时值 → 错误结果
方法:
- 分析 InductorIR 找出 CG capture 失败的根因
- Scalar 变量: 通过字节码重写将其类型从 CPU scalar 改为 GPU tensor
- CPU-to-GPU memcopy: 使用 debug 元数据回溯到拥有该 CPU tensor 的 Python 对象,将其移动到 GPU,hoist memcopy 到 graph capture 路径之前
- CPU tensor 输出: 更新 TorchIR 元数据标记为 GPU tensor
效果: 使大量原本被排除的 kernel 可被捕获。例如 XLNET-I 的 413 个 kernel 从 0% CG 覆盖 → 99.28%。
2. Parameter Indirection (PI)
核心洞察: 如果 kernel 能从新数据 tensor 读取——不同于 capture 时的数据——CG 执行仍然正确,无需拷贝参数数据本身。
方法: 将 kernel 参数从 pointer 变为 pointer-to-pointer:
Baseline (PyTorch2-CG):
  Capture: 记录参数地址 x (指向数据区域)
  Replay:  将新数据从地址 y 拷贝到 x 指向的位置 [可能数千字节]

PyGraph (PI):
  Capture: 记录 pointer-to-pointer px (指向指针 y)
  Replay:  将指针 y 拷贝到 px 指向的位置 [仅 8 字节]
Kernel: 解引用 pointer-to-pointer 访问实际数据两种实现方式:
(a) JIT 编译内核 (Triton):
- PyGraph 在代码生成阶段识别需间接寻址的参数
- 自定义 LLVM pass 集成到 Triton 框架
- 重写 PTX 代码:更新 kernel 签名为 pointer-to-pointer 参数
- 在 kernel 开头插入 PTX 指令解引用指针后再用于计算
- 其余 kernel 代码不变
(b) 供应商内核 (cuBLAS/cuDNN/CUTLASS):
- 这些内核是编译二进制,无法修改
- 在 CUDA Graph 开头插入 prelude kernel
- Prelude kernel 使用 CUDA 12.4 新 API
cudaGraphKernelNodeSetParam在 replay 时更新 vendor kernel 的参数 - 使用
cuFuncGetParamInfo获取 kernel 参数缓冲区句柄 - 通过 byte-pattern match 识别占位符指针的正确偏移量
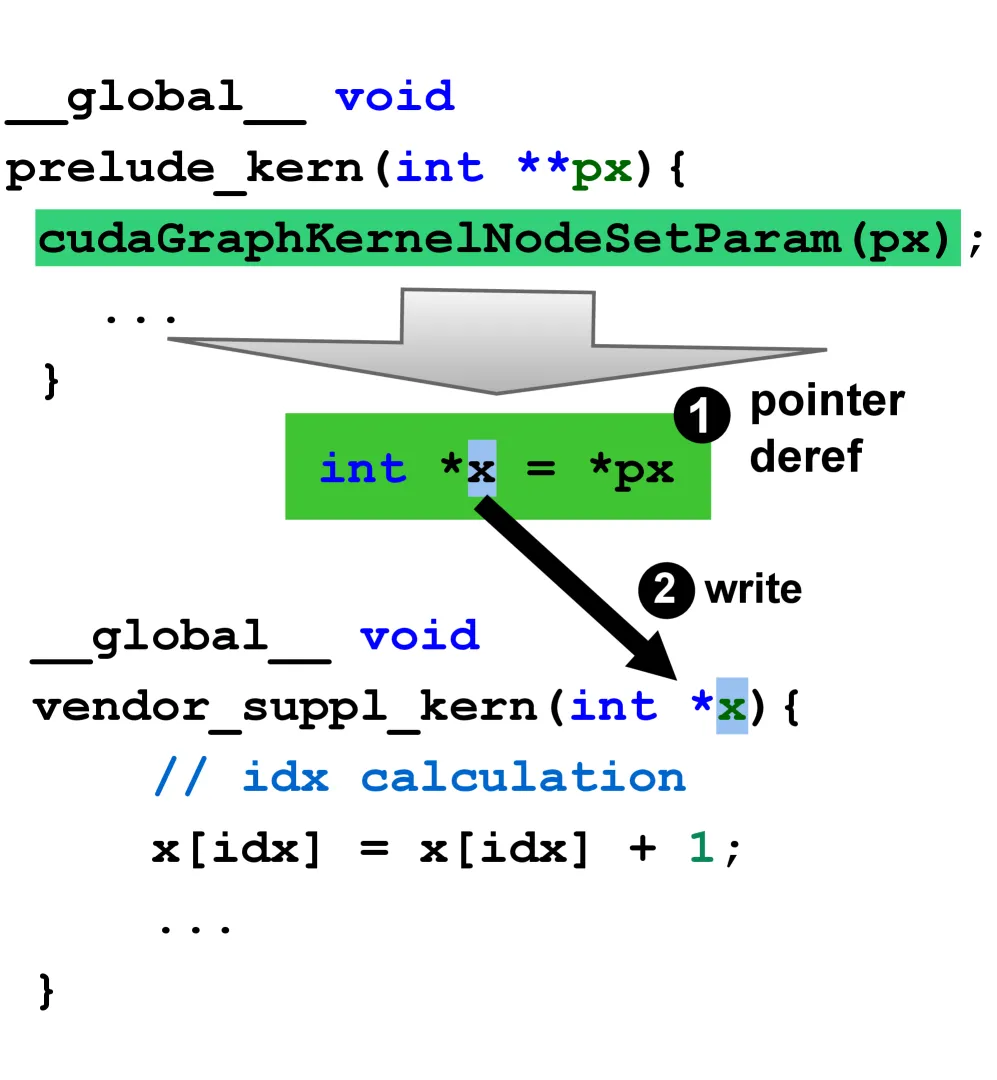
性能对比: JIT kernel rewrite 明显快于 prelude kernel(后者在高参数计数时超过 10 μs),因此优先使用 JIT 方式,仅对 vendor 内核回退到 prelude。
3. Selective CUDA Graphs (SCG)
问题: 即使 CG 可以部署,也不一定总是有益——参数拷贝、垃圾回收、GPU RNG 重置等开销可能超过收益。
方法: 在编译阶段(slow path)进行自动化性能剖析:
- 测量 CG 中 encapsulated kernels 的总执行时间
- 分别测量带/不带 PI 的 CG 执行时间
- 考虑三种配置:无 CG / CG 无 PI / CG 有 PI
- 缓存最佳性能的模块
为什么区分 CG 有/无 PI? PI 将 D2D(设备到设备)数据拷贝转为 H2D(主机到设备)指针拷贝。对于小对象,PCIe 传输指针的开销可能超过 GPU HBM 内拷贝数据的开销。Profiler 能识别此类情况。
结果: PyGraph 在 25 个工作负载中有 5 个选择性禁用了 CG。例如 VM 暴露 21 个候选 CG,但仅启用 4 个、禁用 17 个以提升端到端性能 6%。总体启用了 123 个可能 CG 中的 97 个。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| CGCT | 自动 IR 级代码变换使 ML 程序兼容 CUDA Graph | XLNET-I 从 0% → 99.28% CG 覆盖;ST 从 5.14% → 74.22% |
| Parameter Indirection | 两级间接寻址:JIT kernel 重写 + prelude kernel | 拷贝量从 GB 级降至 <1KB(>99% 减少);TKE 提速 23% |
| Selective CG | 编译期 cost-benefit profiler 指导有选择部署 | 25% 的 CG 损害性能(最高 397%);PyTorch2-CG 盲目部署 |
| 零程序员干预 | 所有变换在编译器层透明完成 | 构建于 PyTorch2 之上,无需修改任何 PyTorch 程序 |
五、实验结果
评测环境
- GPU: NVIDIA H100 NVL (94GB HBM3) + Intel Xeon 8462Y+ (64核) + 512GB DDR5
- 软件: PyTorch 2.4, CUDA 12.8, cuDNN 8.9.2, driver 575.57.08
- 多GPU: 4×80GB H100 via NVLink (CUDA 12.4)
- A6000: 工作站级 GPU 额外评估
- 基准: TorchBench (8) + HuggingFace (10) + TIMM (1) = 25 个工作负载
- 指标: 单次迭代运行时(推理=前向,训练=前向+反向),100 次运行平均
端到端性能
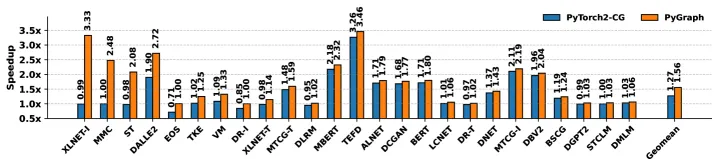
| 指标 | 数值 |
|---|---|
| PyGraph vs PyTorch2-CG 几何平均加速 | 29% |
| PyGraph vs PyTorch2-CG 最大加速 | 3.36× (XLNET-inference) |
| PyGraph vs PyTorch2-No-CG 最大加速 | 3.36× (XLNET-I) |
| 分布式 TP 平均加速 (vs No-CG) | 75% (最高 3.56×) |
关键案例:
- XLNET-I: PyTorch2-CG 完全无法部署任何 CG(413 个 kernel 因单个 CPU tensor 被排除),PyGraph 部署全部 413 个 → 3.17× 加速
- DALLE2: PyTorch2-CG 1.9× → PyGraph 2.72×
- Speech Transformer: 2.28× 加速
- EOS: 盲目部署 CG 导致 29% 降级,SCG 禁用后避免回归
消融实验
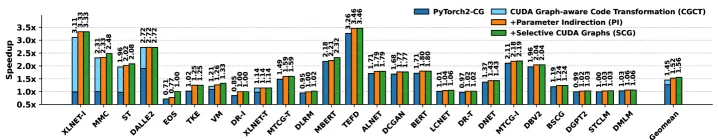
三项优化各自贡献:
- CGCT 单独: XLNET-I 3.14×、MMC 2.31×、ST 2× over PyTorch2-CG
- +PI: TKE +23%、DR-I +18%、12 个工作负载 >4% 提升
- +SCG: 避免性能退化,VM 整体 +6%
参数拷贝减少 (Table 3):
| 应用 | 拷贝量减少 | CG 数量 |
|---|---|---|
| MTCG-T | 1.0 GB → 312 B | 3 |
| DGPT2 | 953 MB → 136 B | 3 |
| STCLM | 850 MB → 136 B | 14 |
| BSCG | 1.6 GB → 56 B | 30 |
| DR-I | 3.0 GB → 8 B | 1 |
几乎所有工作负载拷贝量减少 >99%,最大剩余拷贝仅 336 B。
分布式 ML 模型评估
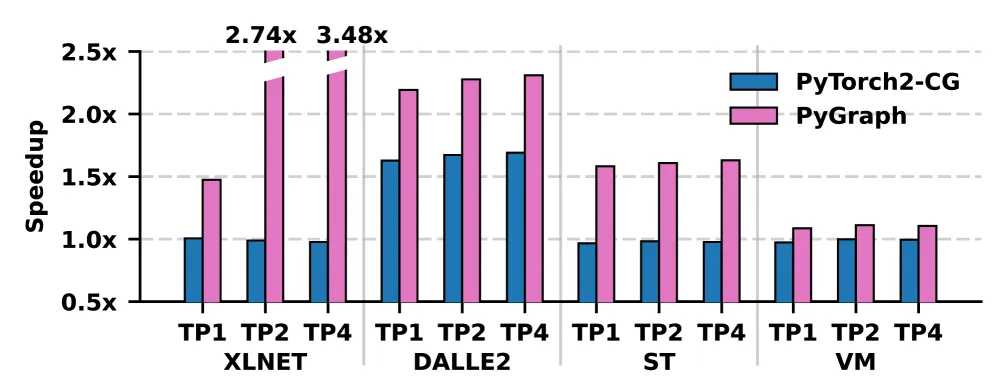
- TP 度增加 → GPU kernel 更快 → CPU 启动延迟占比更大 → CG 重要性增加
- XLNET 在 TP-4: PyGraph 加速达 3.48× over PyTorch2-No-CG
- 平均 across TP=1,2,4: 2.41× (XLNET)
- 增益随并行度递增:PyTorch2-CG 在高 TP 下表现更差(未能充分利用 CG)
A6000 评估与编译时间
- A6000: PyTorch2-CG 对 EOS 降级 32%,PyGraph 从不降级,最大改善 3.25×,平均 1.18×
- 编译时间: PyGraph 增加 1.6×(如 ST: 15s→37s, DALLE2: 96s→185s),但这是 slow path 一次性开销,被 fast path 持续收益轻松覆盖
六、与现有方法对比
| 方法 | CG 覆盖率 | 参数拷贝 | 选择性部署 | 程序员干预 |
|---|---|---|---|---|
| PyTorch2-No-CG | N/A | N/A | N/A | 无 |
| PyTorch2-CG | 低(排斥 CPU tensor/scalar) | 全数据拷贝 | 无(盲目部署) | 无 |
| PyGraph | 高(CGCT 自动修复) | 指针拷贝(PI) | 有(SCG profiler) | 无 |
| Grape | 需手动 kernel 编辑 | 未知 | 未知 | 需要(>400 行手动修改) |
七、相关工作
- ML 编译器: TensorFlow/Caffe/Theano/CNTK(图级优化)→ PyTorch2/JAX/XLA(丰富 IR)→ 多级别超优化。PyGraph 补充它们,专注于减少 CPU 启动开销。
- PyTorch2: Torch Dynamo(字节码重写 → FxGraph)+ Torch Inductor(降为优化 GPU kernel)。PyGraph 扩展两者,不绑定于 PyTorch2 管线。
- CUDA Graphs: Grape(需手动 kernel 修改 + 与 PyTorch2 不兼容)、serverless LLM 推理(图持久化)。PyGraph 更通用、更透明。
八、总结
核心贡献
- 发现并量化了 CUDA Graph 部署的三大障碍: CG 不兼容程序、参数拷贝开销、CG 可能损害性能
- 提出 CGCT: 自动 IR 级代码变换,将 CG 覆盖率从 0% 提升到 >99%
- 提出 Parameter Indirection: 两级实现(JIT kernel 重写 + prelude kernel),将参数拷贝减少 >99%
- 提出 SCG: 编译期 cost-benefit profiler,避免 25% 有害 CG 的部署
- 构建 PyGraph: 集成于 PyTorch2,零程序员干预,25 个工作负载平均提速 29%,最高 3.36×
- 分布式扩展: 在 Tensor Parallelism 下表现更强,TP-4 时 XLNET 加速 3.48×
局限性
- 编译时间增加 1.6×(slow path,可接受)
- PI 对极小 tensor 可能不利(PCIe 指针拷贝开销 > HBM 数据拷贝收益)
- 预编译器 kernel 方式在高参数计数时 >10 μs,慢于 JIT 重写
未来方向
- 将 PyGraph 扩展到 JAX/XLA 等其他编译框架
- 探索更细粒度的 cost model 以优化 PI 的适用场景
- 结合 source-level graph-repair 技术进一步延长计算图
九、参考资源
- arXiv 论文: https://arxiv.org/abs/2503.19779
- 图片索引:
figures/2503.19779-pygraph-cuda-graphs-pytorch/README.md