pytorch cuda-graphs compiler gpu-optimization kernel-launch parameter-indirection code-transformation
PyGraph: Robust Compiler Support for CUDA Graphs in PyTorch
Compiler Framework to Maximize CUDA Graph Coverage and Benefits
PyGraph: Robust Compiler Support for CUDA Graphs in PyTorch
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | PyGraph: Robust Compiler Support for CUDA Graphs in PyTorch |
| 作者 | Abhishek Ghosh, Ajay Nayak, Ashish Panwar, Arkaprava Basu |
| 机构 | Indian Institute of Science (IISc) |
| 论文 | arXiv:2503.19779 |
| 代码 | 无公开代码 |
| 发布 | 2025-03-25 (v3: 2025-12-22) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
ML 工作负载每迭代启动数百到数千个短运行 GPU 内核。随着 GPU 计算吞吐量快速增长,CPU 端内核启动延迟成为瓶颈。CUDA Graphs 通过单次图分发重放一组内核来消除逐内核启动成本,但在实际部署中面临三个核心问题:
- 覆盖不足:许多 ML 应用因 CPU 驻留标量/张量、同步内存拷贝等构造无法被捕获到 CUDA Graph 中
- 重放开销:参数拷贝(将数据复制到图捕获时的占位符)主导重放时间(约 50%)
- 盲目部署:25% 的 CUDA Graph 实际损害性能(最差情况 29% 回退)
解决方案概述
PyGraph 是一个编译器框架,通过三项优化最大化 CUDA Graph 的覆盖和收益:
- CUDA Graph-aware Code Transformation (CGCT):自动代码转换使 ML 应用兼容 CG 捕获
- Parameter Indirection (PI):消除参数拷贝开销,仅更新指针(8 字节)而非数据(数千字节)
- Selective CUDA Graphs (SCG):基于成本-收益分析选择性部署 CG
三、技术架构
整体框架图
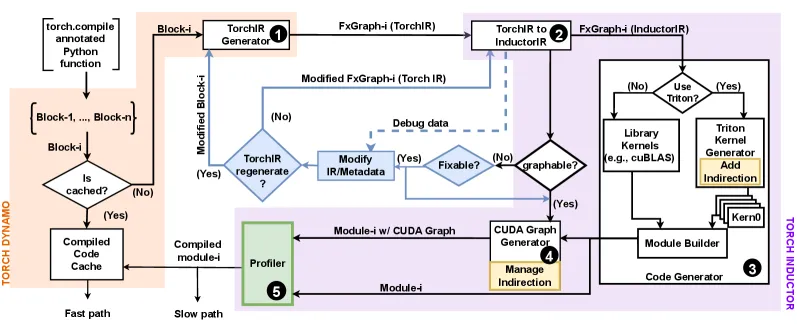
PyGraph 集成在 PyTorch2 编译管线中:
- TorchDynamo 捕获 FxGraph
- CGCT 分析并转换不兼容代码
- PI 重写内核参数传递
- SCG 通过 profiling 选择最优配置
- TorchInductor 生成优化内核
问题分析
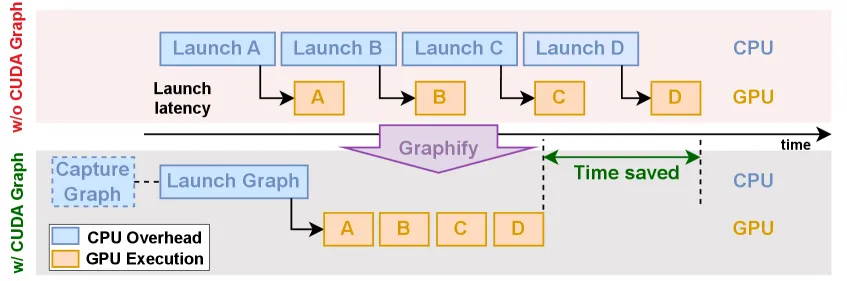
CUDA Graph 通过单次分发重放减少 CPU 启动开销。
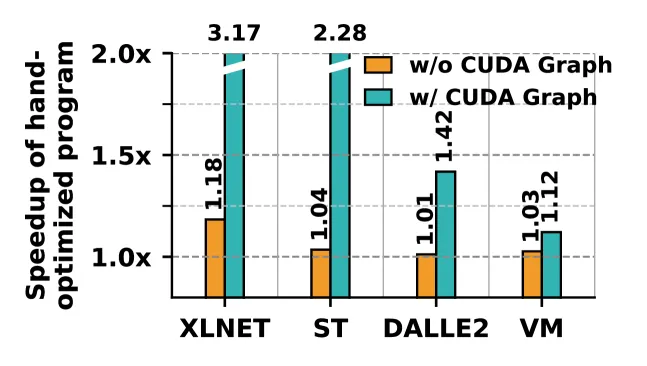
将张量从 CPU 移到 GPU 显著提升性能。
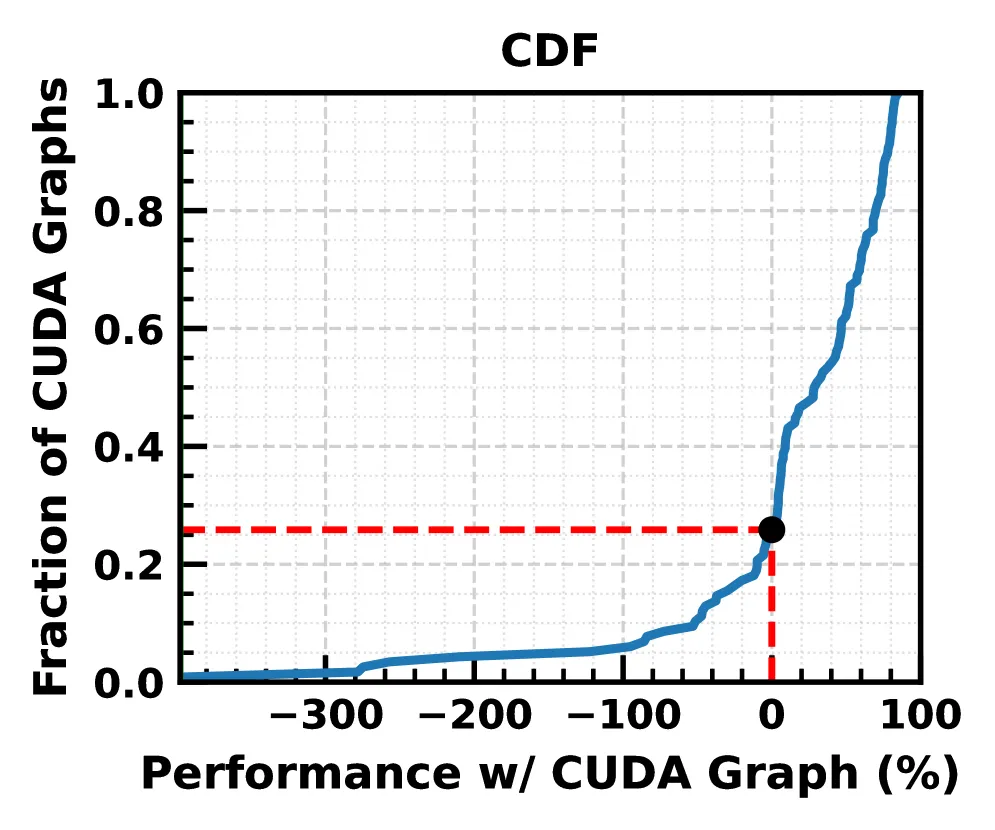
25% 的 CUDA Graph 实际损害性能,50% 的应用包含有害 CG。
核心优化
优化 1:CUDA Graph-aware Code Transformation (CGCT)
问题:同步内存拷贝、CPU 驻留标量/张量阻碍 CG 捕获 解决:在 IR 层面重写代码,使变量和操作满足 CG 约束
- 将标量参数转换为 GPU 驻留张量
- 将 DRAM-to-GPU 拷贝提升到 CG 区域外
- 确保计算和必要输入位于 GPU 上
优化 2:Parameter Indirection (PI)
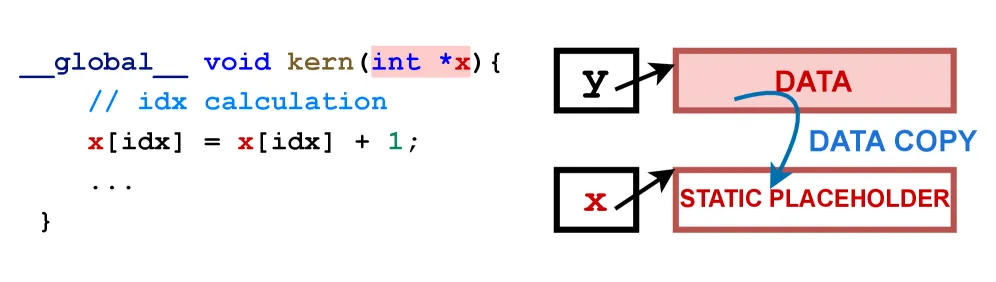
问题:CG 重放时参数拷贝开销巨大 解决:引入指针间接层,重放时仅更新指针(8 字节)而非数据
- 捕获时:记录指针到指针(pointer-to-pointer)
- 重放时:更新指针指向新数据
- 内核执行前解引用指针获取实际数据
效果:MTCG-T 从 1GB 拷贝减至 312B,DR-I 从 3GB 减至 8B
优化 3:Selective CUDA Graphs (SCG)
问题:盲目部署 CG 可能损害性能 解决:编译时自动 profiling,为每个 CG 选择最优配置
- 测量单个内核执行时间
- 测量 CG 执行时间(含/不含 PI)
- 自动选择最佳配置
- 123 个候选 CG 中启用 97 个,禁用 26 个
模型组件
| 组件 | 说明 | 关键特性 |
|---|---|---|
| CGCT | IR 级代码转换 | 自动识别并修复不兼容构造 |
| PI | 指针间接引用 | 消除参数拷贝,仅更新 8 字节指针 |
| SCG | 选择性部署 | 编译时 profiling,成本-收益分析 |
| Profiler | 自动性能分析 | 慢路径执行,不影响重放 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| CG-aware 代码转换 | 自动将不兼容代码转换为 CG 兼容形式 | XLNET-I 从 0% 覆盖提升到 99.28% |
| Parameter Indirection | 指针间接引用消除参数拷贝 | 数据拷贝减少 99%+,TKE 加速 23% |
| Selective CUDA Graphs | 基于 profiling 的选择性部署 | 避免 EOS 29% 性能回退 |
| 零开发者干预 | 完全自动化,无需修改源代码 | 与 PyTorch2 无缝集成 |
| 分布式兼容 | 在张量并行下效果更显著 | TP-4 下 XLNET 加速 3.48x |
五、代码实现分析
- 实现基础: PyTorch2 编译框架(TorchDynamo + TorchInductor)
- IR 层操作: 在 FxGraph 级别进行代码转换
- 内核重写: 支持 JIT 编译内核(如 Triton),厂商库通过 CG 管理 API
- 集成方式: 作为编译管线的后端优化 pass
六、实验结果
实验环境
| 组件 | 配置 |
|---|---|
| GPU | NVIDIA H100 NVL (94GB HBM3) |
| CPU | 64-core Intel Xeon 8462Y+ |
| 内存 | 512 GB DDR5 |
| 软件 | PyTorch 2.4, CUDA 12.8, cuDNN 8.9.2 |
| 多 GPU | 4× H100 (80GB) via NVLink |
基准测试
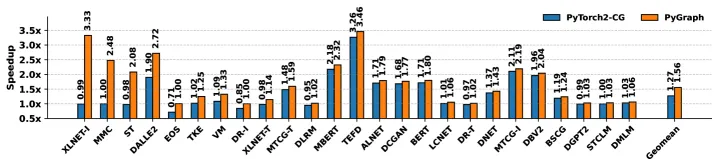
端到端性能:
- PyTorch2-CG 相比 No-CG:4 个应用回退(最差 29%),其余提升有限
- PyGraph 相比 PyTorch2-CG:平均 29% 提升,最高 3.36x(XLNET-I)
- PyGraph 在所有应用上至少与 No-CG 和 CG 的最佳配置持平
关键案例:
- XLNET-I:PyTorch2-CG 无法部署任何 CG(413 个内核),PyGraph 部署 99.28%
- DALLE2:PyTorch2-CG 1.9x 加速,PyGraph 2.72x 加速
- EOS:PyTorch2-CG 29% 回退,PyGraph 通过 SCG 避免
消融实验
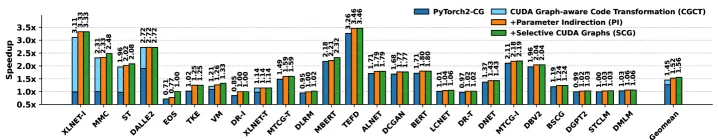
| 优化 | 效果 | 典型案例 |
|---|---|---|
| CGCT | 增加 CG 覆盖 | XLNET-I 3.14x,MMC 2.31x,ST 2x |
| +PI | 减少参数拷贝 | TKE 23%,DR-I 18%,12 个应用 >4% |
| +SCG | 避免性能回退 | EOS 避免 29% 回退 |
CG 覆盖提升:
| 应用 | PyTorch2-CG | +CGCT |
|---|---|---|
| ST | 5.14% | 74.22% |
| DALLE2 | 79.56% | 99.32% |
| MMC | 0% | 99.32% |
| XLNET-T | 1.53% | 98.06% |
| XLNET-I | 0% | 99.28% |
| VM | 58.84% | 71.01% |
参数拷贝减少:
| 应用 | 原始拷贝 | PI 后拷贝 | 减少 |
|---|---|---|---|
| MTCG-T | 1 GB | 312 B | 99.97% |
| DGPT2 | 953 MB | 136 B | 99.99% |
| STCLM | 850 MB | 136 B | 99.98% |
| DR-I | 3 GB | 8 B | 99.99% |
分布式评估
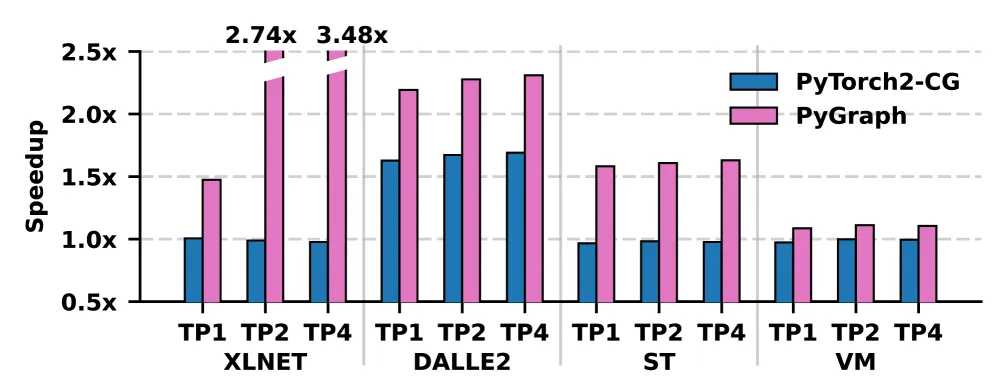
张量并行 (TP=1,2,4):
- 随 TP 度数增加,GPU 内核执行更快,CPU 启动延迟占比更大
- PyGraph 在 TP-4 下 XLNET 加速 3.48x,平均 2.41x
- PyTorch2-CG 在高 TP 下效果有限
A6000 GPU 评估:
- PyGraph 最大 3.25x 加速,平均 1.18x vs PyTorch2-CG 的 1.06x
- PyTorch2-CG 最差 32% 回退(EOS),PyGraph 从不回退
编译开销
- PyGraph 相比 PyTorch2 编译时间平均增加 1.6x
- 一次性成本,完全被稳态性能提升摊销
七、相关工作
ML 编译器
- TensorFlow、Caffe、Theano:图级优化
- TVM、XLA、Triton:张量程序 IR 和代码生成
- PyGraph 通过缓解 CPU 启动开销补充这些工作
PyTorch2 编译
- TorchDynamo:字节码级图捕获
- TorchInductor:内核优化和代码生成
- PyGraph 不依赖 PyTorch2 管线,可集成到 JAX/XLA
CUDA Graphs 优化
- Grape:需 400+ 行内核修改,与 PyTorch2 不兼容
- PyGraph:零手动修改,完全自动化
- Serverless LLM 推理:关注图持久化,与 PyGraph 互补
八、总结
核心贡献
- 提出 PyGraph 编译器框架,最大化 CUDA Graph 在 ML 工作负载中的覆盖和收益
- 设计 CGCT 自动代码转换,使不兼容应用兼容 CG 捕获
- 提出 Parameter Indirection,将参数拷贝从数千字节减至 8 字节指针
- 引入 Selective CUDA Graphs,基于 profiling 选择性部署避免性能回退
- 在 25 个 ML 工作负载上实现平均 29% 提升,最高 3.36x 加速
技术影响
- 作为 PyTorch2 编译管线的透明优化,无需开发者干预
- 在分布式 ML 场景(高 TP 度数)下效果更显著
- 为 CUDA Graph 的广泛部署提供编译器级解决方案
- 可扩展到 JAX/XLA 等其他编译框架
局限性
- 编译时间增加 1.6x(一次性成本)
- 仅支持 JIT 编译内核的 PI 优化,厂商库需要 CG 管理 API
- 对极小内核(微秒级)效果有限
- 未评估动态形状和控制流密集型工作负载
九、参考资源
- 论文: arXiv:2503.19779
- 相关工作:
- Grape (2024) - CUDA Graph 优化(需手动修改)
- TorchDynamo (Ansel et al., 2024) - PyTorch2 字节码级图捕获
- Triton (Tillet et al., 2019) - JIT 编译 GPU 内核
- CUTLASS (2017) - 高性能 CUDA 模板库