XAttention: Block Sparse Attention with Antidiagonal Scoring
通过反斜线评分实现高效块稀疏注意力,加速长上下文推理高达13.5倍
XAttention: Block Sparse Attention with Antidiagonal Scoring
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | XAttention: Block Sparse Attention with Antidiagonal Scoring |
| 作者 | Ruyi Xu, Guangxuan Xiao, Haofeng Huang, Junxian Guo, Song Han |
| 机构 | MIT |
| 论文 | arXiv:2503.16428 |
| 代码 | GitHub |
| 发布 | 2025-03-20 |
| 领域 | 稀疏注意力、长上下文推理 |
二、核心思想
问题定义
长上下文 Transformer 模型 (LCTMs) 在视频理解、视频生成等应用中至关重要,但注意力机制的二次复杂度导致高昂计算成本。块稀疏注意力通过聚焦关键区域来缓解这一问题,但现有方法在平衡精度和效率方面存在困难。
核心洞察
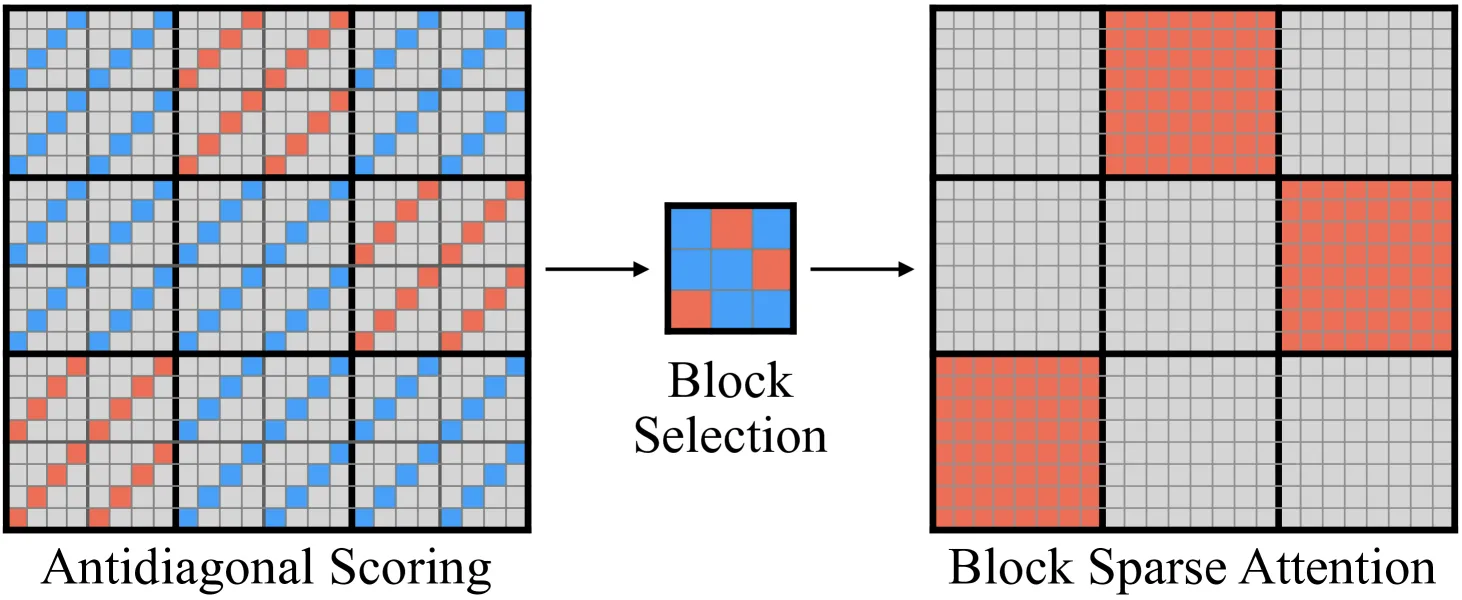
Figure 1: XAttention通过三步过程优化注意力:(左) 反斜线评分, (中) 阈值块选择, (右) 最小阈值预测
关键创新:注意力矩阵中反斜线值的和(从左下到右上)可以作为块重要性的强大代理。这使得能够精确识别和剪枝非必要块,实现高稀疏度和显著加速。
反斜线模式的有效性
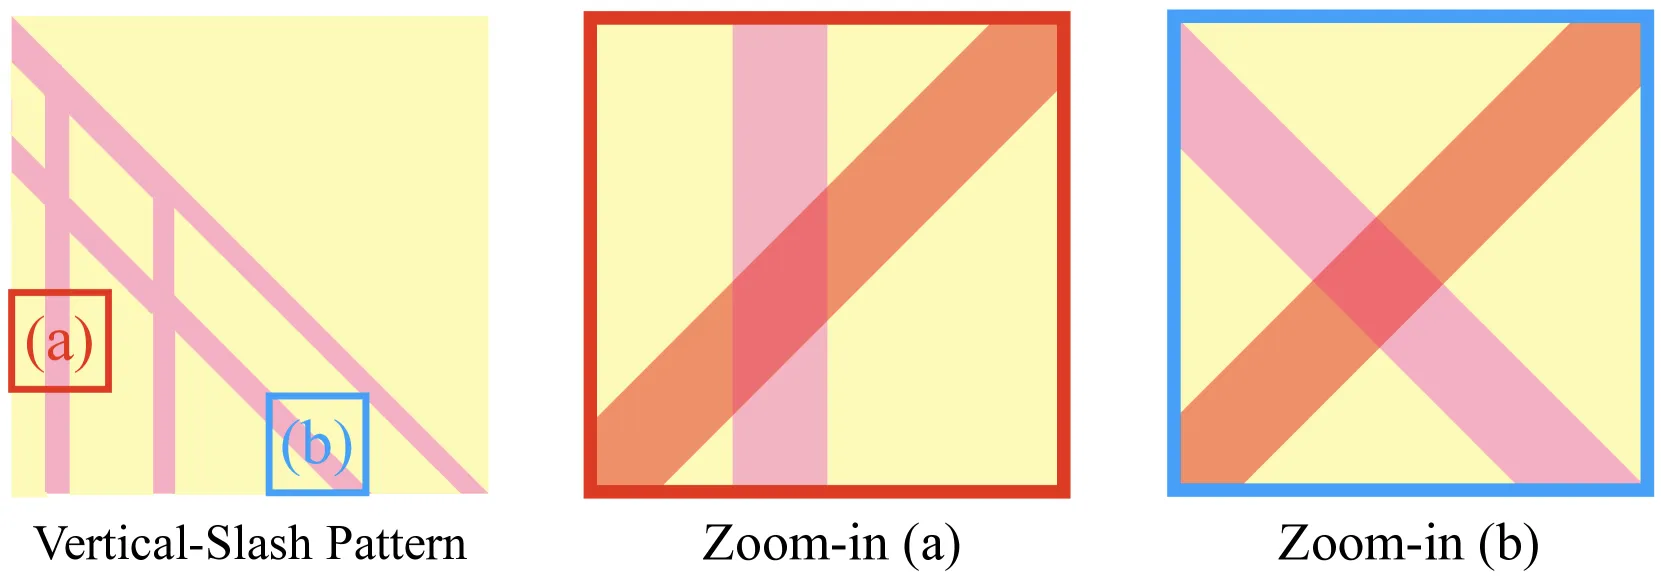
Figure 2: XAttention的反斜线模式与块内的垂直和斜线模式相交,实现高效检测
两个视角理解其有效性:
- 信息保持:选择策略确保所有token的信息都被考虑,因为每个token至少贡献一个反斜线和
- 模式检测:反斜线与块内每个可能的垂直和斜线模式相交
三、技术架构
方法概述
XAttention 算法包含三个主要组件:
- 重要性预测:注意力图块的重要性预测
- 阈值块选择:重要注意力块的选择
- 最小阈值预测:注意力头的最小阈值预测
重要性预测
反斜线选择方法:
在每个大小为 的块中,使用步幅 沿反斜线选择元素。这些选中元素的和作为对应注意力块整体重要性的代理。
为什么有效:
- 现有方法(如 MInference、FlexPrefill)使用池化和”垂直+斜线检测”
- 单独使用平均或最大池化会产生不准确的预测
- 反斜线方法自动且鲁棒地识别显著模式
阈值块选择
算法流程:
- 反斜线求和:在注意力图的每个 块中,沿反斜线选择元素并计算和
- Softmax 归一化:对反斜线和应用 softmax 函数,得到概率分布
- 块选择:使用
find_blocks函数识别最小块集合,其累积概率超过阈值
形式化定义:
\texttt{find\_blocks}(A, \tau) = \arg\min_{\mathcal{B}} \left\{ |\mathcal{B}| \ \Big{|}\ \sum_{b \in \mathcal{B}} \sum_{(i,j) \in b} A_{i,j} \geq \tau \right\}
其中 是注意力图, 是块集合。
最小阈值预测
使用动态规划方法预测最小阈值:
- 步幅 和
- 最大调整数
- 平均阈值约 0.8
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 反斜线评分 | 反斜线和作为块重要性代理 | 信息保持 + 模式检测 |
| 阈值块选择 | 基于累积概率的块选择 | 最小化块数量满足阈值 |
| 动态阈值预测 | 预测每个注意力头的最小阈值 | 动态规划方法 |
| 即插即用 | 无需训练,直接应用 | 兼容各种Transformer模型 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 语言模型 | Llama-3.1-8B-Instruct |
| 视频理解 | QwenVL-2-7B |
| 基准测试 | RULER, LongBench, VideoMME, VBench |
| 上下文长度 | 4K - 256K tokens |
| 步幅 | S = 8, S = 16 |
| 阈值 | τ = 0.9 |
精度结果
表1: RULER 基准测试结果
| 方法 | 4K | 8K | 16K | 32K | 64K | 128K | 平均 |
|---|---|---|---|---|---|---|---|
| Full Attention | 96.74 | 94.03 | 92.02 | 84.17 | 81.32 | 76.89 | 87.52 |
| FlexPrefill | 95.99 | 93.67 | 92.73 | 88.14 | 81.14 | 74.67 | 87.72 |
| MInference | 96.54 | 94.06 | 91.37 | 85.79 | 83.03 | 54.12 | 84.15 |
| SeerAttention | 84.43 | 79.55 | 79.80 | 72.95 | 64.79 | 51.61 | 72.18 |
| XAttention (S=8) | 96.83 | 94.07 | 93.17 | 90.75 | 84.08 | 72.31 | 88.47 |
| XAttention (S=16) | 96.11 | 93.95 | 93.56 | 90.64 | 83.12 | 71.11 | 88.08 |
关键发现:
- XAttention 在多个序列长度上超越全注意力
- MInference 和 SeerAttention 随上下文长度增加性能显著下降
- XAttention 在 RULER 上取得最高平均分数
表2: LongBench 基准测试结果
| 方法 | 单文档QA | 多文档QA | 摘要 | 少样本 | 代码 | 平均 |
|---|---|---|---|---|---|---|
| Full Attention | 28.67 | 17.79 | 25.02 | 65.73 | 50.67 | 40.34 |
| MInference | 28.72 | 17.66 | 25.01 | 65.81 | 51.13 | 40.30 |
| FlexPrefill | 25.18 | 15.60 | 24.93 | 58.62 | 46.62 | 36.83 |
| XAttention | 28.36 | 17.70 | 25.18 | 65.67 | 51.76 | 40.60 |
效率结果
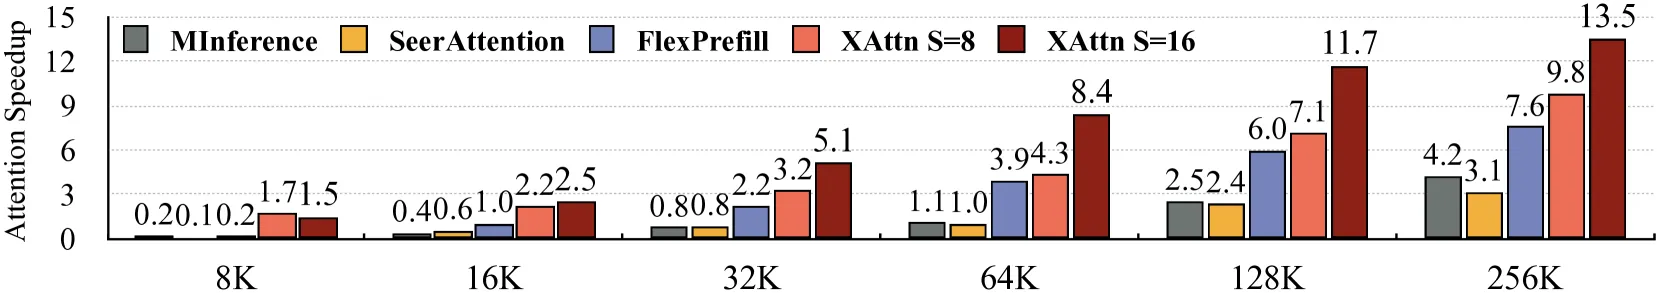
Figure 4: 跨上下文长度的注意力方法加速比较,相对于FlashAttention
关键结果:
- 在 256K tokens 上实现 13.5倍 注意力加速
- 步幅 S=8 时加速 9.8倍,密度 6.89%
- 步幅 S=16 时加速 13.5倍,密度 7.32%
表5: 不同上下文长度的密度
| 序列长度 | Stride 4 | Stride 8 | Stride 16 |
|---|---|---|---|
| 4K | 51.73% | 52.16% | 55.38% |
| 8K | 40.96% | 43.77% | 43.55% |
| 16K | 27.43% | 27.49% | 28.91% |
| 32K | 21.09% | 20.97% | 27.93% |
| 64K | 9.43% | 10.98% | 11.32% |
| 128K | 6.20% | 6.89% | 7.32% |
注意力时间分解
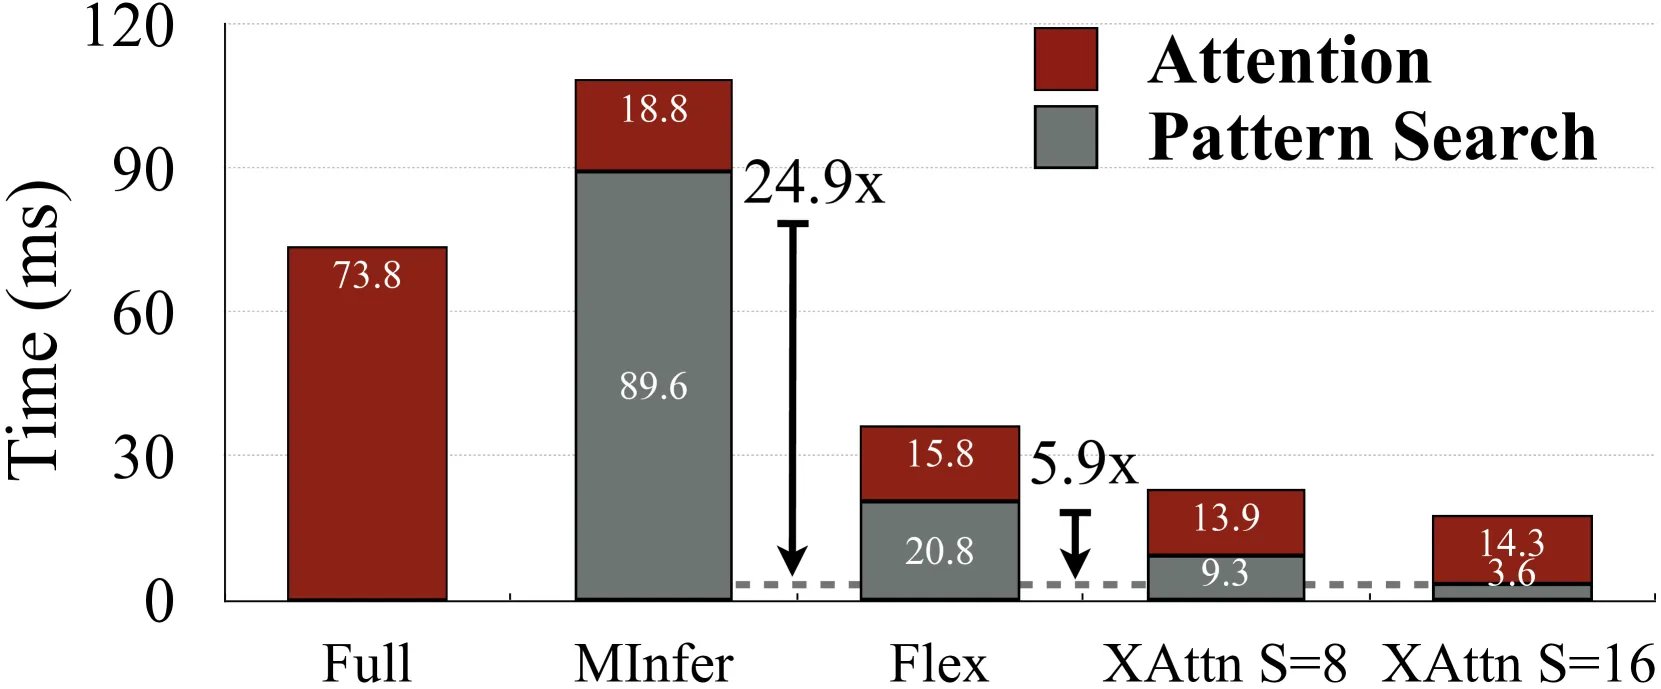
Figure 5: 预填充注意力时间分解
关键发现:
- XAttention 显著减少模式选择时间
- 同时保持密度
- 相比现有方法实现大幅加速
视频生成结果
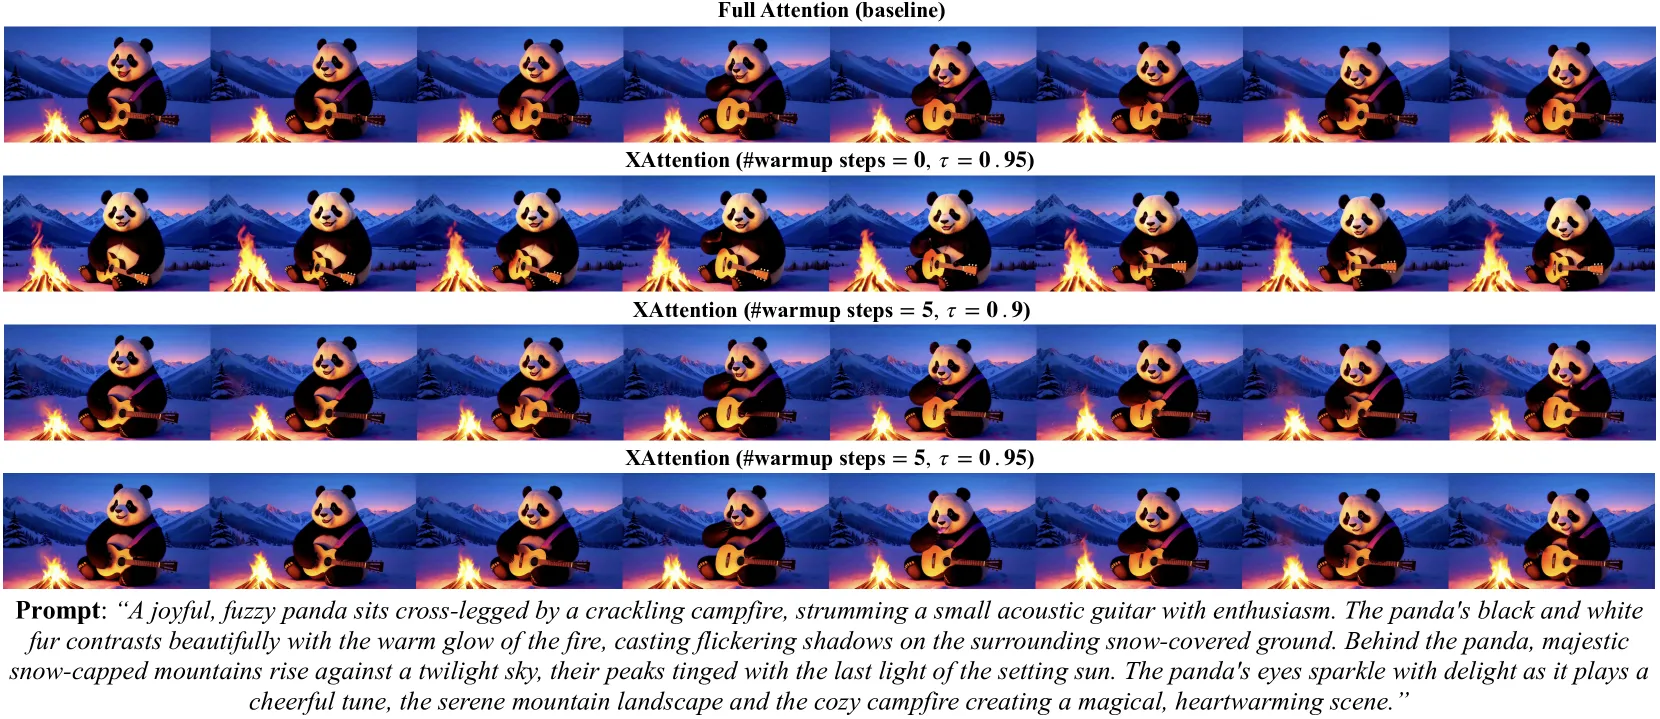
Figure 3: VBench基准上的视频生成定性比较
在 VBench 视频生成基准上:
- XAttention 保持与全注意力相当的生成质量
- 实现显著计算加速
六、相关工作对比
| 方法 | 策略 | XAttention优势 |
|---|---|---|
| Full Attention | 全注意力计算 | 13.5x加速 |
| MInference | 垂直+斜线检测 | 更高精度,更鲁棒 |
| FlexPrefill | 池化+模式检测 | 更高效率,更低开销 |
| SeerAttention | 可训练稀疏注意力 | 无需训练即插即用 |
七、总结
核心贡献
- 反斜线评分:发现注意力矩阵中反斜线和是块重要性的强大代理
- 即插即用框架:无需训练,直接应用于现有Transformer模型
- 高效块选择:基于阈值的块选择算法,实现高稀疏度
- 广泛验证:在语言理解、视频理解、视频生成等多个领域验证有效性
实际意义
- 长上下文推理加速高达 13.5倍
- 保持与全注意力相当的精度
- 支持 4K-256K 的上下文长度
- 兼容多种Transformer架构
技术影响
- 为块稀疏注意力提供了新的重要性度量方法
- 推动长上下文Transformer模型的实用化部署
- 为视频理解和生成等长序列任务提供高效解决方案
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | XAttention概述 | figure1-xattention-overview.png |
| Figure 2 | 反斜线模式 | figure2-antidiagonal-pattern.png |
| Figure 3 | 视频生成比较 | figure3-video-generation.png |
| Figure 4 | 加速比较 | figure4-speedup-comparison.png |
| Figure 5 | 注意力时间分解 | figure5-attention-breakdown.png |