MoE-Gen: High-Throughput MoE Inference on a Single GPU with Module-Based Batching
基于模块级批处理的单GPU高吞吐量MoE推理系统
MoE-Gen: High-Throughput MoE Inference on a Single GPU with Module-Based Batching
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MoE-Gen: High-Throughput MoE Inference on a Single GPU with Module-Based Batching |
| 作者 | Tairan Xu, Leyang Xue, Zhan Lu, Adrian Jackson, Luo Mai |
| 机构 | University of Edinburgh |
| 论文 | arXiv:2503.09716 |
| 代码 | GitHub |
| 发布 | 2025-03-12 |
| 领域 | 分布式计算 (cs.DC), 机器学习 (cs.LG) |
二、核心思想
问题定义
MoE 模型在 LLM 中越来越受欢迎,因为其路由设计只激活部分专家,降低了计算开销。然而,MoE 模型的巨大参数量往往超出单 GPU 内存容量,需要内存卸载 (offloading)。
现有推理系统的问题在于:
| 系统 | Prefill Expert Bsz | Prefill Util | Decode Expert Bsz | Decode Util |
|---|---|---|---|---|
| DeepSpeed | 153 | 52% | 0.3 | 0.1% |
| FlexGen | 115 | 49% | 0.3 | 0.1% |
| MoE-Lightning | 134 | 50% | 0.4 | 0.1% |
| MoE-Gen | 8192 | 100% | 75 | 41% |
现有系统使用 model-based batching(模型级批处理),在 decode 阶段每个专家仅处理极少量 token,GPU 利用率仅 0.1%。
解决方案概述
MoE-Gen 引入 module-based batching(模块级批处理):
- 不同模块使用不同 batch size:attention 模块用小 batch,expert 模块用大 batch
- 在 host memory 中累积 token,动态在 GPU 上启动大 batch
- Full KV-cache offloading:完全卸载 KV cache 到 CPU,减少权重获取流量达 20×
- DAG-based scheduling:最优调度计算和内存拷贝操作
核心结果:比最先进系统吞吐量提升 8-31×,单 GPU 服务器 (22.3K)。
三、技术架构
MoE 模型层结构
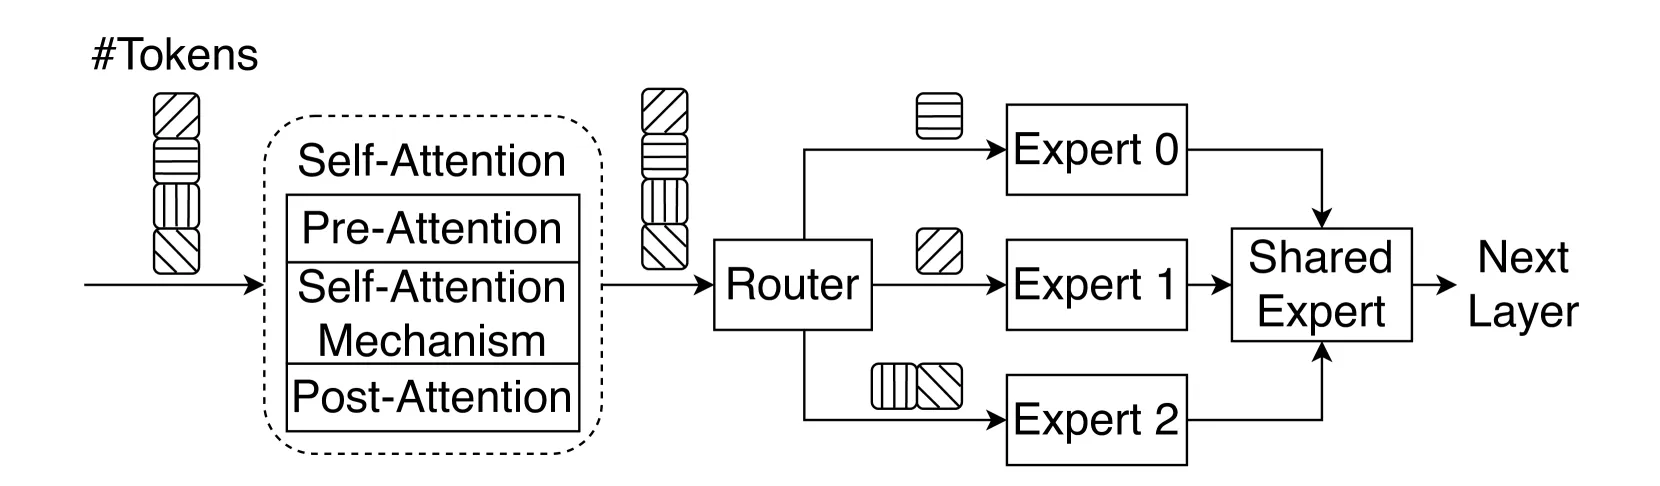
MoE 模型每层包含:
- Self-attention 层:pre-attention (QKV projection) → self-attention (QK^T) → post-attention (output projection)
- Sparse MoE 层:路由器分配 token 到 top-k 个专家,加权平均专家输出
Model-based vs Module-based Batching
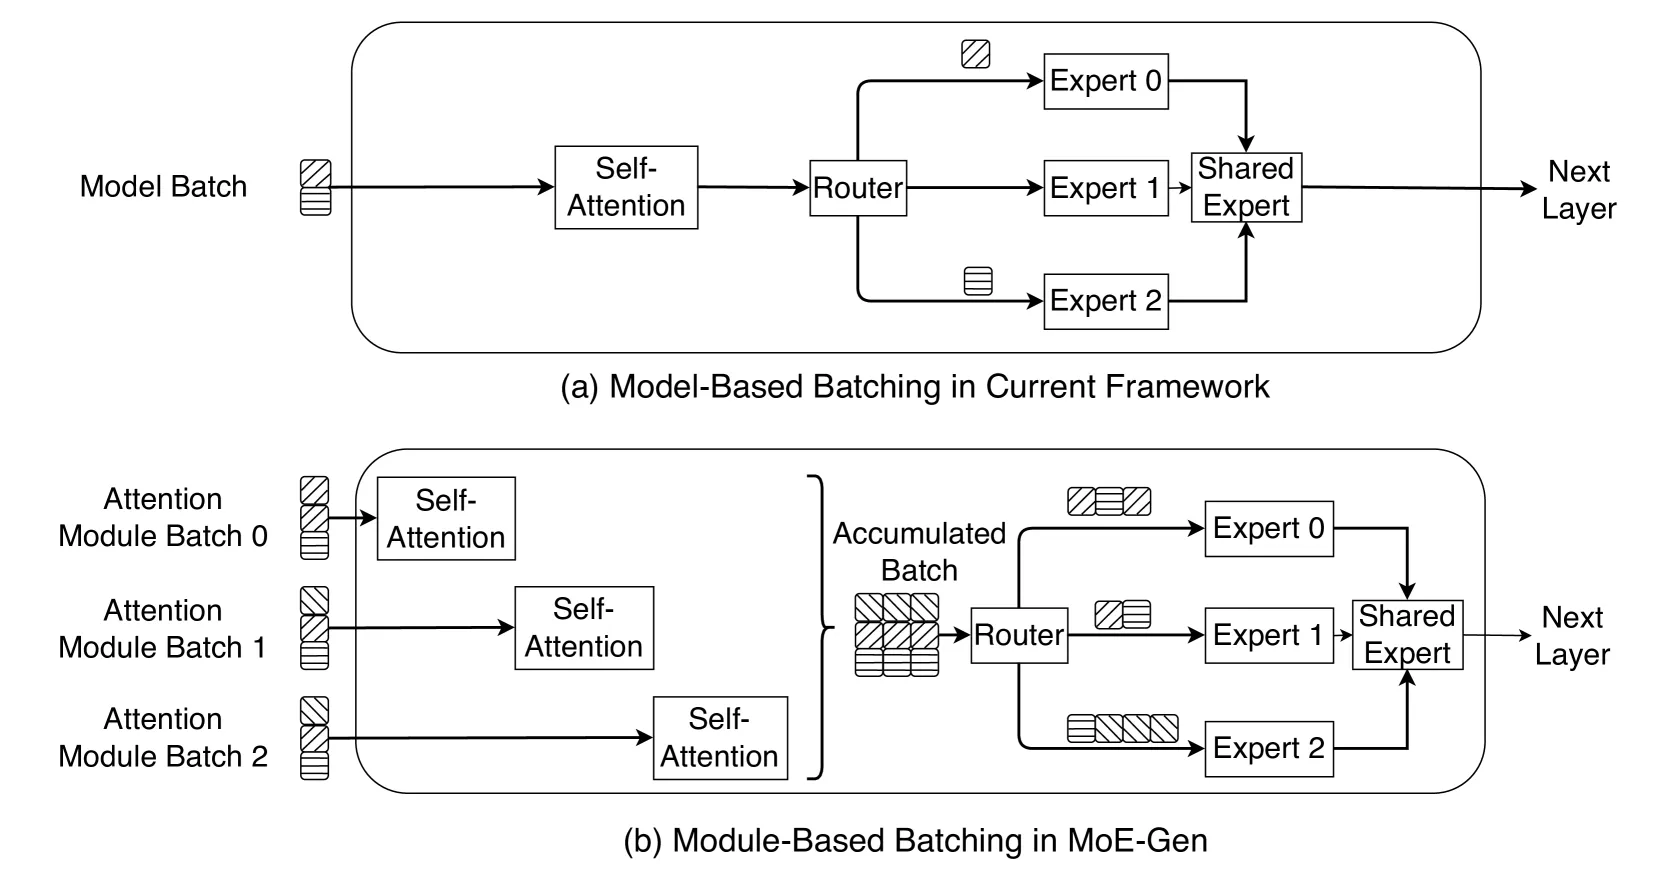
Model-based batching:整个模型使用统一 batch size,受限于内存需求最高的模块(通常是 attention)
Module-based batching:
- Attention 模块:使用较小 batch size(内存受限)
- Expert 模块:累积多个 attention batch,使用大 batch size(计算受限)
- 通过迭代处理小 batch 形成大 batch
GPU 利用率分析
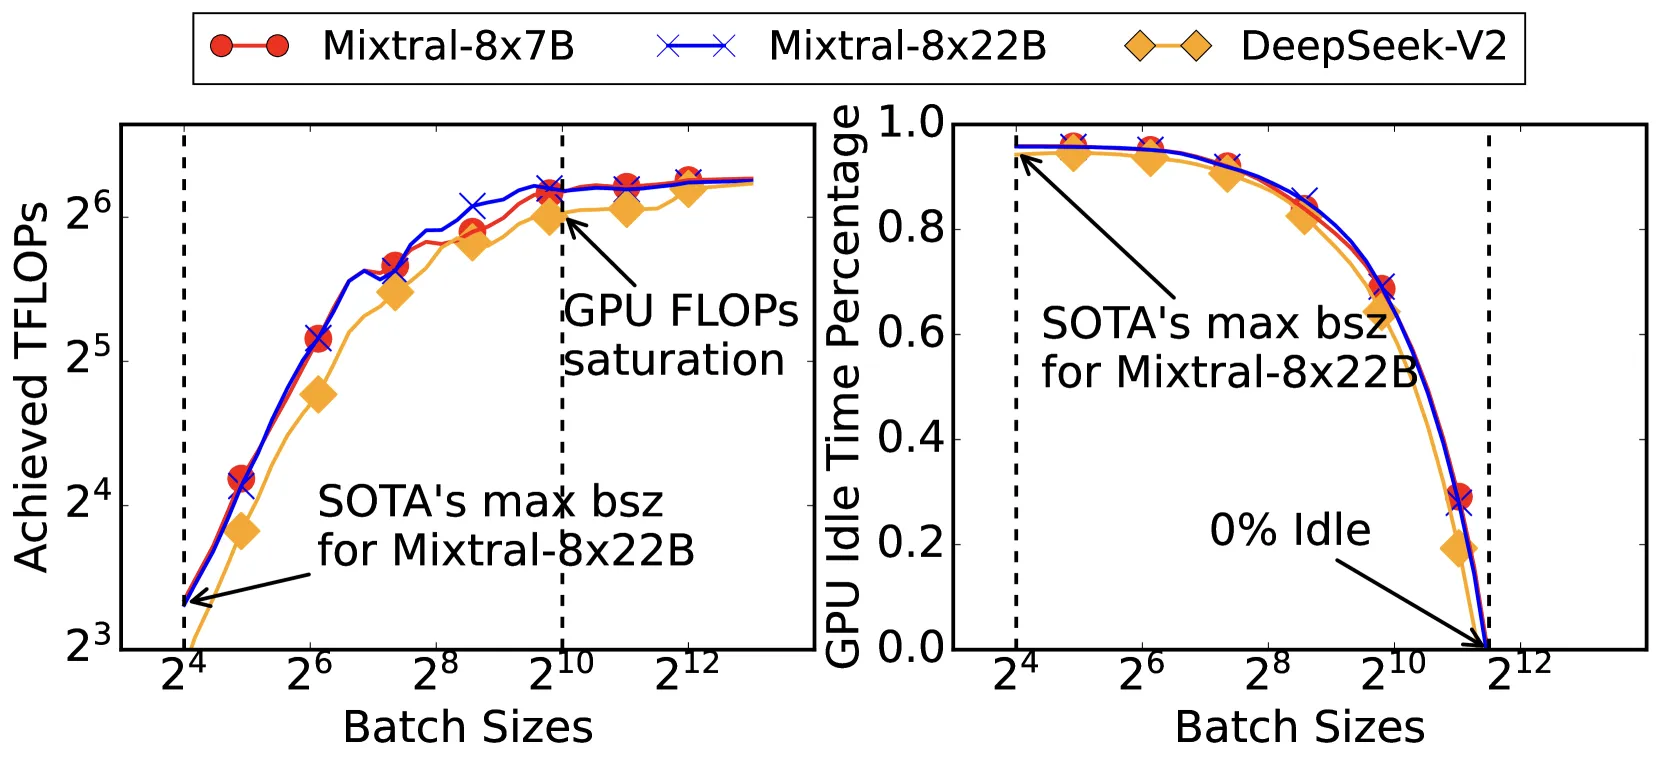
左图:非 offloading 场景下的 FLOPs(每个专家模块的浮点运算次数 / GPU 计算时间)
右图:offloading 场景下的 GPU 空闲时间百分比(A5000, PCIe 4.0, 32 GB/s)
- Expert 模块的执行时间 / 从 CPU 传输权重所需时间
- 批处理不足时 GPU 大量空闲
KV-cache Offloading 策略
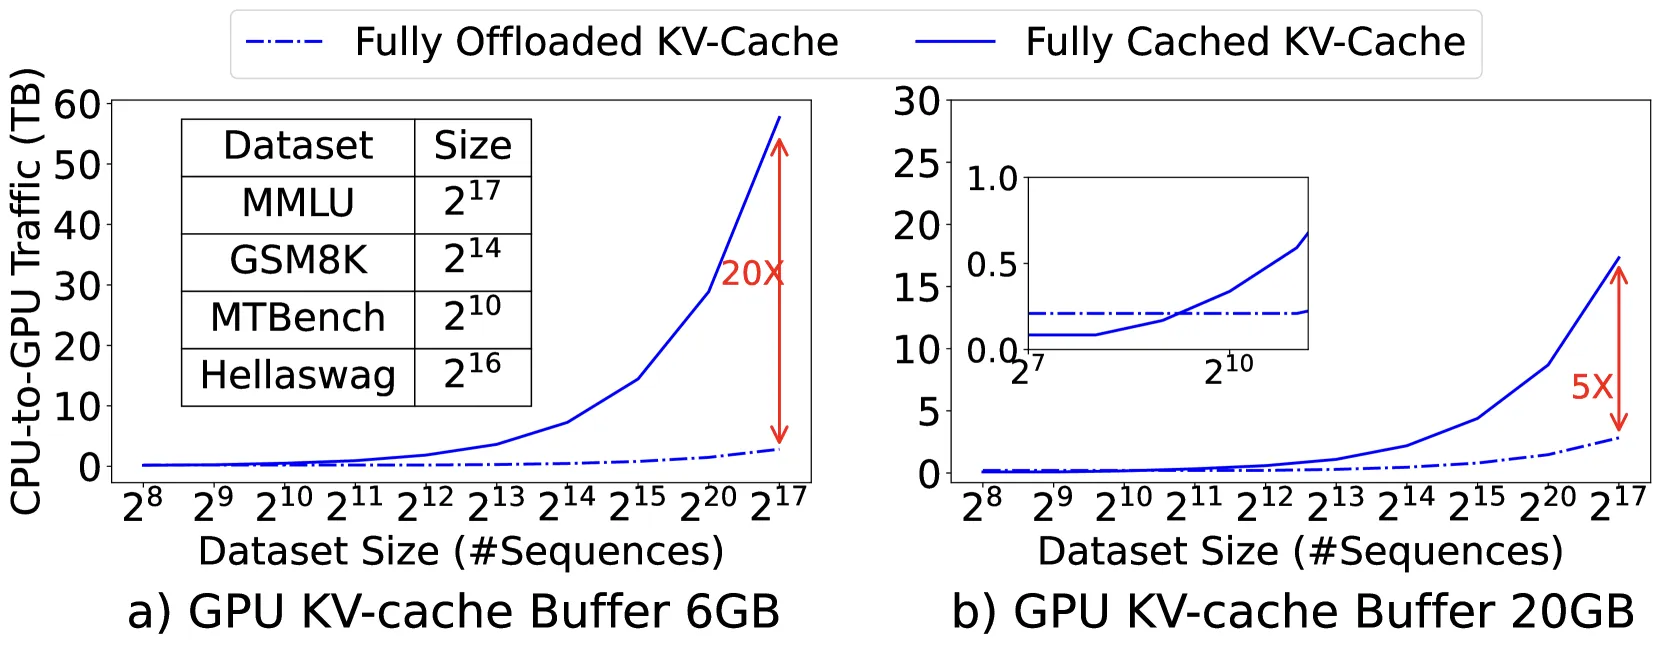
Full KV-cache offloading 优于 partial offloading:
- 缓存 KV-cache 在 GPU 内存会限制 batch size
- 限制 batch size 导致专家权重获取流量增加(如 Mixtral-8x7B 增加 86GB)
- 完全卸载 KV-cache 可实现 20× 的获取流量节省
系统组件
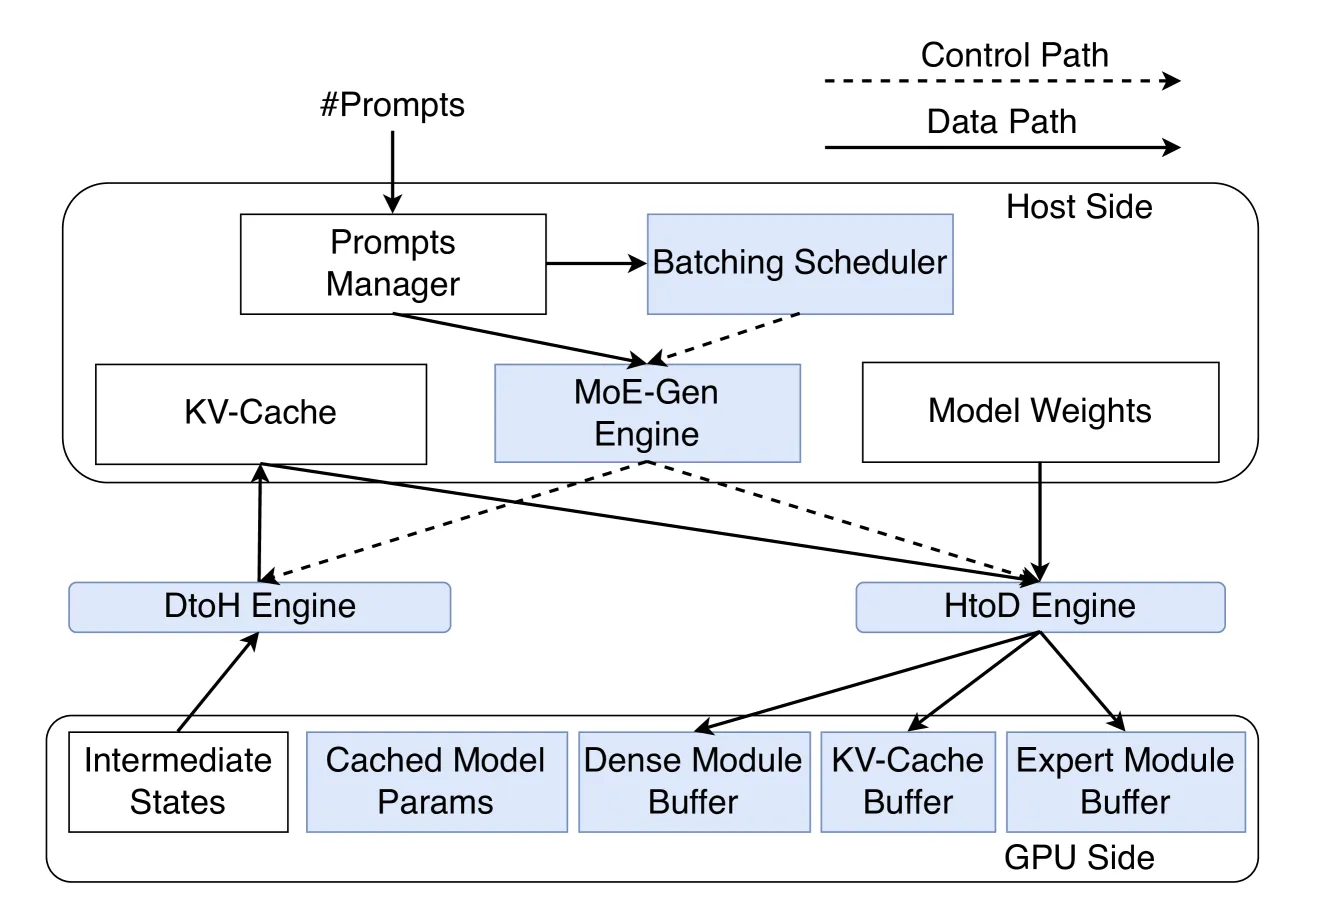
MoE-Gen 系统包含:
批处理调度器,基于以下信息创建策略:
- Hardware profiling:连接速度、GPU 内存容量
- Software profiling:不同 batch size 下 GPU/CPU kernel 的性能和内存使用
调度流程:
- 枚举候选配置
- 应用到 DAG 构造器估计运行时间
- 选择最短完成时间的配置
MoE Offloading DAG
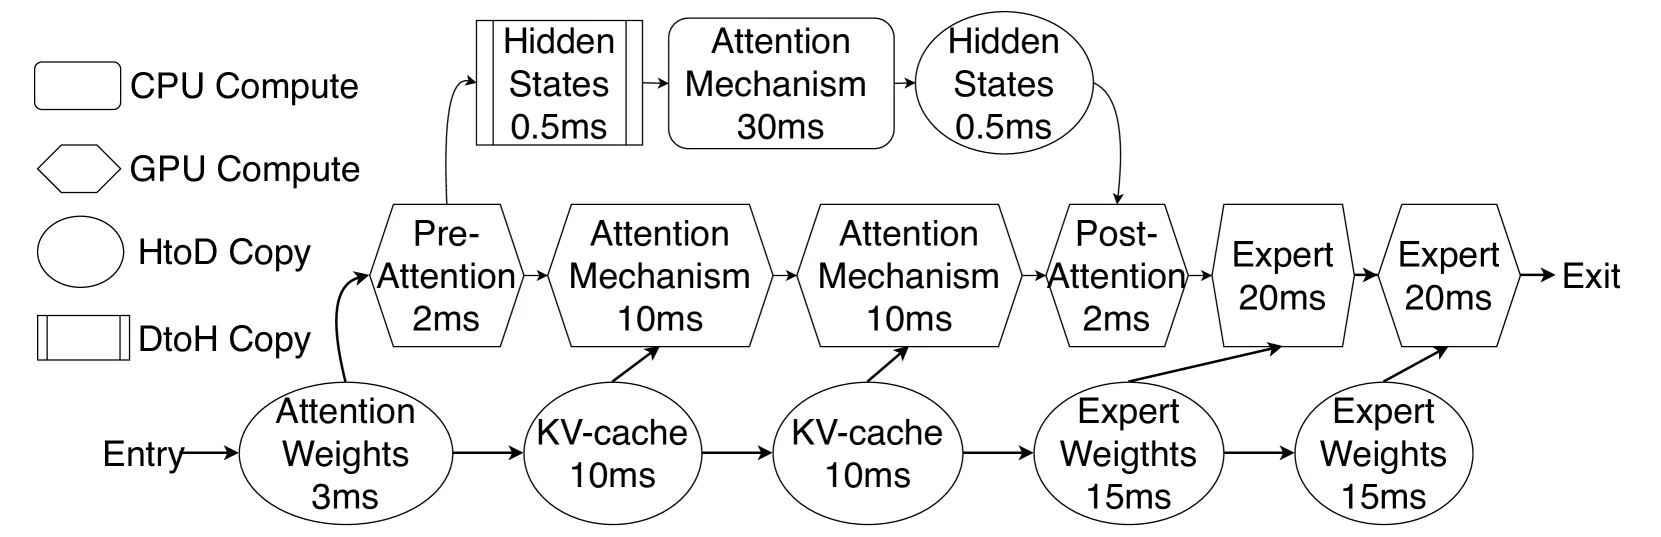
模型推理可视为 有向无环图 (DAG):
- 节点:计算任务或内存拷贝任务
- 边:任务依赖关系
- 目标:最优调度以最大化吞吐量
关键公式
优化目标 (Eq. 1):
其中:
- B:累积 batch size
- T:端到端执行时间
- S_Expert/S_Params:专家/参数分块大小
- b_a/b_e:attention/expert micro-batch size
- ω:CPU attention 比例
内存约束 (Eq. 2):
DAG 调度 (Eq. 3):
解码吞吐量 vs Split Ratio
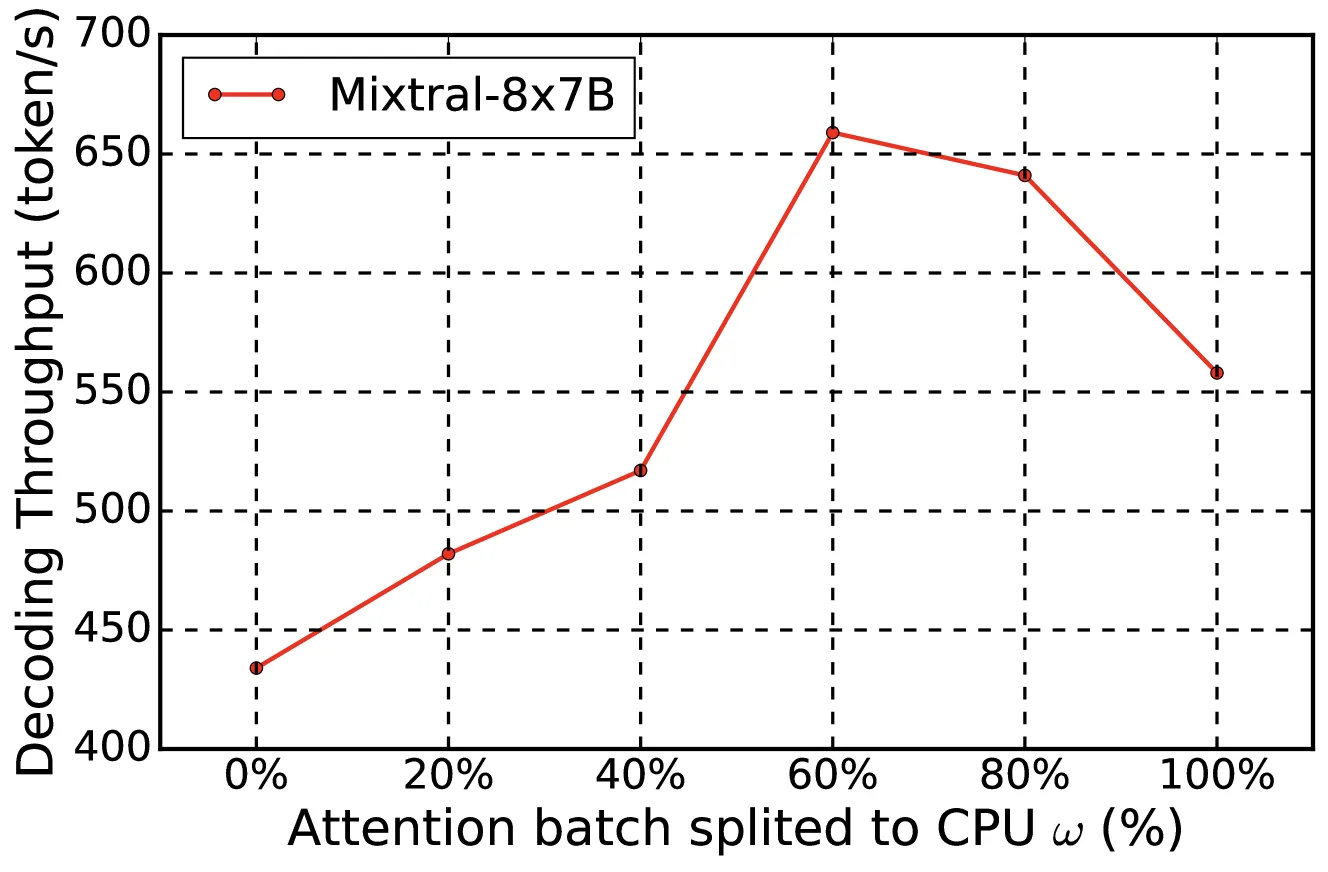
Split ratio ω(CPU attention 比例)对吞吐量有显著影响,需要找到最优值。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Module-based Batching | 不同模块使用不同 batch size | Expert 利用率从 0.1% 提升到 41% |
| Sequential Expert Execution | 利用均匀 token 分布顺序执行专家 | 大 batch 下专家负载均衡 |
| Full KV-cache Offloading | 完全卸载 KV cache 到 CPU | 减少 20× 获取流量 |
| DAG-based Scheduling | 最优调度计算和内存拷贝 | 重叠 computation 和 fetching |
| CPU Self-Attention | 在 CPU 上执行 QK^T 等操作 | GEMV 操作在 CPU 上与 PCIe 传输速度相当 |
五、实验结果
实验设置
硬件配置:
| 配置 | GPU | CPU | 主机内存 |
|---|---|---|---|
| C1 | A5000 24GB | AMD 7453 28-Core | 256GB |
| C2 | A5000 24GB | AMD 7453 28-Core | 512GB |
| C3 | A6000 48GB | AMD 7313P 16-Core | 480GB |
模型:Mixtral-8x7B, Mixtral-8x22B, DeepSeek-V2 236B, DeepSeek-R1 671B
数据集:LongBench, MMLU, GSM8K, Chatbot-Arena
端到端性能
Mixtral-8x22B 在 C2 上的完成时间:
| 系统 | MMLU | GSM8K | ChatBotArena |
|---|---|---|---|
| Llama.cpp | 149hr | 374hr | 6423hr |
| vLLM | 112hr | 303hr | 5205hr |
| DeepSpeed | 23hr | 115hr | 1710hr |
| FlexGen | 25hr | 122hr | 5132hr |
| MoE-Lightning | 23hr | 68hr | 5123hr |
| MoE-Gen(G) | 18hr | 12hr | 124hr |
| MoE-Gen(H) | 18hr | 8hr | 82hr |
解码吞吐量
Decoding throughput (tokens/s),C2,prompt length 512:
| 系统 | Mixtral 8x7B | Mixtral 8x22B | DeepSeek-V2 236B | DeepSeek-R1 671B |
|---|---|---|---|---|
| Llama.cpp | 4 | 2 | 1 | 0.9 |
| vLLM | 31 | 2 | 0.8 | Fail |
| DeepSpeed | 27 | 4 | 1 | Fail |
| FlexGen | 33 | 5 | 1 | Fail |
| MoE-Lightning | 89 | 9 | 1 | Fail |
| MoE-Gen(G) | 195 | 54 | 31 | 17 |
| MoE-Gen(H) | 469 | 91 | 31 | 17 |
Prefill 吞吐量
Prefill throughput (tokens/s):
| 系统 | Mixtral 8x7B | Mixtral 8x22B | DeepSeek-V2 236B | DeepSeek-R1 671B |
|---|---|---|---|---|
| DeepSpeed | 2621 | 710 | 109 | Fail |
| MoE-Lightning | 2237 | 702 | 98 | Fail |
| MoE-Gen | 2790 | 907 | 787 | 204 |
性能总结
| 指标 | MoE-Gen |
|---|---|
| 吞吐量提升 vs SOTA | 8-31× |
| Decoding 吞吐量提升 | 最高 31× |
| Prefill GPU 利用率 | 100% (vs 49-52%) |
| Decode GPU 利用率 | 41% (vs 0.1%) |
| 成本效益 | 22.3K 8GPU |
| 功耗 | 380W vs 1780W |
六、消融实验
- Batch size 不足:即使 batch size 仅为 1 或 32,MoE-Gen 仍优于或持平基线
- CPU attention ratio (ω):最优 ω 显著提升 GPU 利用率和整体性能
- CPU 计算能力:影响最优 ω 值的选择
七、相关工作
| 方法 | 特点 | MoE-Gen 优势 |
|---|---|---|
| FlexGen | Model-based batching | Module-based batching,8-31× 吞吐量 |
| MoE-Lightning | CPU-GPU-I/O pipeline | 不同 batch size + full KV offloading |
| DeepSpeed | 分布式推理 | 单 GPU 更高效 |
| vLLM | Continuous batching | Offline 场景更高效 |
| Llama.cpp | CPU 推理 | GPU 加速 + 智能 offloading |
八、总结
核心贡献
- Module-based Batching:首次提出模块级批处理,为不同模块使用不同 batch size
- Full KV-cache Offloading:证明完全卸载 KV cache 优于部分卸载
- DAG-based Scheduling:最优调度计算和内存拷贝操作
- 开源实现:代码公开于 GitHub
技术影响
- 使大型 MoE 模型在单 GPU 上实现高吞吐量推理成为可能
- 显著降低 AI 开发者使用大型 MoE 模型的硬件门槛
- 为离线推理任务(benchmarking、数据处理、特征提取)提供实用方案
局限性
- 主要针对离线批量推理,未针对在线交互式推理优化
- 需要 profiling 阶段确定最优配置
- CPU attention 在某些场景下可能成为瓶颈
九、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | MoE 模型层结构 | moe-layer-architecture.png |
| Figure 2 | Model-based vs Module-based batching | model-vs-module-batching.png |
| Figure 3 | GPU 利用率分析 | gpu-utilization.png |
| Figure 4 | 获取流量分析 | fetching-traffic.png |
| Figure 5 | 系统组件 | system-components.png |
| Figure 6 | MoE Offloading DAG | offloading-dag.png |
| Figure 7 | 吞吐量 vs Split Ratio | throughput-vs-split-ratio.png |