Inductive Moment Matching: Few-Step Generation via Single-Stage Training
提出归纳矩匹配(IMM)框架,通过单阶段训练实现一步或少步生成,在ImageNet-256×256上以8步达到1.99 FID,超越扩散模型
Inductive Moment Matching: Few-Step Generation via Single-Stage Training
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Inductive Moment Matching |
| 作者 | Linqi Zhou, Stefano Ermon, Jiaming Song |
| 机构 | Stanford University |
| 论文 | https://arxiv.org/abs/2503.07565 |
| 发布 | 2025-03-10 (v1), 最新 v7 (2025-05-14) |
| 会议 | ICML |
二、核心思想
问题定义
生成模型面临三难困境(Trilemma):
| 挑战 | 说明 |
|---|---|
| 高保真输出 | 生成高质量样本 |
| 高效推理 | 减少推理步数 |
| 稳定训练 | 避免训练崩溃 |
现有方法的局限:
| 方法 | 问题 |
|---|---|
| 扩散模型 | 推理步数多,速度慢 |
| 扩散蒸馏 | 需要预训练初始化,训练不稳定 |
| 一致性模型(CMs) | 需要仔细调参,存在训练崩溃风险 |
解决方案概述
Inductive Moment Matching (IMM) 是一种新的生成模型框架,核心创新:
- 单阶段训练:无需预训练初始化,从头训练
- 少步生成:支持1步或少步推理
- 分布级收敛:保证分布级收敛,而非点级一致性
- 训练稳定:在各种超参数和标准模型架构下保持稳定
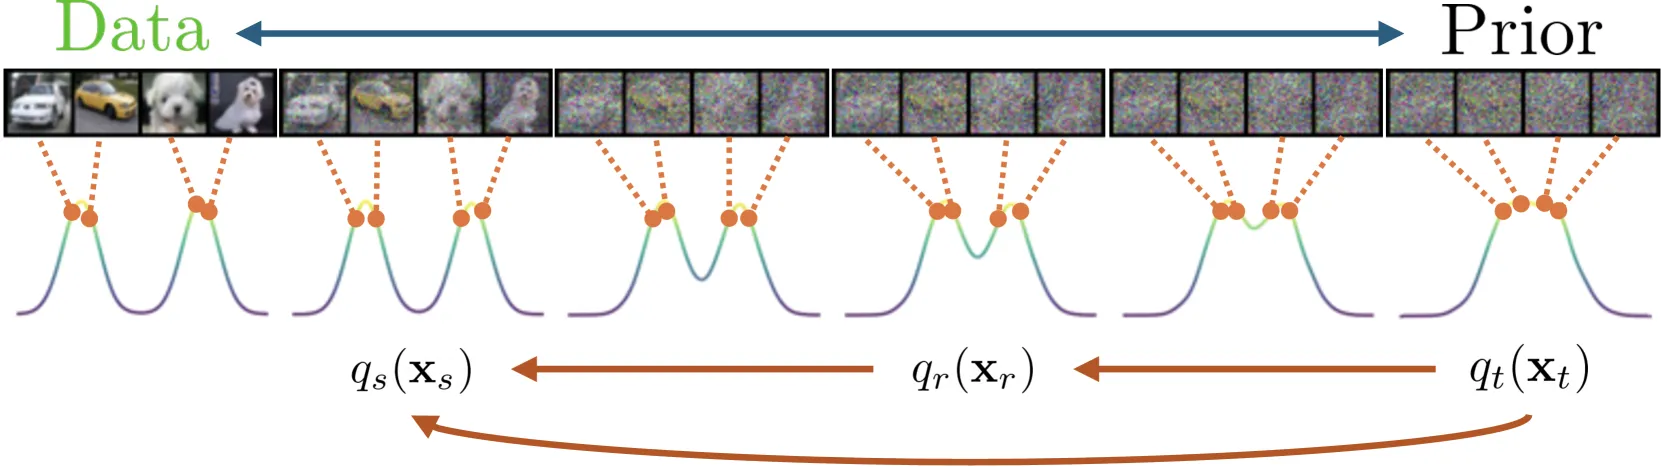
三、技术架构
整体框架
IMM基于**随机插值(Stochastic Interpolants)**构建:
- 插值定义:连接数据分布 和先验分布 的随机过程
- 边际分布: 表示时间 处的边际分布
- 一步映射:学习从 到 () 的一步映射
- 归纳训练:通过数学归纳法训练,保证收敛
核心公式
随机插值定义:
其中:
- 是插值函数
- 是噪声水平
- 约束:,
自一致性插值(Self-Consistent Interpolants):
满足:
IMM目标函数:
其中:
- :从 一步映射到 的分布
- :从 一步映射到 的分布
- MMD:最大均值差异(Maximum Mean Discrepancy)
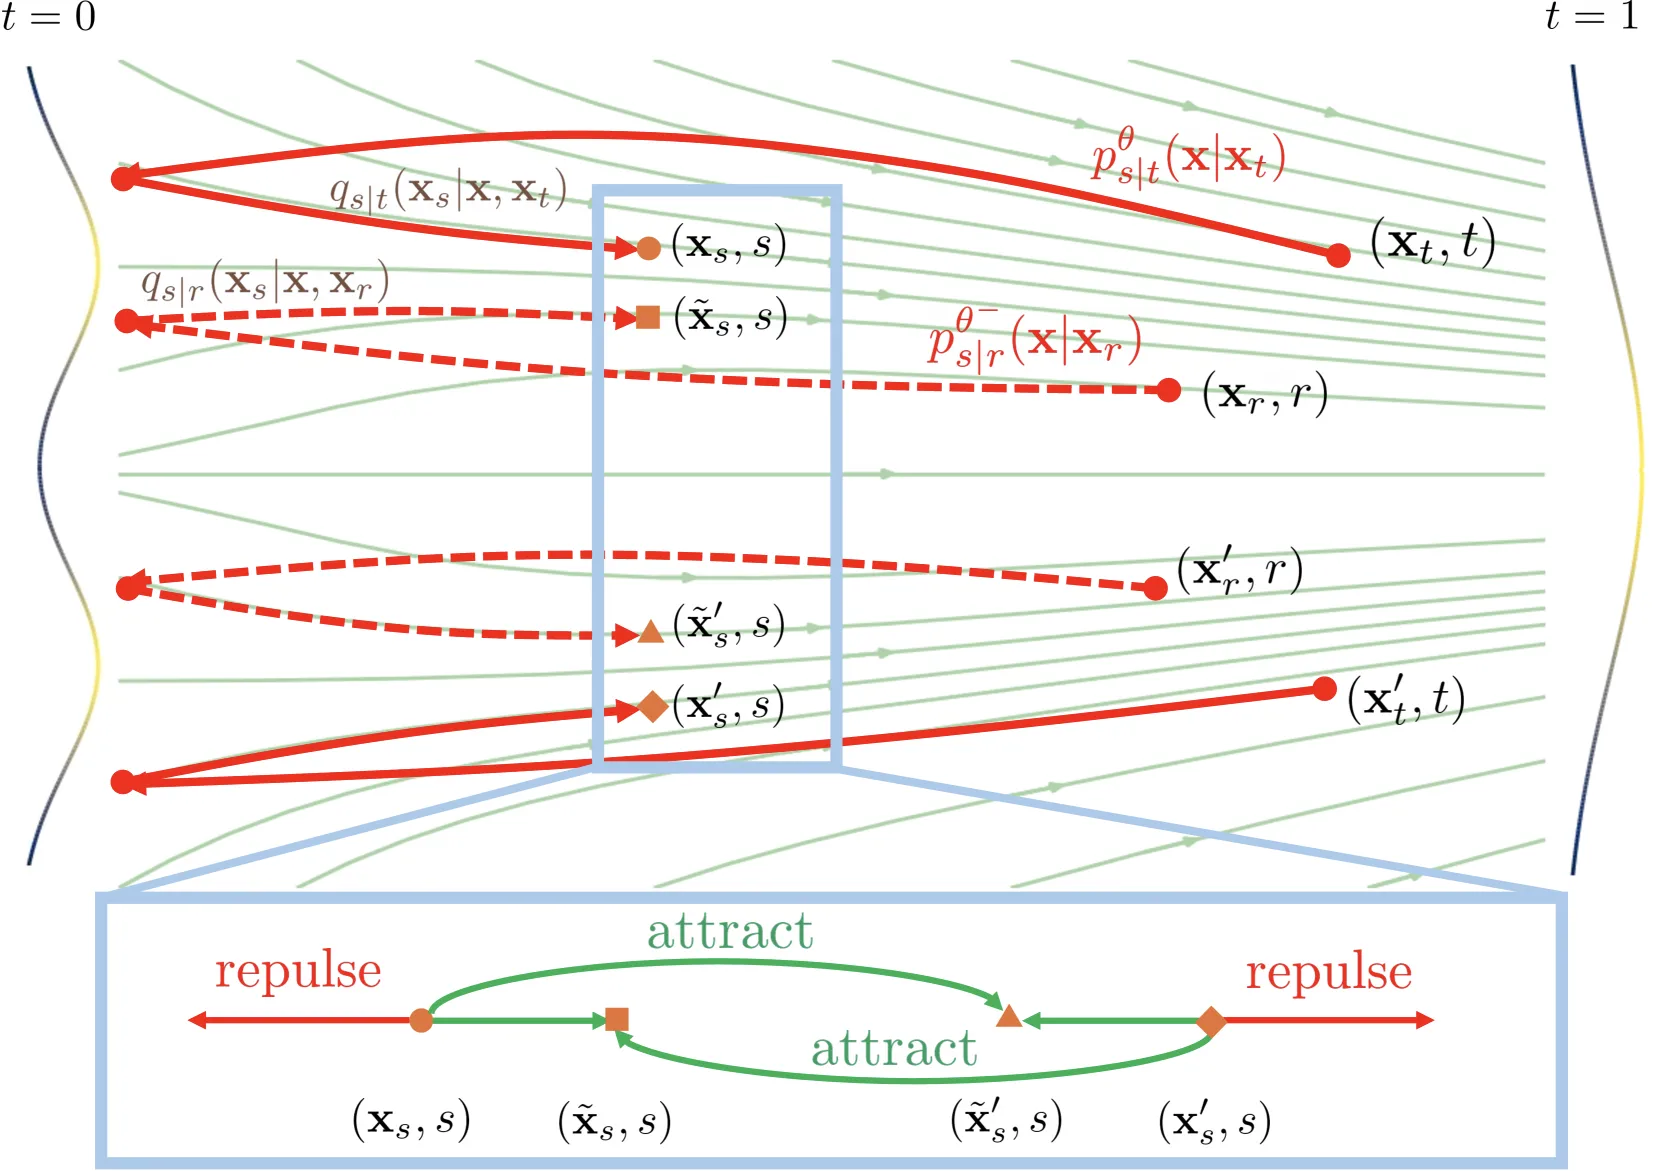
简化参数化
DDIM插值:
简化目标:
关键设计选择:
| 组件 | 选择 | 说明 |
|---|---|---|
| 映射函数 | 简化计算 | |
| 时间分布 | 均匀采样 | , |
| 核函数 | Gaussian kernel | |
| 权重函数 | 均匀权重 |
与一致性模型的关系
关键发现:一致性模型(CMs)是IMM的特例
- CMs使用单粒子、一阶矩匹配
- IMM使用多粒子、全矩匹配
- 这解释了CMs训练不稳定的原因:单粒子估计方差大
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 归纳训练范式 | 通过数学归纳法训练 | 保证分布级收敛 |
| 自一致性插值 | 定义满足边际保持的插值 | 理论保证 |
| 多粒子MMD | 使用M个粒子估计MMD | 训练稳定 |
| 单阶段训练 | 无需预训练初始化 | 简化流程 |
| 灵活步数 | 支持1步到多步生成 | 推理灵活 |
五、实验结果
CIFAR-10结果
| 方法族 | 方法 | FID↓ | 步数↓ | 参数量 |
|---|---|---|---|---|
| GAN | BigGAN | 6.95 | 1 | 112M |
| GAN | GigaGAN | 3.45 | 1 | 569M |
| GAN | StyleGAN-XL | 2.30 | 1 | 166M |
| 扩散 | NCSN++ | 2.34 | 2000 | 25.6M |
| 扩散 | DDPM++ | 2.28 | 1000 | 25.6M |
| 流匹配 | FM | 2.31 | 1000 | 25.6M |
| 蒸馏 | DMD | 2.19 | 1 | 25.6M |
| 蒸馏 | SEDD | 2.10 | 1 | 25.6M |
| 从头训练 | IMM (2步) | 1.98 | 2 | 25.6M |
关键发现:
- IMM在2步生成中达到1.98 FID,超越所有从头训练的方法
- 与蒸馏方法相当,但无需预训练
- 使用pushforward采样器
ImageNet-256×256结果
| 方法 | 架构 | FID↓ | 步数↓ |
|---|---|---|---|
| DiT | DiT-XL | 2.27 | 250 |
| SiT | DiT-XL | 2.06 | 250 |
| VAR | VAR-2B | 2.06 | 10 |
| IMM | DiT-XL | 1.99 | 8 |
| IMM | DiT-XL | 1.90 | 16 |
关键发现:
- 8步IMM (1.99 FID) 超越DiT和SiT的250步结果
- 16步IMM (1.90 FID) 超越VAR-2B的10步结果
- 推理速度提升30×以上
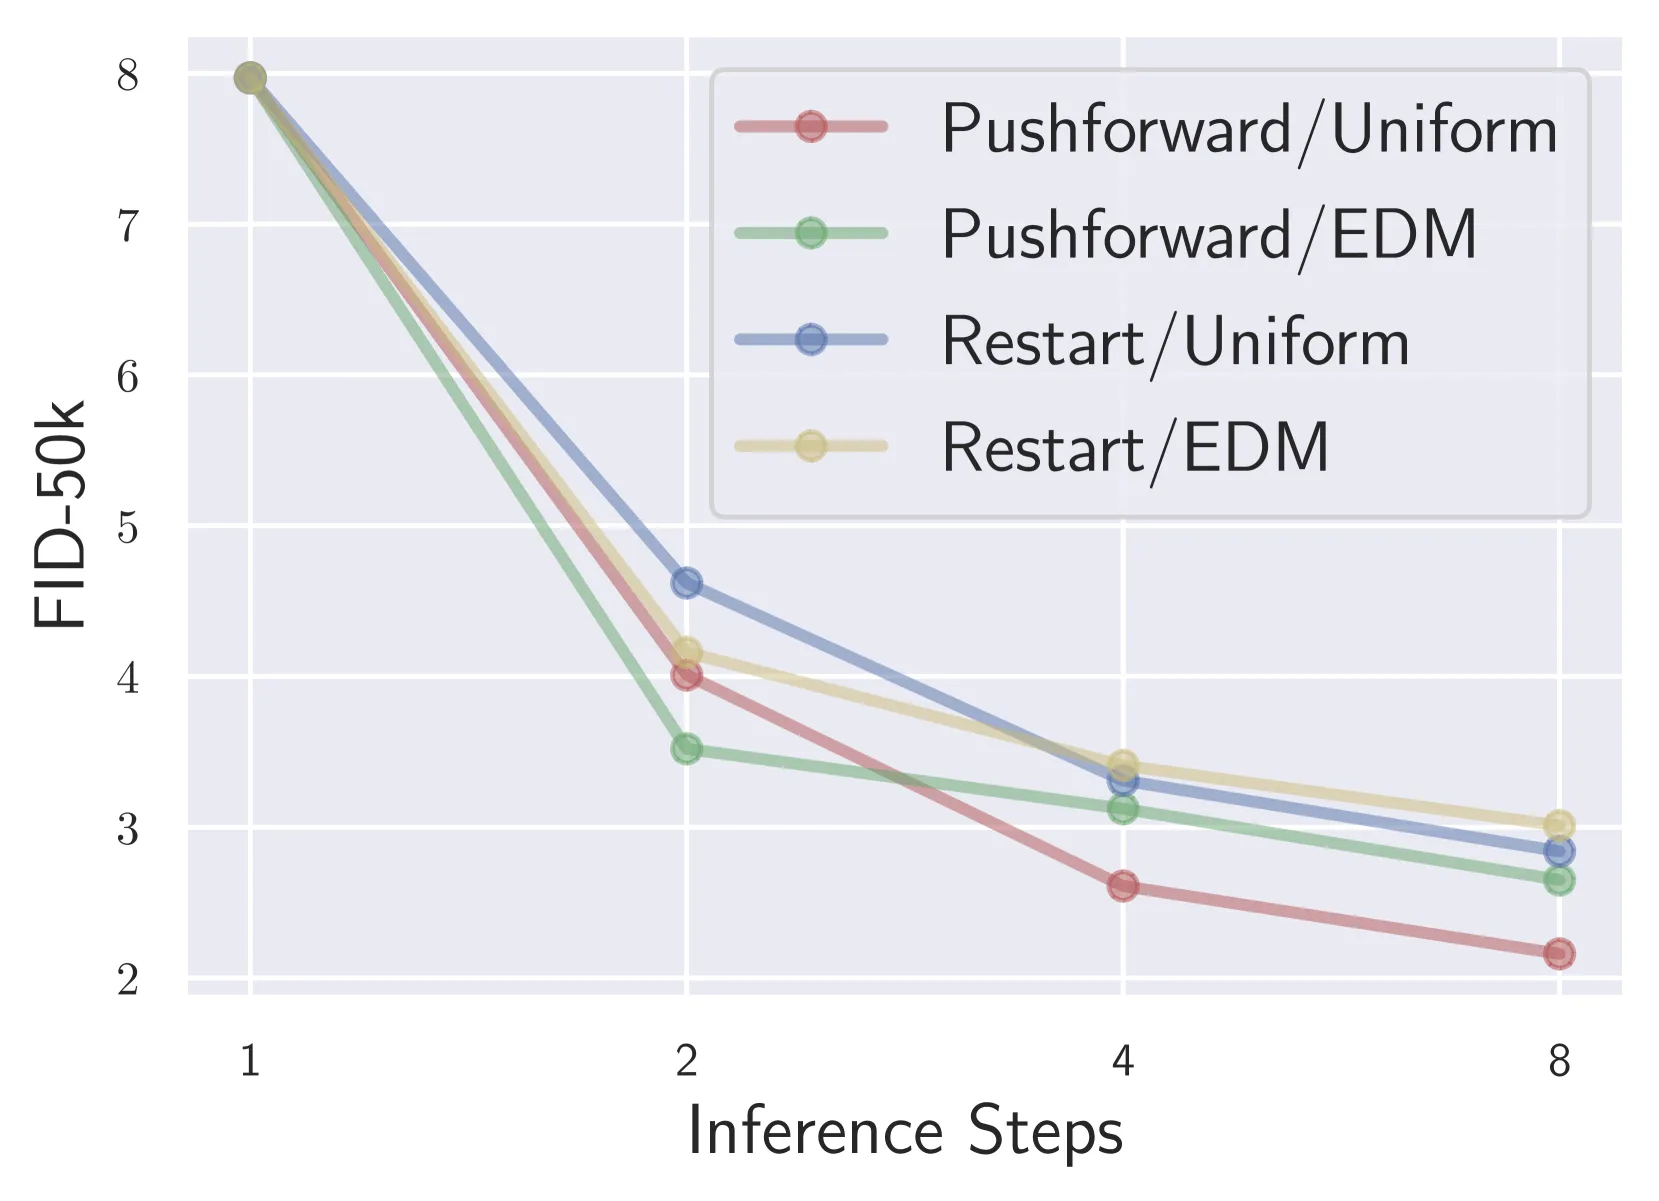
训练稳定性
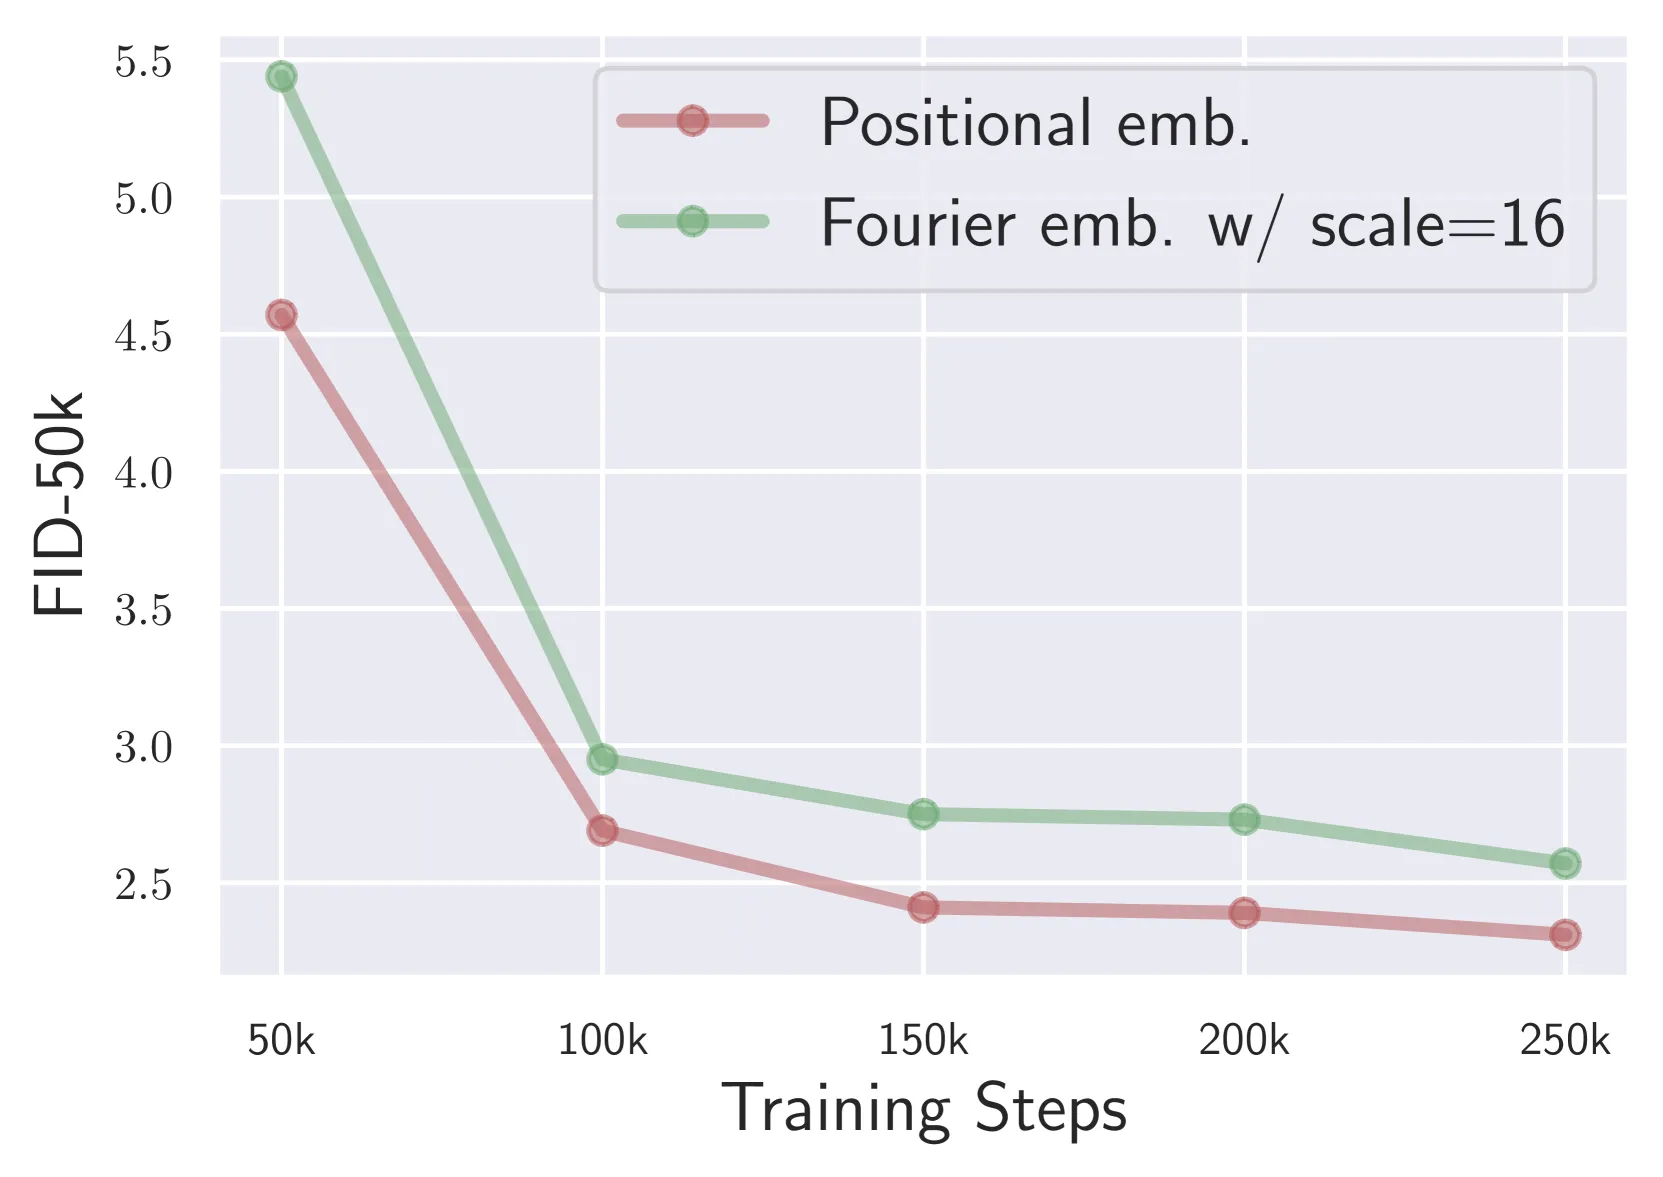
稳定性验证:
| 测试 | 结果 |
|---|---|
| Fourier embedding (scale=16) | 稳定收敛(CMs在此设置下不稳定) |
| 位置编码 | 稳定收敛 |
| 不同粒子数M | M越大越稳定 |
缩放行为
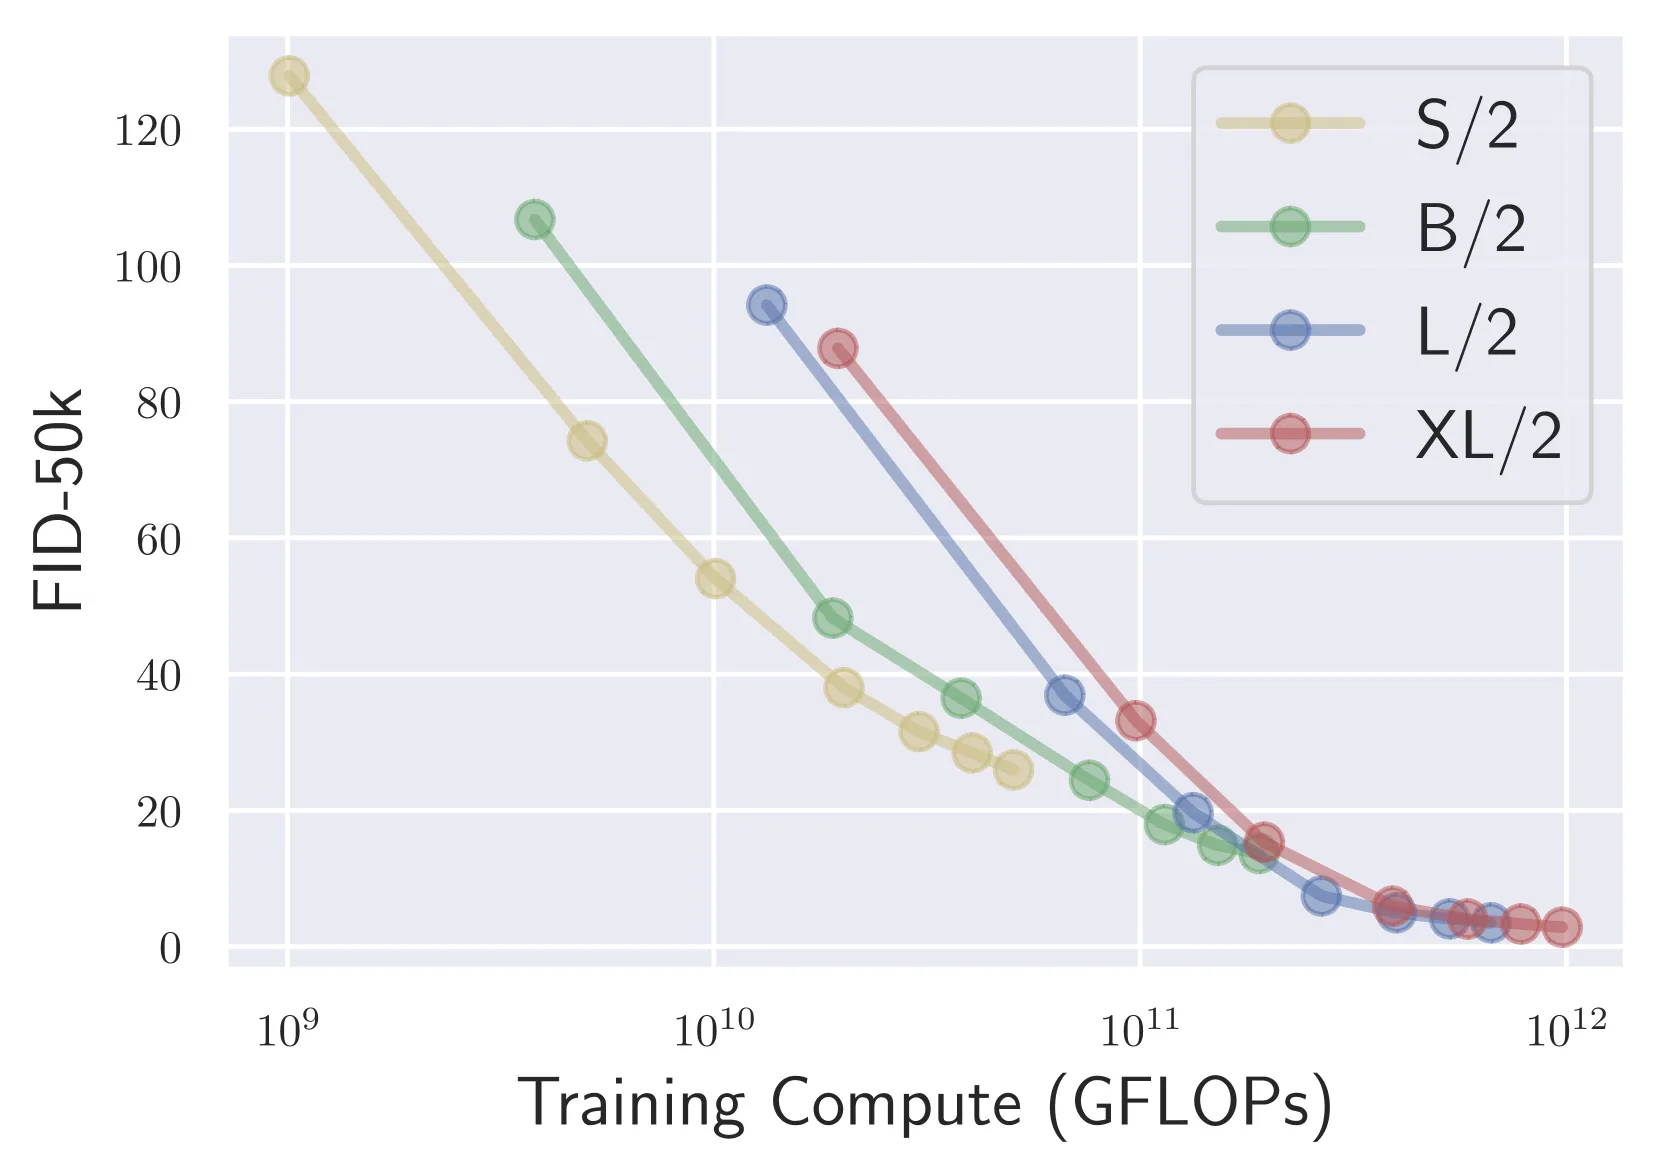
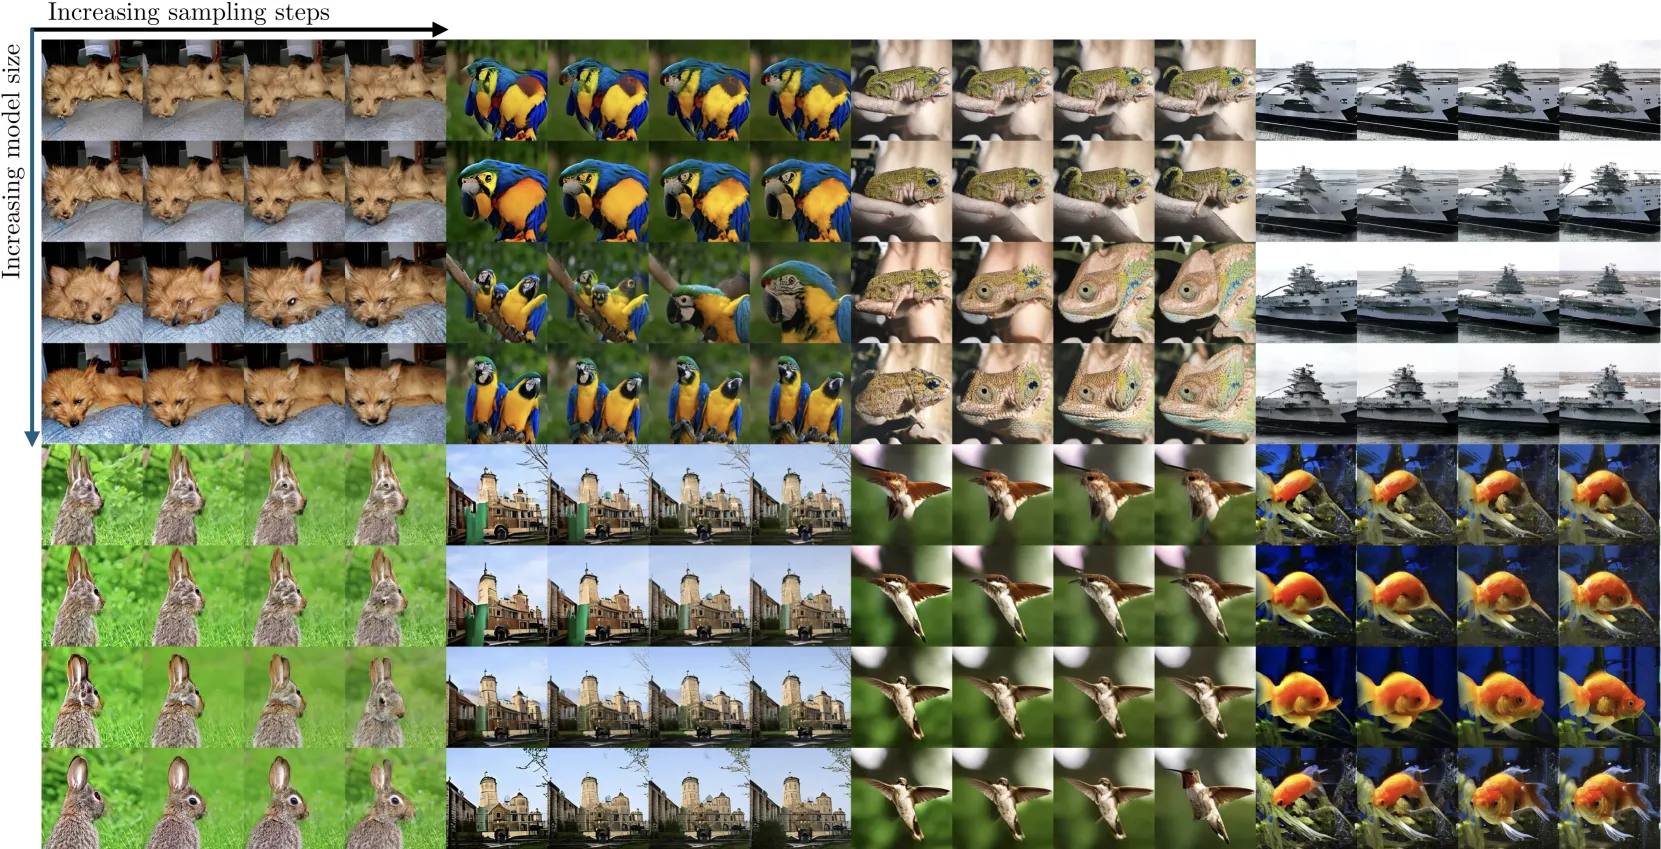
缩放特性:
- FID与训练/推理计算量强相关
- 模型越大、步数越多,样本质量越高
- 支持DiT-S/B/L/XL不同规模
消融实验
流调度和参数化:
| 参数化 | CIFAR-10 | ImageNet |
|---|---|---|
| id/cos | 3.77 | - |
| id/FM | - | - |
| sEDM/cos | 2.08 | 3.75 |
| sEDM/FM | 1.98 | 3.40 |
| eFM | 2.06 | 3.18 |
关键发现:
- Identity参数化性能较差
- OT-FM调度+Euler参数化在大规模上更优
- 小规模sEDM/FM最优,大规模eFM最优
六、相关工作
扩散模型与流匹配
- 扩散模型:DDPM, NCSN++, DDPM++
- 流匹配:FM, OT-FM
- 随机插值:统一扩散和流匹配框架
扩散蒸馏
- DMD:分布匹配蒸馏
- SEDD:离散扩散蒸馏
- 渐进蒸馏:逐步减少步数
一致性模型
- CMs:点级一致性,训练不稳定
- 伪目标:使用时间依赖的一致性目标
- IMM的改进:分布级收敛,多粒子估计
生成矩匹配
- GMMN:生成矩匹配网络
- MMD GAN:使用MMD的GAN
- IMM的区别:结合插值框架,支持少步生成
七、总结
核心贡献
- 提出IMM框架:新的少步生成模型,单阶段训练
- 理论保证:证明分布级收敛,统一多种现有方法
- 训练稳定:在各种超参数和架构下保持稳定
- SOTA性能:
- CIFAR-10: 1.98 FID (2步)
- ImageNet-256×256: 1.99 FID (8步)
技术影响
- 少步生成新范式:无需蒸馏,从头训练
- 理论统一:将一致性模型、GAN等统一到IMM框架
- 实用性强:支持灵活步数,训练稳定
- 可扩展:支持不同模型规模和分辨率
局限性
- 计算开销:MMD估计需要多个粒子,增加计算量
- 超参数敏感:粒子数M、核带宽等需要调整
- 架构依赖:在DiT上效果好,其他架构待验证
- 分辨率限制:主要评估256×256,更高分辨率待探索
八、参考资源
论文
- 本文: https://arxiv.org/abs/2503.07565
- 随机插值: Albergo et al., 2023
- 一致性模型: Song et al., 2023
- DiT: Peebles & Xie, 2023
相关工作
- DMD: Distribution Matching Distillation
- SEDD: Discrete Diffusion Distillation
- VAR: Visual Autoregressive Modeling
- GMMN: Generative Moment Matching Networks