Seesaw: High-throughput LLM Inference via Model Re-sharding
通过动态模型重分片实现高吞吐量LLM推理
Seesaw: High-throughput LLM Inference via Model Re-sharding
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Seesaw: High-throughput LLM Inference via Model Re-sharding |
| 作者 | Qidong Su, Wei Zhao, Xin Li, Muralidhar Andoorveedu, Chenhao Jiang, Zhanda Zhu, Kevin Song, Christina Giannoula, Gennady Pekhimenko |
| 机构 | University of Toronto, Vector Institute |
| 论文 | arXiv:2503.06433 |
| 代码 | 未公开 |
| 发布 | 2025年3月9日 |
| 领域 | 分布式LLM推理、系统优化 |
二、核心思想
问题定义
在分布式LLM推理中,现有的并行化策略(如张量并行和流水线并行)在预填充(prefill)和解码(decode)两个阶段表现出截然不同的性能特征:
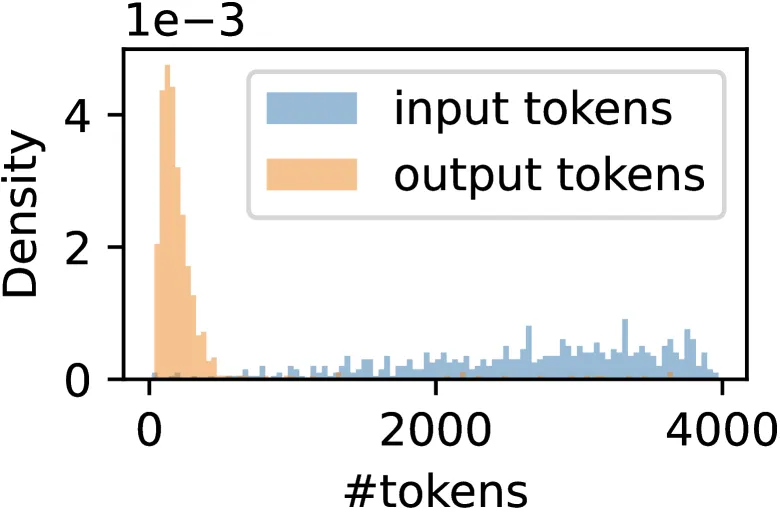
- 预填充阶段:处理输入序列的多个token,计算和通信是主要开销
- 解码阶段:逐个生成token,权重传输的相对开销显著增加
单一的静态并行化策略无法同时优化这两个阶段的性能。
解决方案概述
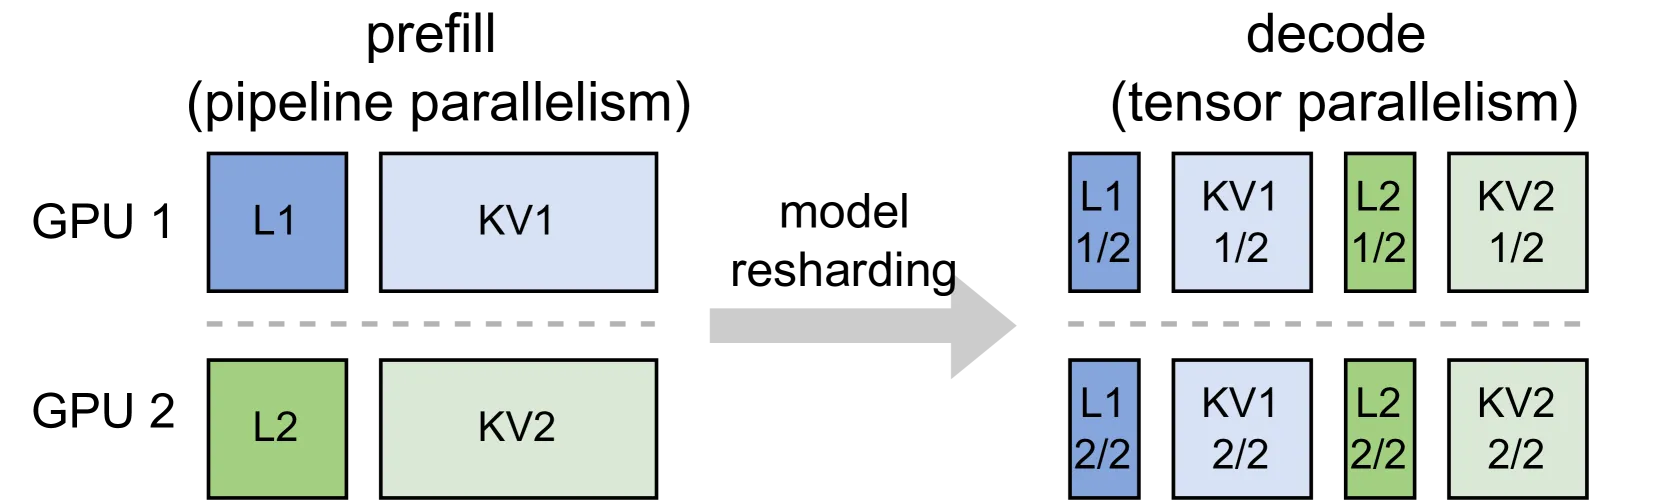
Seesaw提出**动态模型重分片(Dynamic Model Re-sharding)**技术:
- 分阶段并行化:为预填充和解码阶段选择不同的并行策略
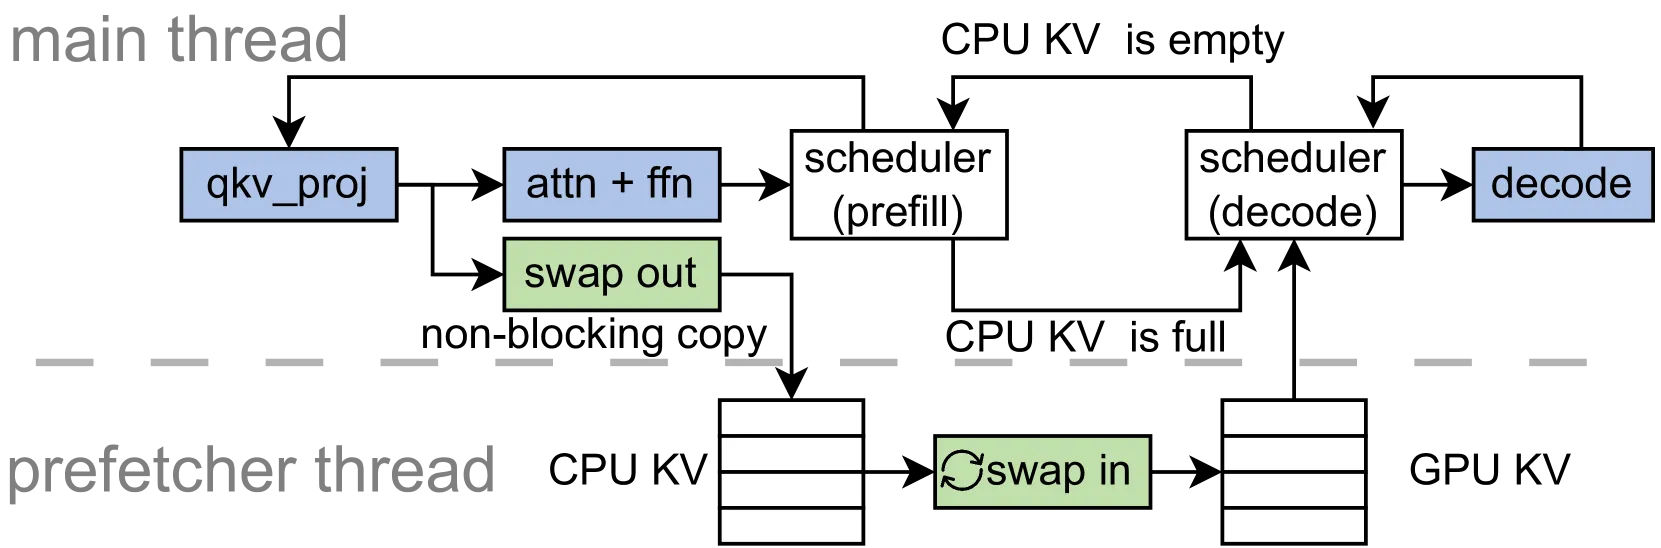
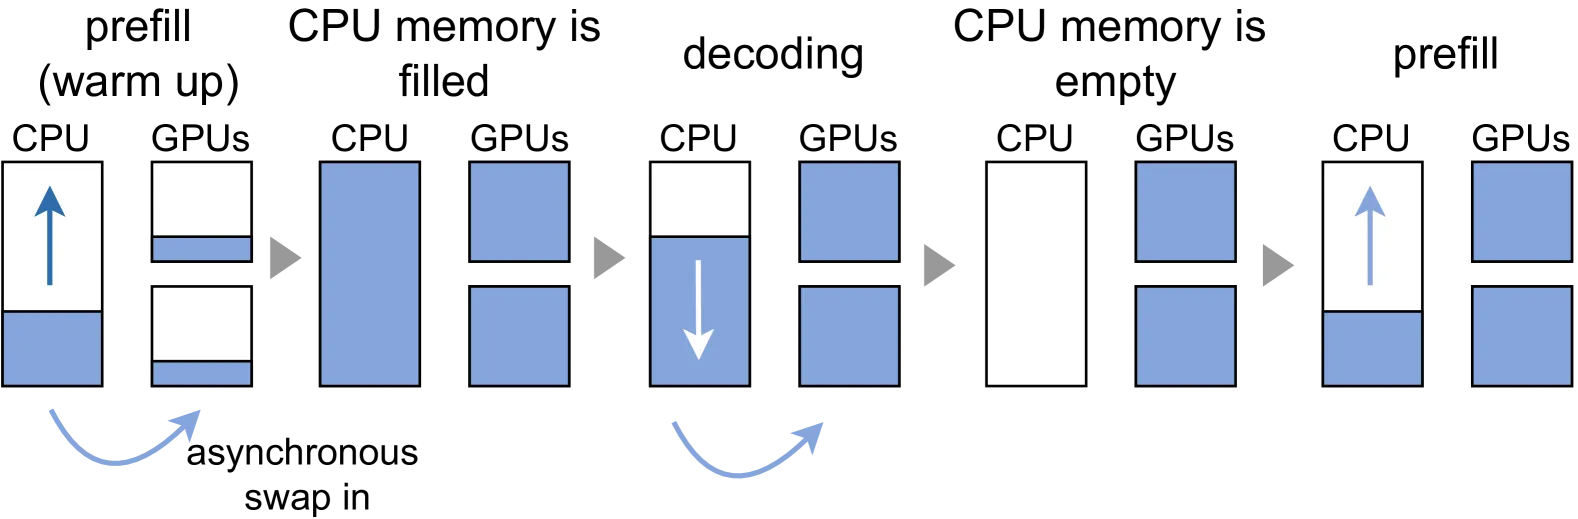
- 分层KV缓存缓冲:通过多级缓存减少重分片开销
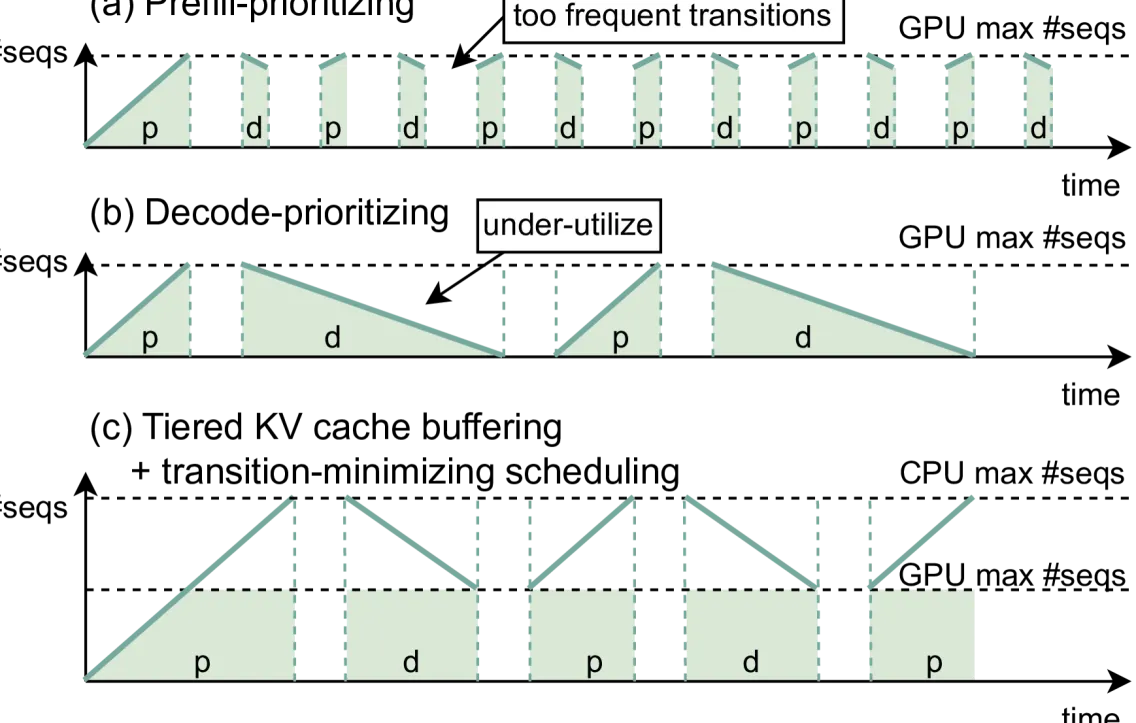
- 转换最小化调度:减少频繁阶段转换带来的开销
- 异步流水线:重叠数据传输与计算
三、技术架构
整体框架图
Seesaw采用单调度器-多工作节点架构:
- 调度器(Scheduler):管理所有生成请求,组织批次,向工作节点发送指令
- 工作节点(Worker):控制单个GPU,维护任务队列执行指令
核心公式
并行策略对吞吐量的影响:
其中:
- :权重数据移动时间
- :线性层计算时间
- :注意力层数据移动时间
- :注意力层计算时间
- :张量并行的通信开销
吞吐量公式:
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 动态模型重分片 | 在预填充和解码阶段切换不同并行策略 | (预填充并行度)、(解码并行度) |
| 分层KV缓存缓冲 | 多级缓存减少重分片开销 | CPU共享内存、GPU HBM |
| 转换最小化调度 | 减少频繁阶段转换 | 批次大小、序列长度 |
| 异步流水线 | 重叠数据传输与计算 | 交换进/出与计算重叠 |
关键观察
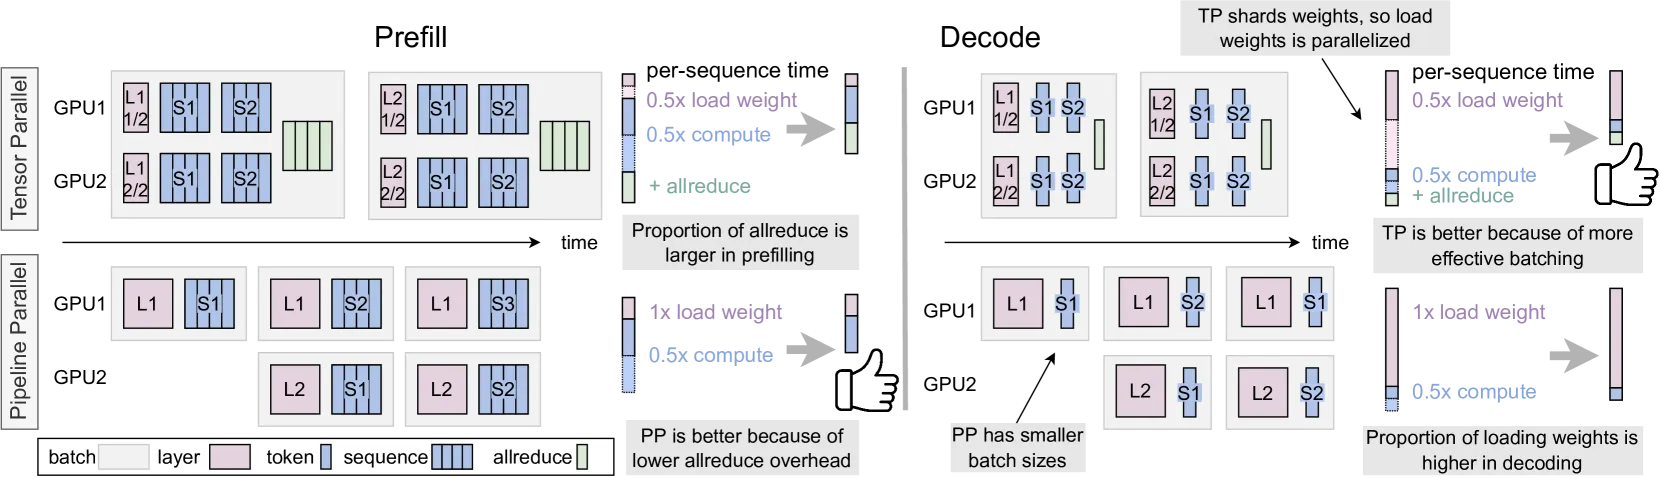
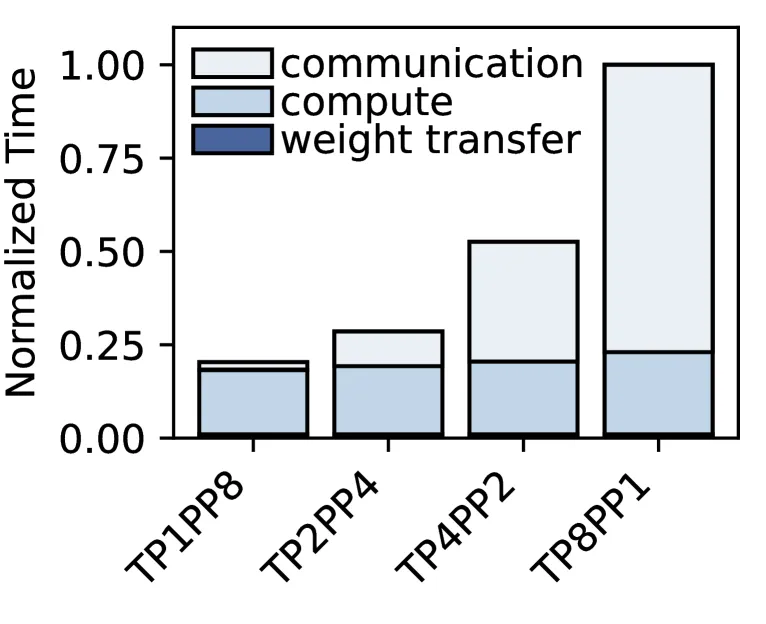
观察1:张量并行在预填充阶段开销大
张量并行在每个层都需要全归约操作,通信开销为:
随着张量并行度增加,通信开销线性增长。
观察2:流水线并行在解码阶段效率低
流水线并行需要将批次分割为微批次,导致:
- 每个微批次重复加载权重到计算单元
- 批次大小被分割为 ,降低了批处理效率
- 最大批量大小受限
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 动态模型重分片 | 为预填充和解码阶段使用不同并行策略 | 预填充偏好PP,解码偏好TP |
| 分层KV缓存缓冲 | 通过CPU共享内存减少重分片开销 | 重分片在交换过程中完成 |
| 转换最小化调度 | 减少频繁阶段转换的开销 | 最大化批处理效率 |
| 异步流水线 | 重叠数据传输与计算 | 隐藏重分片延迟 |
五、实验结果
硬件配置
| GPU型号 | 显存 | 带宽 | FLOPS | NVLink |
|---|---|---|---|---|
| A10 | 24 GiB | 600 GiB/s | 125T | ✗ |
| L4 | 24 GiB | 300 GiB/s | 121T | ✗ |
| A100 | 40 GiB | 1,555 GiB/s | 312T | ✓ |
性能提升
在PCIe系统上(A10/L4):
- A10:几何平均加速比 1.45×,最高 1.78×
- L4:几何平均加速比 1.29×,最高 1.52×
- 整体平均加速比 1.36×
在A100系统上:
- A100 + NVLink:最高 13% 吞吐量提升(当TP>4时)
- A100 + PCIe:最高 46% 吞吐量提升
与vLLM对比:
关键发现
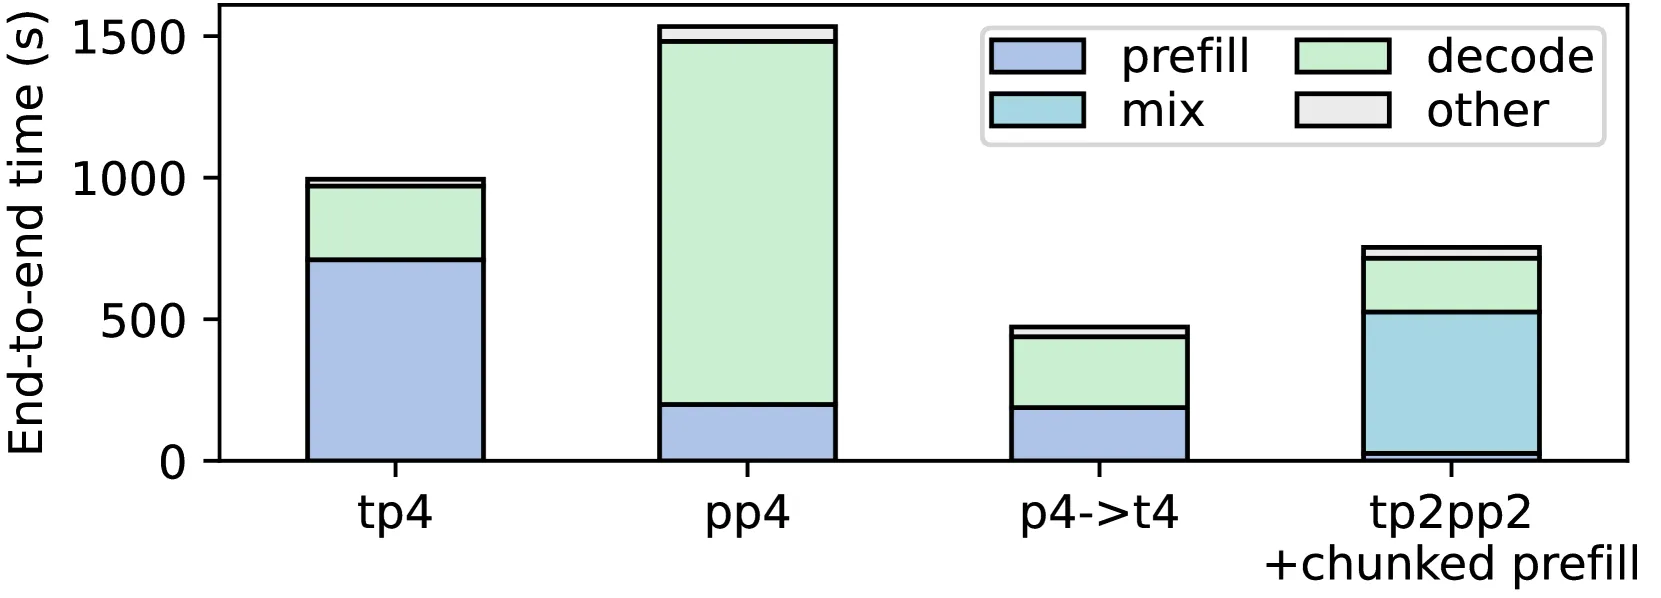
- 预填充阶段:PP4最优,因为通信开销占比小
- 解码阶段:TP4PP2最优,因为权重传输开销被分摊
- 混合策略:Seesaw使用PP4预填充 + TP4解码,实现最优性能
敏感性分析
输入输出长度比例影响:
- 当输出长度为1(仅预填充)时,Seesaw与PP8性能相近
- 随着输出长度增加,PP8的吞吐量迅速下降
- 存在一个区间TP2PP4最优,然后TP4PP2在解码主导时最优
互联带宽影响:
- 带宽较慢时(如分布式设备),流水线并行更优
- 带宽较快时,张量并行的通信开销减小,适用性增强
六、相关工作
| 方法 | 特点 | 与Seesaw的区别 |
|---|---|---|
| vLLM | 静态并行策略 | Seesaw动态切换策略 |
| DistServe | 预填充/解码分离 | Seesaw在同一集群内重分片 |
| Sarathi-serve | 分块预填充 | Seesaw优化批次组织 |
| NanoFlow | 纳米批处理 | 关注点不同 |
七、总结
核心贡献
- 动态模型重分片技术:首次提出在预填充和解码阶段动态切换并行策略
- 分层KV缓存缓冲:通过CPU共享内存高效实现KV缓存重分片
- 转换最小化调度:减少频繁阶段转换的开销
- 全面的性能分析:深入分析不同并行策略在两个阶段的性能特征
技术影响
- 吞吐量提升:相比vLLM平均提升1.36×,最高1.78×
- 资源利用优化:在PCIe系统上显著提升性能,接近NVLink水平
- 通用性:适用于不同模型规模和工作负载
局限性
- 重分片开销:模型权重重分片需要从CPU内存重新加载
- 批次大小限制:流水线并行限制了最大批次大小
- 硬件依赖:在NVLink系统上提升有限(仅13%)
八、参考资源
- 论文:arXiv:2503.06433
- HTML版本:arXiv HTML
- 相关项目:vLLM、DistServe、Sarathi-serve