FlexInfer: Breaking Memory Constraint via Flexible and Efficient Offloading for On-Device LLM Inference
通过灵活高效的卸载打破内存约束实现设备端LLM推理
FlexInfer: Breaking Memory Constraint via Flexible and Efficient Offloading for On-Device LLM Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FlexInfer: Breaking Memory Constraint via Flexible and Efficient Offloading for On-Device LLM Inference |
| 作者 | Hongchao Du, Shangyu Wu, Arina Kharlamova, Nan Guan, Chun Jason Xue |
| 机构 | City University of Hong Kong, MBZUAI |
| 论文 | arXiv:2503.03777 |
| 代码 | 未公开 |
| 发布 | 2025年3月4日 |
| 领域 | 设备端LLM推理、内存优化、卸载技术 |
二、核心思想
问题定义
在设备端部署LLM面临严峻的内存挑战:
- 内存需求高:LLM的参数量巨大,通常超出本地设备内存容量
- 现有方法局限:
- 蒸馏/压缩/剪枝:影响模型性能,缺乏灵活性
- 卸载方法:I/O开销大,不支持灵活的内存使用
- 适应性差:无法灵活适应不同的资源约束环境
解决方案概述
FlexInfer提出一个优化的卸载框架,包含三项核心技术:
- 异步预取(Asynchronous Prefetching):并行化I/O和计算操作
- 平衡内存锁定(Balanced Memory Locking):统一保留模型参数以充分利用可用内存
- 灵活张量保留(Flexible Tensor Preservation):根据用户指定的资源预算确定卸载和保留的参数
三、技术架构
整体框架图
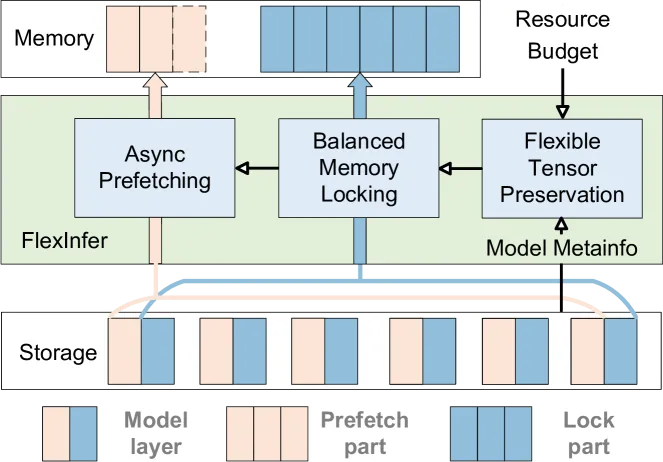
FlexInfer由三个关键组件组成,在推理过程中协同工作:
- 灵活张量保留优化器:根据可用预算和模型元数据确定参数保留计划
- 内存锁定管理器:将模型分为两部分:一部分加载并固定在内存中,另一部分通过预取按需加载
- 异步预取模块:处理按需加载的参数
核心公式
同步卸载吞吐量:
异步预取优化:
通过并行化I/O和计算操作,隐藏I/O延迟:
注意力计算:
前馈网络:
模型组件
| 组件 | 说明 | 关键技术 |
|---|---|---|
| 异步预取 | 并行化I/O和计算 | 多线程预取、计算-IO重叠 |
| 平衡内存锁定 | 统一保留模型参数 | 层级平衡、内存最大化利用 |
| 灵活张量保留 | 智能参数选择 | 预算感知、动态调整 |
关键技术详解
异步预取
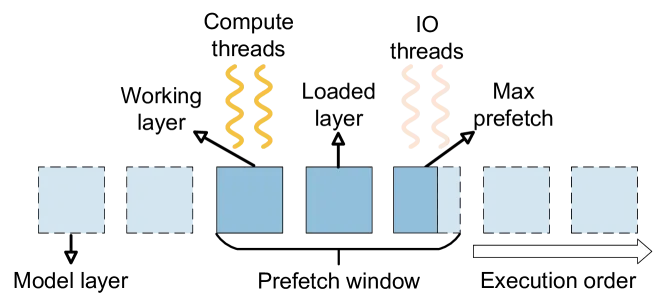
- 问题:同步I/O导致推理性能受限于I/O带宽
- 解决方案:并行化I/O和计算操作
- 效果:通过预取并行化,性能提升34.8-59.4%
平衡内存锁定
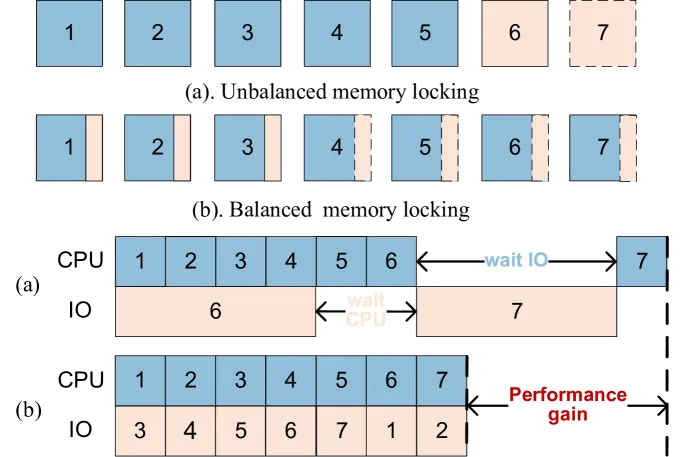
- 问题:按层顺序锁定参数导致内存利用不均衡
- 解决方案:统一保留模型参数以充分利用可用内存
- 效果:在最小内存设置下提升9.2-11.1%
灵活张量保留
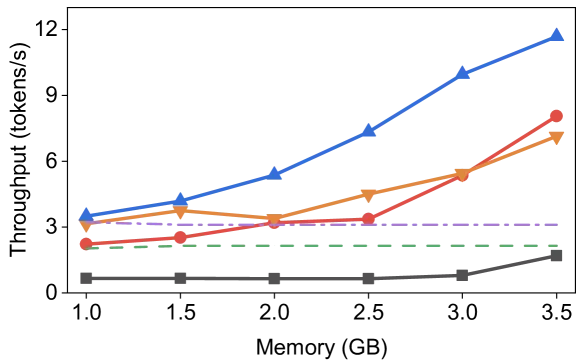
- 问题:现有方法不支持灵活的内存使用
- 解决方案:根据用户指定的资源预算确定卸载和保留的参数
- 效果:支持不同内存预算下的最优参数保留
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 异步预取 | 并行化I/O和计算操作 | 性能提升34.8-118.8% |
| 平衡内存锁定 | 统一保留模型参数 | 内存利用率提升9.2-11.1% |
| 灵活张量保留 | 预算感知的参数选择 | 支持不同内存预算 |
| 精确内存管理 | 最小化I/O瓶颈 | 吞吐量提升5.2-12.5倍 |
五、实验结果
实验设置
- 硬件:Ubuntu服务器,512GB内存,AMD 7995WX CPU
- 模型:Llama2系列(7B, 13B, 34B, 70B)
- 基线:mmap(MMAP)、无预取(Flex. w/o Prefetch)、无平衡锁定(Flex. w/o Balance)
性能提升
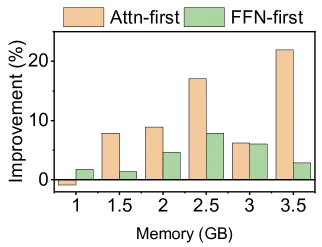
关键结果:
| 模型 | 模型大小 | 全内存性能 | FlexInfer提升 |
|---|---|---|---|
| Llama2-7B | 3.8GB | 12.72 tokens/s | 5.2-12.5× |
| Llama2-13B | 7.3GB | 6.74 tokens/s | 5-11.8× |
| Codellama-34B | 17.9GB | 2.6 tokens/s | 4.2-10.6× |
| Llama2-70B | 36.4GB | 1.3 tokens/s | 5-11× |
消融实验
异步预取效果:
- 内存有限时:性能提升34.8-59.4%
- 内存增加时:性能提升69.9-118.8%
平衡内存锁定效果:
- 最小内存设置下:性能提升9.2-11.1%
- 随内存增加,差异减小
同步读取 vs 预取:
- 同步读取:性能提升2.6-3×(证明I/O是主要瓶颈)
- 预取:进一步提升34.8-59.4%
关键发现
- I/O是主要瓶颈:在内存受限条件下,I/O是大模型推理的主要瓶颈
- 异步预取有效:通过并行化I/O和计算,显著提升性能
- 平衡锁定重要:统一保留参数可以充分利用可用内存
- 灵活适应性:FlexInfer可以适应不同的资源约束环境
六、相关工作
| 方法 | 特点 | 与FlexInfer的区别 |
|---|---|---|
| mmap | 系统默认方法 | 性能差,0.08-0.67 tokens/s |
| FlexGen | 高吞吐量卸载 | 不支持灵活内存使用 |
| PowerInfer | 消费级GPU推理 | 需要GPU支持 |
| PowerInfer-2 | 智能手机推理 | 特定硬件优化 |
| LLMCad | 设备端推理 | 不支持灵活预算 |
七、总结
核心贡献
- FlexInfer框架:首个支持灵活内存预算的LLM卸载推理框架
- 异步预取技术:并行化I/O和计算,显著降低I/O开销
- 平衡内存锁定:统一保留参数,最大化内存利用
- 灵活张量保留:根据预算智能选择保留参数
技术影响
- 性能提升:相比mmap提升5.2-12.5倍吞吐量
- 灵活性:支持不同内存预算下的最优配置
- 实用性:适用于资源受限的设备端部署
- 通用性:支持多种LLM模型(7B-70B)
局限性
- CPU推理:主要针对CPU推理优化,未充分利用GPU
- 硬件依赖:性能受存储设备I/O带宽限制
- 模型支持:主要验证于Llama2系列模型
八、参考资源
- 论文:arXiv:2503.03777
- HTML版本:arXiv HTML
- 相关项目:FlexGen、PowerInfer、PowerInfer-2