PSA: Progressive Sparse Attention — Algorithm and System Co-design for Efficient Attention in LLM Serving
PSA提出渐进式稀疏注意力机制,通过阈值驱动的自适应KV块选择替代固定top-k策略,结合流水线迭代执行和统一内存管理,在保证精度的同时最大化推理吞吐。
PSA: Progressive Sparse Attention — Algorithm and System Co-design for Efficient Attention in LLM Serving
一、论文概述 (Overview)
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | Progressive Sparse Attention: Algorithm and System Co-design for Efficient Attention in LLM Serving |
| arXiv ID | 2503.00392 |
| 作者 | Qihui Zhou, Peiqi Yin, Pengfei Zuo, James Cheng |
| 机构 | 香港中文大学 (CUHK), 华为云 |
| 论文 | https://arxiv.org/abs/2503.00392 |
| 代码 | https://github.com/ASISys/PSAttention |
| 发布日期 | 2025-03-01 |
1.2 摘要
长上下文处理已成为现代大语言模型(LLM)的关键能力。然而,LLM推理中的键值(KV)缓存带来了巨大的显存开销。现有动态稀疏注意力算法(DSAes)采用 top-k KV 缓存选择策略,在精度和效率之间存在难以调和的权衡:更大的 k 提升精度但降低效率,更小的 k 提升效率但损害精度。
本文提出 PSA(Progressive Sparse Attention)——一种将算法创新与系统协同设计的渐进式稀疏注意力机制。PSA 根据每个 token 和层的真实注意力权重分布,自适应地调整 KV 缓存预算,而非依赖固定的预算 k。这实现了高推理精度与高效率的统一。此外,PSA 引入了流水线迭代方案以减少 CPU-GPU 交错和同步开销,并实现了统一 GPU 内存管理来优化不同模型层间不均衡的内存需求。实验表明,PSA 相比最先进的 DSAes 将 KV 缓存使用量最多减少 2.4×,相比无稀疏注意力的系统最多减少 8.8×,端到端服务吞吐量提升最多 1.4× 和 2.0×。
1.3 核心贡献
- 问题发现: 系统性分析现有 DSAes 的 top-k 选择策略,揭示固定 KV 预算在不同 token 和层间注意力稀疏性变化时的固有缺陷
- 渐进式稀疏注意力算法: 提出基于阈值的 KV 块选择方案,自适应地为每个 token 的每层分配 KV 缓存预算
- 流水线迭代执行: 通过分离线程和 CUDA 流实现数据加载与注意力计算的重叠,消除 CPU-GPU 同步瓶颈
- 统一 GPU 内存管理: 合并所有层的 GPU 内存为统一的 KV 块池,解决层间注意力稀疏性差异导致的缓存命中率不均问题
- 原型实现与评估: 基于 vLLM 实现约 6000 行代码,在 LWM-Text-7B 和 Llama-3.1-8B 上验证
二、核心思想 (Core Ideas)
2.1 问题定义
LLM 推理中,KV 缓存大小随序列长度线性增长。以 Llama-3.1 8B 为例,128K 上下文长度的单个请求需要高达 62 GB 的 KV 缓存显存(远超模型权重的 16 GB),严重限制了推理 batch size 和吞吐量。
动态稀疏注意力算法(DSAes)观察到注意力计算具有高度稀疏性——只有少量关键 token 贡献了大部分注意力权重。因此 DSAes 采用 select-then-compute 的方式,动态选择少量关键 KV 块进行注意力计算,从而允许将 KV 缓存卸载到主机内存。
2.2 Top-k 选择的困境
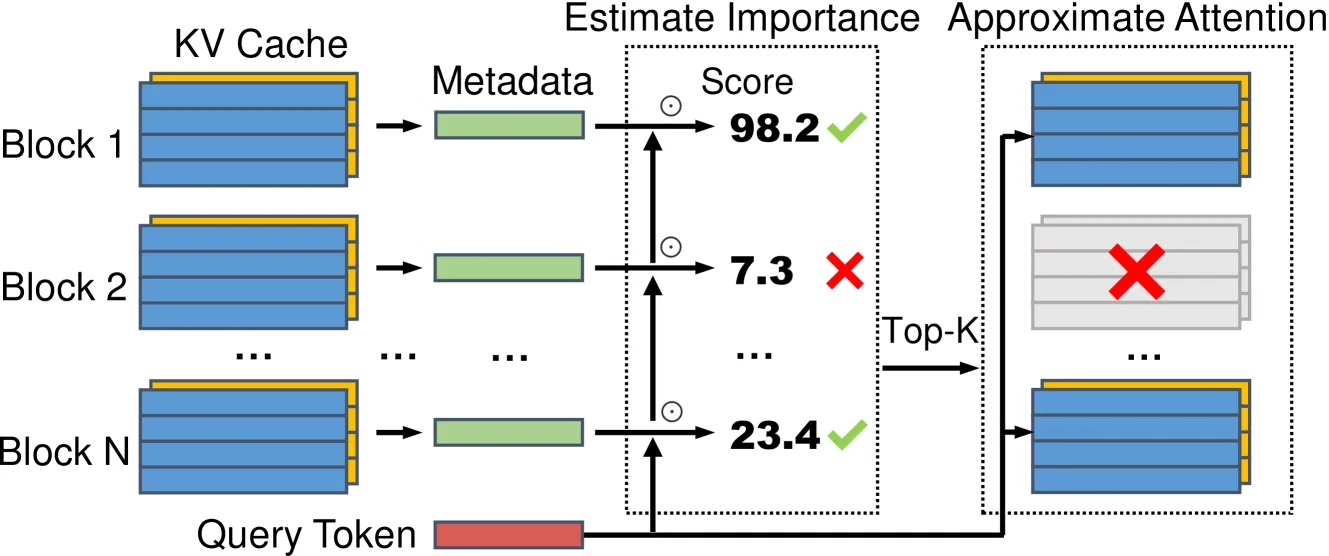
现有 DSAes 采用 top-k KV 块选择策略:对所有 token 和层使用相同的固定 KV 缓存预算 k。这导致以下问题:
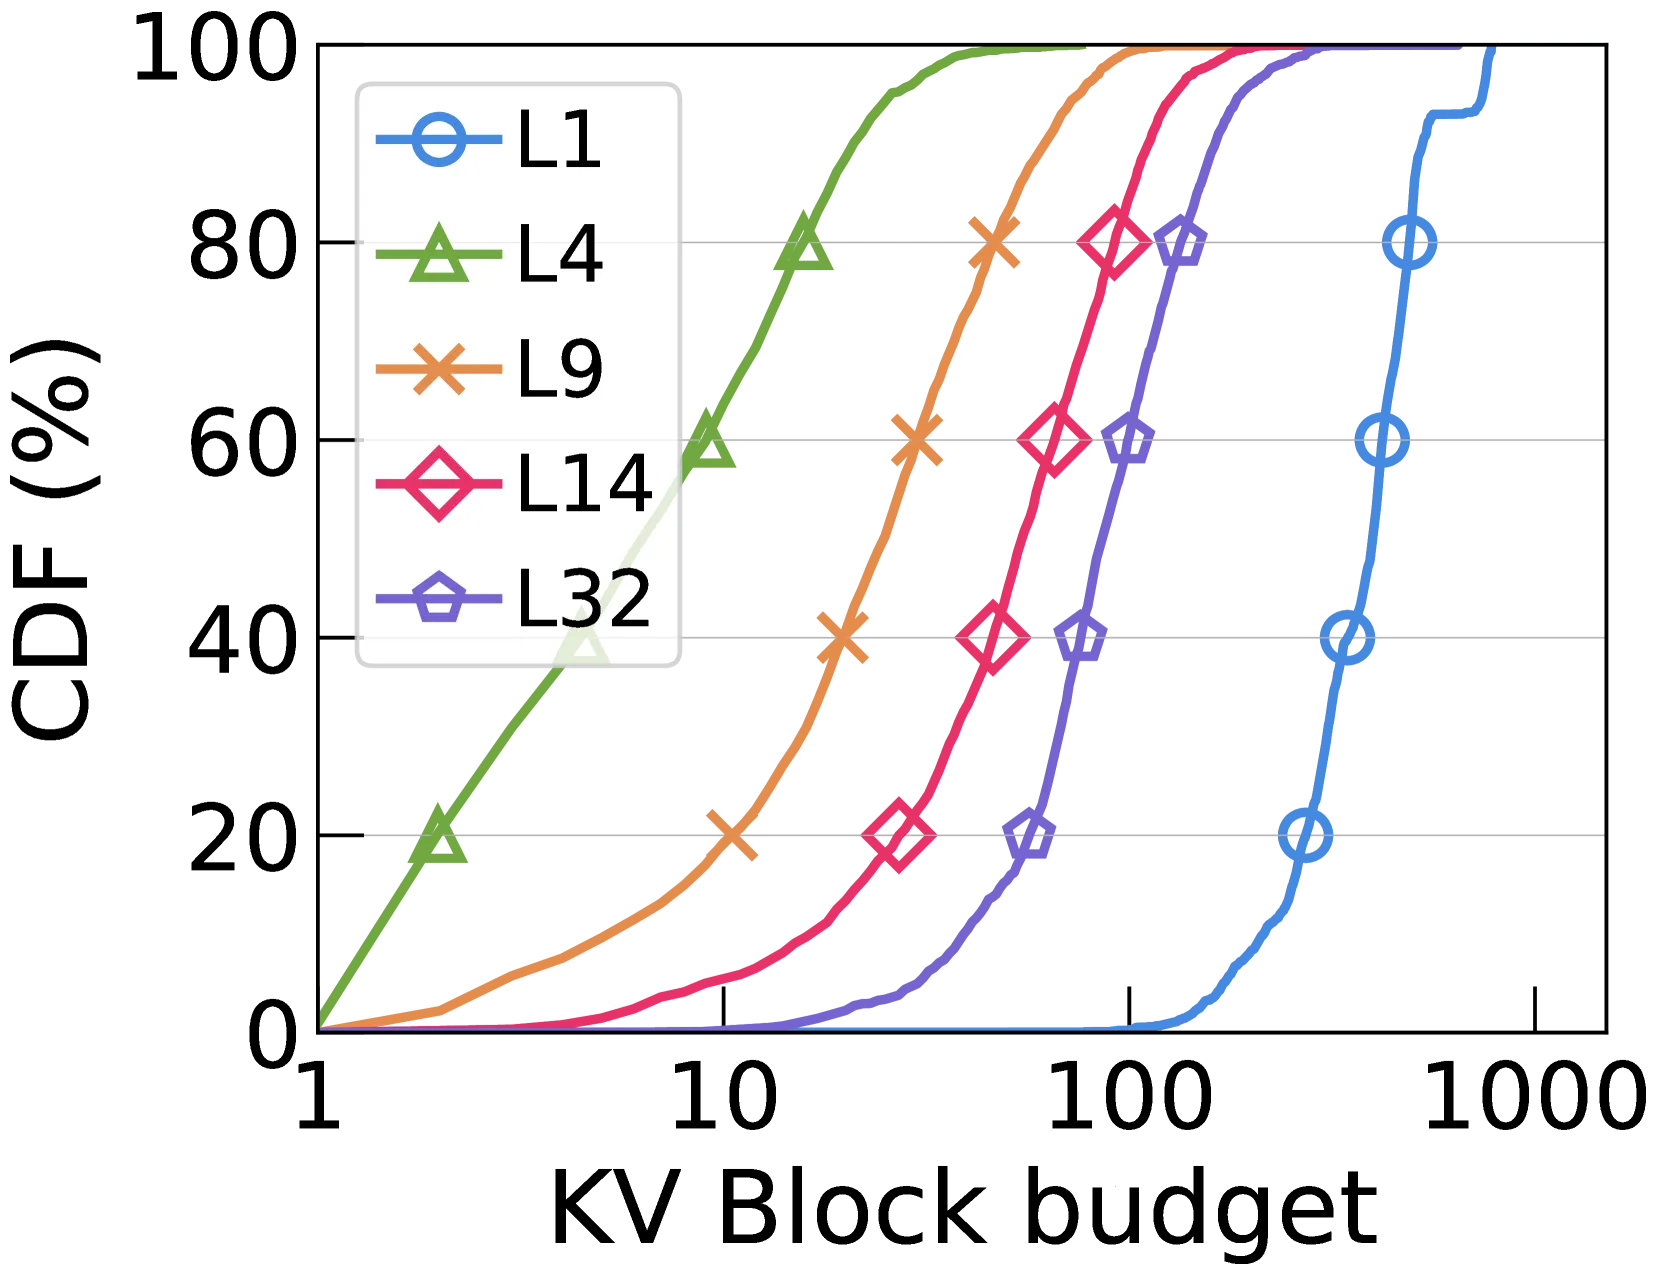
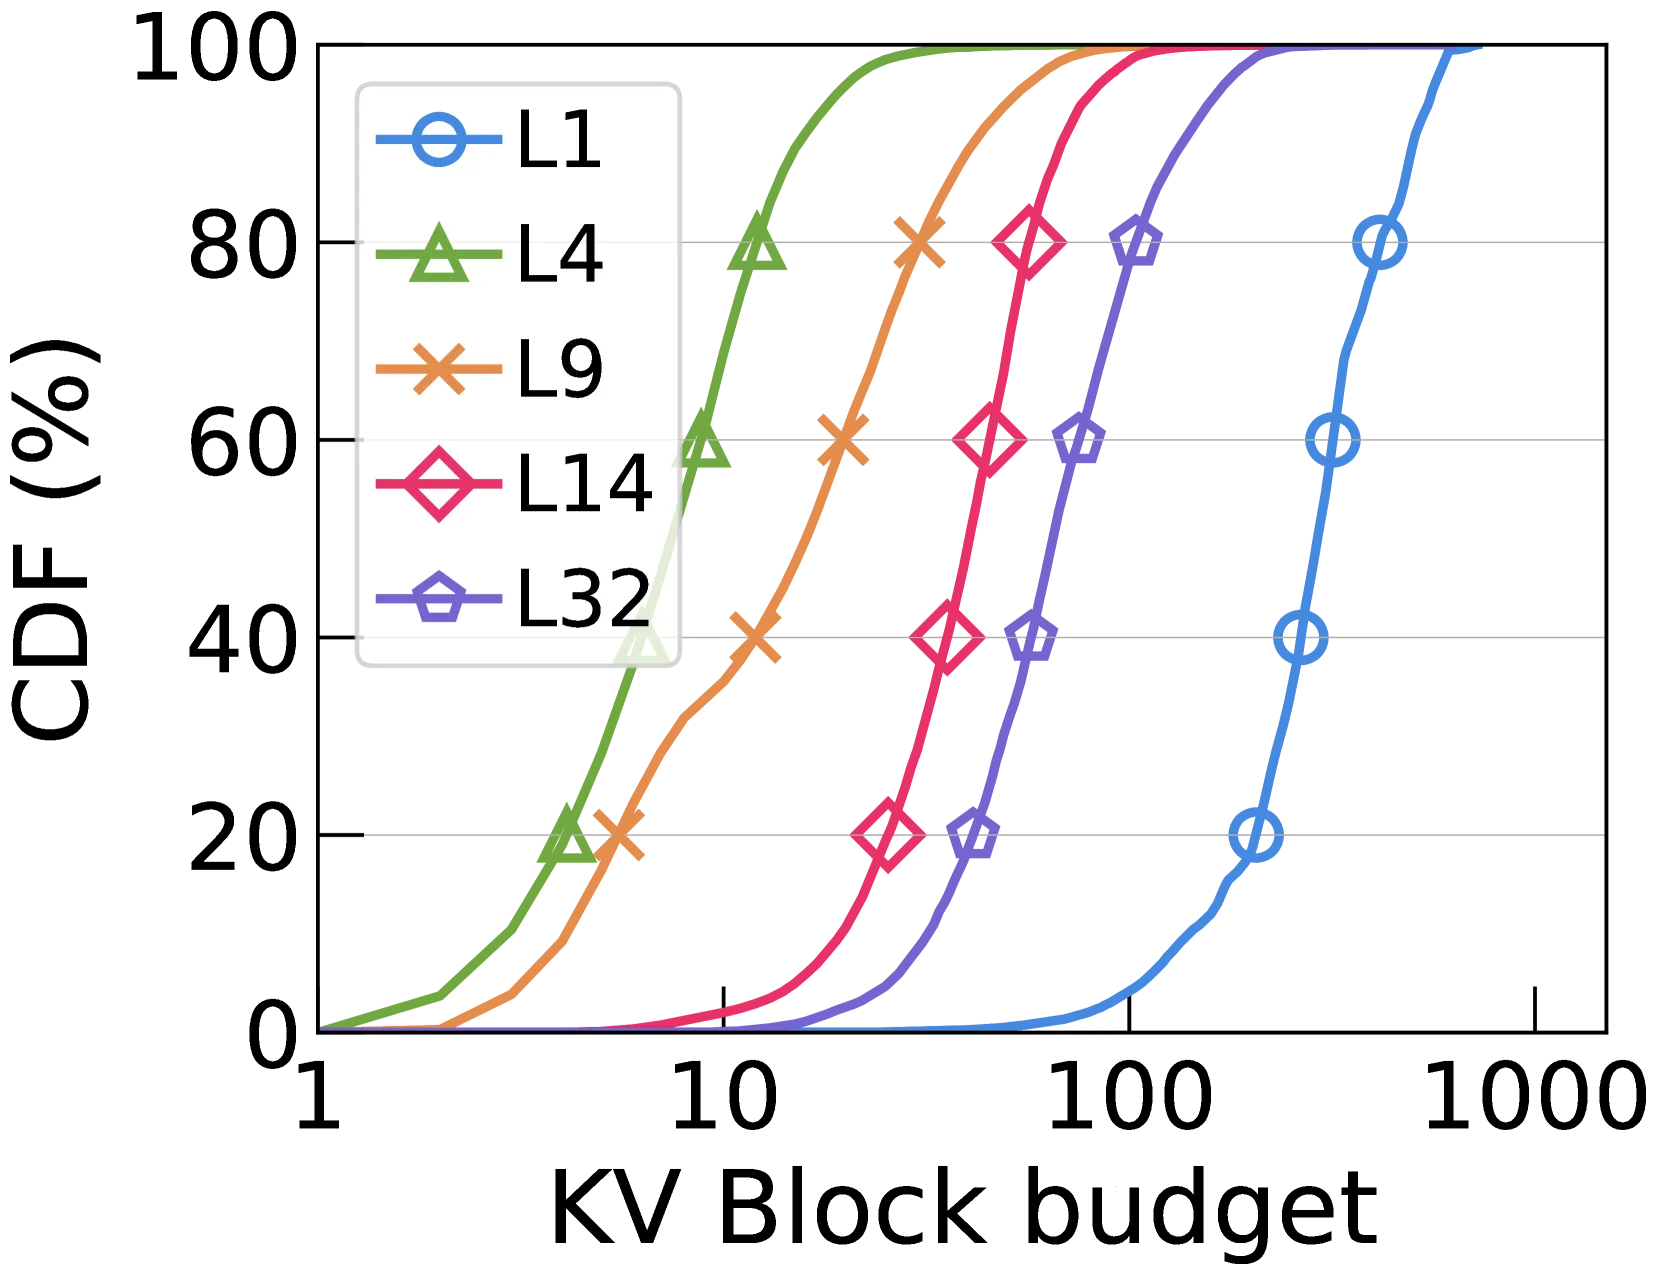
Observation 1: 注意力稀疏性在不同 token 间变化显著。以 LWM-Text-7B 的 GovReport 数据集为例,在 Layer 32 中:
- 20% 的查询 token 需要 < 50 个 KV 块即可累积 95% 注意力权重
- 60% 的查询 token 需要 50-100 个 KV 块
- 20% 的查询 token 需要 > 100 个 KV 块
Observation 2: 注意力稀疏性在不同层间也变化显著。在 QMSum 数据集中,Layer 9 中 80% 的 token 需要 < 50 个 KV 块,而 Layer 1 中该数字降至 40%。
结论: 固定 top-k 选择无法同时满足精度和效率。较小的 k 导致大多数 token 注意力权重不足(精度差),较大的 k 导致短序列 token 过度选择 KV 块(效率低)。
2.3 PSA 的核心思路
PSA 采用阈值驱动的渐进式选择方案:
- 设定累积注意力权重阈值(如 95%),由 LLM 服务提供商配置
- 对每个 query token 的每层,从最关键 KV 块开始,逐个计算注意力
- 实时监测累积注意力权重,一旦超过阈值即终止
- 不同 token/层自动获得不同的 KV 块预算,无需人工调参
这种方法的核心优势是自适应——每个 token 根据其真实的注意力权重分布获得精确所需的 KV 缓存量。
三、技术架构 (Technical Architecture)
3.1 系统架构
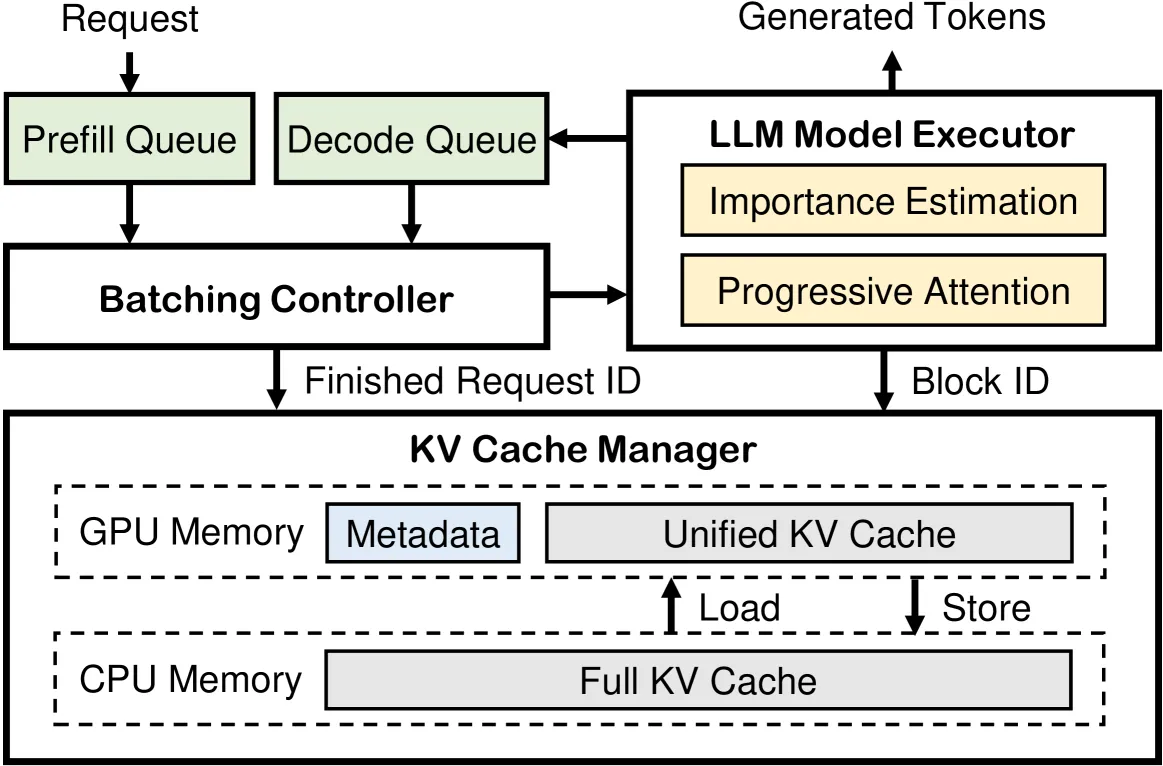
PSA 系统由三个核心组件构成:
| 组件 | 职责 |
|---|---|
| Batch Controller | 动态分组请求(FCFS),确保每批次的 KV 块能装入 GPU 显存 |
| Model Executor | 执行模型前向计算,用渐进式注意力替换标准注意力计算 |
| KV Cache Manager | 维护 GPU/主机间的分层 KV 块存储,管理 KV 块的分配、卸载和缓存 |
数据流:
- Batch Controller 将请求分组并转发给 Model Executor
- Model Executor 发送新生成的 KV 缓存给 KV Cache Manager
- KV Cache Manager 将 KV 缓存写入 GPU 块,满后异步刷新到主机内存
- KV 块元数据保留在 GPU 内存中(因体积小),用于每次注意力计算中的关键度估计
- Model Executor 向 KV Cache Manager 请求所需 KV 块的 ID 触发数据加载
3.2 渐进式稀疏注意力算法 (PSAttention)
算法核心: 基于累积注意力权重阈值的渐进式 KV 块选择
输入: query 向量 q 和 KV 块索引集 B 输出: 近似注意力输出 O_acc
def PSAttention(q, B):
    O_acc ← [0, ..., 0]_d          // 初始化累积输出
    AS_acc ← 0                      // 累积注意力权重
    AS_min ← MAX_VAL                // 最小注意力权重
    CS ← q · B_meta                 // 计算每个KV块的关键度得分
    B' ← Rank(B by CS)              // 按关键度排序
    N_left ← Len(B)                 // 剩余块数

    for each block b in B':
        KV_b ← Load(b)              // 从主机加载KV块
        O, AS ← Attention(q, KV_b)  // 计算局部注意力
        O_acc ← (AS_acc · O_acc + AS · O) / (AS_acc + AS)  // 加权融合
        AS_acc ← AS_acc + AS        // 更新累积注意力权重
        AS_min ← min(AS_min, AS)    // 跟踪最小注意力权重
        N_left ← N_left - 1

        // 检查终止条件
        if (AS_acc / (AS_acc + AS_min)) ≥ threshold:
            break                     // 累积权重达到阈值,提前终止

return O_acc关键设计:
- 渐进式计算: 从最关键块开始,逐步增加参与计算的 KV 块
- 加权融合: 使用累积注意力权重作为权重,逐步融合各块的注意力输出
- 早停机制: 当
AS_acc / (AS_acc + AS_min) ≥ threshold时终止,避免不必要的计算 - 阈值设定: 典型值为 95%,由服务提供商根据精度-效率需求配置
3.3 流水线迭代执行 (Pipelined Iteration Execution)
PSA 将注意力过程分解为多次迭代,带来两个性能挑战:
- GPU 利用率低: CPU 数据准备与 GPU 计算交错
- 同步开销大: CPU-GPU 间频繁传输注意力权重
解决方案:
| 优化 | 方法 | 效果 |
|---|---|---|
| 分离线程 | 数据准备和注意力计算分配到不同线程 | 避免互相阻塞 |
| CUDA 流 | 使用独立的 CUDA 流实现数据传输与内核执行的流水线重叠 | 最大化 GPU 并行度 |
| 验证 GPU 核函数 | 在 GPU 上直接更新和检查累积注意力权重 | 消除 CPU-GPU 同步传输 |
| Zero-copy 通知 | 阈值达标后,GPU 核函数通过零拷贝技术写入 pinned host memory 信号变量 | 异步通知 CPU 终止 |
3.4 统一 GPU 内存管理 (Unified Memory Management)
问题: 现有 LLM 推理系统(如 vLLM)采用层分离的内存管理——每层分配相等的 GPU 内存容量。但在 PSA 中,不同层的注意力权重偏斜程度差异显著:低偏斜层访问的 KV 块远多于高偏斜层,导致缓存命中率不均。
PSA 方案:
- 通过 profile 确定可用 GPU 内存容量
- 分配单个 GPU 张量而非每层独立分配
- 将该张量划分为等大小的槽位存储 KV 块
- 所有层的所有 KV 块操作(分配、释放、加载)统一由 KV Cache Manager 处理
- 采用 LRU 策略进行 KV 块缓存驱逐(利用连续解码 token 间的语义相似性)
四、核心创新 (Key Innovations)
| 创新点 | 说明 | 与传统方法的区别 |
|---|---|---|
| 阈值驱动渐进选择 | 替代固定 top-k,自适应每个 token/层的 KV 预算 | 无需为不同请求手动调参 |
| 流水线迭代执行 | CUDA 流+分离线程重叠数据加载与计算 | 消除 CPU-GPU 同步瓶颈 |
| 验证 GPU 核函数 | 在 GPU 上直接检查累积权重,零拷贝通知 | 避免注意力权重跨设备传输 |
| 统一内存管理 | 合并所有层的 GPU 内存为统一 KV 块池 | 解决层间稀疏性差异导致的缓存不均 |
| 算法+系统协同设计 | 算法创新与系统优化深度融合 | 不仅是算法改进,更是完整的推理系统 |
五、实现细节 (Implementation)
- 框架: 基于 vLLM 实现,约 6000 行代码
- 请求调度: 仅需单轮迭代的 KV 块能装入 GPU 即可调度请求,无需全部 KV 缓存
- FlashAttention 兼容性: 由于 PSA 需要存储注意力权重以估计累积权重,与 FlashAttention 不兼容。通过聚合块内 token 的注意力权重至片上内存,再写回 HBM 来缓解
- 元数据构建: 默认使用 cuboid-mean 方法(Arkvale),也可集成其他方法
- 缓存驱逐: 当前使用 LRU,可轻松切换为 FIFO 或其他策略
六、实验结果 (Experimental Results)
6.1 实验设置
| 配置项 | 详情 |
|---|---|
| 硬件 | Nvidia A100 40GB GPU, AMD EPYC 7J13 CPU, 128GB DRAM, PCIe Gen 4 (32 GB/s) |
| 模型 | LWM-Text-7B (1M 上下文, MHA), Llama-3.1-8B (128K 上下文, GQA) |
| 数据集 | LongBench: HotpotQA, 2WikiMultihopQA, MultifieldQA, Qasper, GovReport, QMSum, MultiNews, SAMSum |
| 基线 | vLLM (完整 KV), vLLM-Sparse (Arkvale), InfiniGen (token级稀疏) |
| SLO | 严格: P99 TBT ≤ 5× 解码迭代时间; 宽松: ≤ 25× |
6.2 KV 缓存缩减
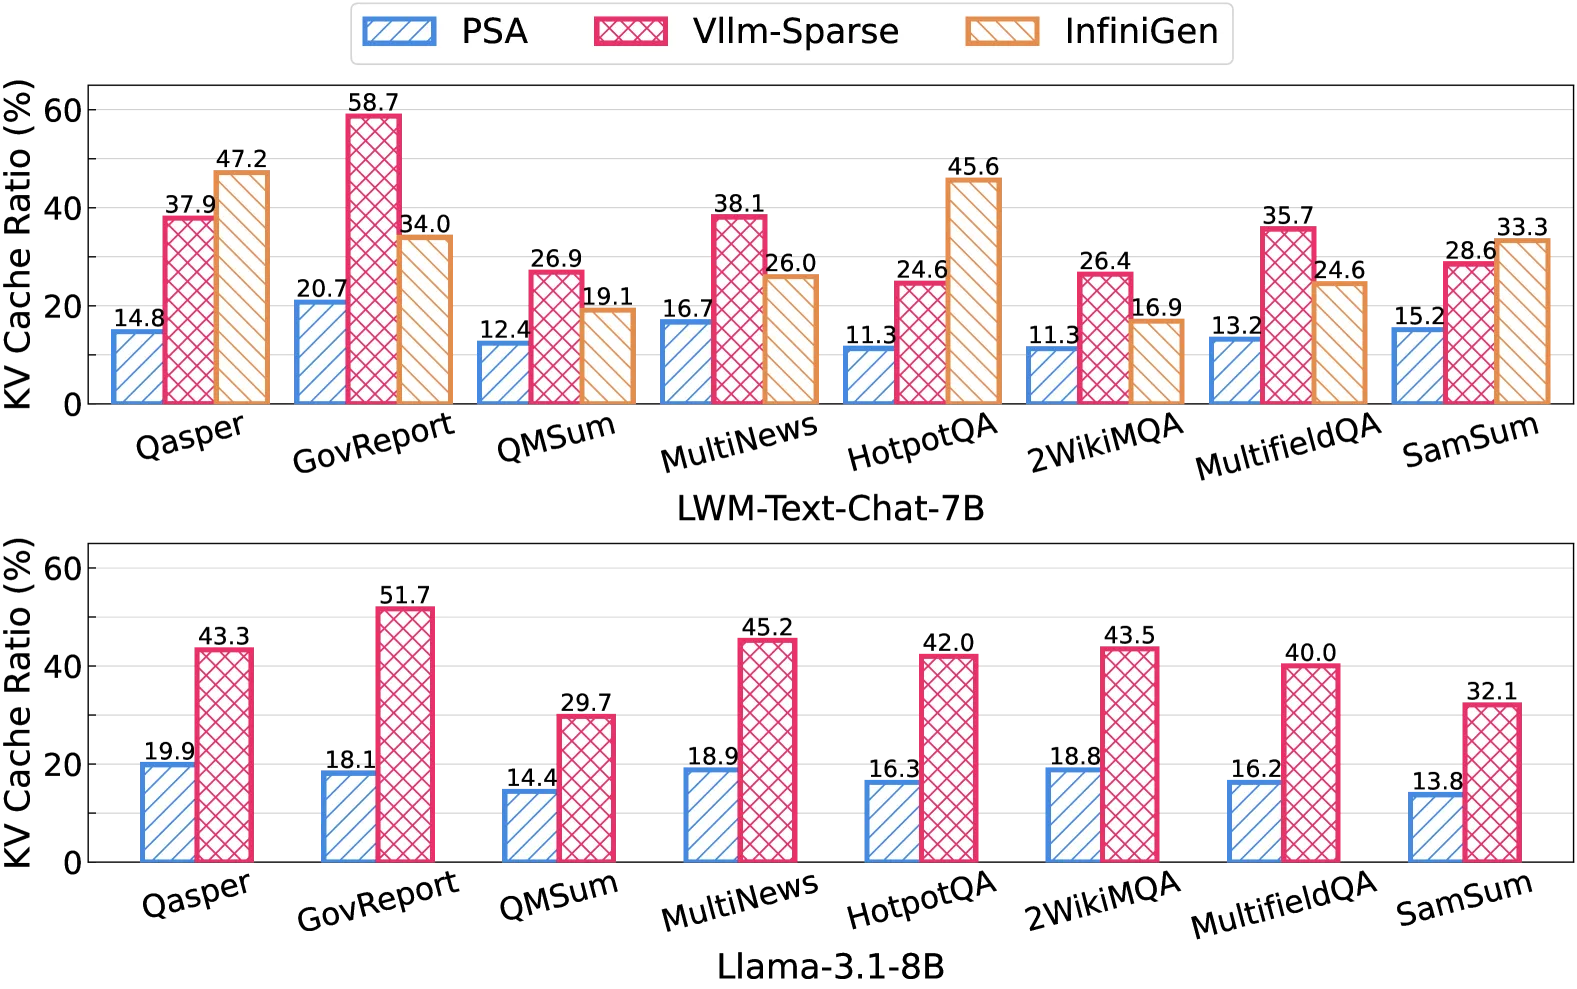
在保持 98% 平均请求精度的条件下:
| 模型 | vs vLLM-Sparse | vs InfiniGen |
|---|---|---|
| LWM-Text-7B | 2.1× KV 缓存减少 | 1.8× KV 缓存减少 |
| Llama-3.1-8B | 2.4× KV 缓存减少 | N/A (不支持 GQA) |
原因分析: vLLM-Sparse 对所有请求分配统一 KV 预算,导致短序列过度选择 KV 块。PSA 根据注意力权重分布动态调整,最小化 KV 缓存使用。
6.3 吞吐量提升
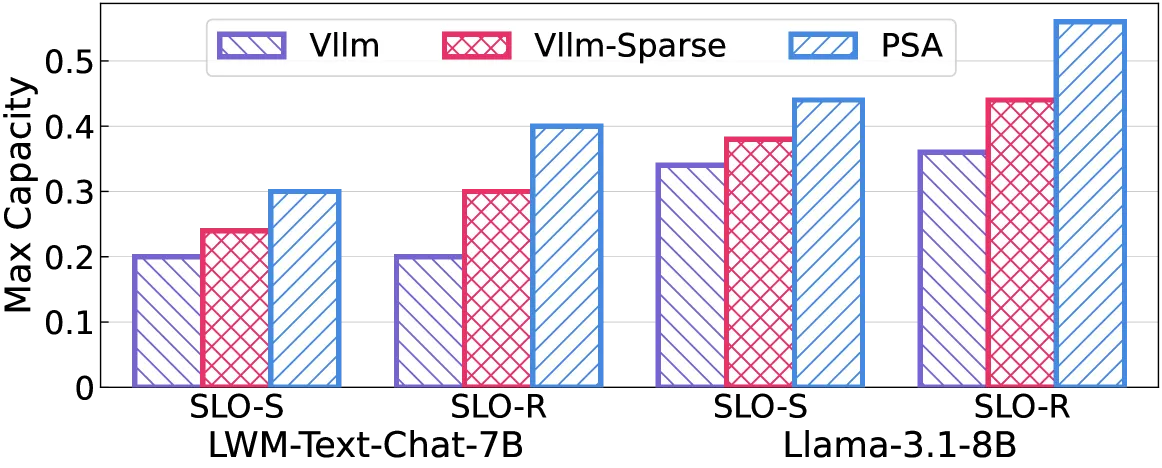
vs vLLM (完整 KV):
- 严格 SLO: PSA 实现 1.5× (LWM-7B) 和 1.3× (Llama-8B) 更高吞吐量
- 宽松 SLO: 进一步提升至 2.0× (LWM-7B) 和 1.5× (Llama-8B)
vs vLLM-Sparse (Arkvale):
- 严格 SLO: PSA 支持 1.3× 更高负载
- 宽松 SLO: PSA 支持 1.4× (LWM-7B) 和 1.3× (Llama-8B) 更高负载
原因: PSA 减少 KV 缓存使用量使 GPU 能够容纳更大 batch size,直接提升吞吐量。
6.4 精度保证
PSA 在 8 个 LongBench 数据集上均保持 ≥ 98% 的平均请求精度(相对于 vLLM 完整注意力)。通过调整累积注意力权重阈值,用户可在精度和效率之间灵活权衡。
七、相关工作 (Related Work)
静态稀疏注意力
H2O, StreamingLLM, SnapKV, FastGen, ScissorHands 等算法静态丢弃不重要 token 的 KV 缓存。但这些方法无法应对 token 重要性随解码过程变化的情况,可能导致重要信息丢失。
动态稀疏注意力
Arkvale, InfLLM, Quest 等 DSAes 动态选择关键 KV 缓存。PSA 是首个同时考虑 DSAes 在实际 LLM 推理系统中部署效率的工作,通过算法与系统协同设计实现高精度和高效率。
Token 级稀疏注意力
InfiniGen, TokenSelect, RetrievalAttention, MagicPig 等在 token 级别进行 KV 缓存选择。但 token 级选择在运行时引入显著开销,block 级选择在精度和性能开销间取得更好平衡。
正交工作
GemFilter, Minference, SeerAttention, NSA 等针对预填充阶段和训练的稀疏注意力方法与 PSA 正交,可结合使用进一步提升整体效率。
八、总结 (Conclusion)
8.1 核心成就
- 系统性洞察: 首次揭示 DSAes 中 top-k 选择的根本局限——无法适应 token 和层间注意力稀疏性的变化
- 算法创新: 提出渐进式稀疏注意力,通过阈值驱动的自适应 KV 块选择打破精度-效率权衡
- 系统优化: 流水线迭代执行 + 统一内存管理,将算法优势转化为实际的推理效率提升
- 性能突破: KV 缓存最多减少 2.4×(vs SOTA DSAes),端到端吞吐最多提升 2.0×(vs vLLM)
8.2 适用场景
- 需要处理超长上下文(128K-1M)的 LLM 推理服务
- 对推理成本敏感的生产环境
- 需要同时保证精度和效率的多任务 LLM 服务
- 已有 GPU-Host 分层存储架构的推理系统
8.3 局限性
- 当前未与 FlashAttention 兼容(需存储注意力权重),限制了部分加速
- 实验仅在单节点 A100 上验证,多 GPU/多节点扩展待研究
- LRU 缓存策略可能非最优,更复杂的驱逐策略值得探索
- 阈值参数需要人工配置,自动化调参是一个开放问题
九、参考资源 (References)
论文链接
关键参考文献
| 编号 | 论文 | 关键贡献 |
|---|---|---|
| [7] | Arkvale | 块级 DSA,cuboid-mean 元数据方法 |
| [39] | InfLLM | 动态稀疏注意力,检索增强 KV 缓存 |
| [36] | Quest | 动态稀疏注意力,量化感知选择 |
| [22] | InfiniGen | Token 级稀疏注意力,权重矩阵压缩 |
| [20] | PagedAttention/vLLM | 块级 KV 缓存管理 |
| [45] | H2O | KV 缓存 eviction (sample+token) |
| [40] | StreamingLLM | 注意力空洞现象 + KV 缓存演化 |
| [24] | SnapKV | 基于空间压缩的 KV 缓存 |
| [3] | LongBench | 长上下文理解基准测试 |
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | DSA 动态选择算法工作流 | figure-1-dsa-workflow.png |
| Figure 2 | QMSum/GovReport 注意力稀疏性 CDF 分布 | figure-2a-qmsum-sparsity.png, figure-2b-govreport-sparsity.png |
| Figure 3 | PSA 系统架构总览 | figure-3-system-architecture.png |
| Figure 4 | PSA 算法执行示例 | figure-4-psa-algorithm-example.png |
| Figure 5 | KV 缓存缩减对比(vs Arkvale/InfiniGen) | figure-5-kv-cache-reduction.png |
| Figure 6 | SLO 约束下的吞吐量对比 | figure-6-throughput-under-slo.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer