COMET: Fine-grained Computation-communication Overlapping for Mixture-of-Experts
COMET提出细粒度计算-通信重叠技术,优化混合专家模型的分布式推理效率。
COMET: Fine-grained Computation-communication Overlapping for Mixture-of-Experts
一、论文概述
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | Comet: Fine-grained Computation-communication Overlapping for Mixture-of-Experts |
| arXiv ID | 2502.19811 |
| 发表日期 | 2025年2月27日 (v1), 2025年3月4日 (v3) |
| 机构 | ByteDance Seed, 上海交通大学 |
| 代码仓库 | https://github.com/bytedance/flux |
1.2 研究背景
混合专家模型(Mixture-of-Experts, MoE)已被广泛应用于将大语言模型扩展至万亿参数规模,同时保持固定的计算成本。然而,在分布式场景下,MoE模型的开发面临着巨大的通信开销问题。
核心问题:
- MoE层的设备间通信可占据整个模型执行时间的47%
- 现有的粗粒度重叠方案会显著损害计算效率
- 延迟隐藏效果不佳
1.3 核心贡献
COMET提出了两个关键设计:
- 基于共享张量的依赖解析方法:识别MoE中通信和计算操作之间的复杂数据依赖,实现优化的流水线结构
- 自适应负载分配方法:在内核中动态分配GPU线程块,平衡通信和计算以提高延迟隐藏效果
性能提升:
- 单个MoE层加速:1.96x
- 端到端执行加速:1.71x (平均)
- 通信延迟隐藏率:86.5%
二、核心思想
2.1 问题分析
MoE层执行涉及三个阶段:
- 数据接收(通信)
- 专家计算
- 数据传输(通信)
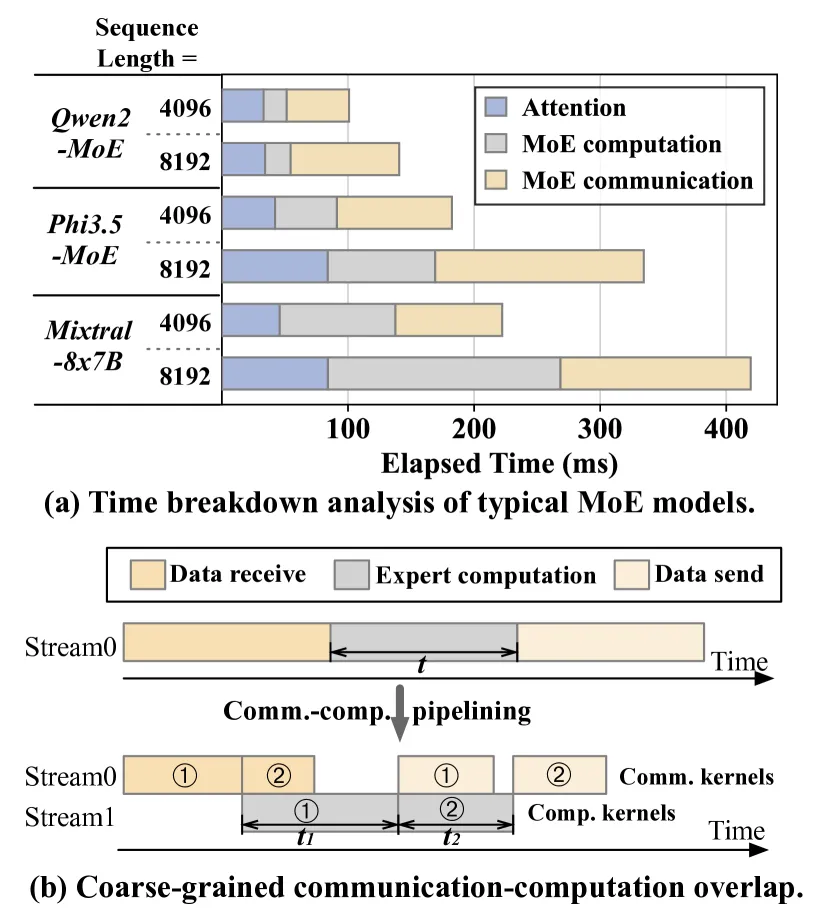
图1:MoE执行分析
- (a) 使用Megatron-LM在8个H100 GPU上执行MoE模型的时间分解
- (b) 通过将专家计算内核分为两部分实现通信-计算重叠的示例
2.2 现有方法的局限性
| 问题 | 描述 |
|---|---|
| 粒度不匹配 | 通信以token为单位,计算以tile为单位(如128x128) |
| 效率损失 | 分区后的专家计算效率下降(t1+t2 > t) |
| 资源分配不均 | 动态路由导致输入形状变化,通信和计算负载不均衡 |
| 调度开销 | 内核级调度引入额外的主机端开销 |
2.3 COMET的核心洞察
洞察1:解决计算和通信之间的粒度不匹配是实现高效重叠的关键
洞察2:资源分配应在运行时的内核中自适应调整,以实现无缝的通信-计算重叠
三、技术架构
3.1 系统总览
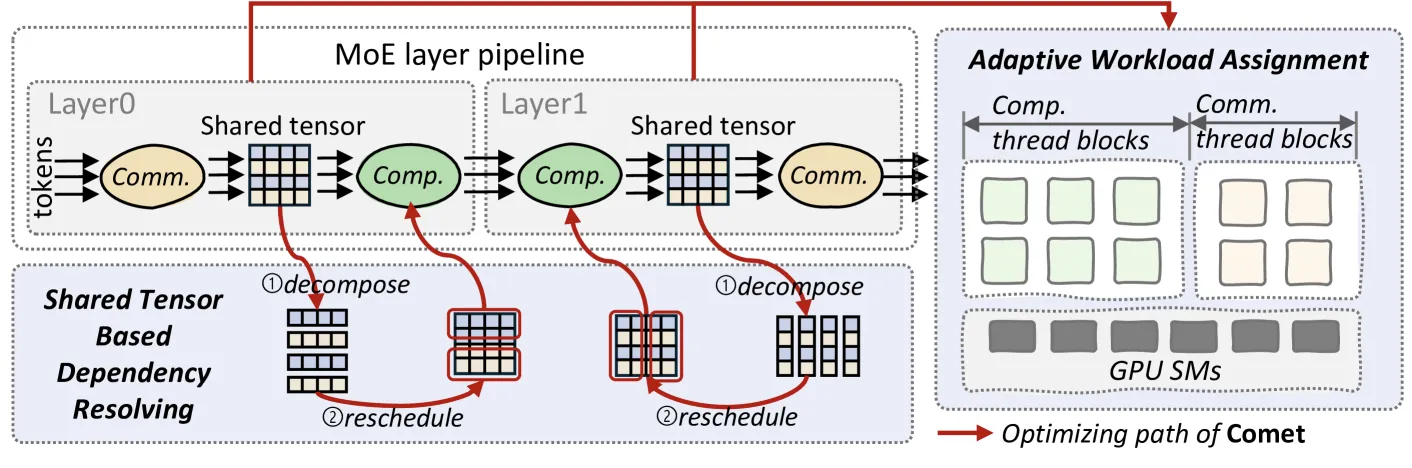
图3:COMET设计概览
COMET由两个核心机制组成:
-
共享张量依赖解析
- 分解共享张量以打破粗粒度数据依赖
- 重新调度计算以提高重叠效率
-
自适应负载分配
- 线程块特化:隔离通信和计算的影响
- 自适应线程块分配:动态平衡通信和计算延迟
3.2 MoE层结构
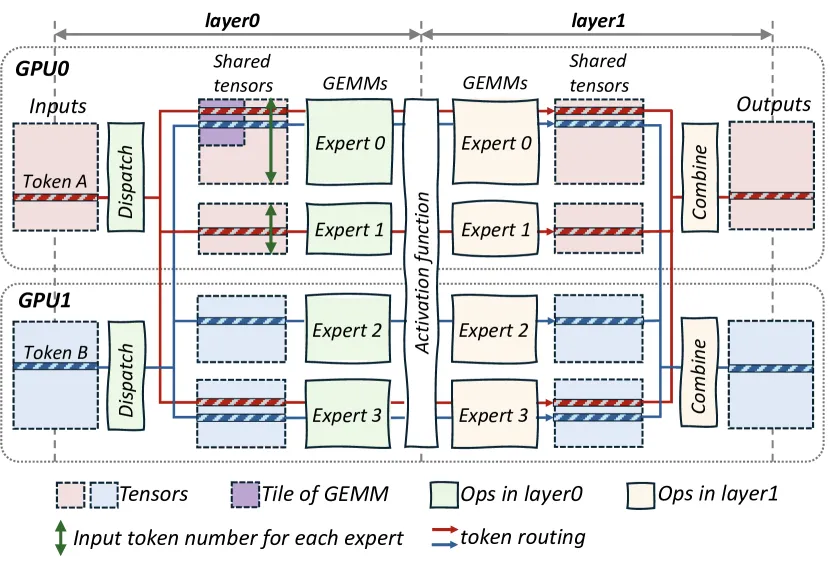
图2:跨两个GPU的MoE层示例
MoE包含两种流水线:
- 通信-计算流水线(Layer0):token通信(dispatch) → 专家计算(GEMM)
- 计算-通信流水线(Layer1):专家计算(GEMM) → token还原(combine)
3.3 并行策略
| 并行策略 | 描述 | 特点 |
|---|---|---|
| 专家并行(EP) | 不同专家分布在不同GPU上 | 每个专家权重完整 |
| 张量并行(TP) | 所有专家权重沿隐藏维度分割 | 每个GPU存储部分权重 |
| 混合并行 | EP + TP组合 | 实际部署常用 |
四、核心创新
4.1 共享张量依赖解析
4.1.1 共享张量分解
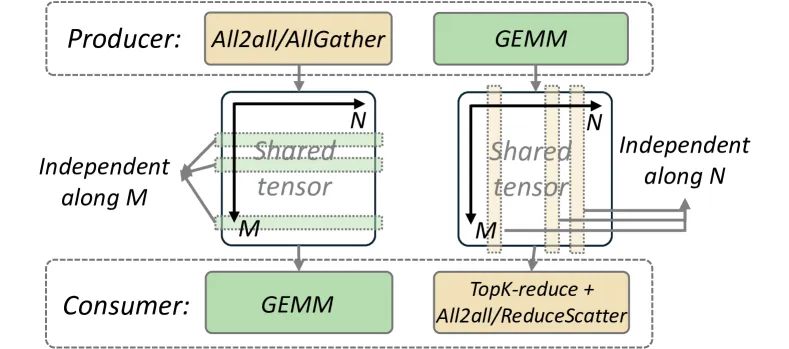
图4:Layer0(左)和Layer1(右)的生产者-消费者建模
共享张量分解策略:
| 流水线类型 | 消费者操作 | 分解维度 | 原因 |
|---|---|---|---|
| 通信-计算 (Layer0) | GEMM | M (token)维度 | token之间相互独立 |
| 计算-通信 (Layer1) | Top-K reduction | N维度 | token沿M维度存在依赖 |
4.1.2 共享张量重调度
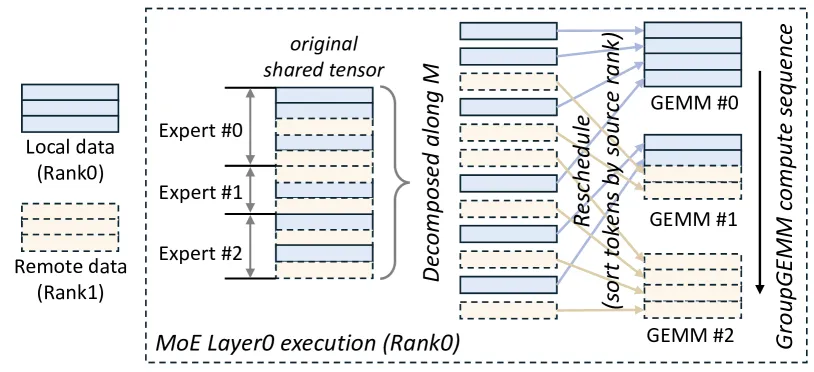
图5:MoE layer0中共享张量的分解和重调度
重调度原则:
- 重调度的子张量应与原始计算tile粒度对齐,以保证计算效率
- 调度策略应优先处理可被消费者立即使用的生产者部分
Layer0优化:按源rank对token排序,计算从包含本地token的tile开始,同时传输其他远程token
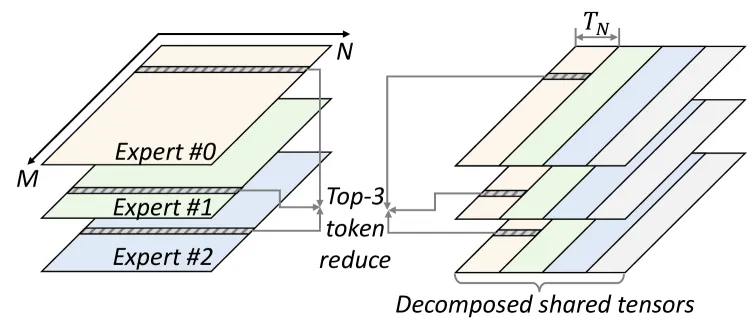
图6:MoE layer1的重调度计算序列
Layer1优化:GroupGEMM按列执行,一旦前TN列计算完成即可开始reduction和通信操作
4.2 自适应负载分配
4.2.1 线程块特化
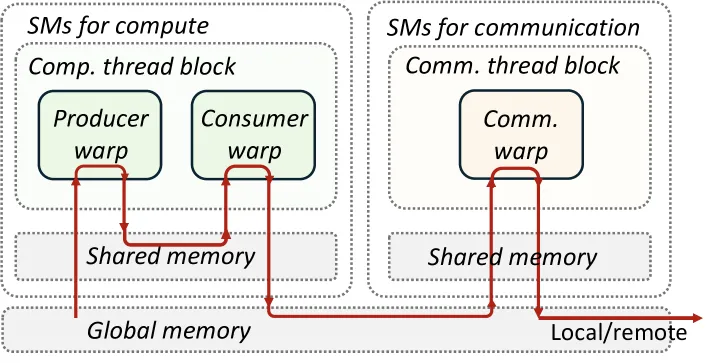
图7:Hopper架构上的MoE layer1内核设计
关键设计:
- 通信和计算工作负载在线程块级别隔离
- GEMM线程块使用与融合前相同的实现(基于CUTLASS)
- 通信线程块独立处理数据传输
硬件资源约束:
- 理论上可以将通信warp与计算warp集成到同一线程块
- 但线程数限制会约束通信操作符充分利用通信带宽
- 通信warp也会干扰同一线程块中的计算warp
4.2.2 自适应线程块分配
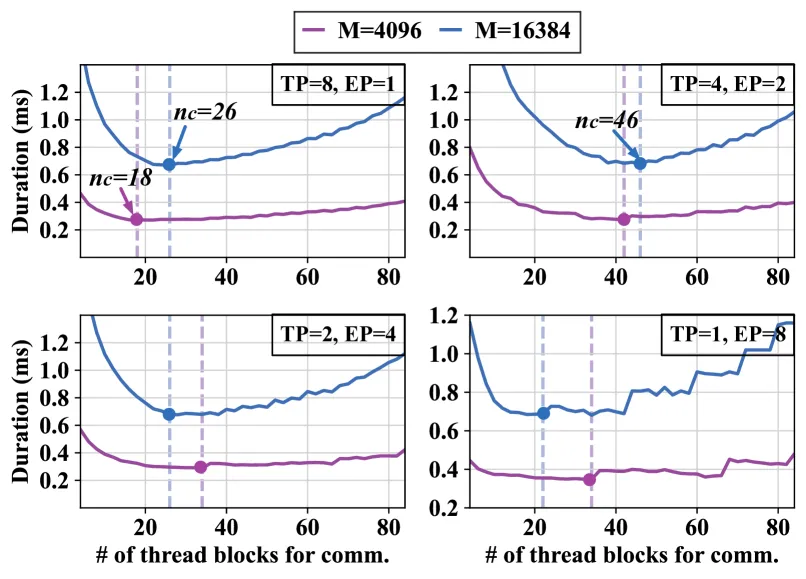
图8:MoE layer1内核在不同线程块分配下的持续时间
关键发现:
- 最优分配点受输入形状和模型配置影响
- 当输入token长度变化时,最优nc从18变为26(TP=8时)
- 当并行策略改变时,最优nc从26变为46(M=16384时)
实现方案:
- COMET库包含多个预编译内核,每个有不同的分配点
- 部署前通过profiling确定最优配置并存储为元数据
- 运行时利用元数据选择最优内核
五、实验结果
5.1 实验设置
| 配置项 | 详情 |
|---|---|
| 硬件 | 8x NVIDIA H100 GPU (80GB) |
| 互联 | NVLink, 平均377 GB/s |
| 软件 | CUDA 12.3, NVSHMEM 2.11, PyTorch 2.4.0 |
| 框架 | Megatron-LM (git-hash 6dbe4c) |
测试模型配置:
| 模型 | L | E | topk | N | K |
|---|---|---|---|---|---|
| Mixtral 8x7B | 32 | 8 | 2 | 4096 | 14336 |
| Qwen2-MoE-2.7B | 24 | 64 | 4 | 2048 | 1408 |
| Phi-3.5-MoE | 32 | 16 | 2 | 4096 | 6400 |
5.2 端到端性能
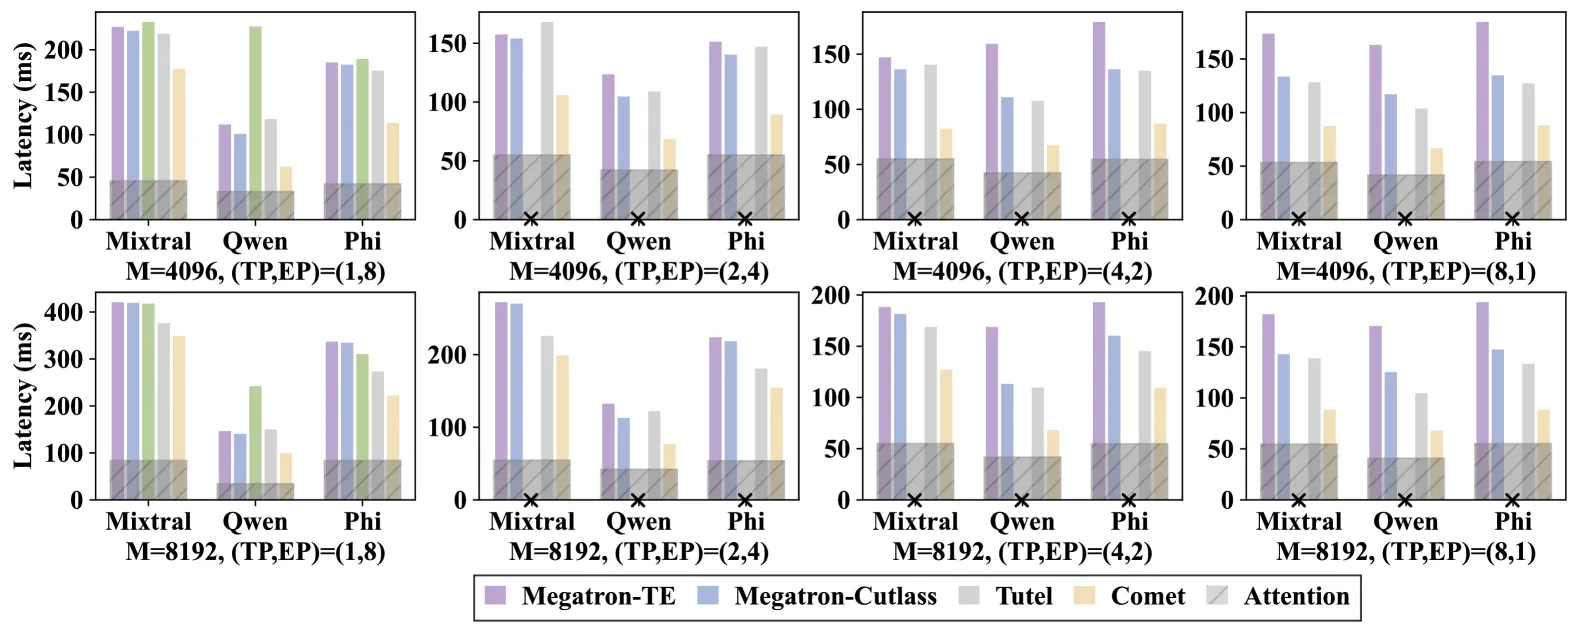
图9:端到端MoE模型延迟
与基线对比的延迟降低:
| 基线方法 | 延迟降低 |
|---|---|
| Megatron-Cutlass | 34.1% |
| Megatron-TE | 42.6% |
| FasterMoE | 44.4% |
| Tutel | 31.8% |
5.3 单层MoE详细评估
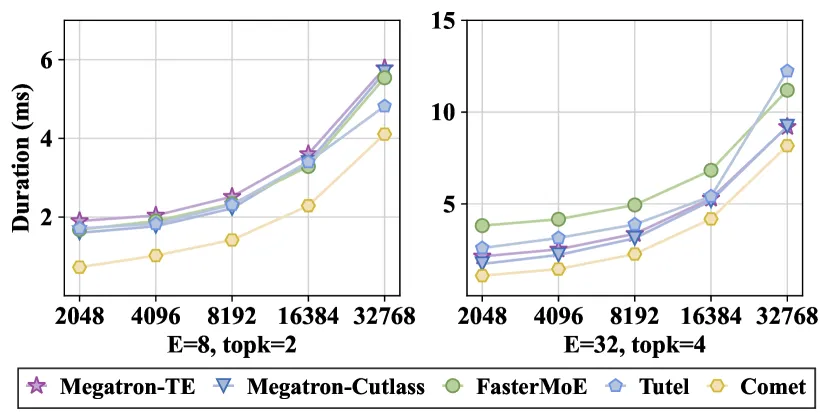
图10:专家并行下单层MoE持续时间(EP=8)
加速比: COMET相比基线实现1.28x至2.37x的加速
关键观察:
- 当M较小时,COMET优势更明显(减少主机端调度开销)
- 调度开销随topk和E增加而增加(FasterMoE和Tutel)
5.4 时间分解分析
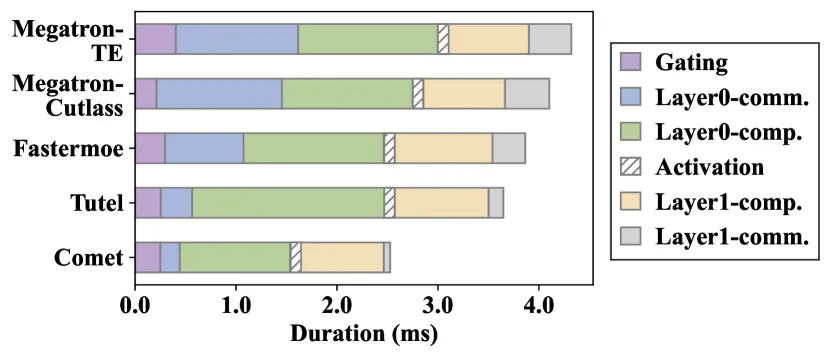
图11:专家并行下MoE层的时间分解
通信隐藏效果:
| 方法 | 通信隐藏率 |
|---|---|
| COMET | 86.5% |
| Tutel | 68.6% |
| FasterMoE | 29.2% |
| Megatron-TE | 0% |
| Megatron-Cutlass | 0% |
5.5 并行策略适应性
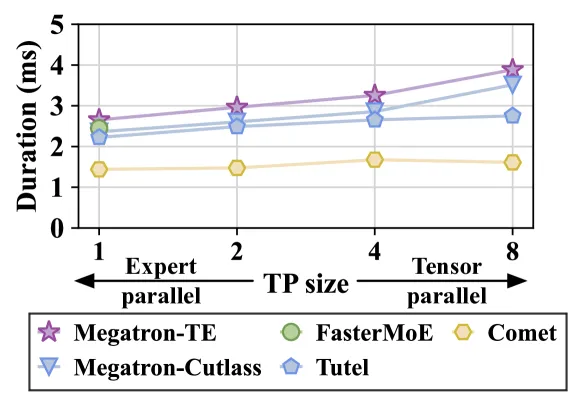
图12:不同并行策略下的单层MoE持续时间
关键观察:
- 随着TP增长,其他基线的延迟增加(专家被分割导致GEMM效率下降)
- COMET在各种并行策略下保持低延迟
5.6 不同配置的适应性
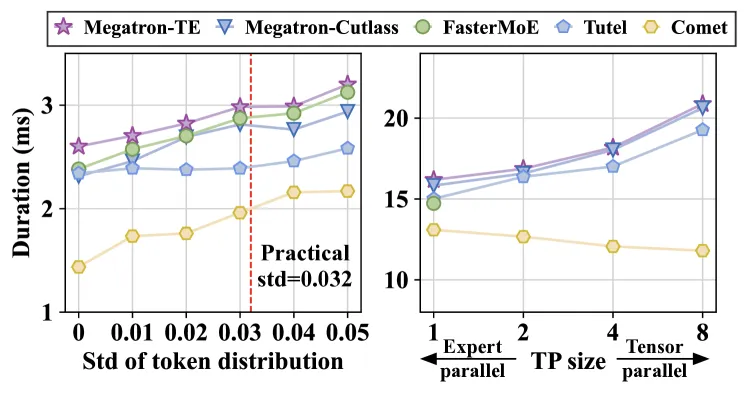
图14:不同场景下的MoE层性能
5.6.1 不同MoE参数
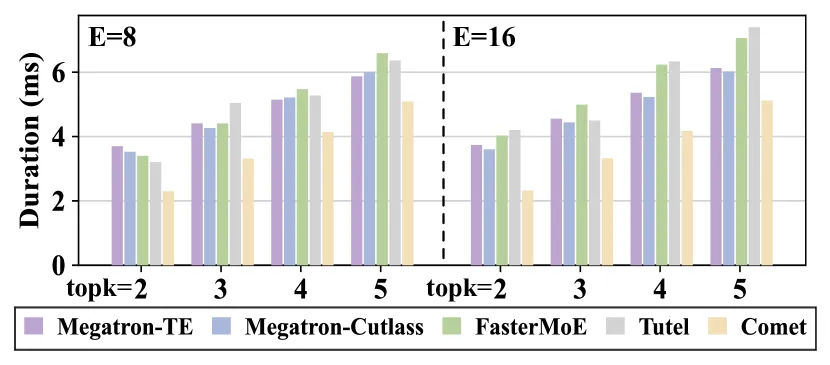
图13:不同专家数E和topk下的单层MoE持续时间
加速比范围: 1.16x至1.83x
5.6.2 不同token分布
- std=0:均匀分布,每个专家接收2048个token
- std=0.05:最轻载专家仅接收数百个token
- 生产环境平均std=0.032
5.6.3 不同硬件环境
L20集群测试:
- 硬件:8x NVIDIA L20 GPU (46GB)
- 互联:PCIe bridges, 约25 GB/s
- 平均加速比:1.19x至1.46x
5.7 开销分析
NVSHMEM内存开销:
| 模型 | M=4096 | M=8192 |
|---|---|---|
| Mixtral 8x7B | 32 MB | 64 MB |
| Qwen2-MoE | 16 MB | 32 MB |
| Phi3.5-MoE | 32 MB | 64 MB |
内存公式:2MN (BF16/FP16),其中M为输入序列长度,N为模型隐藏大小
六、相关工作
6.1 通信优化
| 方法 | 技术 |
|---|---|
| 高效通信算法 | 优化All-to-All通信实现 |
| 2D层次化All-to-All | 利用节点内带宽加速MoE通信 |
| ScheMoE | 数据压缩减少通信量 |
6.2 计算-通信重叠
| 方法 | 特点 | 局限性 |
|---|---|---|
| FasterMoE | 流水线度为2 | 仅支持专家并行 |
| Tutel | 手动设置或启发式搜索 | 搜索空间有限,可能次优 |
| PipeMoE | 调度MoE算子利用带宽 | 内核级调度 |
| ScheMoE | 利用节点内和节点间带宽 | 内核级调度 |
| COMET | 细粒度重叠,内核内调度 | - |
COMET的优势:
- 不是简单的内核级调度
- 在融合GPU内核中集成通信和计算任务
- 通过线程块特化隔离通信对计算的影响
- 自适应调整线程块分配以平衡延迟
七、总结
7.1 主要贡献
COMET是一个针对MoE执行优化的系统,通过细粒度的通信-计算重叠实现高效执行。
两个关键设计:
-
共享张量依赖解析
- 识别MoE中通信和计算操作之间的复杂数据依赖
- 通过分解和重调度共享张量实现细粒度重叠
- 消除细粒度通信带来的瓶颈
-
自适应负载分配
- 线程块特化:隔离通信对计算性能的影响
- 自适应线程块分配:动态平衡通信和计算延迟
- 最大化延迟隐藏效果
7.2 性能成果
| 指标 | 数值 |
|---|---|
| 单MoE层加速 | 1.96x |
| 端到端加速 | 1.71x (平均) |
| 通信隐藏率 | 86.5% |
| 生产部署 | 万级GPU集群 |
| GPU小时节省 | 数百万 |
7.3 技术实现
- 约12k行C++和CUDA代码,2k行Python代码
- 基于CUTLASS模板生成高效GEMM内核
- 使用NVSHMEM支持细粒度通信
- 已集成到Megatron-LM中
7.4 未来方向
论文提到将开源COMET,旨在启发进一步优化,例如:
- 使用Triton或TVM等编译器实现COMET中的编程模型
- 将细粒度流水线编程模型推广到其他场景
八、参考资源
8.1 论文链接
- arXiv: https://arxiv.org/abs/2502.19811
- PDF: https://arxiv.org/pdf/2502.19811
- HTML: https://arxiv.org/html/2502.19811v1
- GitHub: https://github.com/bytedance/flux
8.2 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 混合专家 | Mixture-of-Experts (MoE) | 稀疏激活的模型架构 |
| 专家并行 | Expert Parallelism (EP) | 不同专家分布到不同GPU |
| 张量并行 | Tensor Parallelism (TP) | 权重沿隐藏维度分割 |
| 共享张量 | Shared Tensor | 生产者输出和消费者输入的共享缓冲区 |
| GroupGEMM | Grouped GEMM | 批量处理多个专家的矩阵乘法 |
| NVSHMEM | - | NVIDIA GPU通信库 |
| CUTLASS | - | NVIDIA CUDA模板库 |
| TMA | Tensor Memory Accelerator | Hopper架构的异步计算流水线 |
8.3 相关工具和框架
| 工具 | 用途 |
|---|---|
| Megatron-LM | 大模型训练框架 |
| NVSHMEM | GPU间细粒度通信 |
| CUTLASS | 高效GEMM实现 |
| Transformer Engine | NVIDIA Transformer加速库 |
8.4 关键图表索引
| 图表 | 描述 | 文件 |
|---|---|---|
| Figure 1 | MoE执行时间分析 | figures/comet/figure1.png |
| Figure 2 | MoE层结构示例 | figures/comet/figure2.png |
| Figure 3 | COMET设计概览 | figures/comet/figure3.png |
| Figure 4 | 生产者-消费者建模 | figures/comet/figure4.png |
| Figure 5 | Layer0分解和重调度 | figures/comet/figure5.png |
| Figure 6 | Layer1重调度计算序列 | figures/comet/figure6.png |
| Figure 7 | Hopper内核设计 | figures/comet/figure7.png |
| Figure 8 | 线程块分配优化 | figures/comet/figure8.png |
| Figure 9 | 端到端性能对比 | figures/comet/figure9.png |
| Figure 10 | 单层性能对比 | figures/comet/figure10.png |
| Figure 11 | 时间分解分析 | figures/comet/figure11.png |
| Figure 12 | 并行策略对比 | figures/comet/figure12.png |
| Figure 13 | 不同MoE参数性能 | figures/comet/figure13.png |
| Figure 14 | 场景适应性 | figures/comet/figure14.png |
文档生成时间: 2026-05-30 数据来源: arXiv:2502.19811v1