Can Tensor Cores Benefit Memory-Bound Kernels? (No!)(张量核心能加速访存受限 kernel 吗?不能!)
从理论与实证两方面证明:把 GPU 张量核心(Tensor Core)用于访存受限(memory-bound)kernel 无法带来实质性能收益。核心理论:基于 Roofline 模型与机器平衡度(machine balance)推导,在完全不重叠(fully un-overlapped)极端情形下张量核心相对 CUDA 核心的加速上界为 Speedup < 2 − 2/(1+α);对于 FP64(张量核心算力 α=2,即 V100/A100/H100)该上界仅为 1.33×,即便 α→∞ 也不超过 2×。完全重叠情形下访存主导、计算加速对总时间无影响。实证在 A100 与 GH200 上用 STREAM SCALE、SpMV(cuSPARSE vs DASP)、迭代 stencil(EBISU/Brick vs ConvStencil/LoraStencil)三类代表性访存受限 kernel 验证:张量核心实现普遍慢于同等优化的 CUDA 核心实现,主因是张量核心访存模式次优。结论:访存受限 kernel 应优先用 CUDA 核心并聚焦访存优化(cache-aware、减少访存流量、流水/重叠),而非引入张量核心。
Can Tensor Cores Benefit Memory-Bound Kernels? (No!)(张量核心能加速访存受限 kernel 吗?不能!)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Can Tensor Cores Benefit Memory-Bound Kernels? (No!) |
| 作者 | Lingqi Zhang, Jiajun Huang, Sheng Di, Satoshi Matsuoka, Mohamed Wahib |
| 机构 | RIKEN / Argonne(ANL) / Tokyo Tech 等(HPC 方向) |
| 论文 | arXiv:2502.16851(v2, 2025-02-27) |
| 硬件 | A100-80GB、GH200(另涉 V100/H100 理论) |
| 主题 | GPU 张量核心、访存受限 kernel、Roofline 模型、HPC |
一句话总结:近期有研究声称张量核心(Tensor Core)在访存受限 kernel 上也能超越 CUDA 核心。本文用理论 + 实证双重分析反驳该结论:张量核心对 FP64 访存受限 kernel 的加速理论上界仅 1.33×,且实测中张量核心实现普遍慢于同等优化的 CUDA 核心实现。
二、核心思想
问题定义
张量核心是集成在 SM 内的专用脉动阵列矩阵引擎,在计算受限(compute-bound)应用(如深度学习稠密矩阵运算)上效率显著。研究者试图将其扩展到访存受限(memory-bound)kernel——但此类 kernel 的瓶颈本就不是计算。本文回答两个问题:
- 张量核心用于访存受限 kernel 时的理论性能天花板是多少?
- 现有张量核心实现策略是否为访存受限 kernel 带来真实收益?
关键前提
张量核心与 CUDA 核心共享同一内存层级(数据都经 global memory → register file → 计算单元),且因 Dark Silicon 效应不能同时工作。因此在 Roofline 模型中,张量核心只是 CUDA 核心基线之上的一条额外性能天花板。
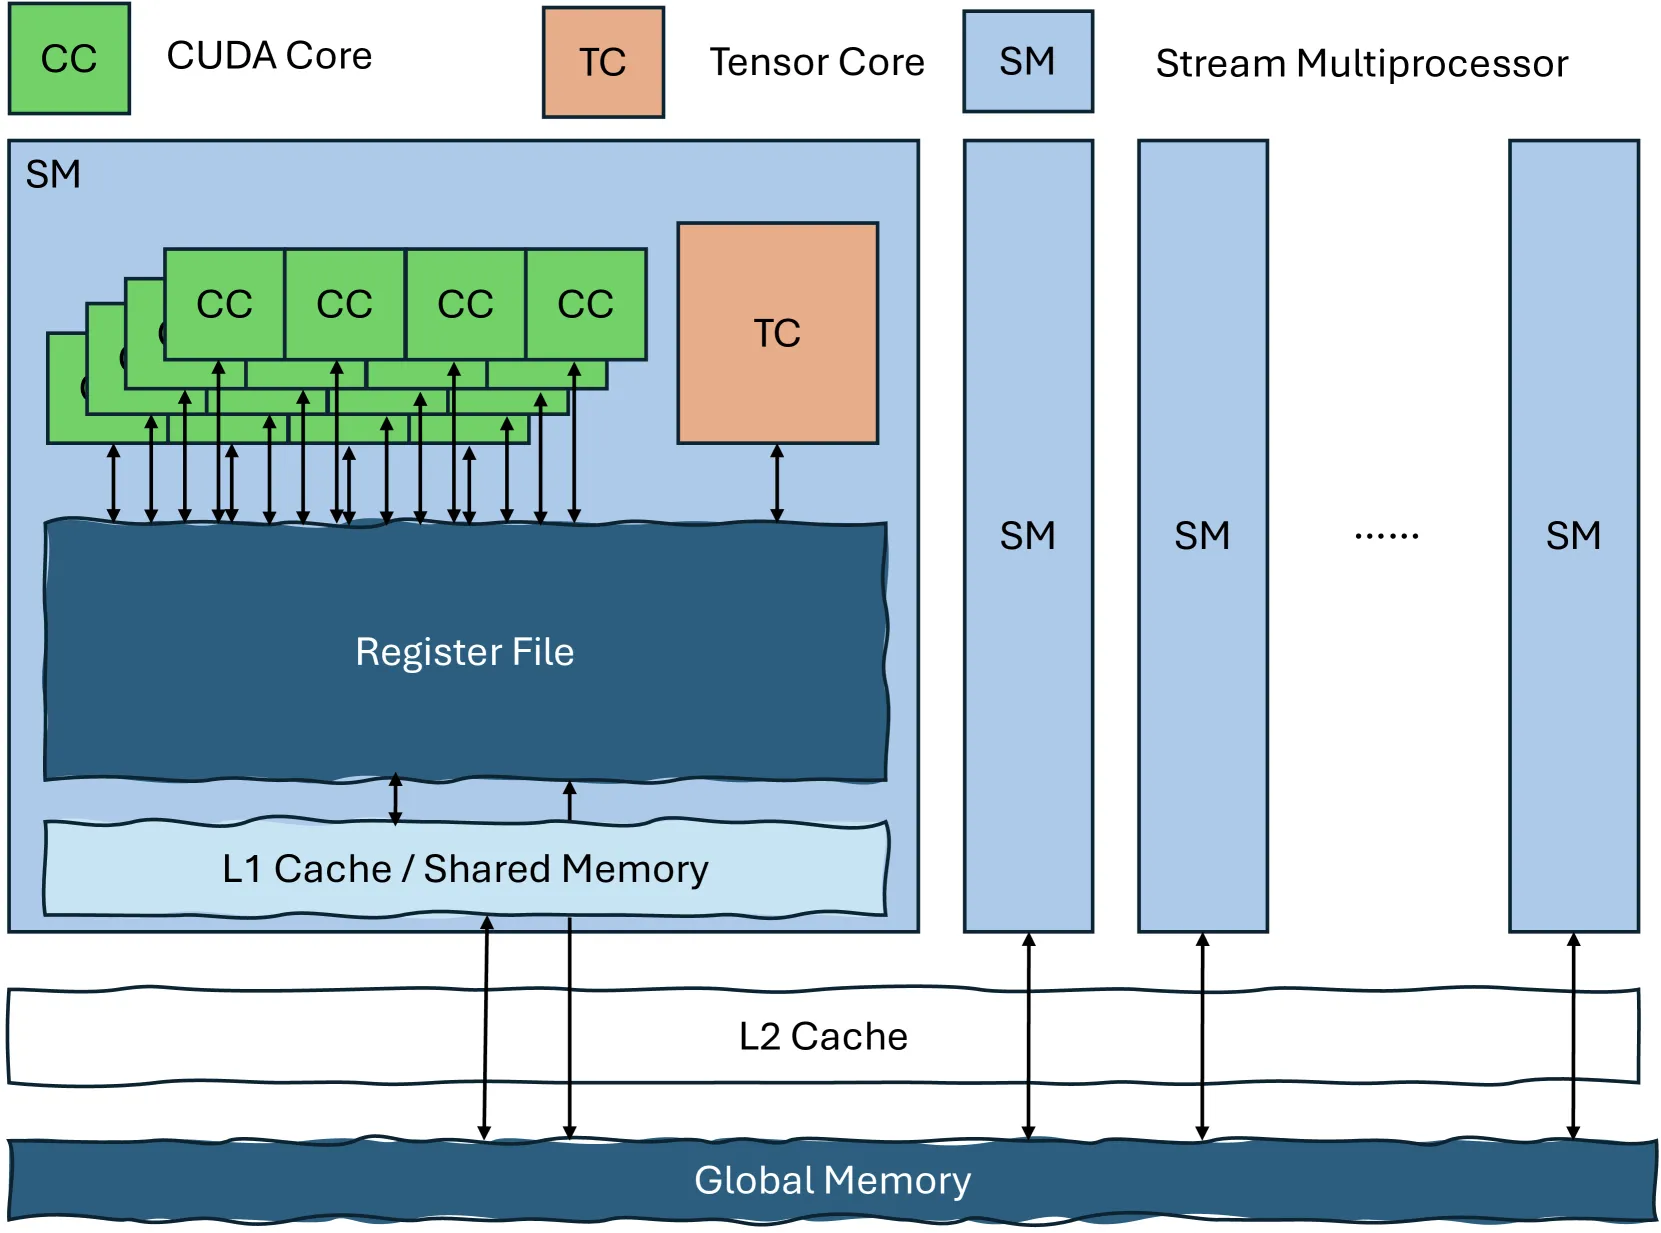
三、背景与性能模型
机器平衡度(Machine Balance)
峰值算力 与内存带宽 之比。
Roofline 模型
操作强度(operational intensity)(计算量/访存量),可达性能:
- 当 → 访存受限(memory-bound)
- 当 → 计算受限(compute-bound)
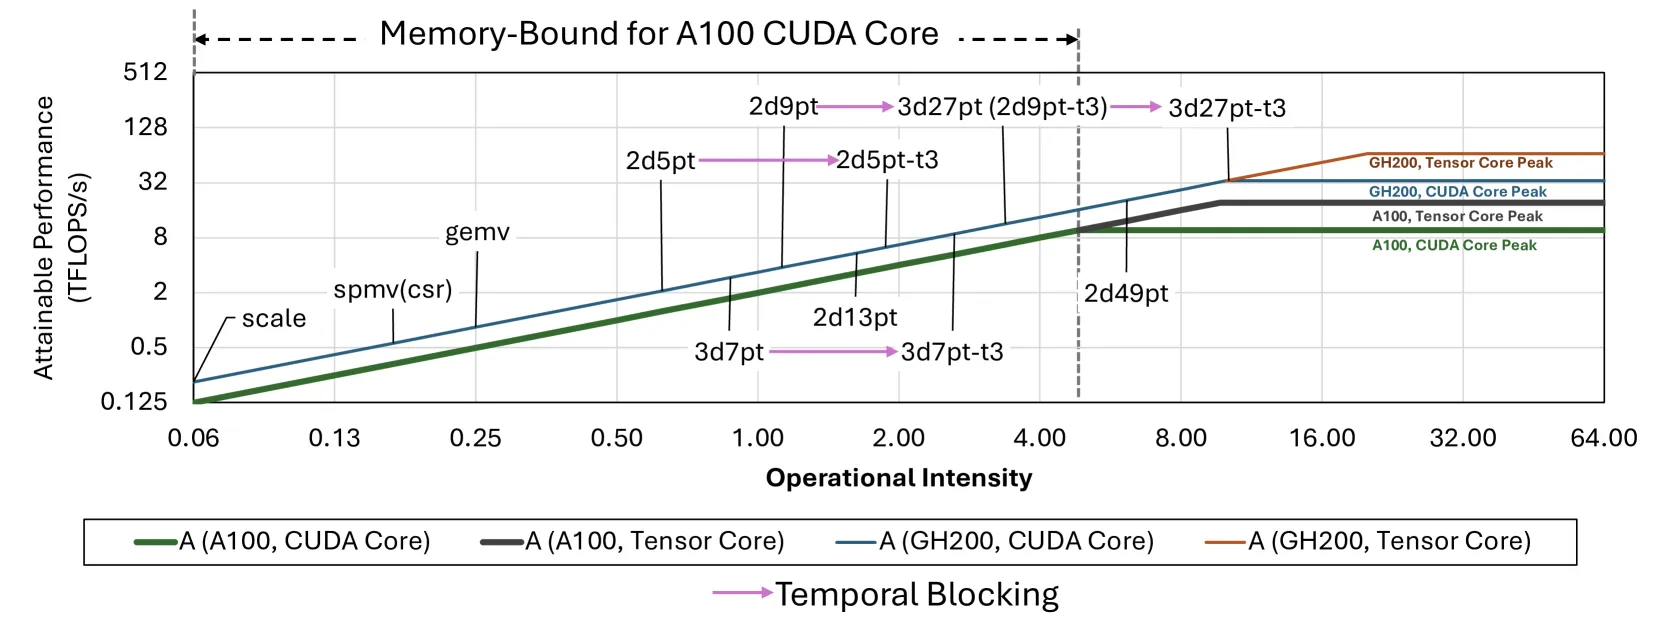
四、理论分析(核心)
对于吞吐受限的 HPC 负载,计算时间 ,访存时间 ,两者之比:
访存受限()时 。分析两种极端情形:
4.1 完全重叠(Fully Overlapped)
访存与计算完全重叠时,总时间取最大值:
由于访存主导,减少计算时间对总运行时间毫无影响——张量核心加速计算无用武之地。
4.2 完全不重叠(Fully Un-overlapped)
总时间为三段之和 。设张量核心相对 CUDA 核心的算力加速为 ,则 ,加速比:
张量核心上界:访存受限 kernel 有 (即 的临界),得到与 无关的紧上界:
| 场景 | α | 加速上界 |
|---|---|---|
| FP64(V100/A100/H100) | α=2 | < 1.33× |
| 假想 α→∞ | ∞ | < 2× |
工作负载上界(假设 α→∞,代入具体 ):
例如 A100 上 GEMV:Speedup < 1.05×。
4.3 小结
真实 kernel 通常介于两种极端之间(部分重叠),FP64 加速落在 1× ~ 1.33×。超出此范围的差异只能来自访存优化,而访存优化对张量核心和 CUDA 核心同等有效(两者都经 register file 访存),因此张量核心并无独占优势。
五、实证分析
实验平台
| 指标 | A100-80GB | GH200 |
|---|---|---|
| CUDA 版本 | 12.1 | 12.6 |
| L2 Cache (MB) | 40 | 50 |
| 内存带宽 (TB/s) | 1.94 | 4.00 |
| FP64 峰值 (TFLOPS) CUDA/Tensor | 9.7 / 19.5 | 34.0 / 67.0 |
三个代表性访存受限 kernel:
5.1 SCALE(STREAM)
张量核心实现把 SCALE 表示为矩阵乘 ( 为单位阵)。但这只用到张量核心 的算力——A100/H100 的 8×4 FP64 张量核心仅用 1/8 算力(A100 有效 2.4 TFLOPS,GH200 8.37 TFLOPS,均低于 CUDA 核心)。因 SCALE 操作强度极低,这对性能影响不大。CUDA 基线用 ChatGPT 生成的 STREAM 实现(仅加 warmup)。
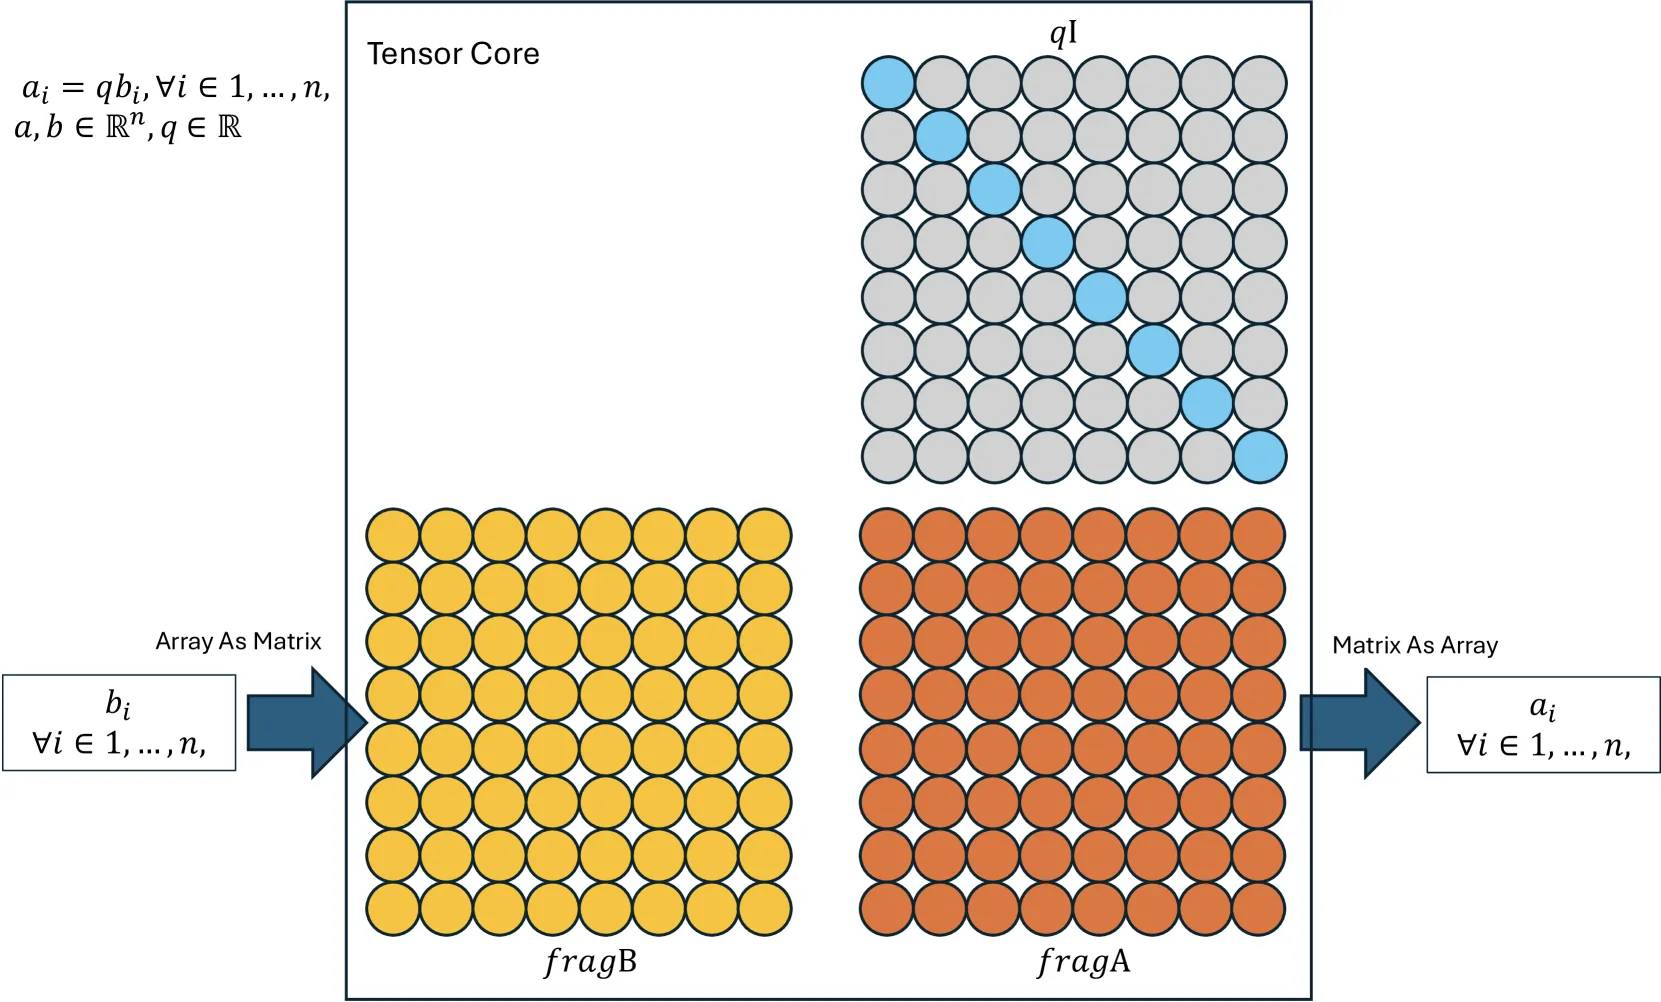
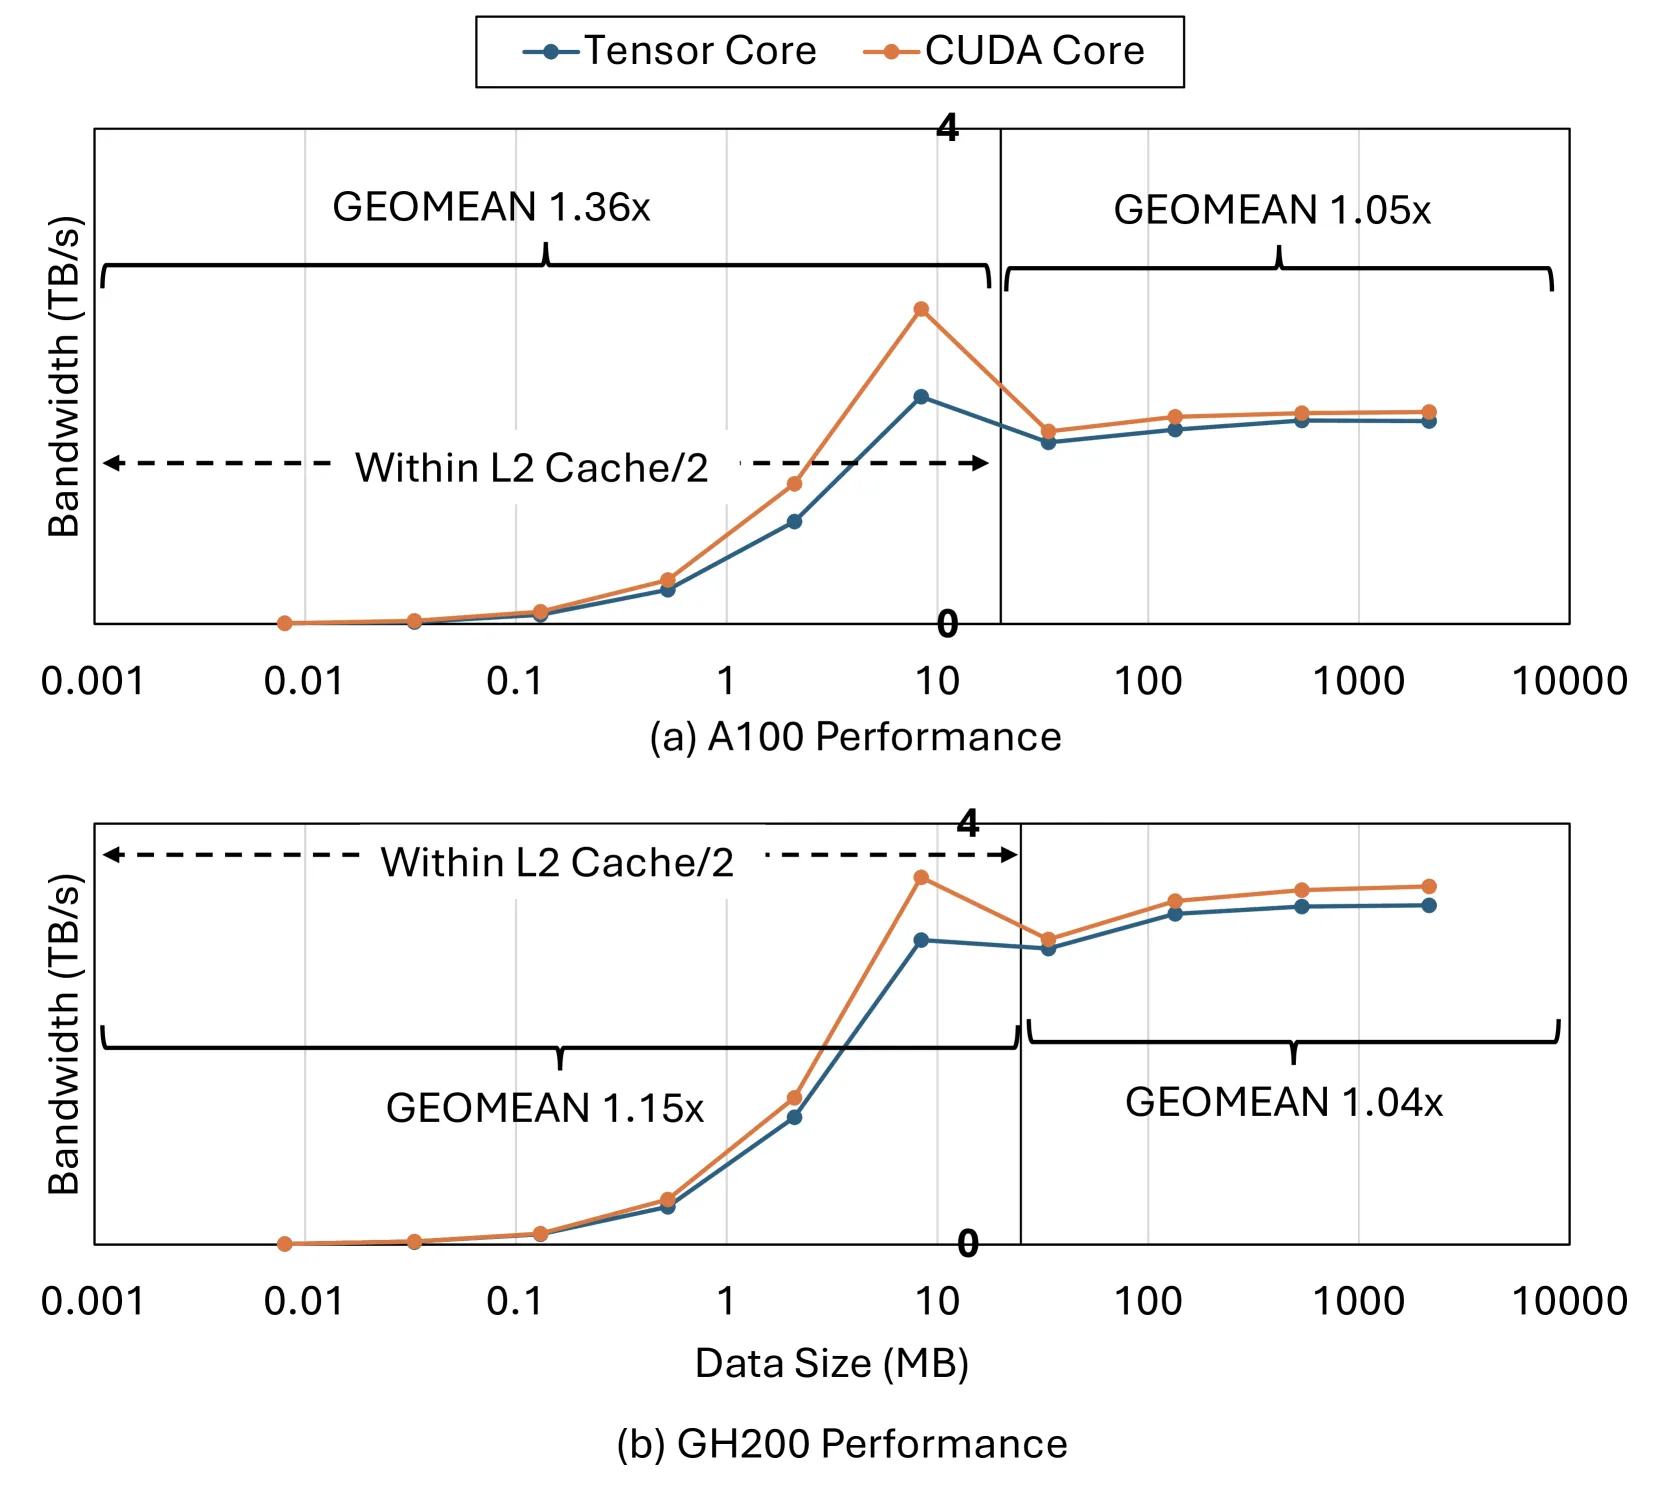
结果:张量核心持续、温和地慢于 CUDA 核心。计算时间差可忽略,性能差距源于张量核心在当前架构上的次优访存模式。
5.2 SpMV(稀疏矩阵-向量乘)
对比 cuSPARSE(CUDA 核心)与 DASP(张量核心),数据集来自 DASP 基准。
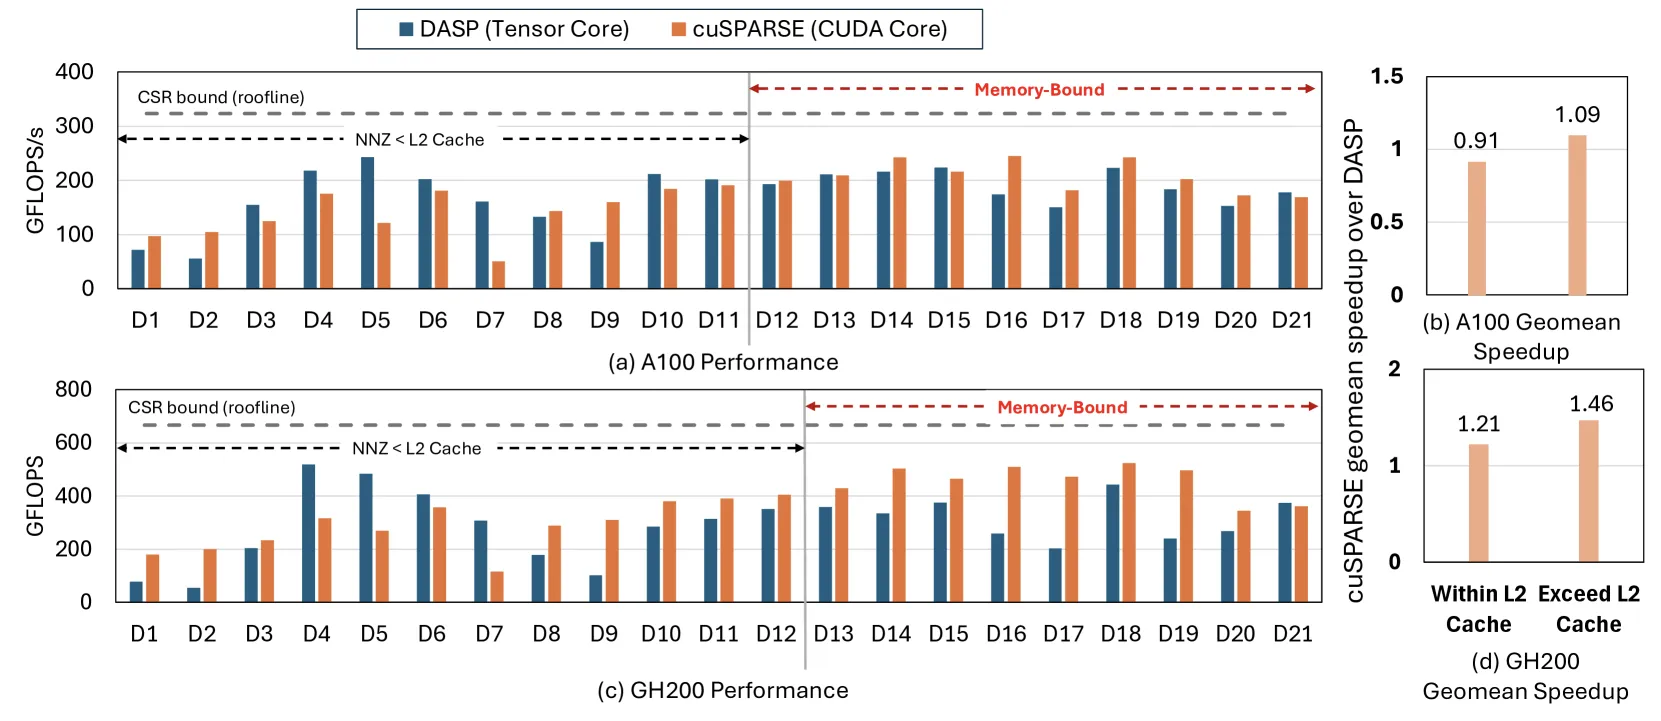
结果:对于超过 L2 cache 大小的数据集,cuSPARSE 平均优于 DASP。
5.3 迭代 Stencil
对比等同优化的张量核心(ConvStencil/LoraStencil)与 CUDA 核心(EBISU/Brick)实现。
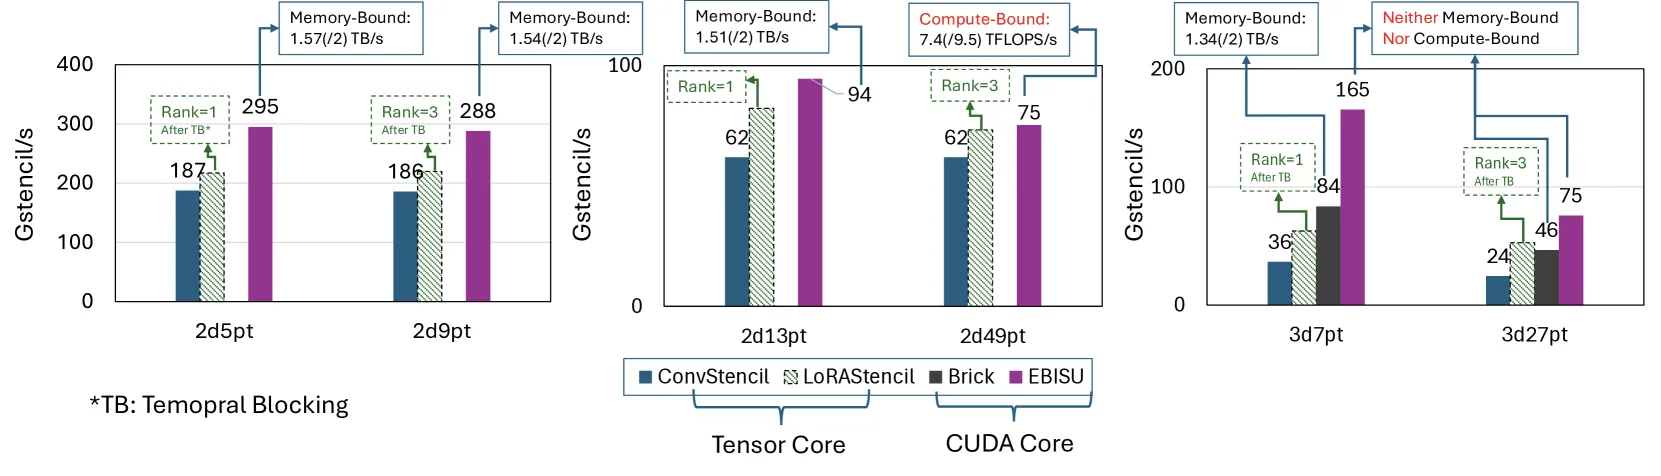
结果:等同优化下张量核心实现普遍不及 CUDA 核心。
5.5 其他观察
- L2 Cache 影响:SCALE 在 L2 范围内张量核心退化加剧;DASP 对 cache 驻留数据反而改善——L2 优化影响显著。
- 计算受限反例:2d49pt stencil 在 A100 上计算受限、两者相当;但在 GH200 上变为访存受限,CUDA 核心理论上更优。
- 资源受限:3D/高阶 2D stencil 常受限于寄存器/cache 容量或带宽,张量核心(只优化计算)无益。
六、核心创新与贡献
| 贡献 | 说明 |
|---|---|
| 理论上界推导 | 首次基于 Roofline+机器平衡度证明访存受限 kernel 张量核心加速 < 2−2/(1+α),FP64 仅 1.33× |
| 访存等效论证 | 张量核心与 CUDA 核心共享 register file 访存路径,访存优化对二者同等有效 |
| 三 kernel 实证 | SCALE/SpMV/stencil 跨 A100/GH200 验证理论,且实测张量核心通常更慢 |
| 反直觉纠偏 | 系统反驳”张量核心可加速访存受限 kernel”的近期主张 |
七、关键要点(Key Takeaways)
- 先辨别 kernel 属性(计算受限 / 访存受限)。
- 计算受限:张量核心仍有优势。
- 访存受限:
- 优先用 CUDA 核心(简单有效)。
- 聚焦访存优化:cache-aware 算法、减少访存流量。
- 优先做流水与重叠优化,再考虑张量核心。
- 牢记理论极限:FP64 至多 1.33×,α→∞ 上限 2×。
八、总结
核心结论
系统的理论 + 实证分析表明:在访存受限 kernel 中用张量核心做计算无法带来实质性能收益。理论上界 FP64 为 1.33×;实测 SCALE/SpMV/stencil 中张量核心实现通常慢于 CUDA 核心。
技术影响
为 HPC/GPU 从业者提供明确决策依据:不要盲目把张量核心套用到访存受限 kernel,应把精力投入访存与重叠优化。这与 GPU kernel 优化的主流经验一致——访存受限场景的关键是带宽/MLP/cache(参见 CudaDMA 的 warp 特化访存优化思路)。
局限性
- 分析聚焦 FP64;低精度(张量核心 α 更大)下上界更接近 2×,但仍受访存主导约束。
- 张量核心访存模式次优部分归因于当前架构实现,未来硬件可能改变具体数值(但理论上界不变)。
九、参考资源
- 论文:Can Tensor Cores Benefit Memory-Bound Kernels? (No!) (arXiv:2502.16851)
- 相关文档:
- CudaDMA: 通过 Warp 特化优化 GPU 内存带宽(访存受限 kernel 的正确优化方向:DMA warp 特化 + 饱和带宽)
- Lean Attention(attention kernel 的访存/调度优化)
- Veda: 蒸馏式稀疏注意力(Hopper kernel 访存与稀疏优化)