LServe: Efficient Long-sequence LLM Serving with Unified Sparse Attention
LServe通过统一稀疏注意力机制实现高效长序列LLM服务,优化KV缓存管理和注意力计算。
LServe: Efficient Long-sequence LLM Serving with Unified Sparse Attention
一、论文概述 (Overview)
1.1 研究背景
随着大语言模型(LLM)在长序列应用中的广泛应用,如多轮对话、长文档分析、多模态理解和代码补全等场景,高效服务这些模型面临严峻挑战。传统的注意力机制具有二次计算复杂度,在处理长序列时(如128K tokens以上),注意力计算占据总运行时间的50%以上,成为系统性能瓶颈。
1.2 问题陈述
长序列LLM服务面临两个核心挑战:
| 阶段 | 挑战 | 原因 |
|---|---|---|
| Prefilling阶段 | 计算复杂度高 | 注意力计算的二次复杂度 O(N(S+N)HD) |
| Decoding阶段 | 内存占用大 | KV缓存随序列长度线性增长 |
以Llama-3-8B为例,在256K输入tokens和20K输出tokens的配置下,prefilling时间为116秒,而decoding时间长达540秒——几乎是prefilling的5倍。
1.3 核心贡献
LServe提出了一个高效的长序列LLM服务系统,主要贡献包括:
- 统一块稀疏注意力框架:将多种硬件友好的结构化稀疏模式统一到单一框架中
- 静态与动态稀疏的兼容性:证明了头级静态稀疏和查询感知动态稀疏可以正交组合
- 层级化KV页面选择:设计了层级化页面选择策略,在不增加token预算的情况下保持长上下文能力
- 可复用页面选择器:利用相邻查询的相似性将页面选择开销降低4倍
二、核心思想 (Core Idea)
2.1 关键观察
LServe的核心观察是:
静态稀疏和动态稀疏模式在长序列LLM中是正交的,可以组合实现乘法级加速。
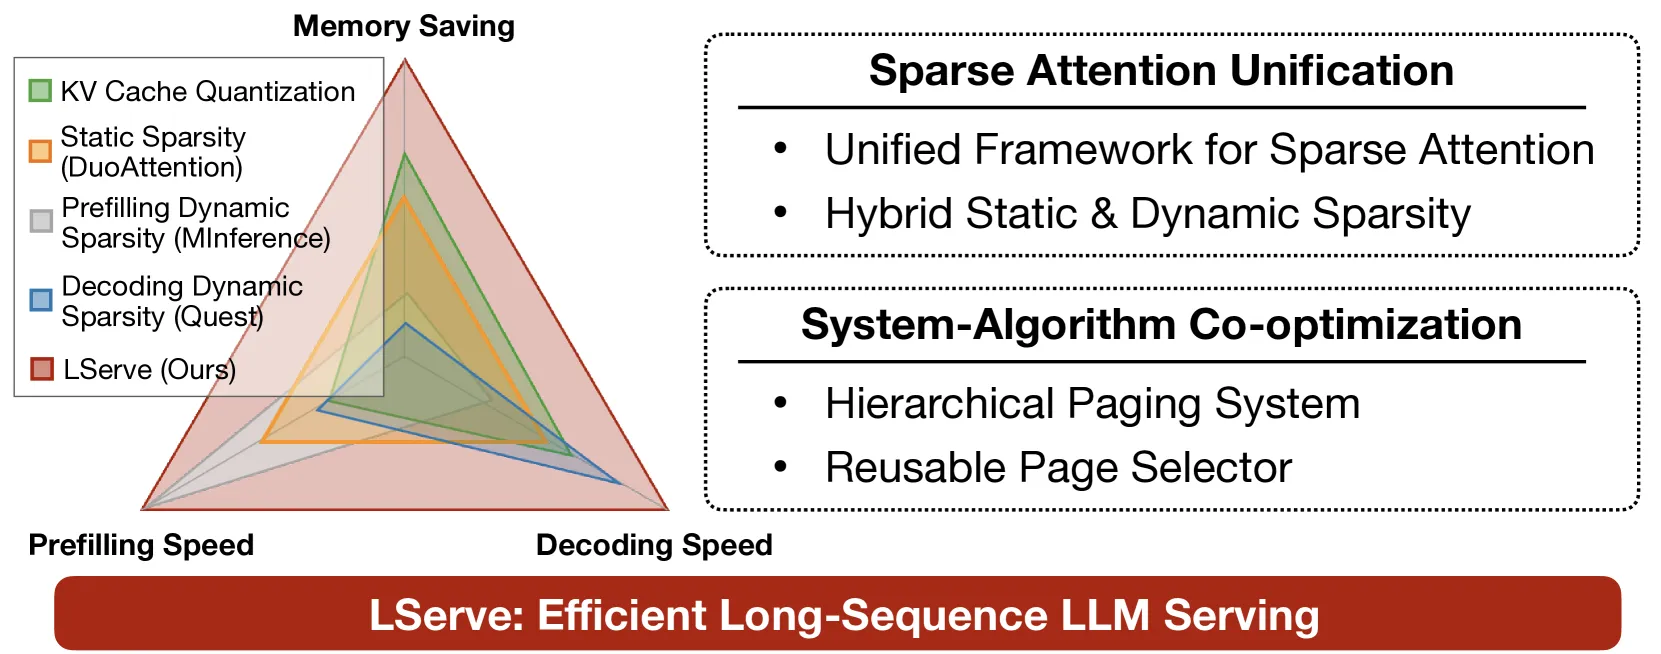
图1:LServe是一个利用混合稀疏注意力的高效长序列LLM服务系统。通过统一不同稀疏模式和KV缓存量化,在prefilling和decoding阶段都实现了显著加速,同时减少了内存消耗。
2.2 加速原理
LServe通过三种优化的组合实现加速:
| 优化类型 | 机制 | 加速效果 |
|---|---|---|
| 静态稀疏(Streaming Heads) | 将50%的注意力头转换为Λ形掩码的流式头 | ~1.7× |
| 动态稀疏(Page Sparsity) | 基于查询相似性动态选择重要KV页面 | 复杂度降至常数 |
| KV缓存量化 | W4A8KV4量化减少内存带宽使用 | 正交加速 |
2.3 块稀疏注意力
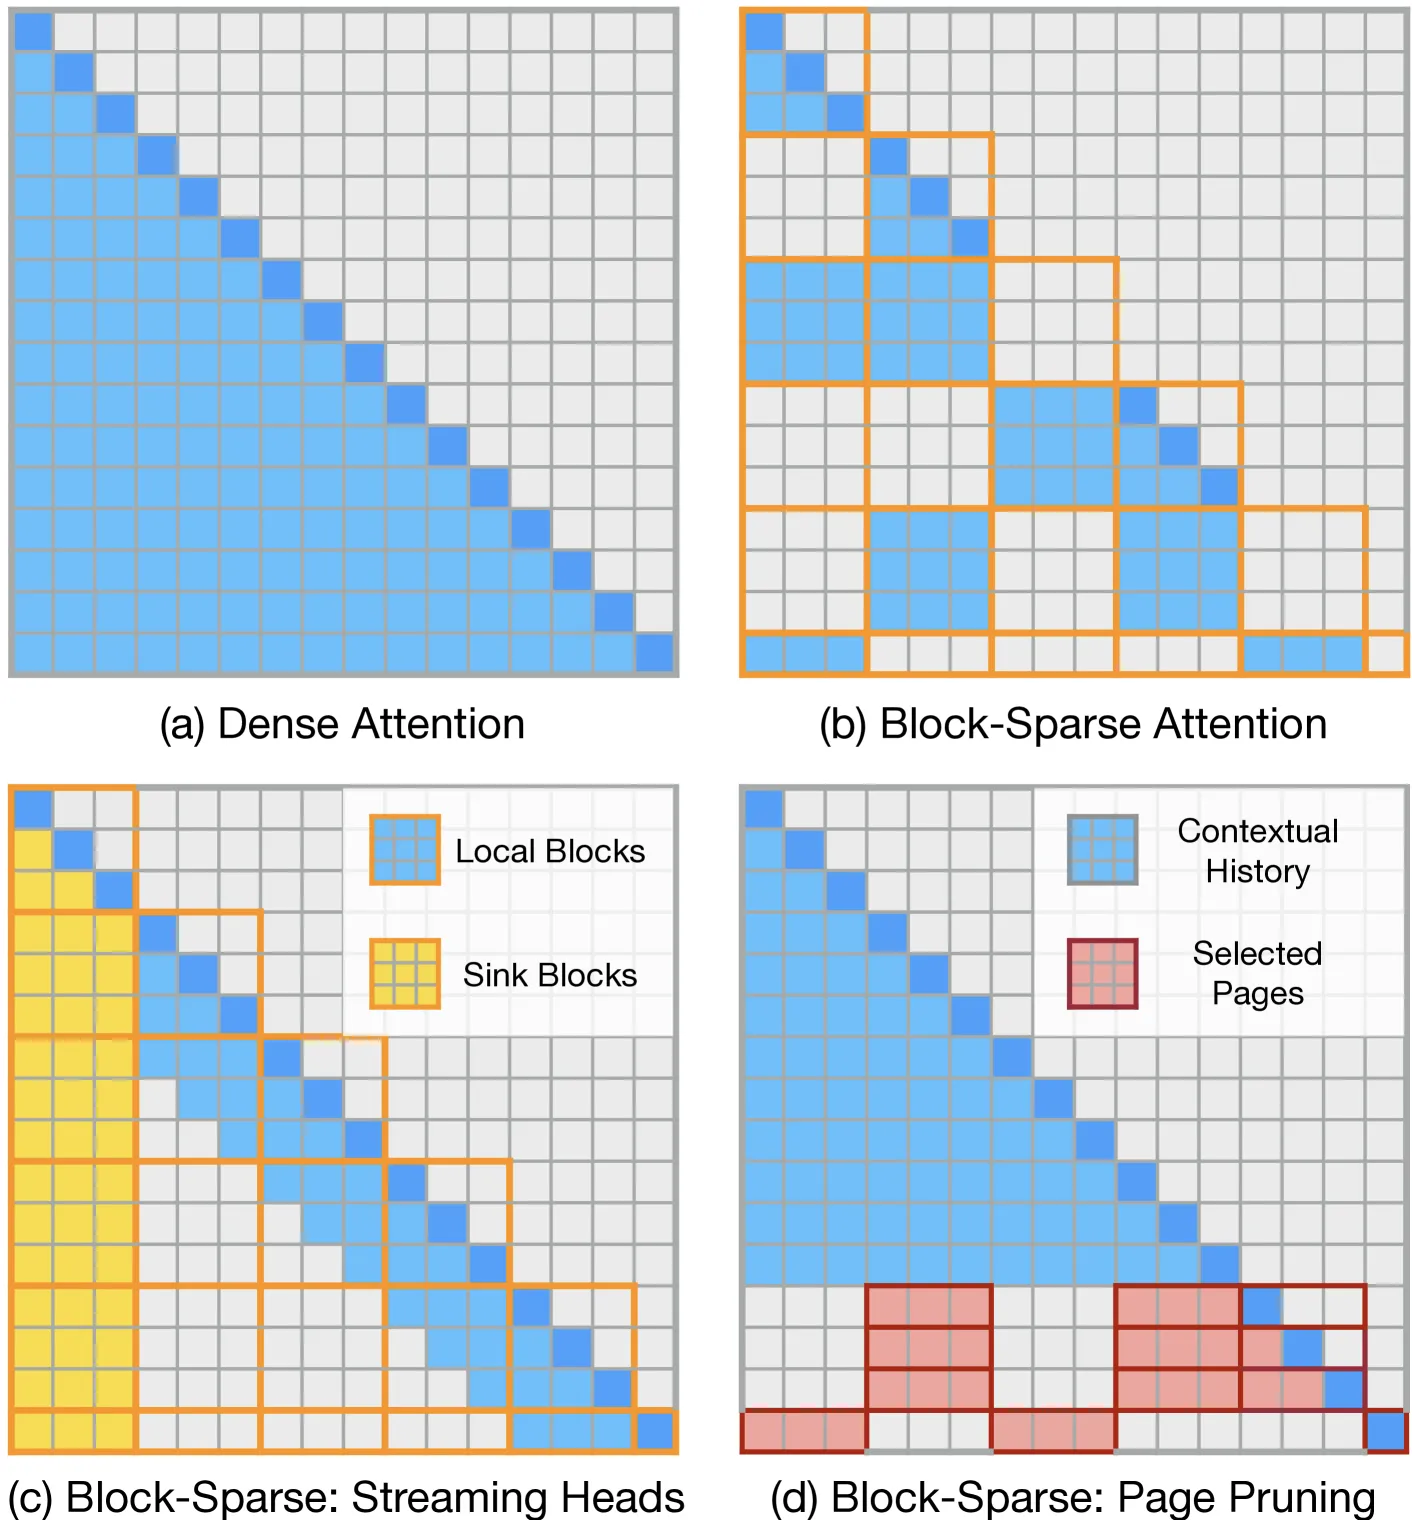
图4:统一块稀疏注意力模式。LServe将各种稀疏模式集成到统一框架中。
LServe定义了统一的块稀疏模式:每个 T_Q × T_K 的tile在注意力计算中要么完全跳过(浅灰色块),要么像标准因果注意力一样保留(蓝色块)。块稀疏度为r时,理论加速比为 1/(1-r)。
三、技术架构 (Technical Architecture)
3.1 系统架构概览
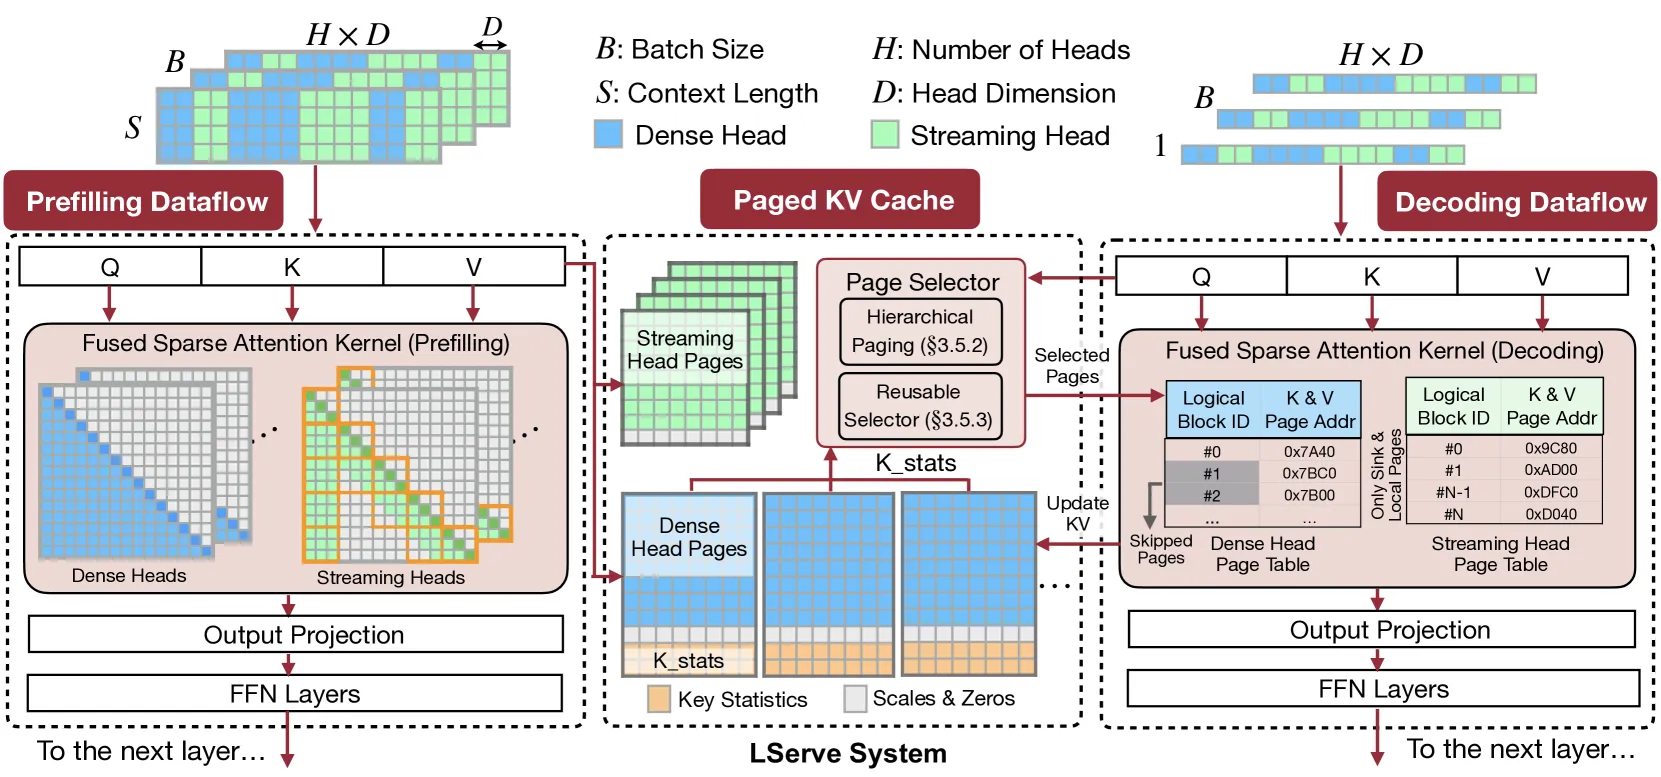
图5:LServe系统架构。在prefilling阶段,LServe在融合的稀疏注意力核中处理dense heads和streaming heads。过去的Keys和Values存储在两个独立的分页系统中。在decoding阶段,LServe对dense heads应用动态稀疏,只加载选中的KV页面进行注意力计算。
3.2 关键组件
3.2.1 双路KV缓存管理
LServe维护两套独立的KV缓存:
┌─────────────────────────────────────────────────────┐
│                    LServe KV Cache                   │
├─────────────────────────┬───────────────────────────┤
│   Streaming Head Cache  │    Dense Head Cache       │
│   (Λ形掩码,固定模式)    │    (支持动态稀疏)          │
│   - Sink tokens         │    - 完整KV数据            │
│   - Local tokens        │    - Key统计信息           │
│                         │    (用于页面选择)           │
└─────────────────────────┴───────────────────────────┘
3.2.2 Prefilling阶段流程
- 稀疏性确定:使用DuoAttention的优化方法识别每个注意力头的类型
- 融合核处理:使用迭代器抽象统一处理dense和streaming heads
- 量化写回:将KV特征以量化形式写入两套缓存
3.2.3 Decoding阶段流程
- 动态页面选择:使用层级化页面选择器识别重要KV页面
- 稀疏注意力计算:只加载选中的页面进行注意力计算
- 可复用选择:利用相邻token的相似性复用选择结果
3.3 GPU核实现
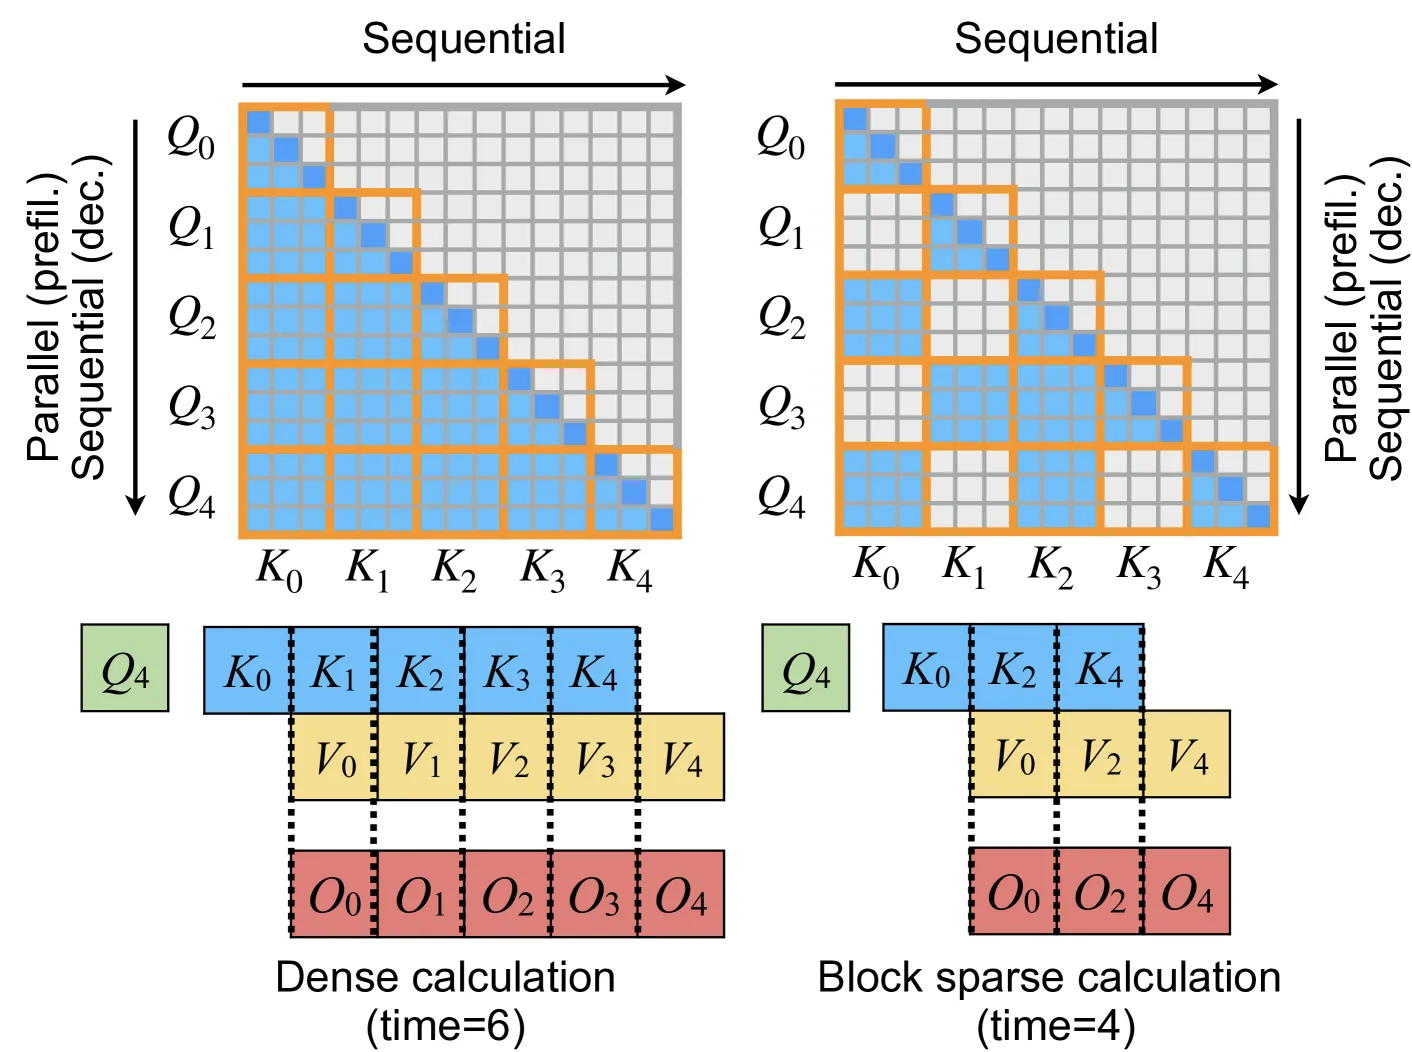
图3:GPU上的注意力计算:在decoding和prefilling阶段,每个查询token以块为单位顺序遍历所有key和value tokens。跳过KV块减少了顺序迭代次数,直接加速注意力计算。
LServe的核实现特点:
- 迭代器抽象:标准化索引操作,只循环需要计算的块
- 两级索引层次:物理索引(线程迭代步)和逻辑索引(KV缓存中的实际位置)
- 融合设计:将streaming和dense heads的计算统一到同一GPU核中
四、核心创新 (Core Innovations)
4.1 Streaming Heads(静态稀疏)
| 特性 | 描述 |
|---|---|
| 识别方法 | 基于DuoAttention的优化方法,获取每个头的门控值 α ∈ [0,1] |
| 稀疏比例 | 默认50%的头被转换为streaming heads |
| 注意力模式 | Λ形掩码:只关注sink tokens和local tokens |
| 优势 | 计算复杂度恒定,不随序列长度增长 |
4.2 层级化分页(Hierarchical Paging)
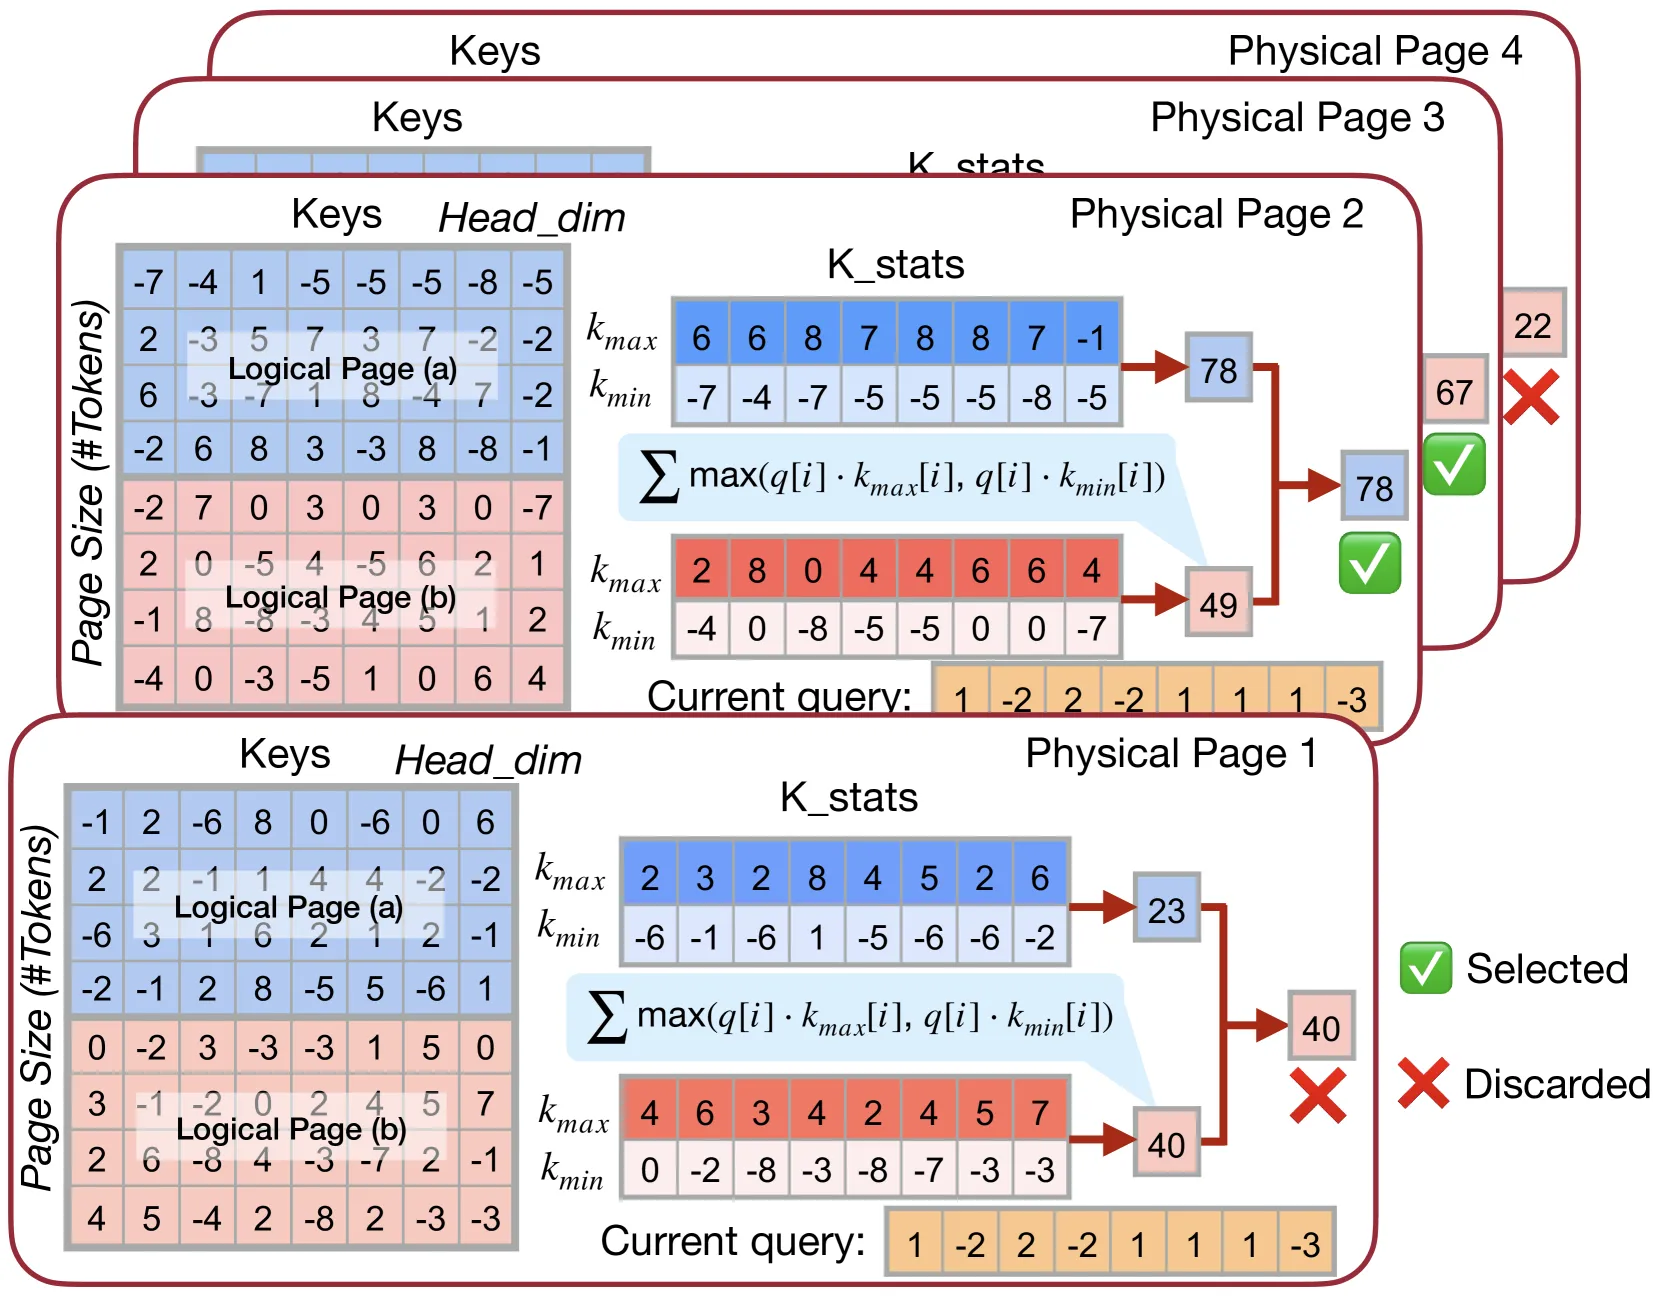
图7:LServe系统中的层级化分页。假设每个物理页面包含N_p=8个tokens,每个逻辑页面有N_l=4个tokens。k_max和k_min向量连接到每个物理页面的末尾,在context阶段和之前的decoding步骤中预计算。
核心设计:
- 物理页面:大页面(如64 tokens),优化GPU内存带宽利用
- 逻辑页面:小页面(如16 tokens),保持精细粒度的关键性估计
- 映射关系:一个物理页面包含g个逻辑页面(g = N_p / N_l)
重要性计算公式:
S^j = Σ_i^D max(q[i] * k^j_max[i], q[i] * k^j_min[i])其中 S^j 是逻辑页面j的重要性分数,D是头维度。
物理页面重要性:通过对包含的所有逻辑页面的重要性分数进行max-reduction得到。
4.3 可复用页面选择器(Reusable Page Selector)
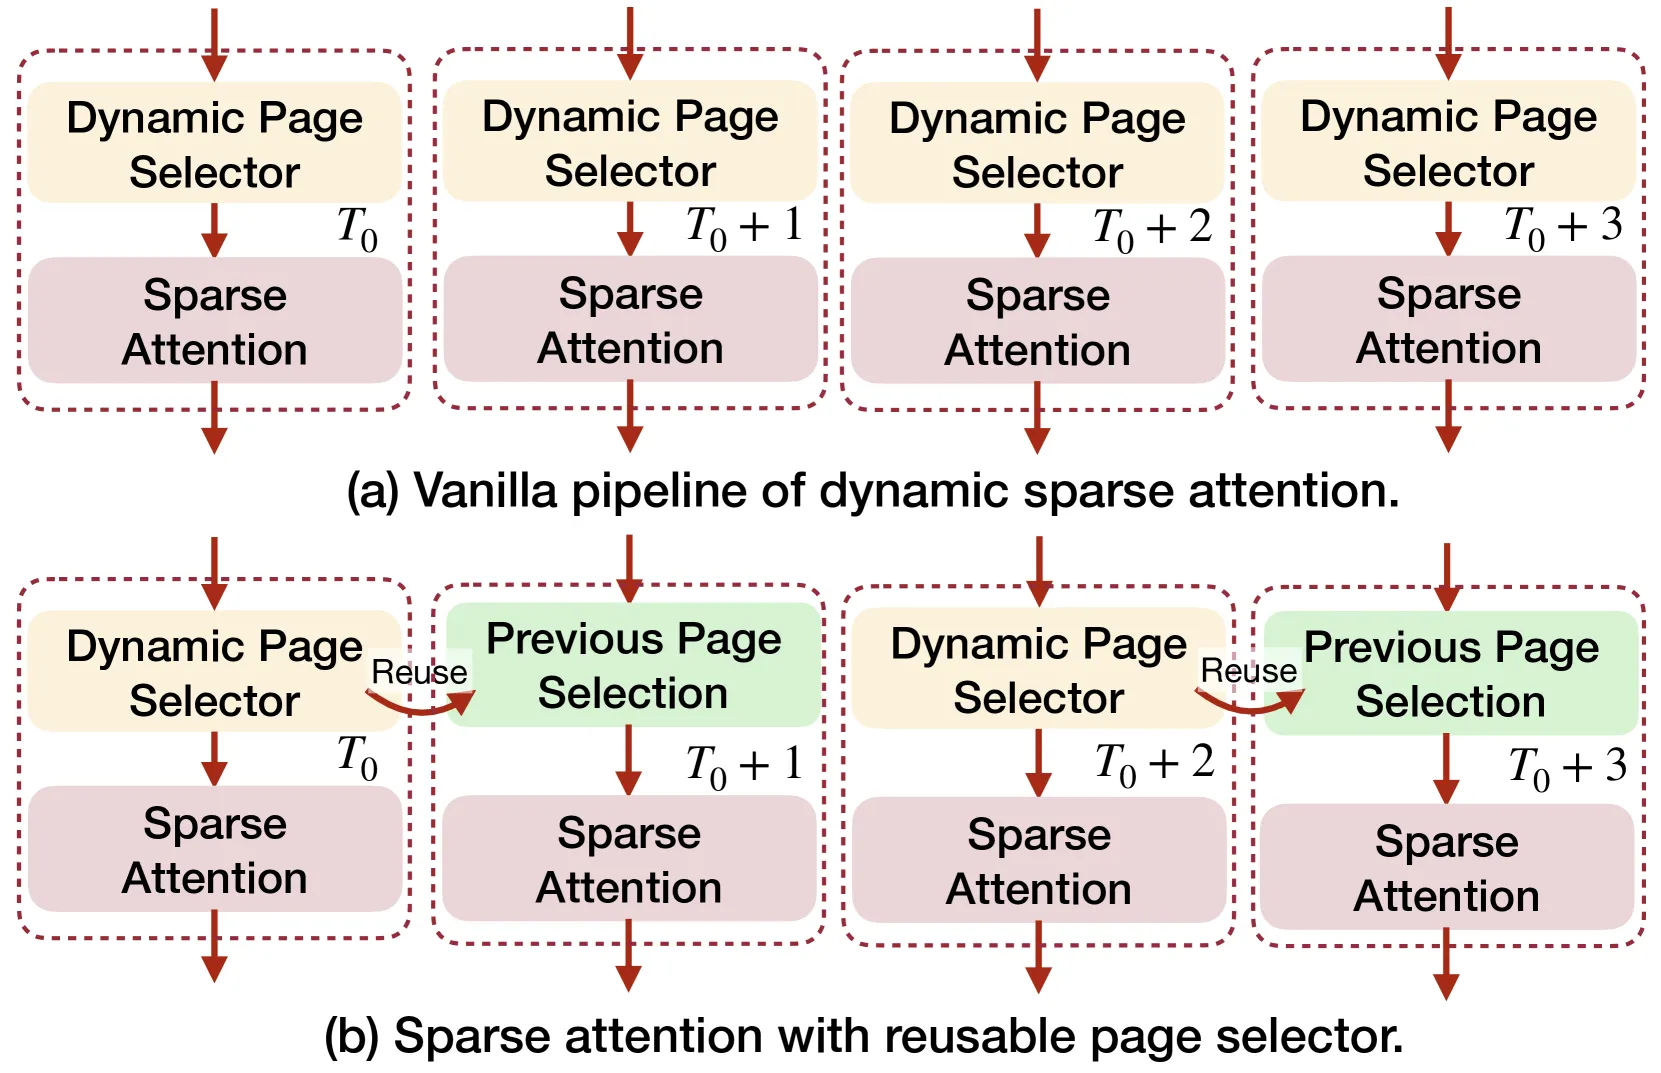
图8:LServe中的可复用页面选择器,利用连续token查询的相似性来减少选择器开销。
核心思想:利用注意力的时序局部性——相邻的查询token往往关注相似的历史页面。
实现方式:
- 只在预定义chunk的开始激活页面选择器
- 同一chunk内的后续token复用第一个token的选择结果
- 默认chunk大小为4
开销降低:页面选择开销降低C倍(C为复用间隔)
4.4 页面大小困境的解决
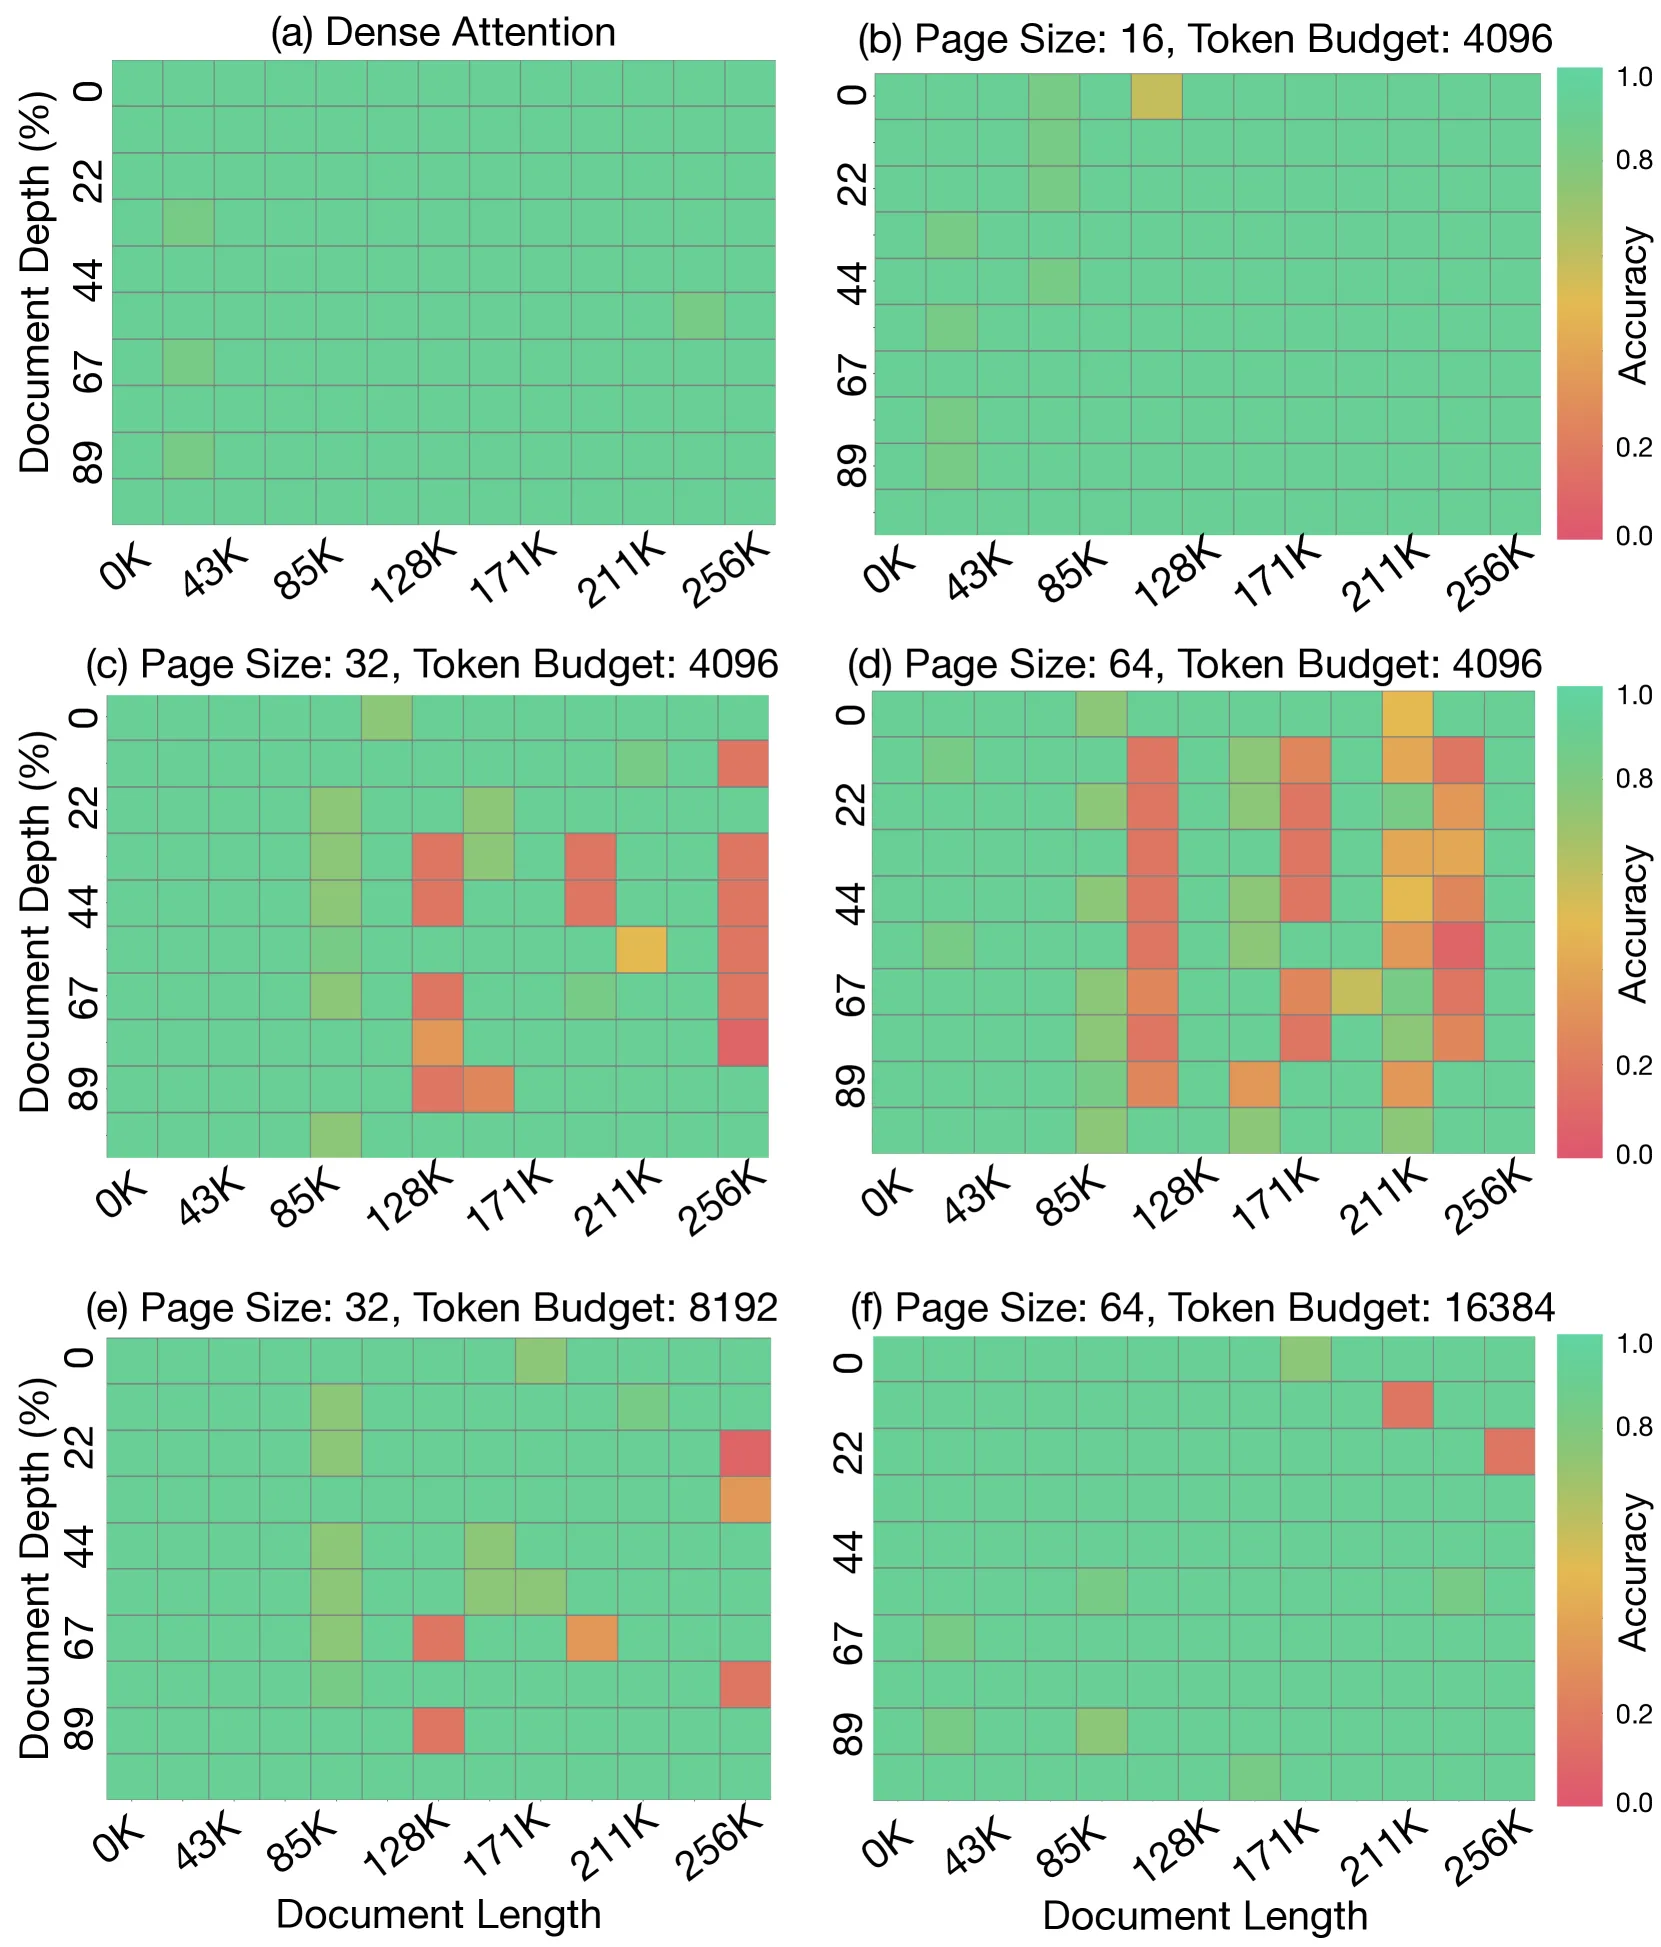
图6:在Llama-3-8B模型上评估Needle-in-a-Haystack基准。当KV页面粒度增大时,查询感知页面选择算法的效果会受到影响。
问题:
- 量化需要大页面(≥64)以保持GPU内存带宽利用率
- 大页面导致页面统计信息同质化,降低选择准确性
解决方案:
- 层级化分页将选择粒度与物理内存布局解耦
- 利用自然语言的语义连续性(空间局部性)
- 重要逻辑页面倾向于聚集在相似的物理页面中
五、实验结果 (Experimental Results)
5.1 实验设置
| 项目 | 配置 |
|---|---|
| 硬件 | 8× NVIDIA A100 80GB GPU, 2× AMD EPYC 7763 CPU |
| 软件 | PyTorch 2.5.0, CUDA 12.4, cuDNN 9.2.0 |
| 模型 | Llama-3-8B (GQA), Llama-2-7B (MHA), Minitron-4B |
| 序列长度 | 最长512K tokens |
| 基线系统 | vLLM, QServe, MInference, DuoAttention, Quest |
5.2 准确性评估
LongBench评估
| 基准 | Llama-3-8B Dense | Llama-3-8B LServe | Llama-2-7B Dense | Llama-2-7B LServe |
|---|---|---|---|---|
| 2WikiMQA | 30.3 | 31.6 | 35.4 | 35.1 |
| DuReader | 30.3 | 30.8 | 25.4 | 24.7 |
| HotpotQA | 41.7 | 42.7 | 47.4 | 49.6 |
| MultiNews | 27.7 | 27.7 | 26.6 | 26.6 |
| Qasper | 31.7 | 29.3 | 32.6 | 29.5 |
| QMSum | 23.8 | 24.0 | 21.0 | 21.3 |
| SamSum | 41.2 | 39.3 | 41.8 | 41.5 |
| TriviaQA | 84.9 | 83.7 | 86.2 | 86.5 |
| 平均 | 38.9 | 38.6 | 39.5 | 39.4 |
表2:LongBench准确性评估。LServe在保持原始模型准确性的同时实现了显著加速。
RULER评估
| 配置 | 32K | 64K | 128K | 160K | 192K | 256K |
|---|---|---|---|---|---|---|
| Dense | 90.5 | 86.8 | 83.8 | 79.3 | 79.6 | 79.4 |
| LServe-4096 | 91.0 | 85.6 | 81.0 | 79.0 | 76.1 | 75.7 |
| LServe-8192 | 91.8 | 86.1 | 81.7 | 81.2 | 79.7 | 79.1 |
表3:RULER基准评估(Llama-3-8B)。LServe-8192在长序列上几乎保持原始模型准确性。
Needle-in-a-Haystack评估
图9:Needle-in-a-Haystack测试结果显示LServe与dense基线达到相同水平的准确性。
5.3 效率评估
Decoding阶段加速
| 模型 | 相对vLLM加速 | 平均加速 |
|---|---|---|
| Llama-3-8B (A100) | 1.3-1.8× | 1.5× |
| Minitron-4B (A100) | 1.3-1.7× | 1.5× |
| Llama-2-7B (A100) | 1.5-2.5× | 2.0× |
| Llama-3-8B (L40S) | 1.3-1.7× | 1.5× |
图10:Decoding速度评估。LServe在不同GPU平台和模型架构上都展示了显著且一致的效率提升。
Prefilling阶段加速
| 模型 | 相对vLLM平均加速 | 最大加速 |
|---|---|---|
| Llama-3-8B | 2.0× | 2.9× |
| Llama-2-7B | 1.8× | 2.5× |
图11:Prefilling速度评估。LServe在不同序列长度上都保持了优越的prefilling吞吐量。
与Quest的对比
| 阶段 | 系统 | 4K | 8K | 16K | 32K | 64K |
|---|---|---|---|---|---|---|
| Prefilling (s) | Quest | 0.51 | 0.82 | 1.62 | 3.61 | OOM |
| LServe | 0.24 | 0.49 | 1.08 | 2.32 | 5.27 | |
| 加速 | 2.1× | 1.7× | 1.5× | 1.6× | - | |
| Decoding (ms) | Quest | 13.13 | 13.58 | 14.08 | 14.86 | OOM |
| LServe | 10.02 | 10.29 | 10.22 | 10.24 | 11.54 | |
| 加速 | 1.3× | 1.3× | 1.4× | 1.5× | - |
表4:LServe在prefilling(1.6-2.1×加速)和decoding(1.3-1.5×加速)阶段都优于Quest。
5.4 消融研究
静态稀疏与动态稀疏的效果
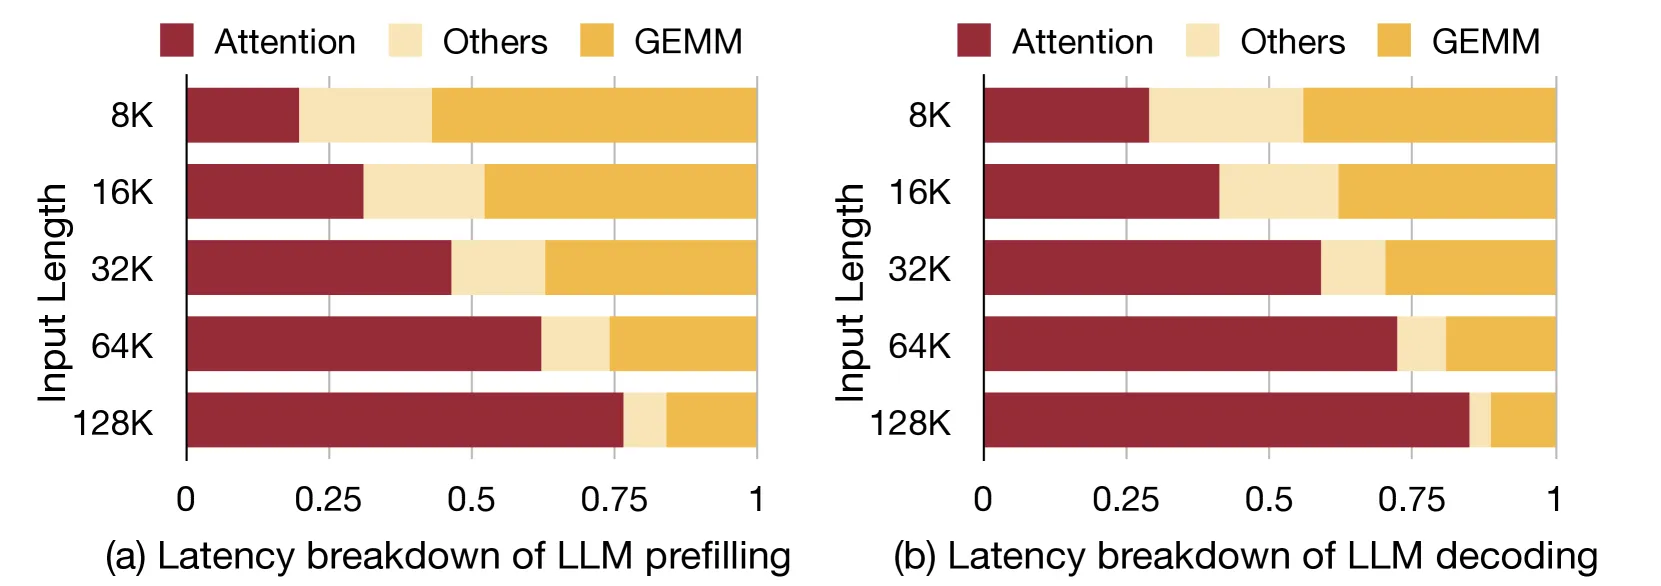
图15:LServe中静态和动态稀疏的效率增益。这些稀疏模式产生复合加速效果,静态稀疏在较短上下文更有效,动态稀疏在较长上下文提供更大收益。
| 稀疏类型 | 机制 | 加速效果 |
|---|---|---|
| 静态稀疏 | 50% streaming heads | 1.3-1.7× |
| 动态稀疏 | 4096 token预算 | 30× (256K序列) |
| 组合 | 静态+动态 | 乘法级加速 |
可复用页面选择器效果
| 复用间隔 | 1 | 2 | 4 | 8 | 16 |
|---|---|---|---|---|---|
| LServe-4096 | 86.2 | 85.6 | 85.6 | 84.8 | 83.2 |
| LServe-8192 | 86.1 | 85.8 | 85.5 | 85.6 | 84.8 |
表5:可复用页面选择器在保持准确性的同时显著降低开销。默认复用间隔设为4。
端到端加速分解
图16:LServe端到端加速分解。静态稀疏在较短上下文长度下收益更大,而动态稀疏在较长序列上实现高达4.5×的端到端加速。
六、相关工作 (Related Work)
6.1 LLM服务系统
| 系统 | 核心技术 | 特点 |
|---|---|---|
| Orca | 迭代级调度 | 分布式系统的选择性批处理 |
| vLLM | PagedAttention | 受虚拟内存启发的KV缓存管理 |
| TensorRT-LLM | PagedAttention | 工业级解决方案,支持in-flight batching |
| QServe | W4A8KV4量化 | 量化与系统协同设计 |
| SGLang | RadixAttention | 领域特定语言和注意力优化 |
6.2 稀疏注意力方法
| 方法 | 类型 | 特点 | 局限 |
|---|---|---|---|
| BigBird | 静态 | 混合局部、全局和随机注意力 | 固定模式 |
| StreamingLLM | 静态 | 只保留sink和local tokens | 丧失长上下文能力 |
| H2O | 静态 | Heavy-Hitter Oracle | 丧失长上下文能力 |
| DuoAttention | 静态 | 优化方法识别retrieval/streaming heads | 不支持动态稀疏 |
| Quest | 动态 | 查询感知的页面选择 | 不支持GQA架构 |
| MInference | 动态 | 加速prefilling阶段 | decoding阶段未优化 |
| LServe | 混合 | 统一静态+动态稀疏 | 本文方法 |
6.3 LServe的优势
LServe相比现有方法的关键优势:
- 统一框架:将prefilling和decoding的稀疏优化统一到单一框架
- 正交组合:静态和动态稀疏可以乘法级组合
- 准确性保持:通过层级化分页保持原始模型的长上下文能力
- 系统级优化:从核实现到系统架构的全栈优化
七、总结 (Conclusion)
7.1 主要成果
LServe通过混合稀疏注意力实现了长序列LLM服务的显著加速:
| 指标 | 结果 |
|---|---|
| Prefilling加速 | 最高2.9×(相对vLLM) |
| Decoding加速 | 1.3-2.1×(相对vLLM) |
| 准确性保持 | LongBench、NIAH、RULER基准上与原始模型相当 |
| 内存优化 | 通过量化和稀疏减少KV缓存内存占用 |
7.2 技术亮点
- 统一块稀疏注意力:将多种稀疏模式集成到硬件友好的块稀疏框架
- Streaming Heads:将50%的注意力头转换为几乎免费的流式头
- 层级化分页:解耦选择粒度与物理内存布局,解决页面大小困境
- 可复用页面选择:利用时序局部性将选择开销降低4倍
7.3 意义与影响
LServe证明了混合注意力稀疏是长序列LLM服务的”免费午餐”——在不牺牲准确性的前提下实现显著加速。这一发现对以下领域有重要影响:
- 长上下文应用:使百万token级的上下文处理更加高效
- 推理密集型任务:加速如OpenAI o1等需要长思维链的模型
- 边缘部署:降低长序列推理的资源需求
7.4 局限性与未来方向
- 当前实现基于QServe和TensorRT-LLM,需要特定的量化支持
- 静态稀疏模式的确定依赖于离线profiling
- 层级化分页增加了系统的复杂性
八、参考资源 (References)
8.1 论文链接
- arXiv: https://arxiv.org/abs/2502.14866
- PDF: https://arxiv.org/pdf/2502.14866
- HTML: https://arxiv.org/html/2502.14866v1
8.2 代码与项目
8.3 关键图表
| 图表 | 文件名 | 描述 |
|---|---|---|
| Figure 1 | figures/lserve/figure1_system_overview.png | LServe系统概述 |
| Figure 2 | figures/lserve/figure2_latency_breakdown.png | 延迟分解分析 |
| Figure 3 | figures/lserve/figure3_gpu_attention.png | GPU注意力计算机制 |
| Figure 4 | figures/lserve/figure4_block_sparse_pattern.png | 统一块稀疏注意力模式 |
| Figure 5 | figures/lserve/figure5_system_overview.png | LServe详细系统架构 |
| Figure 6 | figures/lserve/figure6_niah_page_size.png | NIAH页面大小影响 |
| Figure 7 | figures/lserve/figure7_hierarchical_paging.png | 层级化分页机制 |
| Figure 8 | figures/lserve/figure8_reusable_selector.png | 可复用页面选择器 |
8.4 相关论文
- DuoAttention: Xiao et al., “DuoAttention: Efficient Long-Context LLM Inference with Retrieval and Streaming Heads”, 2024
- Quest: Tang et al., “Quest: Query-aware Sparsity for Efficient Long-Context LLM Inference”, 2024
- MInference: Jiang et al., “MInference 1.0: Accelerating Pre-filling for Long-Context LLMs via Dynamic Sparse Attention”, 2024
- QServe: Lin et al., “QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving”, 2024
- vLLM: Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention”, 2023
- StreamingLLM: Xiao et al., “Efficient Streaming Language Models with Attention Sinks”, 2023
8.5 引用格式
@article{yang2025lserve,
  title={LServe: Efficient Long-sequence LLM Serving with Unified Sparse Attention},
  author={Yang, Shang and Guo, Junxian and Tang, Haotian and Hu, Qinghao and Xiao, Guangxuan and Tang, Jiaming and Lin, Yujun and Liu, Zhijian and Lu, Yao and Han, Song},
  journal={arXiv preprint arXiv:2502.14866},
  year={2025}
}
本文档生成时间:2025-05-30 分析工具:Claude Code