KernelBench: Can LLMs Write Efficient GPU Kernels?
A benchmark framework for evaluating LLMs' ability to generate fast and correct GPU kernels across 250 PyTorch workloads
KernelBench: Can LLMs Write Efficient GPU Kernels?
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | KernelBench: Can LLMs Write Efficient GPU Kernels? |
| 作者 | Anne Ouyang, Simon Guo, Simran Arora, Alex L. Zhang, William Hu, Christopher Re, Azalia Mirhoseini |
| 机构 | Stanford University, Princeton University |
| 论文 | https://arxiv.org/abs/2502.10517 |
| 代码 | 未在论文页面找到独立仓库 |
| 发布 | 2025-02-14 (v1) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
高效的 GPU kernel 是构建高性能机器学习架构的关键,但编写这些 kernel 是一项耗时且需要深厚专业知识的挑战。尽管 AI 架构经历了”寒武纪大爆发”(如各种 Transformer 变体),其可用实现往往达不到峰值性能。以 FlashAttention 为例:Transformer 提出 5 年后才有初始 kernel,NVIDIA Hopper GPU 发布后又花了两年才完成算法移植。
本文探讨的核心问题是:语言模型能否帮助编写正确且优化的 GPU kernel?
解决方案概述
作者提出了 KernelBench——一个开源框架,用于评估 LLM 在 250 个精心选择的 PyTorch ML 工作负载上编写快速且正确的 kernel 的能力。KernelBench 代表了一个真实的工程环境,在基准测试上的进步可以直接转化为更快的生产环境 kernel。
作者引入了一个新评估指标 fast_p,衡量生成的 kernel 既功能正确又比基线快 p 倍以上的比例。实验表明,前沿推理模型(如 OpenAI o1、DeepSeek R1)表现最好,但仍远未达标——在少于 20% 的情况下能匹配 PyTorch 基线。通过迭代反馈优化可显著提升性能。
三、技术架构
整体框架图
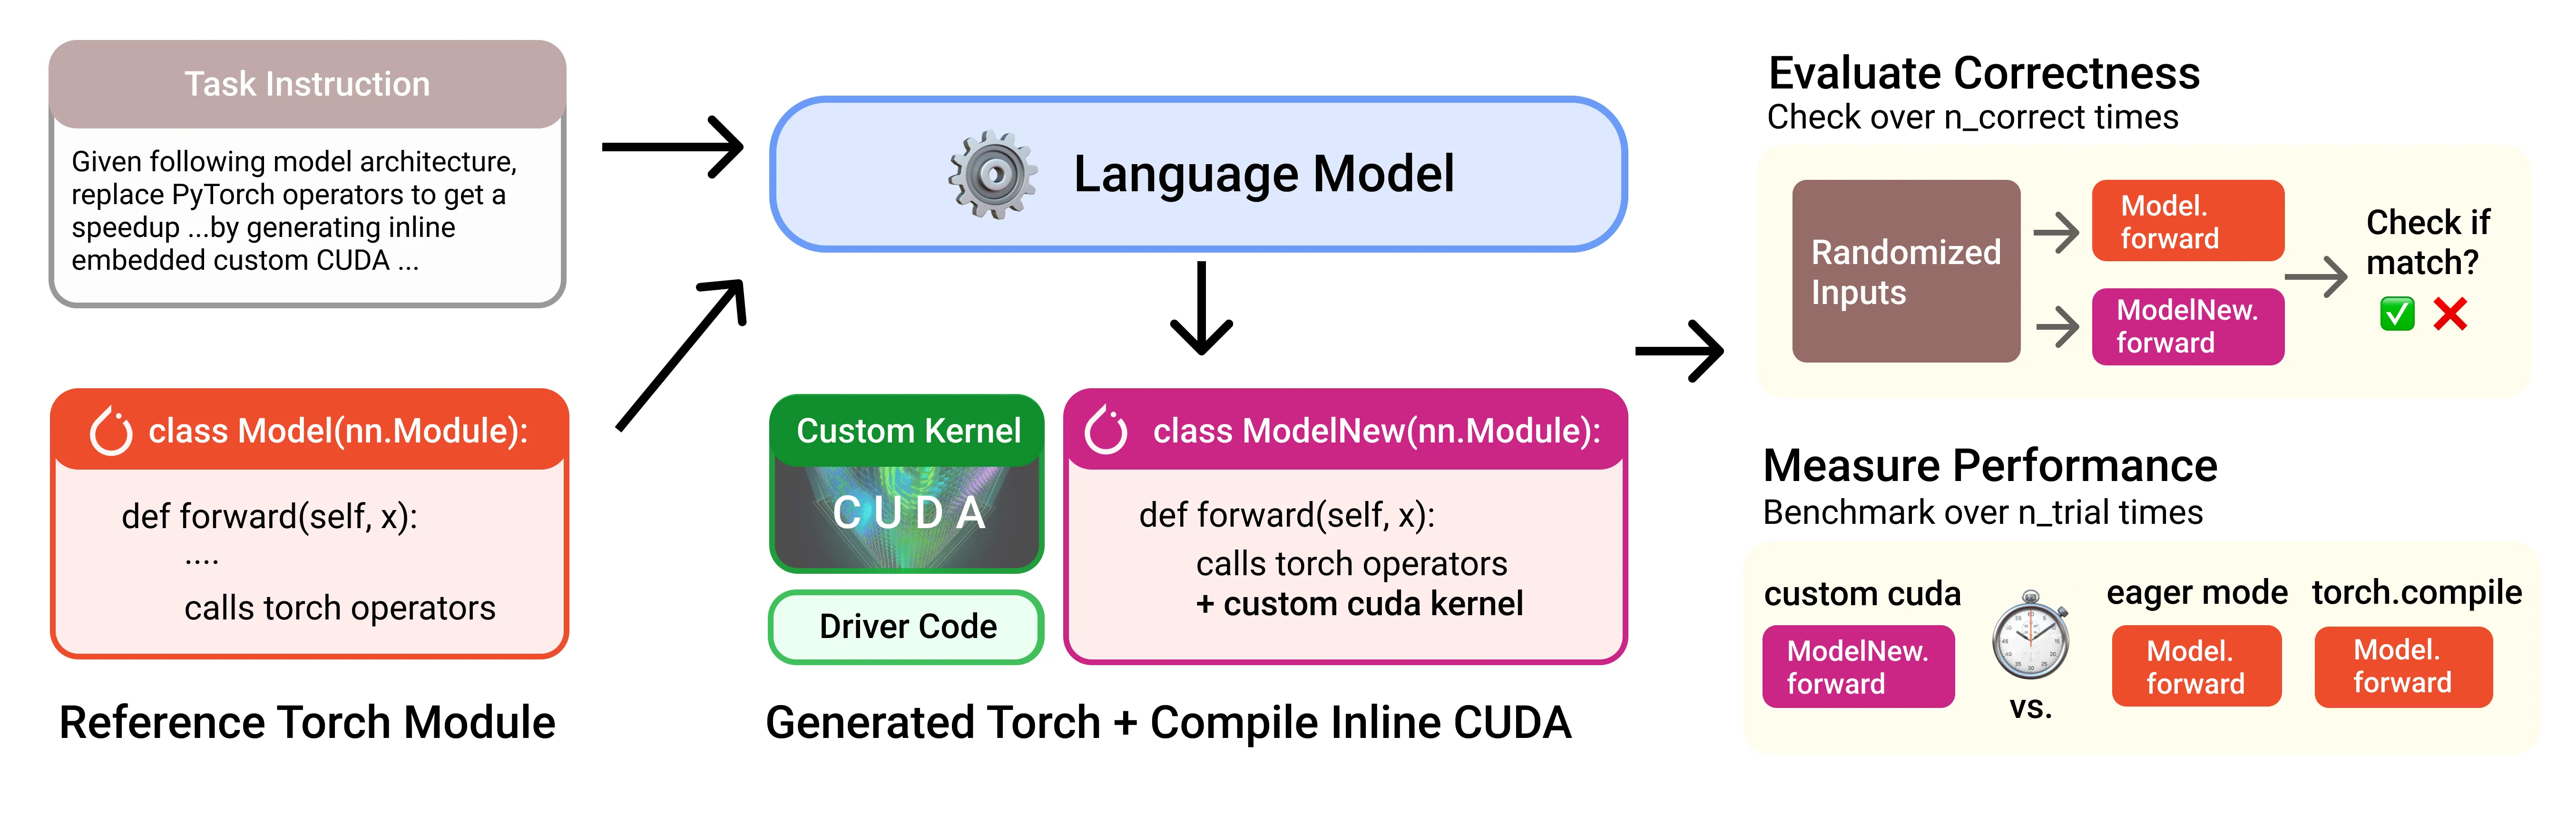
KernelBench 的工作流程如下:
┌─────────────────────────────────────────────────────┐
│                   KernelBench                         │
├─────────────────────────────────────────────────────┤
│                                                     │
│  Task Input: PyTorch Model (torch.nn.Module)        │
│    ├── __init__()                                   │
│    └── forward()  + get_inputs() / get_init_inputs()│
│                    ↓                                │
│  LLM Generation → ModelNew (torch.nn.Module)        │
│    ├── 可嵌入 CUDA-C 扩展                            │
│    ├── 可使用 PTX / Triton / CUTLASS                 │
│    └── 可选择任意算子进行优化                        │
│                    ↓                                │
│  Automated Evaluation:                              │
│    1. Correctness: 输出张量比较 (5 个随机输入)        │
│    2. Performance: 壁钟时间重复试验                   │
│                    ↓                                │
│  Metric: fast_p = Σ 𝟙(correct ∧ speedup > p) / N   │
└─────────────────────────────────────────────────────┘
核心公式
评估指标 fast_p:
其中:
- = 功能正确率(不考虑速度)
- = 正确且加速 >1× 的比例(比 PyTorch 快)
- 为可调速度阈值参数
速度比计算:
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Task Input | PyTorch torch.nn.Module 类,含 __init__ 和 forward | 每个 task 附带 get_inputs() 和 get_init_inputs() 函数指定输入张量形状和数据类型 |
| Task Output | LLM 生成新的 ModelNew 类 | 可嵌入 CUDA-C 扩展、使用 PTX/Triton/CUTLASS/ThunderKittens 等 |
| Correctness Checker | 5 个随机输入,比较 Model 和 ModelNew 的输出 | 张量形状和值匹配 |
| Performance Profiler | 重复试验测量壁钟时间 | 在 NVIDIA L40S 上评估 |
| Feedback Engine | NVCC 编译错误、执行统计、PyTorch profiler | 用于迭代优化 |
训练流程
KernelBench 是一个纯评估基准,不提供 ground truth kernel。实验设置包括多种评估模式:
| 模式 | 描述 |
|---|---|
| One-shot Baseline | 给定 1 个示例,greedy decoding 生成 kernel |
| Repeated Sampling | 高温度采样 k 次,取最佳结果 (fast_p@k) |
| Iterative Refinement | 多轮反馈优化,提供上一代代码 G、执行结果 E、profiler 输出 P |
| Few-shot In-Context | 提供多个硬件优化示例(tiling、fusion、FlashAttention) |
| Hardware-aware | 提供 GPU 规格信息(带宽、TFLOPS、线程/块定义) |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| fast_p 指标 | 首次同时衡量正确性和性能的统一指标 | 可调节阈值 p,适应不同发展阶段的方法评估 |
| 三层任务设计 | Level 1(单算子) → Level 2(算子序列) → Level 3(完整架构) | 覆盖从基础 building block 到生产级架构的完整范围 |
| 真实工程环境 | 任务来自 pytorch/huggingface/transformers 等真实 GitHub 仓库 | 基准上的成功直接映射到生产价值(降低成本和能耗) |
| 自动化反馈闭环 | 编译器错误、执行结果、profiler 数据自动反馈给 LLM | 迭代优化实验中 DeepSeek-R1 L2 从 36% 提升到 72% |
| 跨硬件评估 | 同一 kernel 在 L40S/A10G/A100/H100 上测试 | 发现 one-shot 生成的 kernel 跨硬件泛化能力差 |
五、代码实现分析
KernelBench 任务格式设计模仿 AI 研究员的实际工作流程:
输入规范:
- PyTorch
Model类继承自torch.nn.Module() - 包含标准的
__init__和forward()函数 - 附带
get_inputs()和get_init_inputs()函数指定张量规格
输出要求:
- LLM 生成
ModelNew类继承自torch.nn.Module() - 可在
forward()中使用 inline CUDA-C 扩展 - 自由选择优化策略:fusion、tiling、tensor core 指令等
- 可使用任何编程库:PTX、CUDA、CUTLASS、Triton、ThunderKittens
评估管道:
- 并行化生成、编译、评估(跨 CPU/GPU)
- 提供可视化 UI 用于 kernel 检查(见图 13)
六、实验结果
基准测试
One-shot Baseline 性能 (fast_1 指标,NVIDIA L40S):
| 模型 | L1 (vs Eager) | L2 (vs Eager) | L3 (vs Eager) | L1 (vs compile) | L2 (vs compile) | L3 (vs compile) |
|---|---|---|---|---|---|---|
| GPT-4o | 4% | 5% | 0% | 18% | 4% | 4% |
| OpenAI o1 | 10% | 24% | 12% | 28% | 19% | 4% |
| DeepSeek V3 | 6% | 4% | 8% | 20% | 2% | 2% |
| DeepSeek R1 | 12% | 36% | 2% | 38% | 37% | 2% |
| Claude 3.5 Sonnet | 10% | 7% | 2% | 29% | 2% | 2% |
| Llama 3.1-70B Inst. | 3% | 0% | 0% | 11% | 0% | 0% |
| Llama 3.1-405B Inst. | 3% | 0% | 2% | 16% | 0% | 0% |
关键发现:
- DeepSeek R1 在 L2 上表现最佳(36% vs Eager, 37% vs torch.compile)
- OpenAI o1 在 L3 上领先(12% vs Eager)
- 所有模型在 L3(完整架构)上都表现极差(≤ 2%)
- 推理模型(o1、R1)执行失败更少,但功能正确性与其他模型相当
消融实验
Test-time 方法对比 (sample budget = 10,fast_1 指标):
| 方法 | L1-DeepSeekR1 | L2-DeepSeekR1 | L3-DeepSeekR1 | L2-DeepSeekV3 | L2-Llama70B |
|---|---|---|---|---|---|
| Single Attempt | 12% | 36% | 2% | 4% | 0% |
| Repeated Sampling @10 | — | — | — | 14% | 3% |
| Iterative G | — | 44% | 4% | 7% | 0% |
| Iterative G+E | — | 62% | 12% | 22% | 5% |
| Iterative G+E+P | — | 72% | 18% | 29% | 7% |
反馈组合效果:
- 仅提供上一代代码 G:小幅提升
- 加入执行结果 E:显著提升(R1 L2: 44% → 62%)
- 加入 profiler 输出 P:进一步提升(R1 L2: 62% → 72%)
重复采样效果 (DeepSeek-V3 & Llama 3.1-70B):
随着采样次数 k 从 1 增加到 100,fast_1@k 持续提升。DeepSeek-V3 在 L2 上从 4% 提升到 37%(k=100)。但某些困难任务(34 个卷积变体)即使 100 次采样也无法生成正确解。
与现有方法对比
跨硬件性能变化:
| 模型 | L40S | A10G | A100 | H100 |
|---|---|---|---|---|
| DeepSeek R1 L1 | 基线 | ~相似 | ~相似 | ~相似 |
| DeepSeek R1 L2 | 36% | 47% | 变化较大 | 变化较大 |
发现:one-shot 生成的 kernel 在不同 GPU 平台间不能很好地泛化。Level 2 任务在不同硬件上的速度提升变化更大。
有趣的速度案例:
| 算子 | 速度提升 | 优化技术 |
|---|---|---|
| Dense × Diagonal 矩阵乘法 | 13× | 算法优化:逐行缩放而非加载对角矩阵 |
| GELU activation | 2.9× | 算子融合 |
| Cosine Similarity | 2.8× | GPU shared memory |
| MatMul + Division + Sum + Scale | 2.6× | 多算子融合 |
| Triplet Margin Loss | 2.0× | GPU shared memory |
| Softsign | 1.3× | 算子融合 |
七、相关工作
- FlashAttention [8]:Transformer 提出 5 年后才有的高效注意力 kernel,是手动优化的经典案例
- PyTorch Compiler:编译器级融合已非常有效,LM 需要超越编译器规则的复杂算法
- CuBLAS [27]:PyTorch 底层调用的专家级优化闭源 kernel
- ThunderKittens [32]、Triton [36]:高级 kernel 编程语言,可能简化 LLM 生成
八、总结
核心贡献
- KernelBench 开源框架:250 个精心选择的 PyTorch 工作负载,涵盖三层难度(单算子 → 算子序列 → 完整架构)
- fast_p 统一指标:同时衡量功能正确性和性能加速,阈值可调
- 系统性模型评估:评测 7 种前沿模型(GPT-4o, o1, DeepSeek V3/R1, Claude 3.5S, Llama 70B/405B)在多种 test-time 方法下的表现
- 深入能力分析:揭示执行错误、功能正确性、跨硬件泛化等关键失败模式
- 可视化工具:提供 kernel 检查和生成轨迹可视化 UI
技术影响
- CUDA 在开源代码语料中占比仅 0.073%(The Stack v1.2),是典型的低资源语言
- 推理模型(o1、R1)因更少的执行失败而表现更好,但功能正确性瓶颈对所有模型相同
- 迭代反馈可将 DeepSeek-R1 L2 性能从 36% 提升到 72%,证明 feedback loop 的巨大潜力
- 现有 benchmark 最终会饱和,但 KernelBench 设计为动态演进:可适应新 AI 工作负载、新硬件平台、可调速度阈值
局限性
- 目前仅评估 GPU(CUDA),未来可扩展到其他硬件加速器
- LLM 主要生成 raw CUDA 代码,使用 Triton/CUTLASS 等高级抽象可能更易生成
- 前沿模型仍仅在 <20% 任务上超过 PyTorch Eager,距离实用化差距较大
- One-shot 生成的 kernel 跨硬件泛化能力差
九、参考资源
- arXiv: https://arxiv.org/abs/2502.10517
- PDF: https://arxiv.org/pdf/2502.10517
- HTML: https://arxiv.org/html/2502.10517v1
- License: CC BY 4.0
- 评估硬件: NVIDIA L40S (主要), A10G, A100, H100
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | KernelBench 整体流程图 | architecture-overview.png |
| Figure 3 | 错误分类(执行失败 vs 功能正确性) | error-breakdown.png |
| Figure 6 | 迭代反馈框架 | feedback-framework.png |
| Figure 7 | 迭代优化轨迹 (fast_1@N) | iterative-refinement.png |
| Figure 4 | fast_p 速度分布 | performance-table.png |