NanoVLMs: How small can we go and still make coherent Vision Language Models?
探索VLM最小化极限,通过儿童学习启发的简单词汇数据集训练5M-25M参数的VLM,达到与1.3B模型竞争的性能
NanoVLMs: How small can we go and still make coherent Vision Language Models?
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | NanoVLMs: How small can we go and still make coherent Vision Language Models? |
| 作者 | Mukund Agarwalla, Himanshu Kumar, Raj Dandekar, Rajat Dandekar, Sreedath Panat |
| 机构 | Indian Institute of Technology (IIT) |
| 论文 | https://arxiv.org/abs/2502.07838 |
| 发布 | 2025-02-11 |
二、核心思想
问题定义
当前VLM面临三大挑战:
| 挑战 | 说明 |
|---|---|
| 专有模型限制 | GPT-4V等模型不可访问 |
| 计算资源需求大 | 大模型需要大量GPU资源 |
| 小模型性能差 | GIT、BLIP等小模型无法生成连贯文本 |
核心问题:VLM可以小到什么程度,仍然能生成流畅、一致的文本?
解决方案概述
NanoVLMs 受3-4岁儿童学习方式启发:
- 儿童学习类比:3-4岁儿童主要通过视觉线索学习,使用简单词汇
- 简化数据集:创建ShortDesc(20-25词)和LongDesc(60-70词)两个数据集
- 简单词汇:限制在儿童常用的简单词汇和语法
- 极小模型:5M-25M参数,比SOTA小VLM小10-50倍
三、技术架构
整体框架
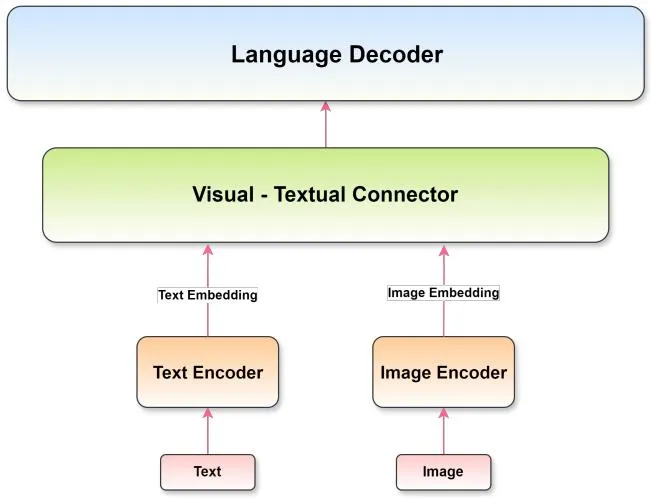
NanoVLM由三个核心组件构成:
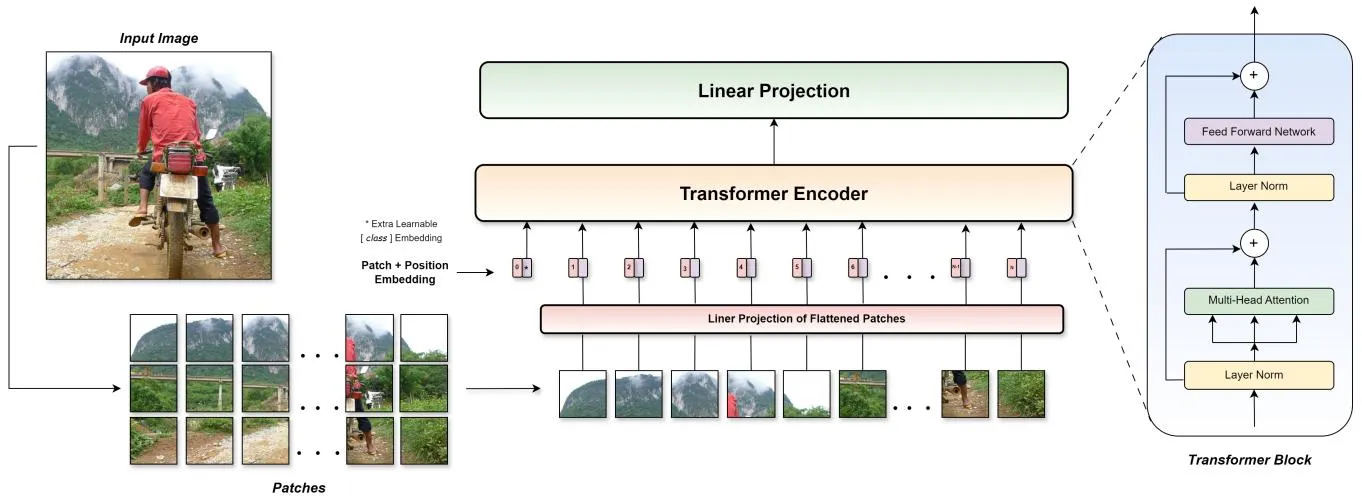
- 视觉编码器:基于ViT的紧凑图像特征提取
- 视觉-文本连接器:对齐视觉和文本嵌入空间
- 语言解码器:自回归Transformer文本生成
视觉编码器
- 输入分辨率:224×224像素
- Patch大小:16×16像素 → 196个patches
- 架构:2D卷积 → 层归一化 → ReLU → 全连接层
- [CLS] token聚合形成图像表示
视觉-文本连接器
- 多模态投影器:单层可学习层 + GELU激活
- 降低视觉嵌入维度
- 拼接视觉和文本嵌入形成多模态token
语言解码器
- 因果自注意力(防止信息泄露)
- 位置编码保持token顺序
- 层归一化 + 线性投影到词汇空间
- 交叉熵损失训练
模型规格
| 参数 | mini | base | large |
|---|---|---|---|
| Transformer块数 | 1 | 3 | 5 |
| 层数 | 4 | 8 | 10 |
| 注意力头数 | 8 | 8 | 16 |
| 头大小 | 12 | 16 | 12 |
| 嵌入维度 | 96 | 128 | 192 |
| 图像嵌入维度 | 400 | 512 | 512 |
| 总参数量 | 5M | 16M | 25M |
参数分布
| 模块 | mini | base | large |
|---|---|---|---|
| 视觉编码器 | 69% | 78% | 73% |
| 多模态投影器 | 14% | 8% | 6% |
| 解码器 | 17% | 16% | 21% |
设计原则:模仿3-4岁儿童主要通过视觉学习,将大部分参数分配给视觉编码器。
四、数据集构建
灵感来源
受3-4岁儿童学习方式启发:
- 儿童通过视觉线索理解世界
- 使用简单词汇和语法
- 简短、有意义的描述
数据集构建流程
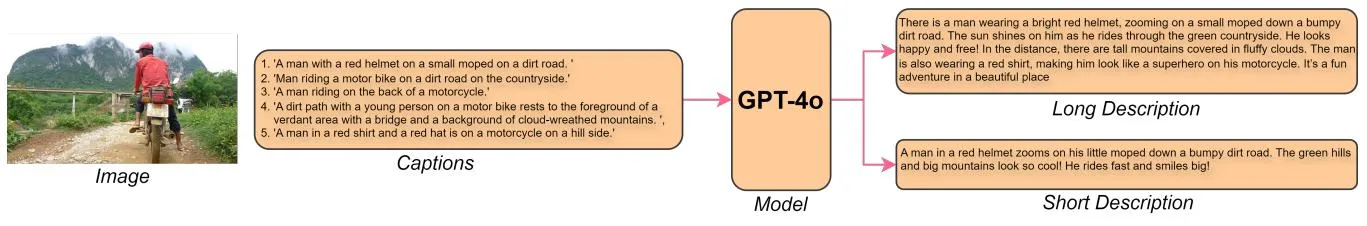
- 基础数据:COCO数据集(28K图像-描述对)
- GPT-4o生成:
- 输入:图像 + 5个原始描述
- Prompt 1(ShortDesc):20-25词简短描述
- Prompt 2(LongDesc):60-70词详细描述
- 训练/验证:90%训练,10%验证
- 测试:25个独立样本
评估方法
创新评估:使用GPT-4o作为评分器(Prompt 3)
5个评估维度(各10分):
- 语法(Grammar):语言正确性
- 一致性(Consistency):上下文连贯性
- 创造性(Creativity):想象力和新鲜感
- 有意义性(Meaningfulness):内容深度
- 情节(Plot):叙事结构
五、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| 儿童学习类比 | 受3-4岁儿童启发 | 启发式数据设计 |
| 简化词汇数据集 | ShortDesc/LongDesc | 降低学习难度 |
| 极小模型 | 5M-25M参数 | 资源高效 |
| GPT-4o评估 | 多维度打分 | 突破传统基准限制 |
| 高比例视觉参数 | 69-78%分配给视觉编码器 | 符合儿童学习模式 |
六、实验结果
训练与验证损失
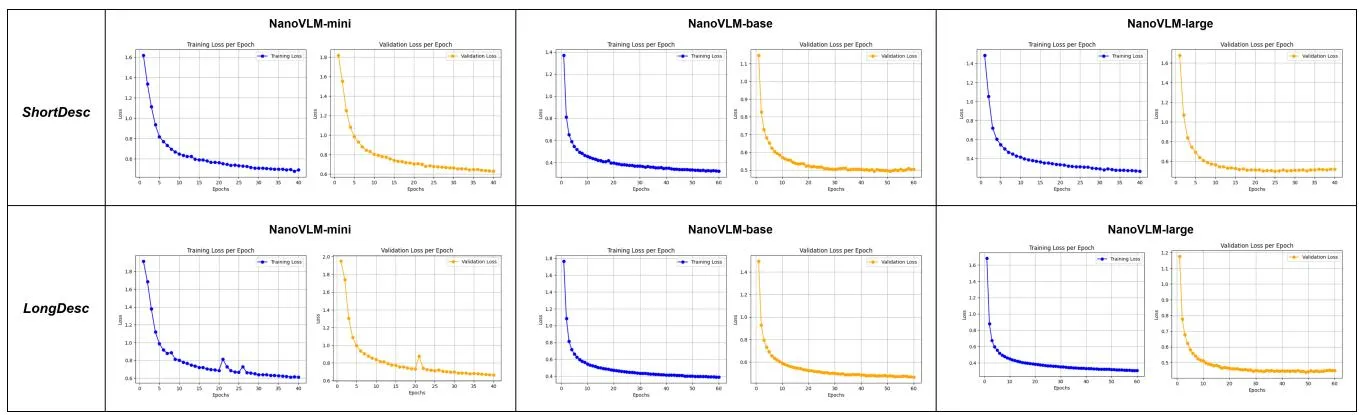
- 所有模型稳定收敛
- 训练-验证损失差距小(最大0.08-0.1)
- LongDesc任务损失稍高(文本更复杂)
模型对比(ShortDesc)
| 模型 | 参数量 | 语法 | 创造性 | 一致性 | 有意义性 | 情节 | 总分 |
|---|---|---|---|---|---|---|---|
| NanoVLM-mini | 5M | 6.36 | 7.44 | 6.28 | 6.12 | 5.72 | 31.92 |
| NanoVLM-base | 16M | 8.36 | 8.00 | 8.20 | 7.68 | 6.56 | 38.80 |
| NanoVLM-large | 25M | 8.20 | 8.00 | 7.83 | 7.79 | 7.75 | 39.39 |
| BLIP-base | 223M | 7.88 | 5.08 | 8.52 | 7.16 | 4.36 | 33.00 |
| GIT | 350M | 6.31 | 3.18 | 7.90 | 4.22 | 2.81 | 24.42 |
| Kosmos-2 | 1.3B | 8.73 | 7.15 | 9.15 | 8.15 | 6.68 | 39.86 |
关键发现:
- NanoVLM-large(25M)总分39.39,接近Kosmos-2(1.3B)的39.86
- NanoVLM-large在创造性(8.00)和情节(7.75)上超越Kosmos-2(7.15/6.68)
- BLIP-base和GIT虽然参数大10-14倍,但创造性严重不足
模型对比(LongDesc)
| 模型 | 参数量 | 语法 | 创造性 | 一致性 | 有意义性 | 情节 | 总分 |
|---|---|---|---|---|---|---|---|
| NanoVLM-mini | 5M | 5.92 | 7.36 | 5.36 | 5.72 | 4.56 | 28.92 |
| NanoVLM-base | 16M | 7.56 | 8.32 | 7.40 | 7.40 | 6.76 | 37.44 |
| NanoVLM-large | 25M | 8.24 | 8.52 | 7.84 | 8.08 | 7.16 | 39.84 |
| BLIP-base | 223M | 7.28 | 5.36 | 8.62 | 6.41 | 4.50 | 32.17 |
| GIT | 350M | 6.83 | 4.54 | 7.62 | 5.75 | 4.04 | 28.78 |
| Kosmos-2 | 1.3B | 8.90 | 7.70 | 8.95 | 8.30 | 6.80 | 40.65 |
关键发现:
- NanoVLM-large(25M)总分39.84,接近Kosmos-2(1.3B)的40.65
- NanoVLM-large在创造性(8.52)上显著超越Kosmos-2(7.70)
- BLIP-base和GIT在长文本生成上严重退化
样本输出对比
短文本完成:
- NanoVLM-mini:生成更多描述性内容,偶尔误解对象
- NanoVLM-base:更好的上下文准确性和连贯性平衡
- NanoVLM-large:与Kosmos-2相当,捕捉周围元素精确
长文本完成:
- NanoVLM-mini:连贯性差,引入无关元素
- NanoVLM-base:捕捉更多相关细节,但有重复
- NanoVLM-large:生成结构化、有意义的长描述,与Kosmos-2相当
ROUGE分数分析
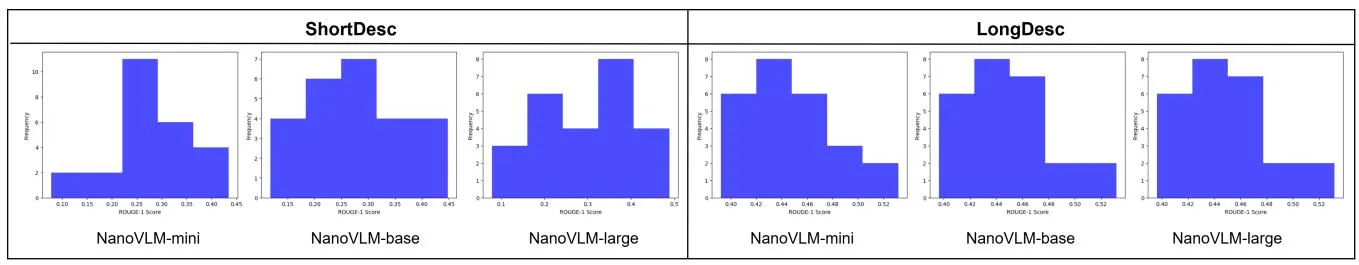
- 所有NanoVLM变体ROUGE-1分数均低于0.5
- 确认模型生成多样化描述,而非记忆训练数据
- 证明模型具有泛化能力
七、相关工作
大型VLM
- GPT-4V/GPT-4o:多模态大模型
- LLaVA:视觉指令微调
- Qwen2-VL:增强视觉感知
- Flamingo:少样本视觉语言学习
小型VLM
- BLIP-base:223M参数
- GIT:350M参数
- Kosmos-2:1.3B参数
- TinyGPT-V:紧凑VLM
模型压缩
- TinyStories:文本领域的小模型研究
- 知识蒸馏:大模型到小模型
- 量化:降低精度
NanoVLMs的差异化
- 极端压缩:5M-25M参数,比SOTA小10-50倍
- 儿童学习启发:独特的数据集设计方法
- 简化词汇:降低语言复杂度
- GPT-4o评估:突破传统基准限制
八、总结
核心贡献
- 探索VLM最小化极限:证明5M-25M参数可以生成连贯文本
- 儿童学习启发的数据集:ShortDesc和LongDesc,使用简单词汇
- GPT-4o多维度评估:语法、一致性、创造性、有意义性、情节
- 竞争性性能:NanoVLM-large(25M)接近Kosmos-2(1.3B),在创造性上超越
技术影响
- 资源受限环境:为低资源设备提供VLM方案
- 教育应用:简单词汇适合儿童教育
- 模型设计指导:证明小模型+好数据可以匹敌大模型
- 评估创新:GPT-4o作为多维度评估器
局限性
- 数据集规模小:仅28K图像-描述对,限制泛化
- 任务单一:仅评估图像描述生成,未覆盖VQA等任务
- 评估依赖GPT-4o:评估成本高,可能引入偏见
- 简单词汇限制:无法处理复杂语言任务
- 缺乏人类评估:仅依赖自动评估,未进行大规模人类评估
九、参考资源
论文
相关工作
- COCO: 基础数据集
- BLIP: 视觉语言预训练
- GIT: 生成式图像到文本
- Kosmos-2: 多模态大模型
- LLaVA: 视觉指令微调