Taming Latency-Memory Trade-Off in MoE-Based LLM Serving via Fine-Grained Expert Offloading
通过细粒度专家卸载优化MoE大模型服务的延迟-内存权衡
Taming Latency-Memory Trade-Off in MoE-Based LLM Serving via Fine-Grained Expert Offloading
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Taming Latency-Memory Trade-Off in MoE-Based LLM Serving via Fine-Grained Expert Offloading |
| 作者 | Hanfei Yu, Xingqi Cui, Hong Zhang, Hao Wang, Hao Wang |
| 机构 | Stevens Institute of Technology, Rice University, University of Waterloo, Rutgers University |
| 会议 | EuroSys ‘26 (21st European Conference on Computer Systems) |
| 论文 | arXiv:2502.05370 |
| 领域 | cs.LG, cs.AI, cs.DC |
二、核心思想
问题定义
Mixture-of-Experts (MoE) 架构已成为现代大语言模型的主流骨干,但其服务阶段面临严重的内存效率问题:
| MoE模型 | 参数量 (活跃/总计) | 每层专家 (活跃/总计) | 层数 | 非活跃参数占比 |
|---|---|---|---|---|
| Mixtral-8×7B | 12.9B / 46.7B | 2/8 | 32 | 72% |
| Qwen1.5-MoE | 2.7B / 14.3B | 4/60 | 24 | 81% |
| Phi-3.5-MoE | 6.6B / 42B | 2/16 | 32 | 84% |
MoE服务的延迟-内存权衡困境:
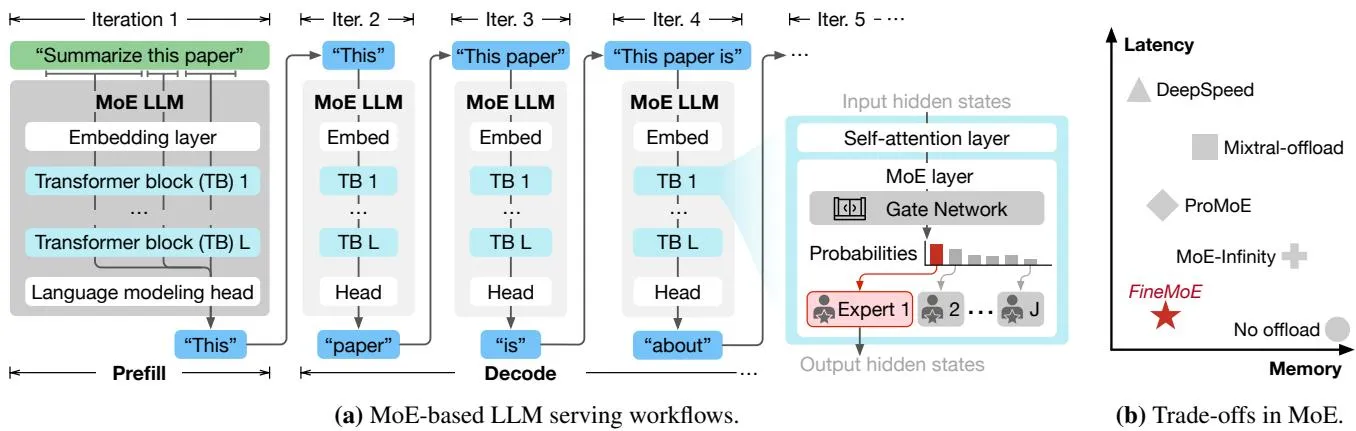
现有专家卸载方案无法同时实现低延迟和低内存占用:
| 方案类型 | 代表方法 | 优势 | 问题 |
|---|---|---|---|
| 低延迟优先 | No-offload, MoE-Infinity | 低推理延迟 | 内存占用大 |
| 低内存优先 | ProMoE, Mixtral-Offloading, DeepSpeed | 内存效率高 | 推理延迟高 |
根本原因:
- 粗粒度设计:现有方案在请求级别跟踪专家模式,聚合后的模式熵值高、可预测性差
- 平衡路由:MoE模型使用负载均衡损失,导致专家使用更均匀
- 模型异质性:不同MoE模型和输入提示具有不同特性,一刀切设计无法适应
解决方案概述
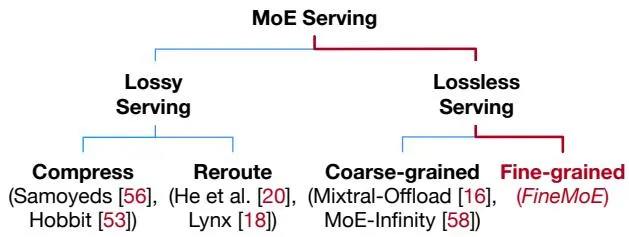
FineMoE提出细粒度专家卸载系统,通过以下创新解决延迟-内存权衡:
- Expert Map数据结构:迭代级别的专家概率分布跟踪
- 语义+轨迹双搜索:结合输入语义嵌入和专家轨迹的相似度搜索
- 动态预取阈值:根据搜索置信度动态调整预取策略
- 异步架构:解耦推理与预取操作
三、技术架构
整体框架
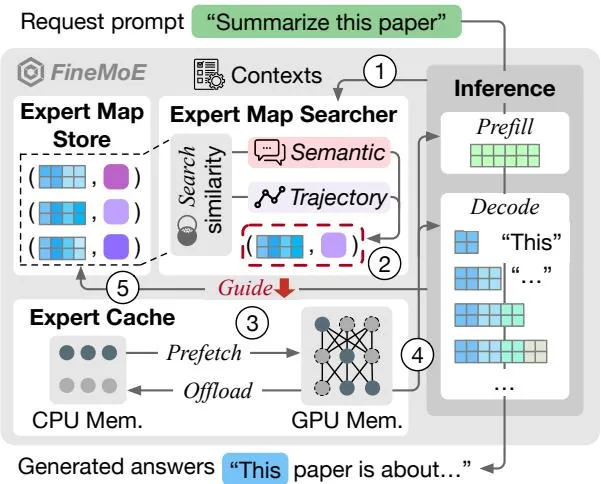
FineMoE包含三个核心组件:
| 组件 | 功能 | 实现 |
|---|---|---|
| Expert Map Store | 存储历史专家地图 | PyTorch + NumPy ndarray |
| Expert Map Searcher | 语义+轨迹相似度搜索 | PyTorch原生操作 |
| Expert Cache | GPU上的专家缓存 | C++ + CUDA Runtime API |
核心数据结构:Expert Map
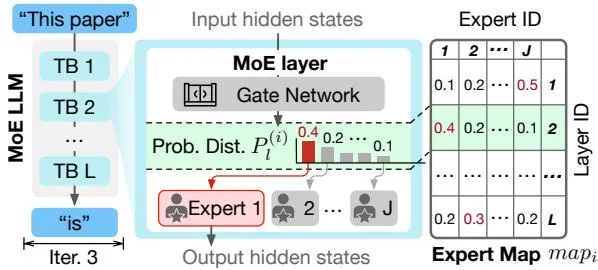
Expert Map记录迭代级别的专家概率分布:
关键优势:
- 细粒度:迭代级别而非请求级别跟踪
- 概率分布:不仅记录选择/未选择,还记录置信度
- 通用性:可通过top-K选择和聚合恢复粗粒度信息
粗粒度 vs 细粒度分析
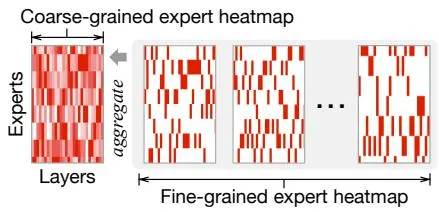
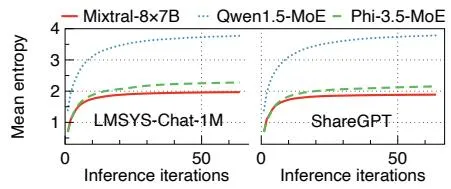
熵分析:
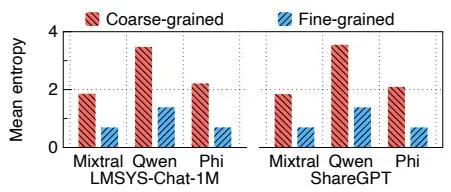
| 粒度 | Shannon熵 | 可预测性 |
|---|---|---|
| 粗粒度 (请求级) | 高 | 低 |
| 细粒度 (迭代级) | 低 | 高 |
关键发现:随着迭代进行,熵值逐渐增加并趋于稳定(约10次迭代后)。
专家地图搜索
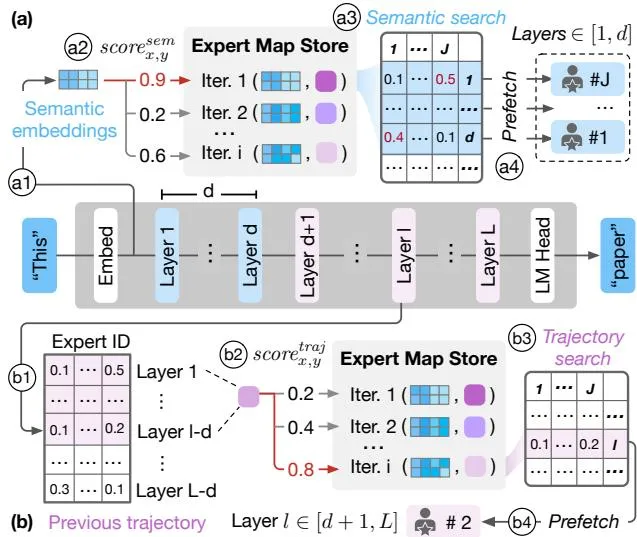
FineMoE采用双搜索策略:
1. 语义搜索 (层 ):
2. 轨迹搜索 (层 ):
相似度有效性验证:
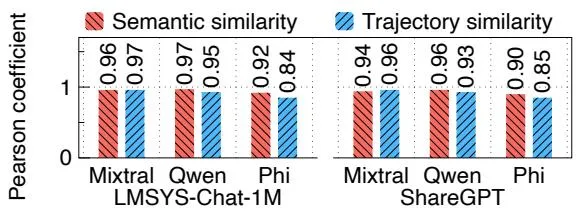
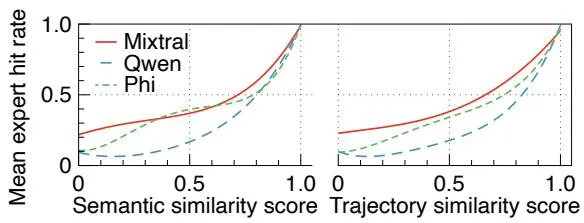
实验表明,语义和轨迹相似度分数与专家命中率呈强正相关。
动态预取策略
给定搜索到的专家地图 和相似度分数 ,FineMoE动态计算专家选择阈值:
预取集合优化:
直觉:
- 高置信度(高分数)→ 低阈值 → 预取更少专家 → 节省内存
- 低置信度(低分数)→ 高阈值 → 预取更多专家 → 降低误预测风险
专家缓存管理
预取优先级:
驱逐优先级(基于LFU):
冗余去重:
理论保证:保持至少 个专家地图可保证75%相似度下界;保持 个可保证98%相似度下界。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Expert Map | 迭代级专家概率分布跟踪 | 熵值比粗粒度低30%+ |
| 语义+轨迹双搜索 | 结合输入嵌入和专家轨迹 | 皮尔逊系数>0.8 |
| 动态预取阈值 | 根据搜索置信度调整 | 平均命中率提升39% |
| 异步Publisher-Subscriber | 解耦推理与预取 | 延迟开销<1% |
| 最小球覆盖去重 | 理论保证的地图多样性 | 75%-98%相似度下界 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 硬件 | 6× NVIDIA RTX 3090 (24GB), NVLink互联, PCIe 4.0 |
| 对比平台 | NVIDIA A100 (80GB HBM2e) |
| 模型 | Mixtral-8×7B, Qwen1.5-MoE, Phi-3.5-MoE |
| 数据集 | LMSYS-Chat-1M, ShareGPT |
| 基线 | MoE-Infinity, ProMoE, Mixtral-Offloading, DeepSpeed-Inference |
| 指标 | TTFT (首token延迟), TPOT (每token延迟), 专家命中率 |
离线服务性能
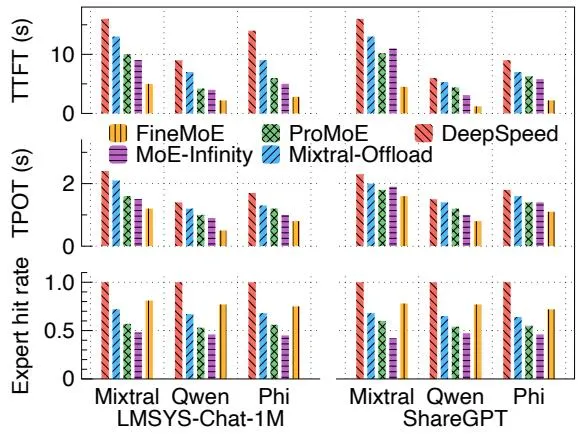
| 对比基线 | TTFT降低 | TPOT降低 |
|---|---|---|
| vs DeepSpeed-Inference | 74% | 46% |
| vs Mixtral-Offloading | 67% | 38% |
| vs ProMoE | 56% | 27% |
| vs MoE-Infinity | 53% | 22% |
专家命中率提升:
- vs Mixtral-Offloading: +14%
- vs ProMoE: +37%
- vs MoE-Infinity: +68%
在线服务性能
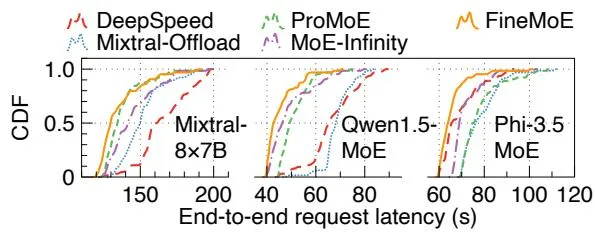
使用Azure推理trace(256个请求,2.91 req/s),FineMoE在端到端请求延迟上显著优于所有基线。
缓存限制下的性能
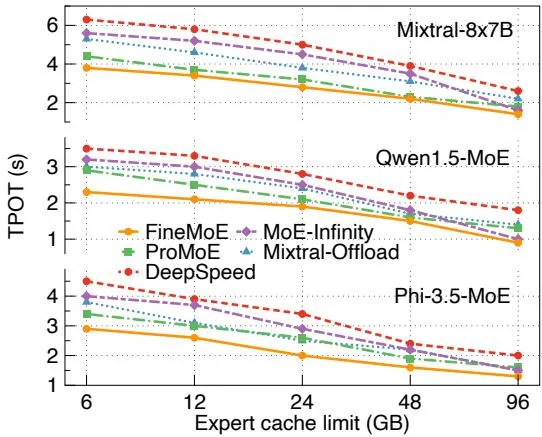
在6GB缓存限制下:
- vs DeepSpeed-Inference: TPOT降低36%
- vs Mixtral-Offloading: TPOT降低25%
- vs ProMoE: TPOT降低16%
- vs MoE-Infinity: TPOT降低29%
高端GPU性能
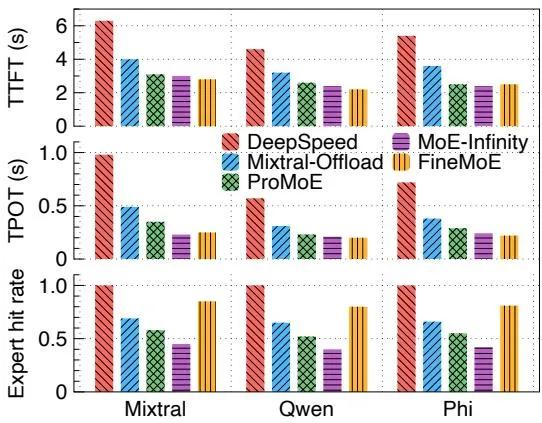
在A100测试平台上,FineMoE仍然一致优于所有基线,但性能差距缩小(高端GPU推理更快,卸载开销更低)。
消融实验
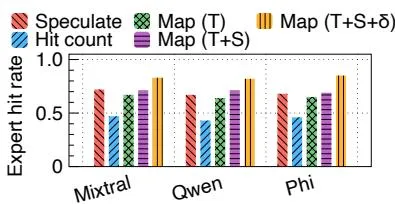
专家地图搜索有效性:
| 跟踪方法 | 说明 | 命中率 |
|---|---|---|
| Speculate | 投机预测(Mixtral-Offloading, ProMoE) | 中等 |
| Hit count | 请求级命中计数(MoE-Infinity) | 最低 |
| Map (T) | 仅轨迹相似度 | 较高 |
| Map (T+S) | 轨迹+语义,静态top-K | 高 |
| Map (T+S+δ) | 完整FineMoE | 最高 |
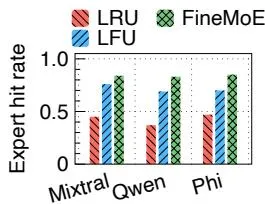
缓存策略有效性:LFU优于LRU,FineMoE的相似度感知缓存优于两者。
敏感度分析
预取距离:
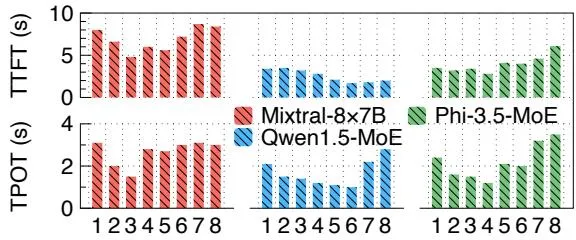
| 模型 | 最优预取距离 |
|---|---|
| Mixtral-8×7B | 3 |
| Qwen1.5-MoE | 6 |
| Phi-3.5-MoE | 4 |
Expert Map Store容量:
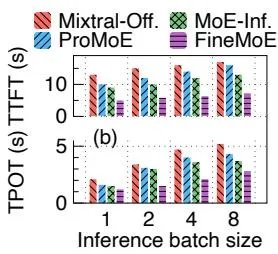
1K地图容量即可获得接近最优的相似度分数,进一步扩大收益递减。
批量大小:
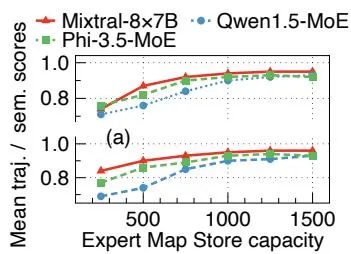
FineMoE在不同批量大小下均保持最低的TTFT和TPOT。
系统开销
延迟开销:
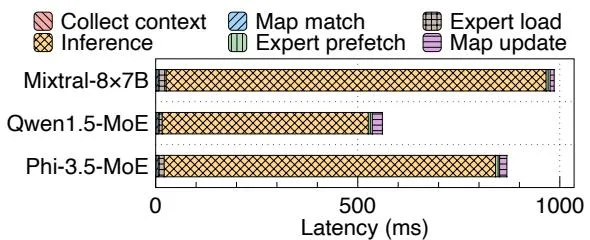
| 操作 | 开销 | 是否阻塞推理 |
|---|---|---|
| 上下文收集 | <50ms | 否 |
| 地图搜索 | 异步 | 否 |
| 专家预取 | 异步 | 否 |
| 地图更新 | 异步 | 否 |
| 总同步开销 | <1%迭代延迟 | - |
内存开销:
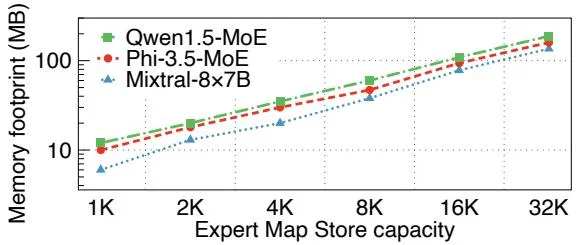
| 地图容量 | CPU内存占用 |
|---|---|
| 1K | <10MB |
| 32K | <200MB |
六、相关工作
| 方法 | 类型 | 特点 | 与FineMoE的区别 |
|---|---|---|---|
| DeepSpeed-Inference | 无损卸载 | 逐层参数卸载 | 无专家感知,无预取 |
| Mixtral-Offloading | 无损卸载 | LRU缓存+投机预测 | 粗粒度,同步预取 |
| MoE-Infinity | 无损卸载 | 请求级激活矩阵 | 粗粒度,低命中率 |
| ProMoE | 无损卸载 | 训练预测器 | 需要训练,层间开销大 |
| SwapMoE | 无损卸载 | 关键专家保持 | 工作负载自适应差 |
| Hobbit | 有损服务 | 混合精度专家 | 牺牲质量 |
| Samoyeds | 有损服务 | 稀疏张量核心 | 牺牲质量 |
| Pre-gated MoE | 重构 | 预门控函数 | 需要训练 |
七、总结
核心贡献
- Expert Map数据结构:首次提出迭代级别的专家概率分布跟踪方法
- 语义+轨迹双搜索:结合输入语义嵌入和专家轨迹的混合相似度搜索
- 动态预取策略:根据搜索置信度自适应调整专家预取数量
- 显著性能提升:延迟降低47%,专家命中率提升39%
技术影响
- 内存效率:显著降低MoE服务的GPU内存需求
- 推理速度:首token延迟降低53%-74%,每token延迟降低22%-46%
- 通用性:适用于Mixtral、Qwen、Phi等多种MoE架构
- 生产就绪:基于HuggingFace Transformers,开销可忽略
局限性
- 预取距离:需要根据具体模型调优
- 地图容量:虽然1K通常足够,但极端场景可能需要调整
- 负载均衡:主要针对top-K路由,对其他路由方案需要适配
- 硬件依赖:性能增益在高端GPU上相对较小
八、参考资源
- 论文:arXiv:2502.05370
- 会议:EuroSys ‘26
- 代码库:基于MoE-Infinity代码库
- 相关项目:MoE-Infinity, HuggingFace Transformers