WaferLLM: Large Language Model Inference at Wafer Scale
首个面向晶圆级加速器(Cerebras WSE-2,85 万核)的 LLM 推理系统。提出 PLMR 设备模型刻画晶圆级硬件特征,配合细粒度二维并行、Shift 式 KV 缓存管理,以及 PLMR 合规的 MeshGEMM(两跳传输)与 MeshGEMV(K-tree allreduce),相比多卡 A100 SGLang 端到端提速 10–20×、能效 2–2.5×。
WaferLLM:面向晶圆级加速器的大语言模型推理
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | WaferLLM: Large Language Model Inference at Wafer Scale |
| 作者 | Congjie He, Yeqi Huang, Pei Mu, Ziming Miao, Jilong Xue, Lingxiao Ma, Fan Yang, Luo Mai |
| 机构 | University of Edinburgh(爱丁堡大学)、Microsoft Research(微软研究院) |
| 论文 | https://arxiv.org/abs/2502.04563 (v3, 2025-05-30) |
| 代码 | https://github.com/MeshInfra/WaferLLM |
| 发表 | OSDI(Marco Canini 为 shepherd) |
| 硬件 | Cerebras WSE-2(85 万核,40GB 片上 SRAM,22 PB/s 内存带宽) |
一句话概括
新兴 AI 加速器(Cerebras WSE、Tesla Dojo)采用晶圆级(wafer-scale)制造,在一块网格(mesh)架构上集成数十万到百万个核心、数十 GB 分布式片上 SRAM、数十 PB/s 片上带宽。但现有 LLM 推理系统都是为 GPU 这类共享内存架构设计的,无法利用这种硬件。WaferLLM 是首个晶圆级 LLM 推理系统:先提出 PLMR 设备模型刻画晶圆级硬件的四大独特约束,再据此设计细粒度二维并行、Shift 式 KV 缓存管理,以及两个 PLMR 合规的分布式算子 MeshGEMM(两跳传输,临界路径 )与 MeshGEMV(K-tree allreduce)。在 WSE-2 上,相比多卡 A100 上最优的 SGLang,端到端提速 10–20×、能效高 2–2.5×;GEMV 相比单卡 A100 快 280–606×、能效高 7.5–16×。
二、核心思想
问题定义
在晶圆级加速器上跑 LLM 有两条朴素路线,都行不通:
- 把分布式片上内存抽象成共享内存(如 Ladder 等为 GPU 设计的 DNN 编译器):假设内存访问延迟均匀,无法容忍晶圆上跨核访问高达 1000× 的延迟差异;且只优化计算划分、忽视数据划分,容易造成数据重复、突破每核内存上限。
- 显式划分计算 + 消息传递(如为 GraphCore IPU 设计的 SOTA 编译器 T10):T10 假设片上 crossbar 提供恒定的跨核访问延迟,但晶圆是 mesh 拓扑、延迟随跳数剧变;且 T10 只能扩展到数千核,扩不到百万核。
解决方案概述
WaferLLM 的三个层次:
- PLMR 设备模型:用四个字母 P、L、M、R 概括晶圆级硬件的根本约束,作为所有设计的”合规性标尺”。
- 晶圆级 LLM 并行:针对 prefill / decode / KV 缓存分别设计满足 PLMR 的并行方案(细粒度二维划分、细粒度复制、Shift 式 KV 缓存)。
- 晶圆级算子 MeshGEMM / MeshGEMV:首个能在百万核 mesh 上高效扩展的分布式 GEMM 与 GEMV,是 prefill(GEMM 主导)与 decode(GEMV 主导)的性能基石。
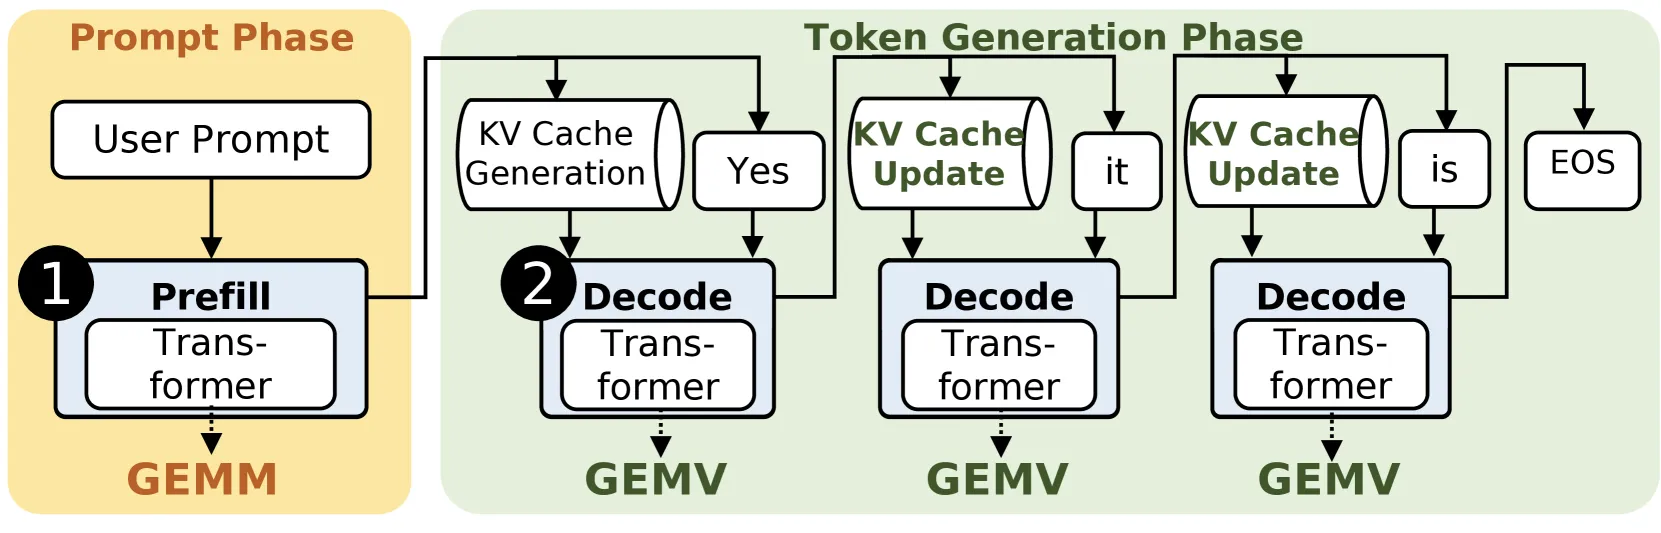
三、PLMR 设备模型
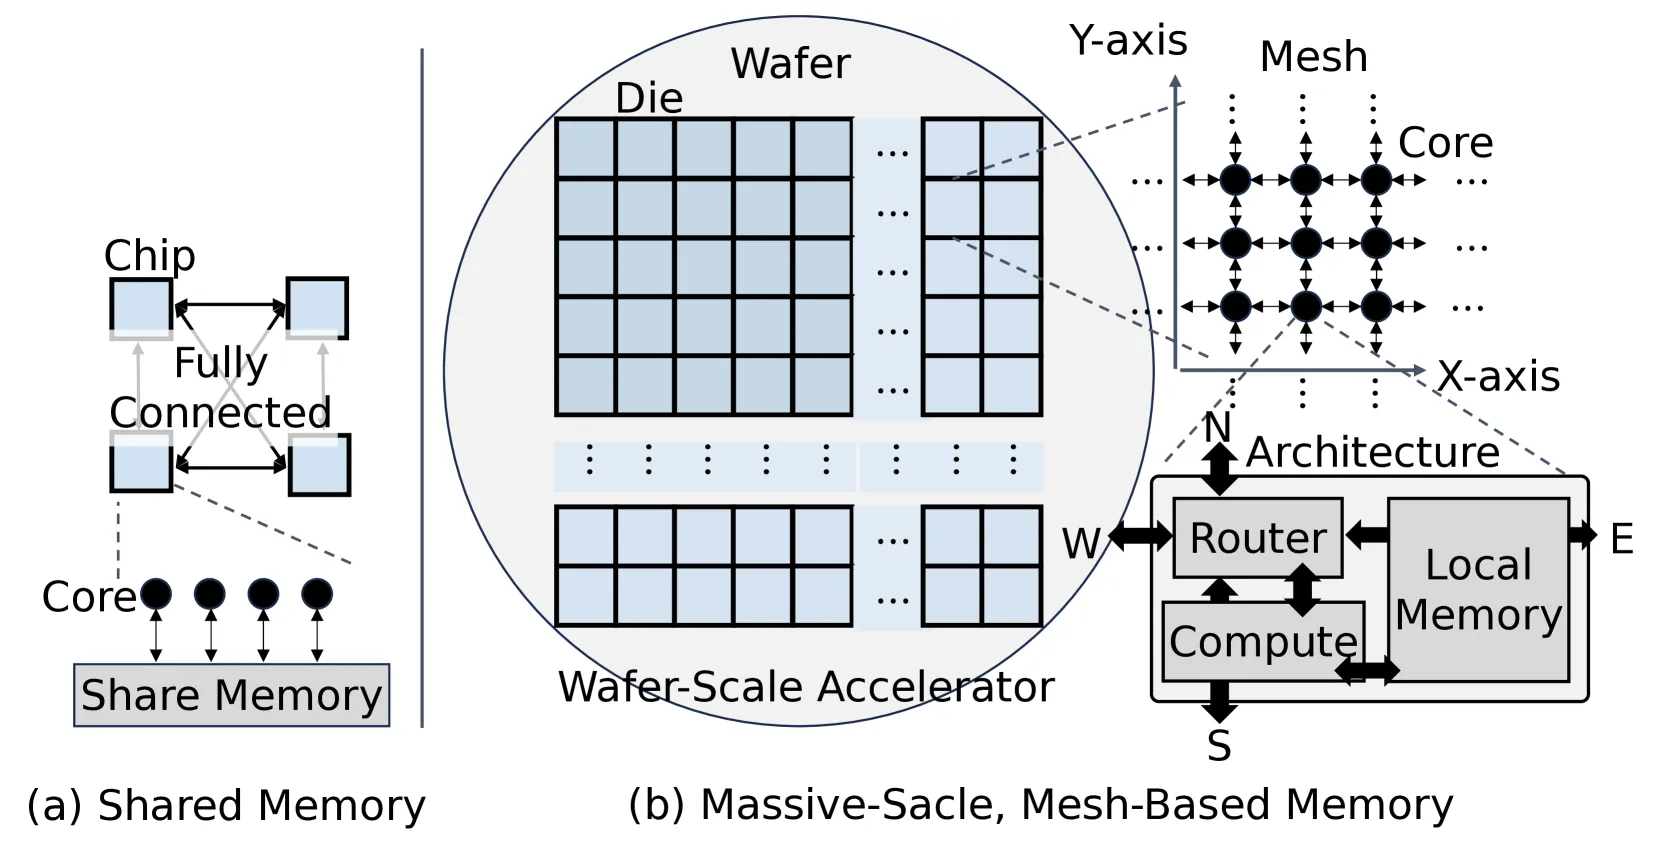
PLMR(读作 “Plummer”)刻画晶圆级加速器的四个独特属性:
| 属性 | 名称 | 含义与量化 |
|---|---|---|
| P | Massive Parallelism(海量并行) | 单晶圆容纳数百万核(GPU 仅数千)。每核有本地硬件流水线,在周期级重叠数据进出、计算、访存。要求把计算切到极细粒度并精细调度以重叠三者。 |
| L | 非均匀访存 Latency | mesh 上 核,两核间最大跳数为 ;最坏访存延迟 。 为每跳转发延迟(路由器硬件按预设规则转发), 为每路由延迟(软件解析/重写报文头),通常 , 为路径上的路由级数。百万核下跳数/路由可达数千 → 本地与远程访存延迟差约 1000×。必须最小化长程通信。 |
| M | 受限每核 Memory | 每核本地内存仅几十 KB 到几 MB(容量越大能效越差)。计算数据须显式切成细粒度块以塞进每核。 |
| R | 受限 Routing 资源 | 每核路由电路/路由表严格受限。WSE-2 上每核只能识别 5-bit 地址码的报文头 → 每核至多 条不同路由路径。远程直连需消耗路由资源(仅 延迟);若路径数超限,则需经中间核多跳中继,引入额外 延迟。 |
PLMR 不仅适用于当前的 Cerebras WSE,也适用于未来的 Tesla Dojo;连非晶圆级但采用 mesh NoC 的设备(如 Tenstorrent Blackhole)都能用调整参数后的 PLMR 表示。
为何现有系统失败(用 PLMR 一一对照):
- 共享内存系统(Ladder):假设均匀访存 → 违反 L;重计算划分轻数据划分 → 数据重复违反 M;不感知通信距离 → 违反 R。
- 分布式内存系统(T10):为 crossbar 恒定延迟设计,不感知 mesh 变化的跳距 → 违反 L;只能扩到数千核 → 违反 P。(T10 已考虑 M 与 R。)
四、晶圆级 LLM 并行
4.1 Prefill 并行
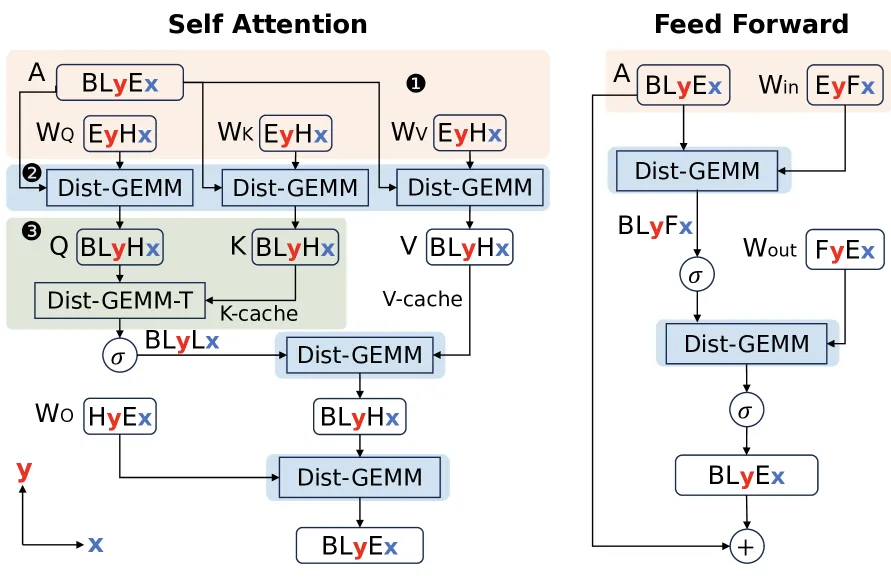
Prefill 阶段矩阵大,主要挑战:如何在两个维度上切分实现百万核并行(P)、如何优化 GEMM 以最小化长程通信(L)并守住 M/R、如何避免昂贵的矩阵转置(L)。
- 细粒度二维划分实现百万核并行:把输入激活 与权重 同时沿核阵列的 X 轴与 Y 轴划分。记号 表示形状为 的矩阵中 维沿 X 轴切、 维沿 Y 轴切。激活 的布局为 ( 序列维沿 Y、 嵌入维沿 X),所有权重矩阵()也在两维上切分。相比只切嵌入维的传统方法,这带来百万级并行。
- PLMR 合规的分布式 GEMM:用 §五的 MeshGEMM 替代 GPU/TPU 惯用的 allgather-based GEMM,在高 NoC 带宽利用率下同时守住 L/M/R。
- 转置无关(transpose-free)方案:矩阵转置在 mesh 上极贵(需把一角的核数据送到对角另一角,制造长程路径)。用**转置分布式 GEMM(dist-GEMM-T)**直接算 ,避免显式转置 。
4.2 Decode 并行
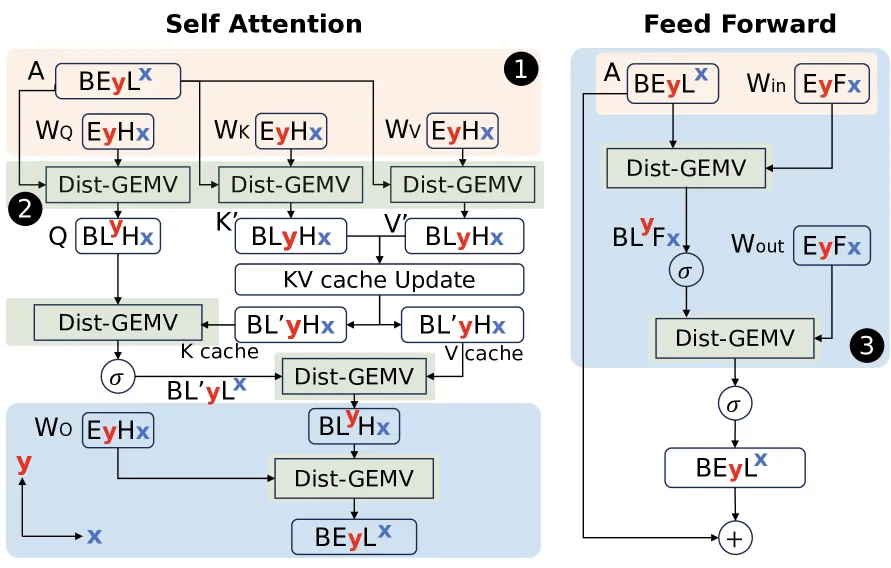
Decode 是访存带宽密集型,矩阵更小、以 GEMV 为主、计算短难以掩盖通信,挑战更大。
- 细粒度复制(fine-grained replication)以最小通信代价获取并行:当张量维度不足以支撑高并行时,复制序列维(decode 时序列长度为 1)。布局记为 : 维沿 Y 轴切分、 维沿 X 轴复制。好处:(i) 提升并行度并均衡各核负载;(ii) 避免跨全核的额外 allreduce 通信。与近期长上下文系统在 prefill 阶段选择性复制不同,WaferLLM 是在 decode 阶段复制。
- PLMR 合规的分布式 GEMV:用 §六的 MeshGEMV,解决现有 GEMV 长程通信与路由资源过度消耗问题。
- 预优化权重布局避免转置:为 decode 的 dist-GEMV 预先重排 、 等权重布局(与 prefill 不同),消除 token 生成时的转置。虽引入 prefill→decode 的一次性重排开销,但远小于逐步转置的代价。
4.3 Shift 式 KV 缓存管理
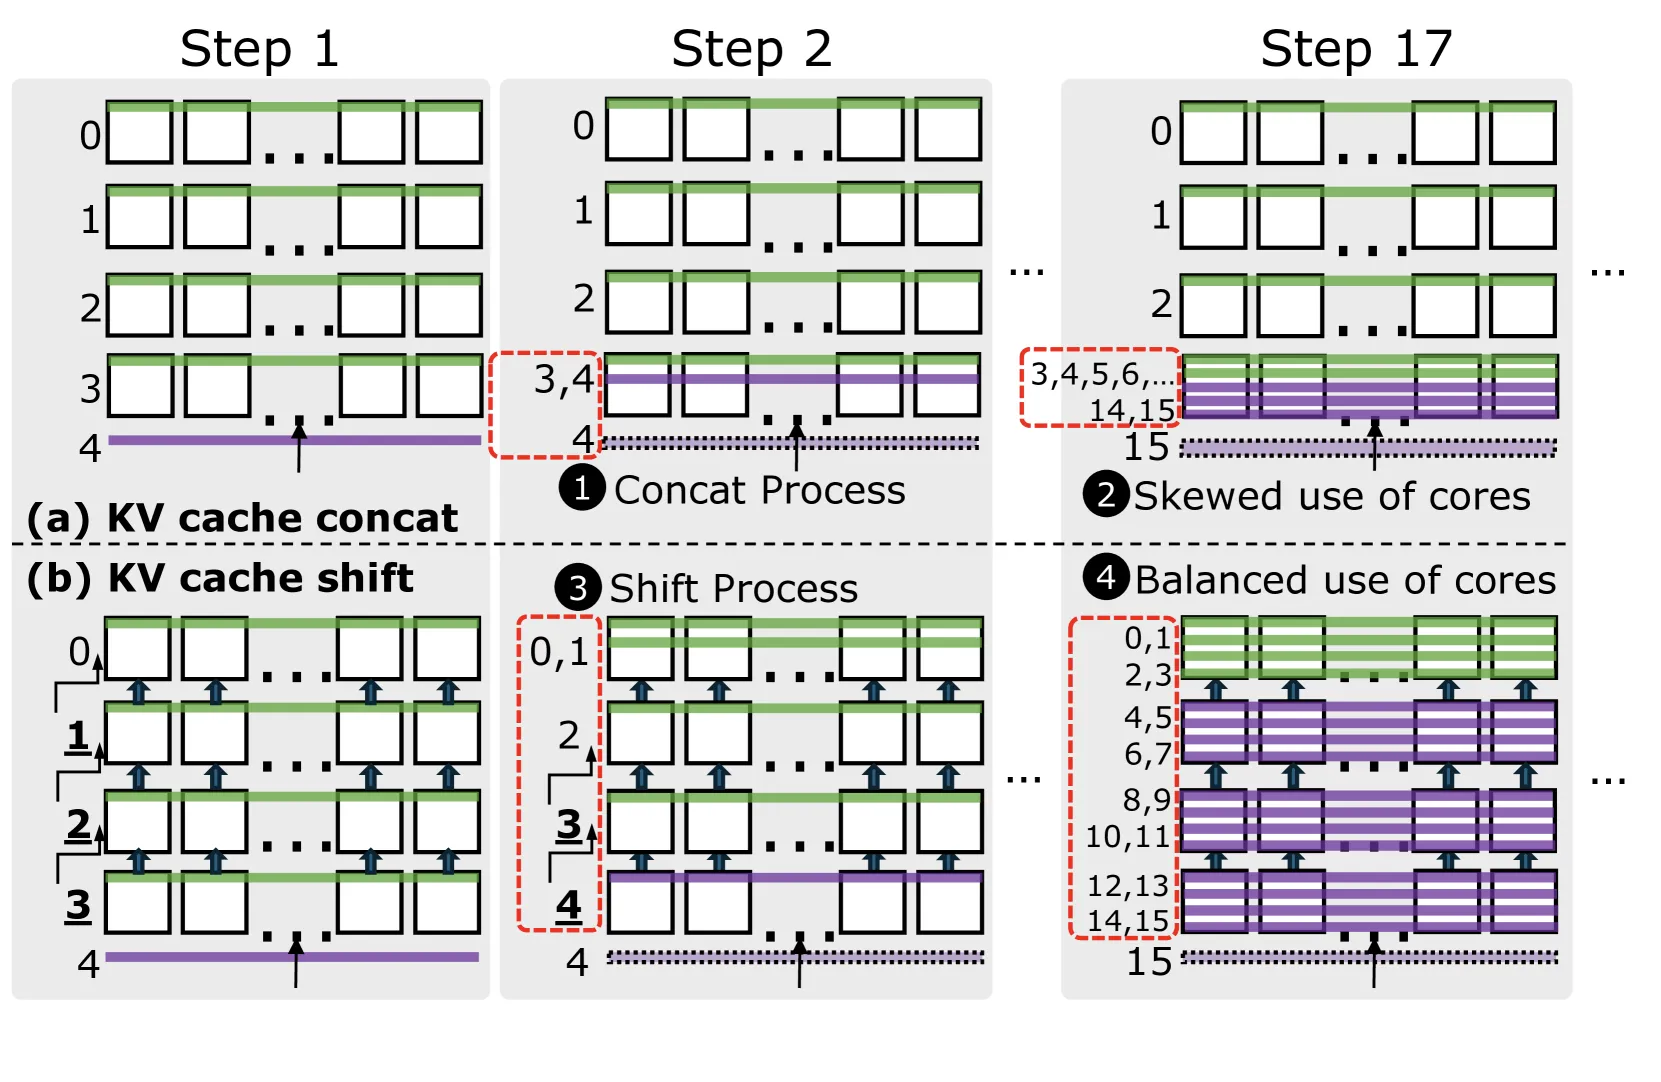
- 传统 concat 式导致核利用倾斜:现有方法把新生成的 KV 向量拼接到已有缓存末尾。在 mesh 上,只有某一行中的某个核负责存储/计算新 KV,几步之后该核迅速成为瓶颈 → 内存倾斜(违反 M)+ 并行低效(违反 P)。
- Shift 式管理实现均衡:不在末尾拼接,而是执行均衡上移(upward shift)——每行把最老的 KV 数据传给上一行。新 KV 到达时,每核比较自身与邻居容量,若相等则触发上移:每行从下方接收、向上方传出,最终 KV 均匀分布在所有核。上移沿 NoC 链路并行进行(满足 P),且物理布局与逻辑连续性对齐、只在相邻核间搬移(满足 L),彻底解决 concat 式最后一行核的 M 违规。
4.4 实现细节
- Prefill↔Decode 切换:两阶段策略不同,通过高速 NoC(常达数百 Pbit/s 聚合带宽)重排 KV 缓存与权重,瞬时完成、无需慢速片外内存。
- 并行配置:离线 autotuning 按模型大小、输入/输出长度、每核内存、阶段(prefill/decode)挑选各阶段核数,借高 NoC 带宽做快速动态重映射。
- 自注意力变体:支持 GQA、MHA、MQA,均通过按 head 维分组后本地执行 dist-GEMM/GEMV/GEMM-T 实现。
五、晶圆级 GEMM:MeshGEMM
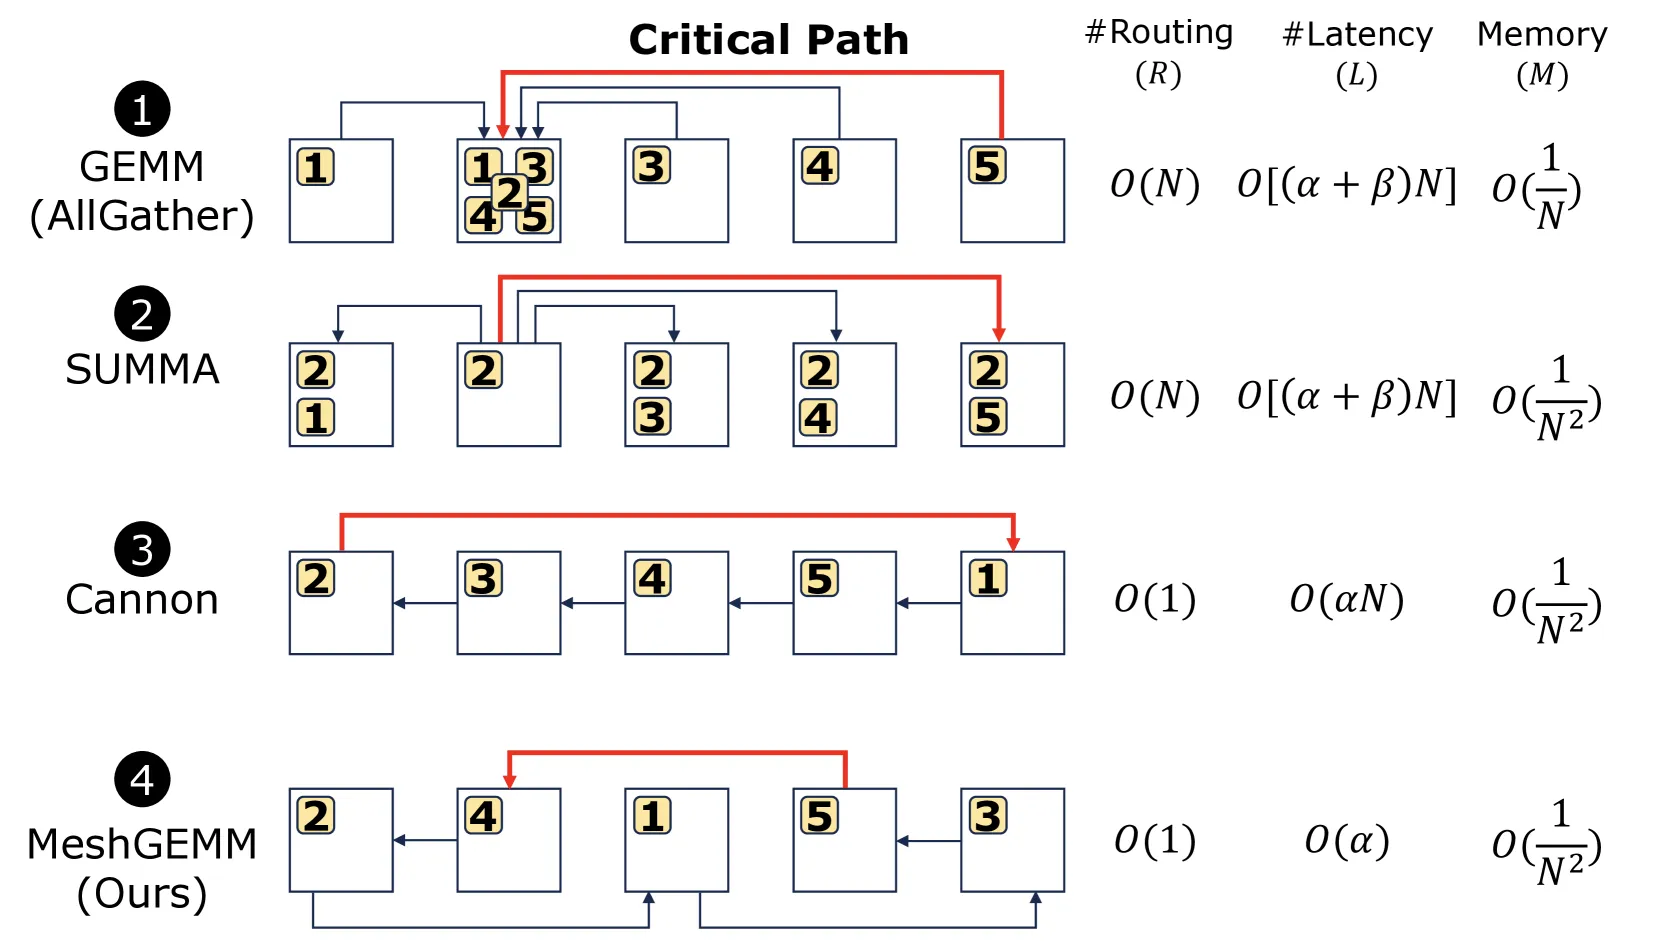
5.1 PLMR 合规性对比
三个评价指标:每核路由路径数(越少越合 R)、临界路径延迟(越小越合 L)、每核内存(越低越合 M)。
| 方法 | 每核路由路径 | 临界路径延迟 | 每核内存 | 合规性 |
|---|---|---|---|---|
| Allgather(GPU/TPU 常用) | (违反 R) | (违反 L) | (膨胀缓冲,违反 M) | ✗ L/M/R |
| SUMMA(Cerebras 默认) | (违反 R) | (违反 L) | 峰值内存翻倍 | ✗ L/R |
| Cannon(超算 mesh 优化) | (跨 N 跳,违反 L) | (最优) | ✗ L | |
| MeshGEMM(本文) | (恒定两跳) | (最优) | ✓ 全合规 |
MeshGEMM 的临界路径是两跳传输(two-hop transmission):每核与两个”隔一跳”的邻居通信、经过一跳邻居中继。既有 Cannon 的 路由与 内存优势,又把临界路径恒定压到 2 跳、,唯一满足 L 属性。
5.2 设计直觉与可扩展性
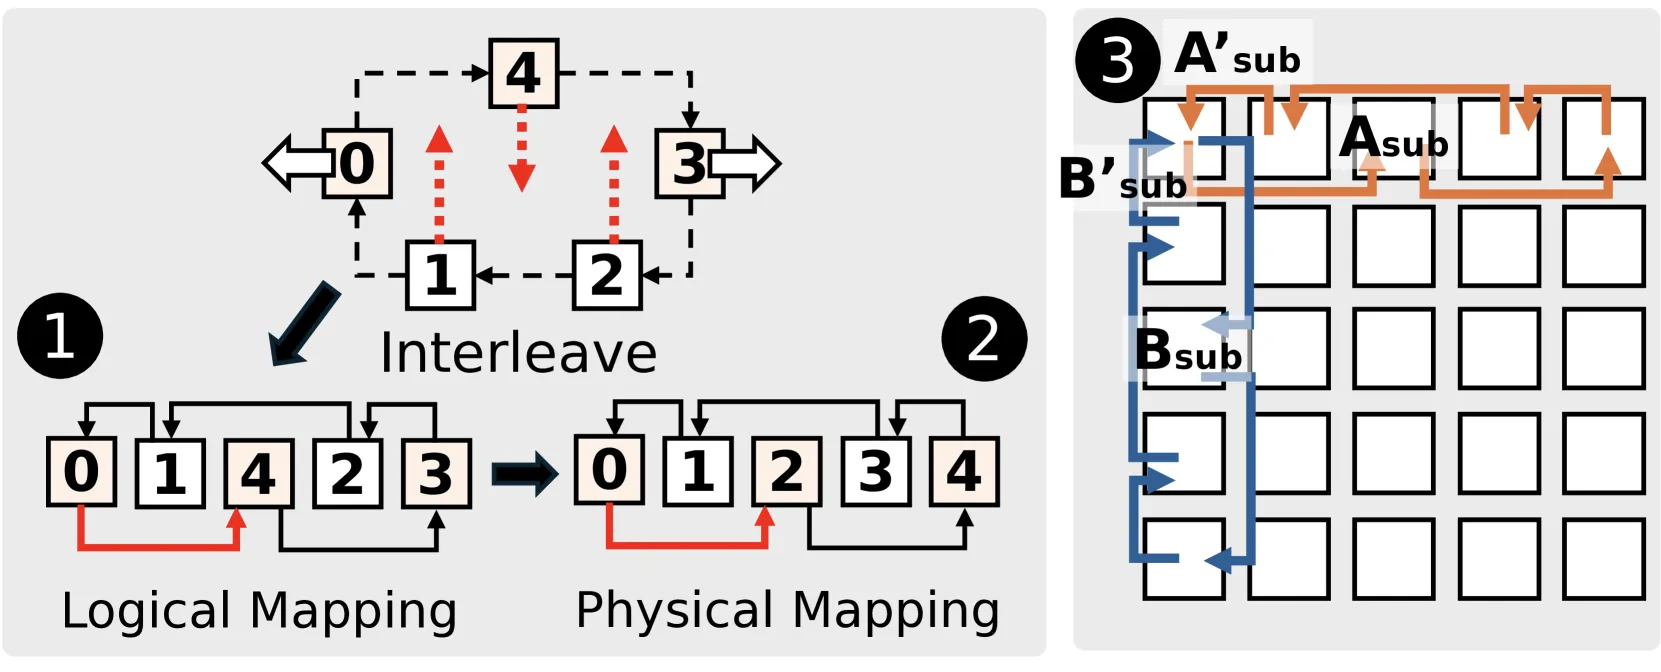
两个阶段:
- 循环移位(Cyclic shifting):类似 Cannon 保证 GEMM 正确性,把通信限制在两个邻居、最小化内存 → 满足 M 与 R。逻辑上把 N 个核排成一个环,展平成物理通信映射(临界路径从头核到尾核)。
- 交织(Interleaving):用 INTERLEAVE 算法(Algorithm 1) 求逻辑→物理的映射,把临界路径长度进一步压到常数(满足 L)。核心规则(对索引 index,共 N 核):
if index 为偶: recv = max(index-2, 0);   send = min(index+2, N-1)
else:          recv = min(index+2, N-1); send = max(index-2, 0)
边界修正: index==0 → recv=1; index==N-1 → (N偶) recv=N-2 else send=N-2
例:N=5 时物理核 2 发给核 4、从核 0 收。对任意 都能生成两跳通信模式。
- 可扩展性证明:INTERLEAVE 产生的两跳距离不可再减——若想构造每个数与邻居恰好差一跳的环形序列,在数学上不可能(首尾端点无法同时与邻居保持单跳差还构成环)。1D 结论借 X/Y 轴对称性自然推广到 2D mesh。
5.3 MeshGEMM 算法
对 :
- 初始化:把 、 沿两维切成 块分布到各核,每核各持一块 、;用 INTERLEAVE 初始化各核邻居位置。
- 对齐(Alignment):各核与邻居对齐输入子矩阵,使每核以正确操作数开始。
- 计算-移位循环:N 步,每步各核算 ,同时沿 X 轴移 、沿 Y 轴移 。N 步后返回累加的 。
实现细节:非方形 mesh()可逻辑划分为 (最小公倍数)。转置 GEMM(,即 dist-GEMM-T)无需对齐,只需对右矩阵 沿 Y 轴做 N 步两跳计算-移位,每步后沿 X 轴 ReduceAdd。
六、晶圆级 GEMV:MeshGEMV
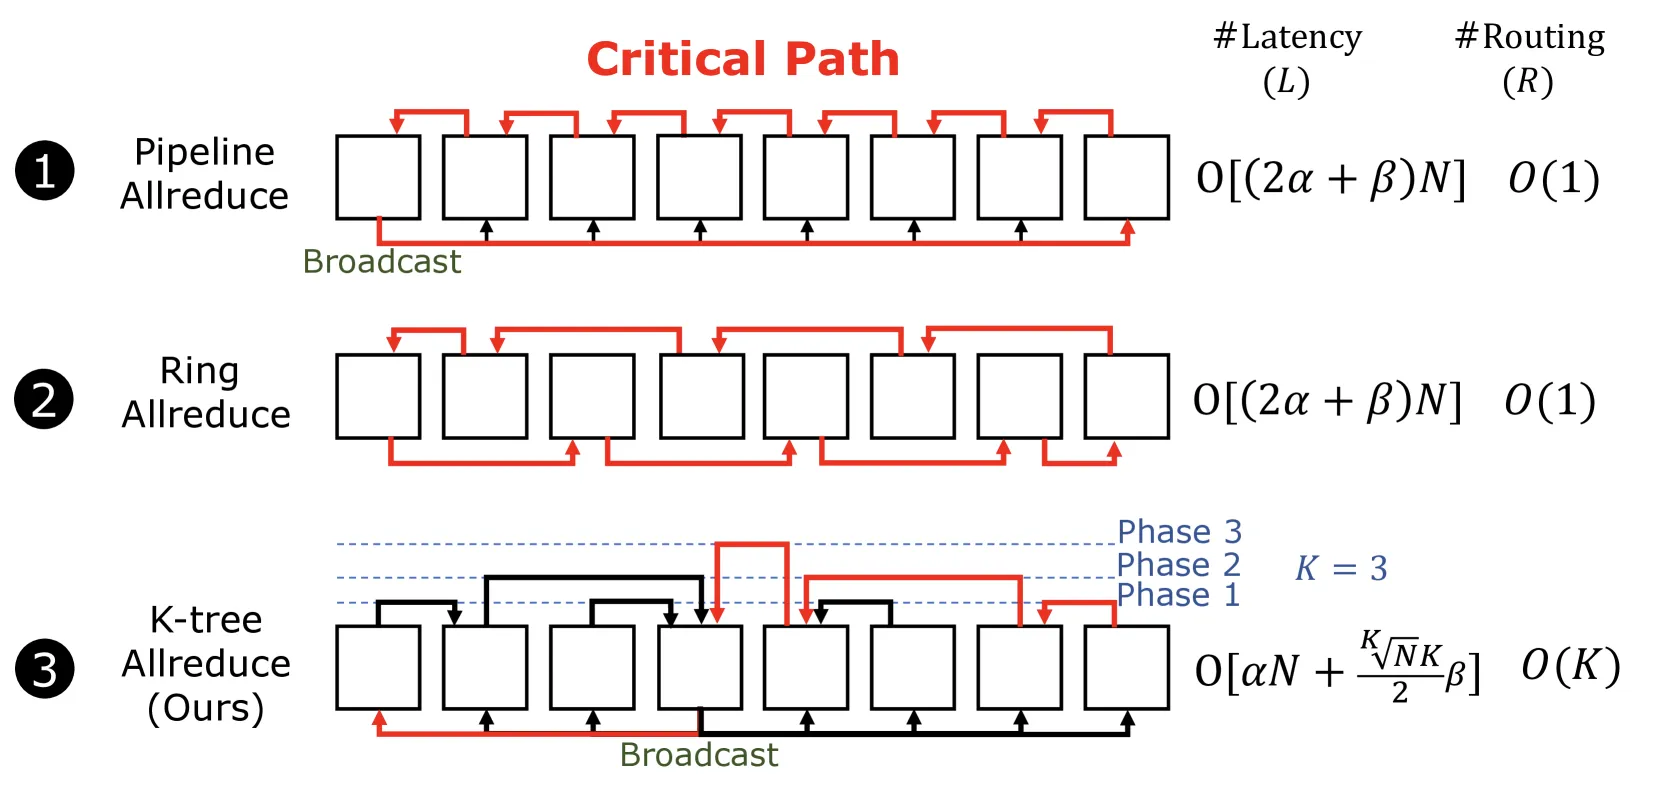
分布式 GEMV 完成时间主要取决于各核逐元素算部分和 + 一次 allreduce 聚合再回传。指标同 GEMM:每核路由路径数、整个 allreduce 的临界路径延迟。
| 方法 | 每核路由路径 | 临界路径 | 合规性 |
|---|---|---|---|
| Pipeline allreduce(TPU pod / Cerebras demo 默认) | 跳、N 个路由级(违反 L) | ✗ L | |
| Ring allreduce(GPU pod 默认,大数据量) | (违反 L) | ✗ L | |
| K-tree allreduce(本文) | 仅 个路由级、N 跳 | ✓(选合适 K) |
K-tree allreduce 把 reduce-add 路径组织成平衡 K 叉树:K 个阶段分组并行归约,每组 核,临界路径路由级从 N 降到 。代价是每核需 路由路径(树根核需 条)。本质是用路由资源换取远距核间的直通路径,减少路由延迟。
MeshGEMV 算法:初始化时把 切成 块、(向量)沿一轴切成 N 块并在另一轴复制;按 K-tree 确定各阶段分组。→ 各核本地 GEMV 得部分和 → K 阶段树形归约(第 k 阶段把 k-1 阶段结果归约到本阶段各组根核,K 次后拼接得 )→ 可选广播。
K 的选择:K 越大并非越好,受 N 与 R 约束影响,且增大路由复杂度。本文实现选 K=2。
七、实验结果
硬件:Cerebras WSE-2(85 万核 @1.1GHz,每核 48KB SRAM、单周期 MAC、单周期收发 32-bit 消息,全片 40GB SRAM)。GPU 对比用 A100(同 7nm 工艺,公平对比),最多 16 卡(2×8,节点内 NVLink、节点间 InfiniBand),推理系统用 SGLang。 基线编译器:T10(分布式片上内存 SOTA,为其在 WSE-2 上实现)、Ladder(共享内存 SOTA)。 指标:Throughput per Request(TPR)= 1/TPOT。 模型:LLaMA3-8B(GQA)、LLaMA2-13B(去掉 4K 限制)、CodeLLaMA-34B、QWen2-72B(后两者超单片内存,取层子集按比例外推)。
7.1 端到端 LLM 推理(Table 2)
以 TPR 计(越高越好),LLaMA3-8B 在 2048/2048 场景:WaferLLM 2370 vs T10 58.3 vs Ladder 7.4 vs A100 8卡 128.4。
- 相比 T10:prefill 平均 160×(最高 178×)、decode 平均 5.7×(最高 6.5×)。decode 增益小是因为 GEMV allreduce 对访问顺序无严格要求,T10 的分布式内存假设尚能获益。
- 相比 Ladder:prefill 平均 270–450×、decode 平均 217×(最高 260×)。Ladder 纯共享内存设计,通信开销惨重。
- 相比 SGLang+A100:8B–72B 全面领先。T10/Ladder 甚至比单卡 A100 还慢,凸显不遵守 PLMR 会让晶圆算力白白浪费甚至倒退。
- 可扩展性:WaferLLM 随核数增长而提速(QWen2-72B 从 480² 到 720² 核提速 1.6×),而 T10/Ladder 吞吐反而下降。
7.2 MeshGEMM(Figure 9)
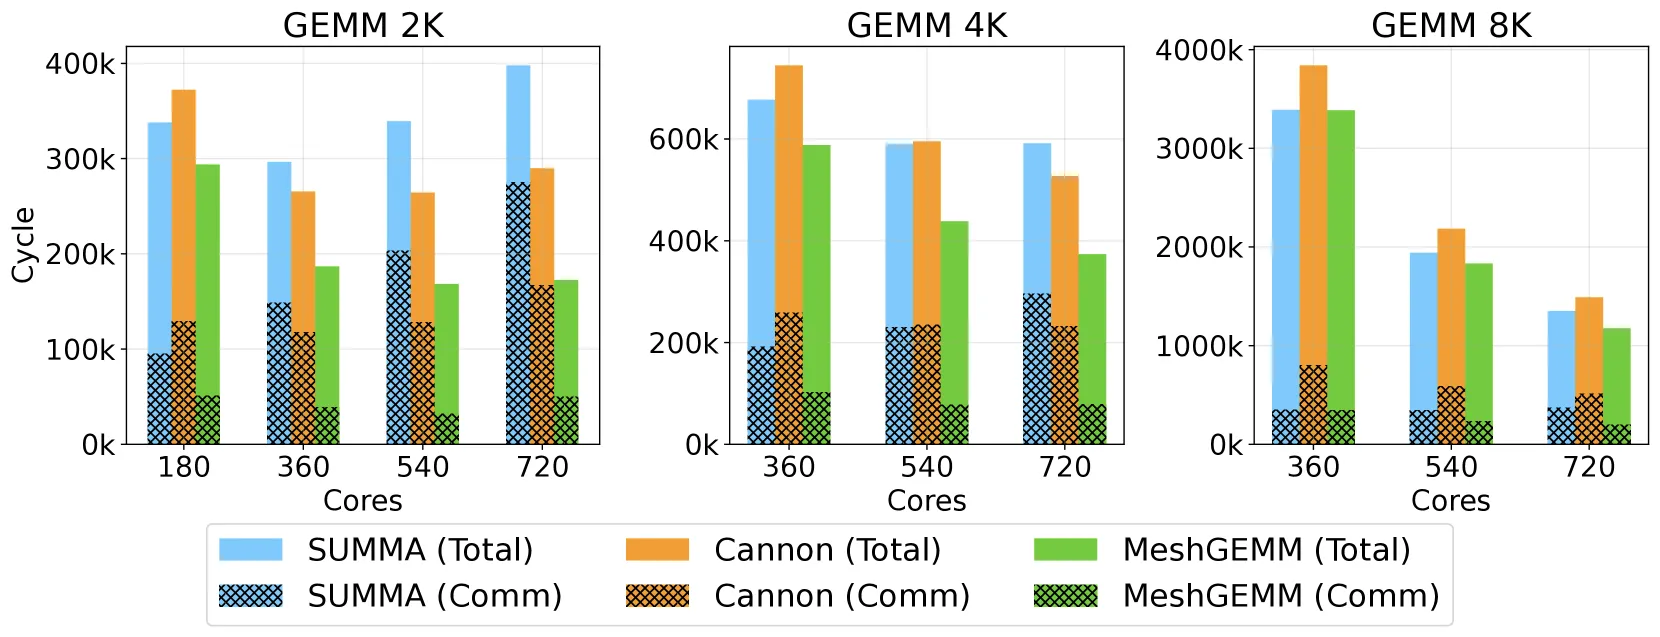
- 各尺寸矩阵下 MeshGEMM 延迟均最低,接近硬件上限仍保持 >70% 计算效率;SUMMA/Cannon 在 720² 核跌破 50%。
- INTERLEAVE 把每步通信开销压成与核数无关的常数(总开销只随步数增),故大规模细粒度并行下计算-通信重叠更好。大矩阵下总周期比 SUMMA/Cannon 少约 17%。
7.3 MeshGEMV(Figure 10)
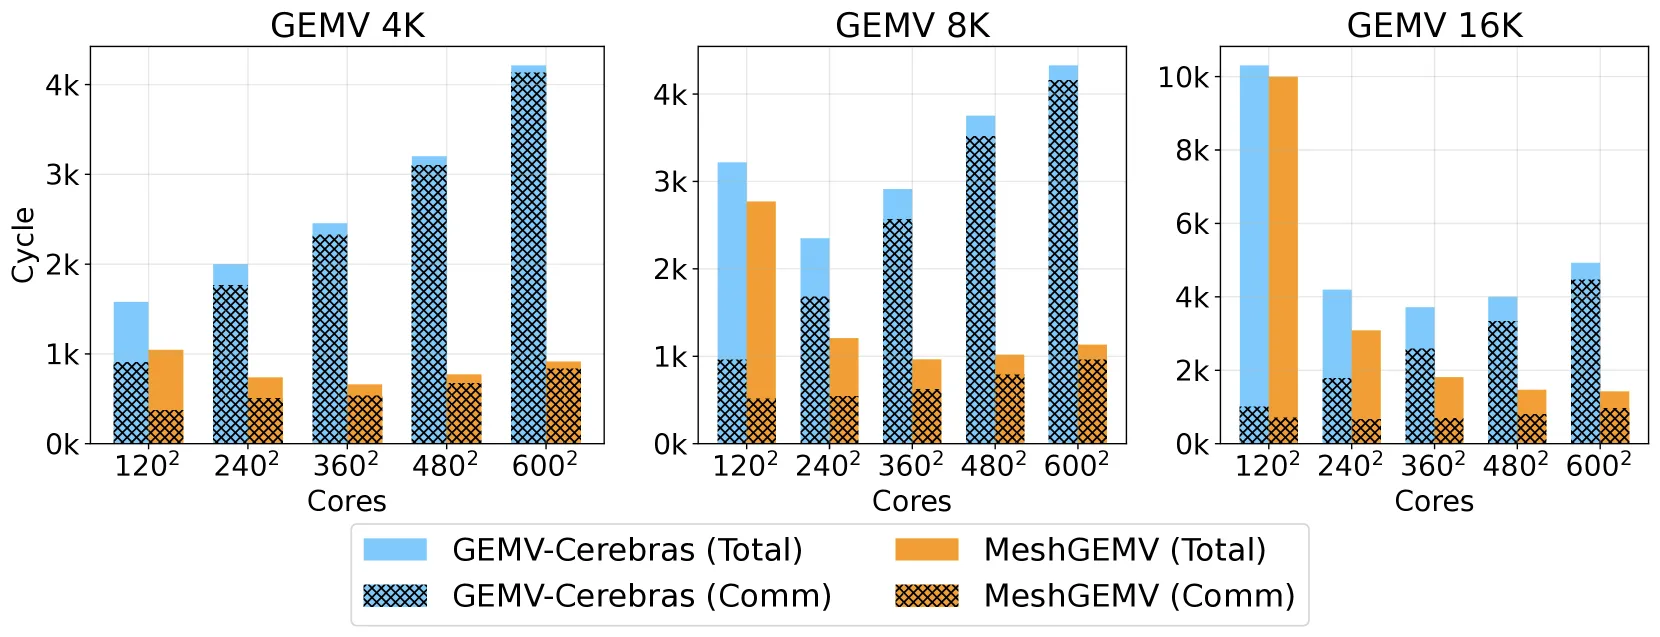
- 大规模下通信可占总开销 90%。MeshGEMV 靠 K-tree allreduce 最大化并行,端到端比 Cerebras 默认 GEMV 快约 4.6×,且通信开销随核数增长更慢、拐点更晚。
7.4 Shift 式 KV 缓存(Table 5)
最大 decode 输出长度:
| 模型 | Concat(PagedAttention) | Shift(WaferLLM) | 倍数 |
|---|---|---|---|
| LLaMA3-8B | 382 | 137548 | 360× |
| LLaMA2-13B | 16 | 6168 | 385× |
均衡核利用直接解决 concat 式的倾斜问题,token 容量提升 360–385×。
7.5 与 GPU 对比(Table 6/7/8)
- GEMV:相比单卡 A100 快 280–606×、能效高 7.5–16×;相比最优 GPU 集群性能高 166–210×、能效高 45–70×。多卡 A100 从 1→8 卡仅提升 1.32×、16 卡还退化(NVLink/IB 通信瓶颈)。
- 端到端:相比 A100 集群 TPR 高 6–20×(输出越长、模型越大差距越明显)。SGLang 从 1→8 卡 prefill 仅 1.2–1.6×、decode 3.3–3.6×,16 卡因跨节点通信退化。
- 能效:WSE-2 芯片面积是 A100 的 47×、功耗与成本 37×,但在 SGLang 最优多卡结果下 WaferLLM 仍能效高 2–2.5×(源于 GPU 在 decode 上的非线性扩展劣势),对 test-time scaling 等长输出场景尤为宝贵。
- 理论差距:MeshGEMV 未达理论 7000× 提升,因 WSE-2 二代核不能完全重叠访存与计算、边缘核利用不足、NoC 长程通信开销仍存。
八、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| PLMR 设备模型 | 用 P/L/M/R 四属性刻画晶圆级硬件根本约束,作为合规标尺 | 解释所有现有系统为何失败;泛化到 Dojo、Tenstorrent |
| 细粒度二维并行 | prefill 双轴切分 + decode 细粒度复制 | 实现百万核并行(P),均衡负载、避免 allreduce |
| Shift 式 KV 缓存 | 均衡上移替代末尾拼接,KV 均匀分布 | token 容量 360–385×(Table 5) |
| MeshGEMM(两跳传输) | 循环移位 + INTERLEAVE,临界路径恒定 2 跳 、 路由、 内存 | 唯一全合规 GEMM;>70% 效率,比 SUMMA/Cannon 少 17% 周期 |
| MeshGEMV(K-tree allreduce) | 平衡 K 叉树归约,临界路径路由级 ,K=2 | 比 Cerebras 默认 GEMV 快 4.6× |
| 转置无关设计 | dist-GEMM-T + decode 预排权重布局 | 避免 mesh 上极贵的对角长程转置 |
九、相关工作
- DL 框架/编译器(PyTorch/TF/XLA/Ladder、vLLM/TensorRT-LLM):为共享内存的 “load-compute-store” 设计,忽视 PLMR 特征。
- 分布式 GPU/TPU 系统:为数千节点的 pod 设计,路由器更强、无本地内存约束,与 PLMR 不符;与本文的片上扩展互补。
- 脉动阵列(Trainium、TPU):聚焦小核内部设计(数百 PE),非 PLMR 设备;可作为 WSE 核内 GEMM 加速器互补。
- 数据流架构(TENET、DISTAL、SambaNova):考虑跨核连接但都未扩展到晶圆级。
- 晶圆级 allreduce:已有工作只做单一 allreduce,无法像 WaferLLM 那样完整并行化 GEMV / 支撑全 LLM 推理,且是本文 K-tree allreduce 的一个特例。
十、总结
核心贡献
- PLMR 设备模型:首次系统化刻画晶圆级加速器的四大硬件约束,作为设计与分析工具。
- 首个晶圆级 LLM 并行方案:细粒度二维并行 + 细粒度复制 + Shift 式 KV 缓存。
- 可扩展的 MeshGEMM 与 MeshGEMV:首个在百万核 mesh 上高效扩展的 GEMM/GEMV。
- 数量级的性能与能效提升:相比多卡 A100 SGLang 端到端提速 10–20×、能效 2–2.5×。
关键数据
| 指标 | 结果 |
|---|---|
| 端到端 vs 多卡 A100 SGLang | 10–20×(最高 30–40× vs 单卡) |
| prefill vs T10 / Ladder | 160× / 270–450× |
| decode vs T10 / Ladder | 5.7× / 217× |
| GEMV vs 单卡 A100 | 606× 速度、16× 能效 |
| KV 缓存 token 容量 vs PagedAttention | 360–385× |
| MeshGEMM vs SUMMA/Cannon | 少 17% 周期,>70% 效率 |
| 端到端能效 vs 最优多卡 A100 | 2–2.5× |
局限与未来方向
- 单片内存受限:WSE-2 每核仅 48KB SRAM,迫使用流水线并行(而非纯张量并行),造成最多 5× 利用率损失;WSE-3 与 Dojo(1MB/核)正朝增大本地内存方向发展。
- decode 能效优势小于 GEMV:受 GPU 优化的窄层 LLaMA 结构限制。
- 未达理论上限:二代核访存/计算重叠不足、边缘核利用不足、长程通信仍有残留开销。
- 可靠性:WSE-2/3 由硬件容错,仅暴露健康核,出厂即含冗余核/链路并运行时动态重映射;报告 93% 可用晶圆面积(高于 GPU 的 70–80%)。
- MoE 与更多架构:MeshGEMM/GEMV/Shift-KV 同样适用 MoE,attention 与专家层间的 all-to-all 用 NoC 多播实现,稀疏优化列为未来工作。
技术影响
WaferLLM 论证了:只要严格遵守 PLMR,晶圆级架构能在 LLM 推理 TPR 与能效上比 GPU 系统高数量级——关键在于把大部分权重映射到低延迟 NoC 的片上内存,逼近理想的 1:1 内存-计算比(A100 FP16 仅 1:312)。这为可持续的 AI 推理开辟了新的硬件路径。
十一、参考资源
- 论文:https://arxiv.org/abs/2502.04563
- PDF:https://arxiv.org/pdf/2502.04563
- 代码:https://github.com/MeshInfra/WaferLLM
- 硬件:Cerebras WSE-2 / WSE-3、Tesla Dojo、Tenstorrent
- 相关:T10(GraphCore IPU 编译器)、Ladder、SUMMA、Cannon、SGLang、PagedAttention
附录:论文图表索引
| 图 | 文件 | 说明 |
|---|---|---|
| Figure 1 | llm-inference-components.png | LLM 推理关键组件 |
| Figure 2 | mesh-memory-architecture.png | 大规模 mesh 内存架构 |
| Figure 3 | prefill-parallelism.png | Prefill 并行方案() |
| Figure 4 | decode-parallelism.png | Decode 并行方案( 复制) |
| Figure 5 | kv-cache-shift-vs-concat.png | KV 缓存 concat vs shift |
| Figure 6 | gemm-plmr-compliance.png | 分布式 GEMM 的 PLMR 合规性 |
| Figure 7 | interleave-scalability.png | INTERLEAVE 设计直觉与可扩展性 |
| Figure 8 | gemv-plmr-compliance.png | 分布式 GEMV 的 PLMR 合规性 |
| Figure 9 | meshgemm-vs-summa-cannon.png | MeshGEMM vs SUMMA & Cannon |
| Figure 10 | meshgemv-vs-cerebras.png | MeshGEMV vs Cerebras 默认 GEMV |


