Twilight: Adaptive Attention Sparsity with Hierarchical Top-p Pruning
基于分层 Top-p 剪枝的自适应注意力稀疏框架,加速长上下文 LLM 推理
Twilight: Adaptive Attention Sparsity with Hierarchical Top-p Pruning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Twilight: Adaptive Attention Sparsity with Hierarchical Top-p Pruning |
| 作者 | Chaofan Lin, Jiaming Tang, Shuo Yang, Hanshuo Wang, Tian Tang, Boyu Tian, Ion Stoica, Song Han, Mingyu Gao |
| 机构 | MIT CSAIL, Tsinghua University |
| 论文 | arXiv:2502.02770 |
| 代码 | — (未开源) |
| 发布 | 2025-02-04 |
核心贡献:
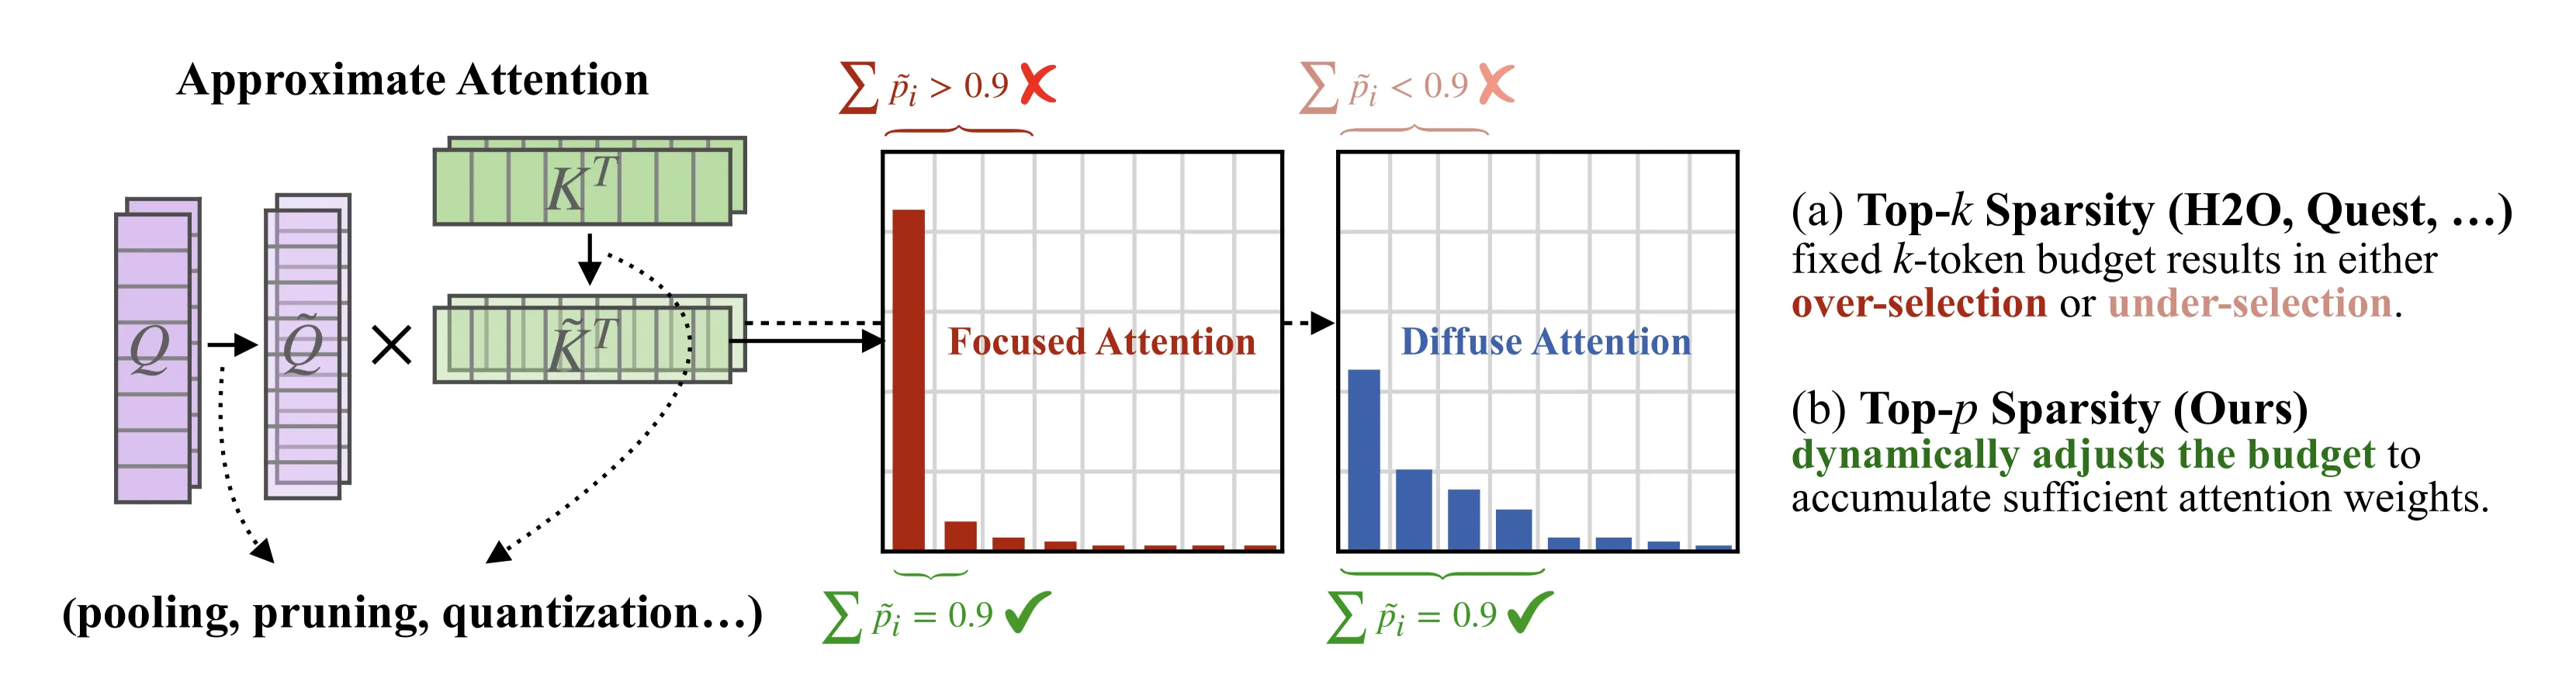
- 发现 Top-k 稀疏注意力的核心问题——固定预算在动态注意力分布下会导致 over-selection 或 under-selection
- 提出将 Top-p(nucleus sampling)引入稀疏注意力,实现自适应预算分配
- 设计 Twilight 框架:Select-then-Prune 双层架构,可无缝适配任何现有稀疏注意力算法
- 实现高效 CUDA/Triton kernel:4-bit 量化 K cache + 并行二分搜索 Top-p + SpGEMV 优化
二、核心思想
问题定义
长上下文 LLM 在解码阶段的注意力计算受限于内存带宽——KV cache 随序列长度增长而增大,需要反复从全局内存加载。现有稀疏注意力方法(如 H2O、Quest、Double Sparsity)使用固定预算 B(即 Top-k),但在实际部署中面临两大挑战:
- 饱和点动态变化:不同 attention head 的注意力权重分布差异很大。有些 head 呈现”聚焦”分布(peaked/focused),少数 token 即可累积足够权重;有些呈现”弥散”分布(flat/diffuse),大量 token 权重相似。固定预算无法同时适应两种极端。
- 算法效率低下:现有算法需离线校准预算,且因估计误差不得不 over-select token。
解决方案概述
Twilight 的核心洞察是:Top-p 采样(nucleus sampling)在 LLM 生成阶段解决了类似的动态分布问题,同样适用于稀疏注意力中的 token 选择。
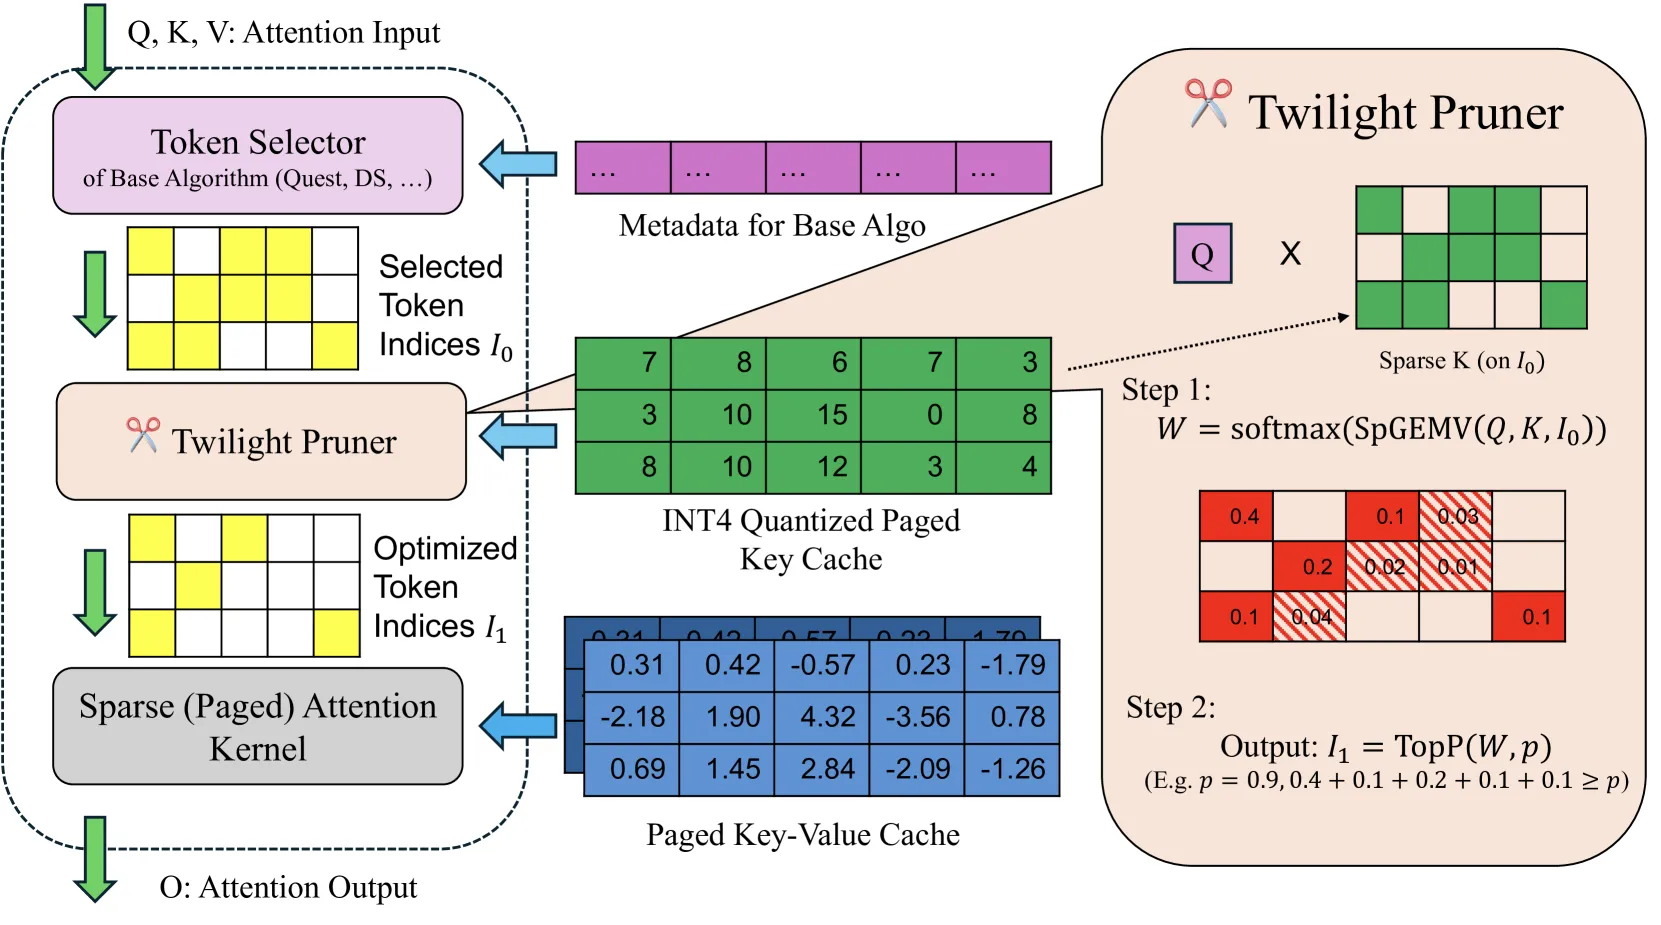
Twilight 采用 Select-then-Prune 两层架构:
- Token Selector:基线算法在宽松预算下选择一个较大候选集(如 1/4 稀疏度)
- Twilight Pruner:对候选集执行 Top-p 阈值剪枝,动态确定最终保留的 token 数量
三大技术挑战
- C1 — 并非所有算法都适合 Top-p:如 Quest 使用 per-page max pooling(16 tokens/page),注意力权重布局不满足 Top-p 要求;部分方法根本不依赖注意力权重选择 token。
- C2 — Top-p 精度要求更高:Top-k 仅需排序正确性,Top-p 需要数值精度以保证累积和达到阈值 p。
- C3 — 系统级优化需求:首次将 Top-p 引入注意力权重,需要在硬件上高效实现并行算法。
三、技术架构
整体框架
Twilight 包含三个步骤:
- Token Selector 选择候选 token(基于基线算法策略 + 宽松预算)
- Twilight Pruner 通过 Top-p 阈值剪枝优化 token 索引
- Sparse Attention Kernel 执行注意力计算
核心公式
稀疏注意力形式化(Definition 3.1)
\hat{O} = \text{softmax}\left(\frac{Q \cdot K^T}{\sqrt{d}}\right) \Lambda_{\mathcal{I}} V = W \Lambda_{\mathcal{I}} V \tag{1}
其中 为选择掩码矩阵:
误差界推导
最小化输出误差 ,利用 V 的相对平滑性(Zhao et al., 2024),可得:
因此目标是最小化 ,即选择注意力权重之和最大的 token 子集。
Oracle Top-k 稀疏注意力(Definition 3.2)
给定预算 :
\mathcal{I} = \arg\max_{\mathcal{I}} \sum_{i=1}^{n} W \Lambda_{\mathcal{I}} \quad \text{s.t. } |\mathcal{I}| = B \tag{3}
Oracle Top-p 稀疏注意力(Definition 3.3)
给定阈值 :
\mathcal{I} = \arg\min_{\mathcal{I}} |\mathcal{I}| \quad \text{s.t. } \sum_{i=1}^{n} W \Lambda_{\mathcal{I}} \geq p \tag{4}
关键优势:Top-p 提供了理论误差上界 ,同时自适应地最小化预算。
注意力分布多样性
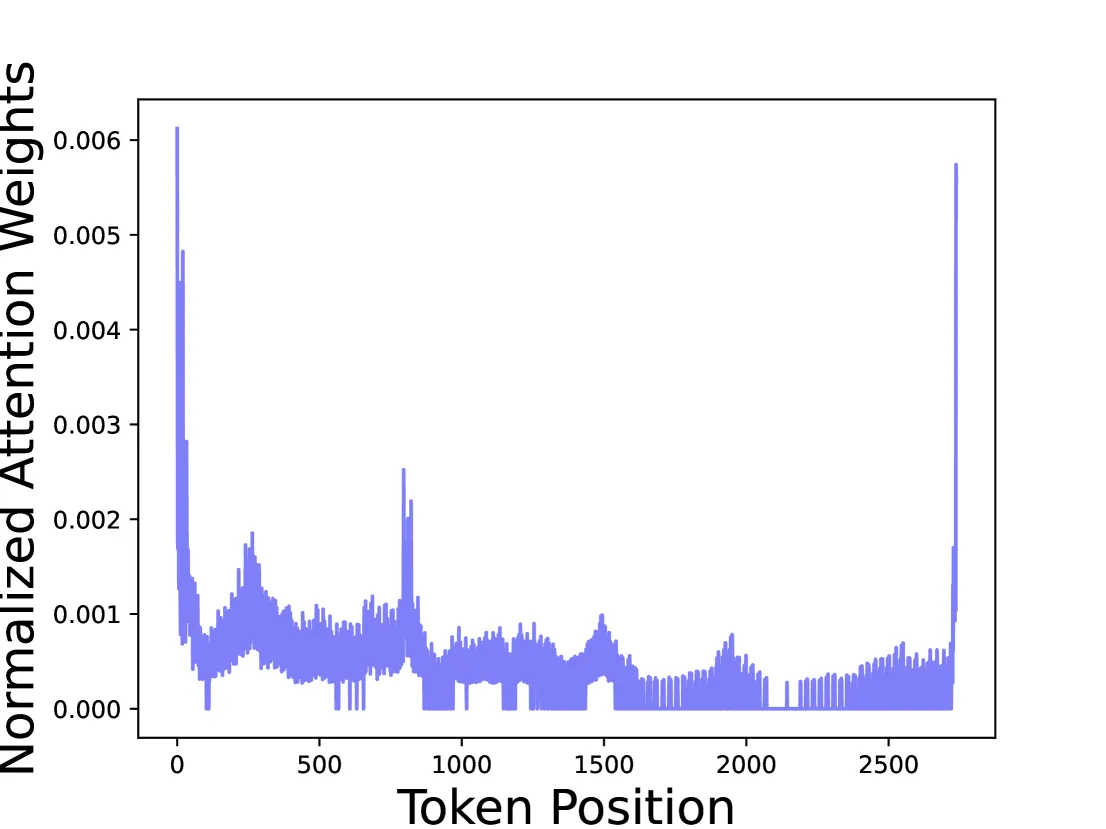
Figure 3 展示了真实 LLM 中的两种注意力分布:
- Flat(弥散):权重均匀分布,需要更多 token 才能达到相同累积阈值
- Peaked(聚焦):权重集中在头部和尾部 token,少数 token 即可覆盖
预算加速比分析
设 Token Selector 预算为 ,Twilight 剪枝后预算为 ,理论加速比为:
当 时,加速比约 2×。
算法流程
Algorithm 1: Top-p via Binary Search
Input: Normalized attention weights W ∈ ℝ^(BS×H×N), Threshold p, Hyper-parameter ε
Output: Indices I, Mask M ∈ {0,1}^(BS×H×N)

Initialize: l = 0, r = max(W), m = (l+r)/2

repeat
  W0 = where(W < m, 0.0, W)    // 低于 m 的值置 0
  W1 = where(W ≤ l, INF, W)     // 低于 l 的值置 INF
  W2 = where(W > r, -INF, W)    // 高于 r 的值置 -INF
  s = sum(W0)                   // 当前阈值 m 下的累加和

  if s ≥ p then
    l = m                       // 阈值太低,提高下界
  else
    r = m                       // 阈值太高,降低上界
  end if
until max(W2) - min(W1) < ε

Select indices I or mask M where W ≥ l;
return I, M
该算法避免了串行排序,适合 GPU 并行实现。
4-bit 量化 K Cache
针对 C2 挑战,Twilight 维护额外的 INT4 非对称量化 K cache:
- INT4 向量在共享内存中 unpack 和 dequantize
- 减少全局内存到共享内存的 I/O 至最多 1/4
- 实验表明 4-bit 在精度和效率间取得最佳平衡(Fig. 5)
量化位宽选择(Fig. 5)
| 量化位宽 | 注意力权重和稳定性 | 计算开销 |
|---|---|---|
| 2-bit | 显著下降,不稳定 | 最低 |
| 4-bit | 稳定 | 低 |
| 8-bit | 稳定 | 较高(过度精确) |
模型组件总览
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Token Selector | 黑盒选择器,基于基线算法策略选择候选集 | 宽松预算(如 1/4 稀疏度) |
| Twilight Pruner | Top-p 阈值剪枝 | p ∈ [0.85, 0.95] |
| 4-bit K Cache | INT4 非对称量化 K 向量 | 共享内存内 unpack/dequantize |
| SpGEMV Kernel | 基于 FlashInfer 的高效稀疏 GEMV | — |
| Top-p Binary Search | 并行二分搜索找到累积和≥p 的阈值 | ε 收敛精度 |
| Sparse Attention Kernel | 最终稀疏注意力计算 | — |
运行时开销分析
相比无 Twilight 的基线,额外引入了 但减少了 的 I/O。由于 Hierarchical 架构天然匹配分层稀疏度(token 数随精度递增而递减),整体仍获加速。
与 Serving System 集成
Twilight 天然适配 PagedAttention(Kwon et al., 2023),可无缝集成到 vLLM、SGLang 等推理系统。Prefix sharing 和 multi-phase attention 也适用,因为 Twilight 使用 page-level 或 token-level 稀疏操作。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Top-p 稀疏注意力 | 首次将 nucleus sampling 引入稀疏注意力,动态确定 KV cache 预算 | Eq.(4):提供理论误差上界 |
| Select-then-Prune 双层架构 | 将基线算法抽象为黑盒 Token Selector,在其后附加 Pruner | 通用适配任意 Top-k 稀疏注意力算法 |
| 并行二分搜索 Top-p | 避免串行排序,适合 GPU 并行实现 | Algorithm 1,修改自 FlashInfer top-p sampling kernel |
| 4-bit K Cache 量化 | 在精度和效率间取得最佳平衡 | Fig. 5:2-bit 不稳定,8-bit 过度精确 |
| 高效 SpGEMV 实现 | 基于 FlashInfer 实现稀疏 GEMV kernel | 全局内存 I/O 降至 1/4 |
五、代码实现分析
实现技术栈:
- CUDA + OpenAI Triton 实现 Twilight kernel
- 基于 FlashInfer 库构建 SpGEMV kernel
- 修改 Quest kernel 支持 batch inference
Note: 代码未开源。
六、实验结果
评估设置
模型:LongChat-7B-v1.5-32K、LLaMA2-7B-Chat、LLaMA-3.1-8B-Instruct(覆盖 MHA 和 GQA)
基准:Longbench(长上下文)、GSM8K / COQA / PG-19(短上下文)
基线:Quest、Double Sparsity(DS)、FlashAttention2
超参数:LLaMA 2/3 的 ,LongChat 的 ;前两层不应用稀疏
精度评估
短上下文任务(Table 2):
| 模型 | 方法 | GSM8K (flex/strict)↑ | COQA (em/f1)↑ | PG-19 Perplexity↓ |
|---|---|---|---|---|
| LLaMA-2-7B-Chat | Full Cache | 0.2290 / 0.2282 | 0.5935 / 0.7511 | 7.503 |
| LLaMA-2-7B-Chat | Quest | 0.0114 / 0.0061 | 0.5150 / 0.6991 | 14.15 |
| LLaMA-2-7B-Chat | DS | 0.1820 / 0.1812 | 0.6043 / 0.7632 | 7.622 |
| LLaMA-2-7B-Chat | Twilight | 0.2153 / 0.2115 | 0.6088 / 0.7642 | 7.600 |
| LLaMA-3.1-8B | Full Cache | 0.7726 / 0.7475 | 0.6363 / 0.7882 | 7.490 |
| LLaMA-3.1-8B | Quest | 0.0773 / 0.0652 | 0.5310 / 0.7033 | 19.00 |
| LLaMA-3.1-8B | DS | 0.3806 / 0.3609 | 0.6490 / 0.8003 | 10.23 |
| LLaMA-3.1-8B | Twilight | 0.7771 / 0.7604 | 0.6325 / 0.7869 | 7.529 |
Twilight 在全部短上下文任务上几乎无损,而 Quest 和 DS 在固定小预算(64)下损失严重。
长上下文任务(Longbench):
- LongChat:Twilight 系列较原版最高提升 5.7% 分数,同时剪除最多 98% 的冗余 token
- LLaMA-3.1-8B:几乎零精度损失(<1%),略有增加预算(推测因知识更压缩)
效率评估
Self-Attention 算子加速(Fig. 7):
| 方法 | 对比 FlashAttention2 | 对比基线 |
|---|---|---|
| FlashInfer-Twi | 6.5× | 2.2× |
| Quest-Twi | 15.4× | 1.4× |
端到端解码加速(Fig. 8):
Quest-Twi 较 FlashInfer 实现最高 3.9× 解码加速,较 Quest 本身额外提速 1.35×。
时间分解(Fig. 6): 在 batch size 64 时,Quest-Twi 较 Quest 快约 2×,证明 Pruner 开销远小于其节省的 I/O 开销。
消融研究
量化位宽选择(Fig. 5): 2-bit 导致注意力权重和显著下降,4-bit 和 8-bit 保持稳定。4-bit 是最佳平衡点。
预算-困惑度关系(Fig. 2): 不同 Top-k 稀疏方法的最佳饱和点对应不同预算,验证了自适应预算的必要性。
七、相关工作
稀疏注意力(KV Cache Sparsity):
- 静态淘汰:H2O、StreamingLLM、SnapKV — query-agnostic 方式丢弃非关键 token
- 动态选择:SparQ、Double Sparsity、Quest — 保留全部 token 在 GPU,选择性加载
- 检索增强:RetrievalAttention — 更精确估计 token 关键性
动态预算:
- 不同层/不同 head/不同 prompt 的最优预算差异显著(Cai et al., 2024; Feng et al., 2025; Zhou et al., 2024)
其他 KV Cache 优化:
- 量化(PagedAttention, AQLM, SmoothQuant)、线性注意力(Linformer, Performer)、FlashAttention、SageAttention
Twilight 与以上方法正交,可组合使用。
八、总结
核心贡献
- Top-p 稀疏注意力:首次将 nucleus sampling 引入稀疏注意力,通过动态累积阈值替代固定预算
- Twilight 框架:Select-then-Prune 双层架构,可无缝适配任意现有稀疏注意力算法
- 高效 Kernel 实现:4-bit 量化 K cache + 并行二分搜索 Top-p + SpGEMV 优化
- 全面实验验证:在 3 个模型、两类 benchmark 上验证,自注意力最高 15.4× 加速,端到端 3.9× 加速
局限性
- 并非所有现有算法都适合 Top-p(如 Quest 的 per-page 布局)
- Top-p 需要比 Top-k 更高的数值精度,限制了可搭配的量化方案
- 代码未开源
未来方向
- 探索更多适合 Top-p 的注意力权重估计方法
- 将 Twilight 集成到 vLLM/SGLang 等主流推理系统中验证
九、参考资源
- arXiv: https://arxiv.org/abs/2502.02770
- 相关论文: SpargeAttn (ICML 2025), SageAttention (ICLR 2025), SageAttention2 (ICML 2025), Quest (NeurIPS 2024), Double Sparsity (NeurIPS 2024), FlashAttention2 (ICLR 2024), FlashInfer
附图索引
| 编号 | 文件名 | 说明 |
|---|---|---|
| Figure 1 | figure-1-topk-vs-topp.png | Top-k vs Top-p 稀疏对比(over/under-selection) |
| Figure 2 | figure-2-budget-perplexity.png | 预算-困惑度关系(不同 Top-k 方法的饱和点差异) |
| Figure 3 | figure-3-attention-distributions.png | 注意力权重分布多样性(Flat vs Peaked) |
| Figure 4 | figure-4-twilight-architecture.png | Twilight 三层架构(Token Selector → Pruner → Sparse Kernel) |
| Figure 5 | figure-5-quantization-bits.png | 不同量化位宽的注意力权重和稳定性 |
| Figure 6 | figure-6-time-breakdown.png | 自注意力时间分解(batch size 64 时 Quest-Twi 快 2×) |
| Figure 7 | figure-7-latency-speedup.png | 不同序列长度和 batch size 下的自注意力延迟与加速比 |
| Figure 8 | figure-8-tpot-speedup.png | 端到端推理场景的 TPOT 加速比 |