ParetoQ: Improving Scaling Laws in Extremely Low-bit LLM Quantization
一、论文概述
| 项目 | 内容 |
|---|
| 标题 | ParetoQ: Improving Scaling Laws in Extremely Low-bit LLM Quantization |
| 作者 | Zechun Liu, Changsheng Zhao, Igor Fedorov, Bilge Soran, Dhruv Choudhary, Raghuraman Krishnamoorthi, Vikas Chandra, Yuandong Tian, Tijmen Blankevoort |
| 机构 | Meta AI (FAIR) |
| 论文 | arXiv:2502.02631 |
| 代码 | 未公开 |
| 发布 | 2025年2月4日 |
| 主题 | cs.LG, cs.AI, cs.CL |
| 会议 | ICLR 2025 |
二、核心思想
问题定义
关于 LLM 量化的最优比特宽度一直存在争议:
- 一些研究主张 4-bit 量化 是最优选择
- 另一些研究认为 1.58-bit (三值) 量化更优
- 缺乏统一框架进行公平比较
核心挑战: 不同比特宽度的量化方法使用不同的训练策略和量化函数,导致比较不公平。
解决方案概述
ParetoQ 是第一个统一框架,支持在 1-bit、1.58-bit、2-bit、3-bit 和 4-bit 之间进行严格比较:
- 统一训练策略: 优化 QAT 预算分配(90% FP + 10% QAT)
- 统一量化函数: 为每个比特宽度选择最优量化函数
- 公平比较: 确保所有比特宽度都在最优配置下比较
核心发现
| 发现 | 说明 |
|---|
| 学习转变 | 2-bit 和 3-bit 之间存在显著的学习行为转变 |
| 2-bit 优越性 | 2-bit 量化在精度-大小权衡上优于 4-bit |
| 硬件友好 | 2-bit 比三值 (1.58-bit) 更硬件友好 |
| SOTA 性能 | ParetoQ 在所有比特宽度上超越先前方法 |
三、技术架构
整体框架图
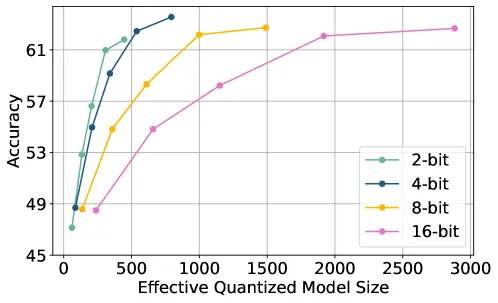
Figure 1: 精度-大小权衡的 Pareto 曲线。
核心公式
量化损失函数的五维搜索空间:
L(P,F,N,Strain,D)
其中:
- P: 量化精度(比特宽度)
- F: 量化函数
- N: 模型参数数量
- Strain: 训练策略
- D: 训练 token 数量
训练预算分配
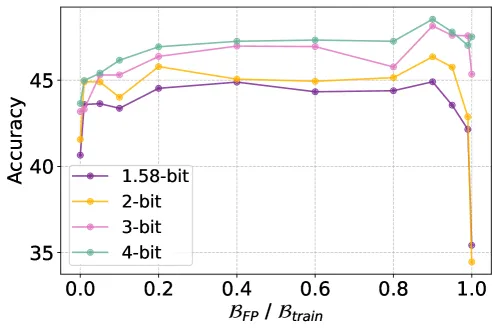
Figure 2: 固定 100B token 训练预算下的最优分配。
最优分配比例:
- 90% 全精度预训练 (BFPT)
- 10% QAT 微调 (BQAT)
BFPT∗,BQAT∗=argminBFPT+BQAT=BtrainL(BFPT,BQAT∣N,P)
训练 Token 需求
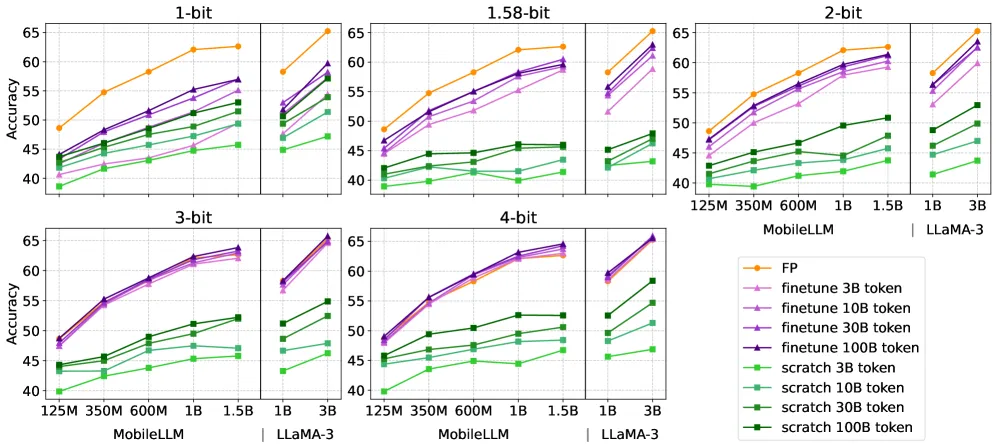
Figure 3: 不同比特宽度的 QAT 微调和从头训练的 token 需求分析。
关键发现:
- 3-bit 和 4-bit: 微调在 10B token 时饱和
- 1-bit、1.58-bit、2-bit: 微调在 30B token 时饱和
- 微调始终优于从头训练(在精度和 token 效率上)
权重差异分析
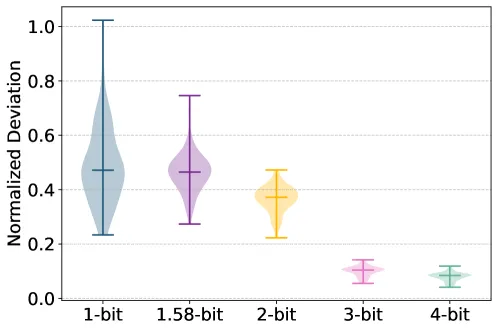
Figure 4: QAT 微调权重与全精度初始化之间的 L1 范数差异。
关键发现:
- 3-bit 和 4-bit: 微调后的模型接近原始预训练分布
- 2-bit 及以下: 表示发生剧烈变化
四、量化函数设计
量化网格选择
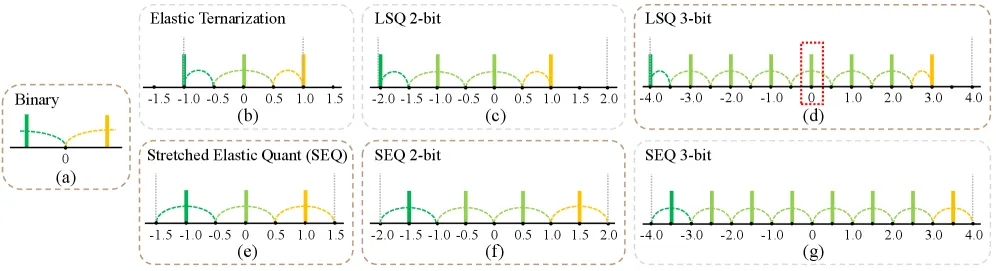
Figure 5: 不同比特宽度的量化网格选择影响。
关键权衡:
- 异常值精度 vs 中间值精度
- 对称性 vs 包含 “0”
量化方法比较
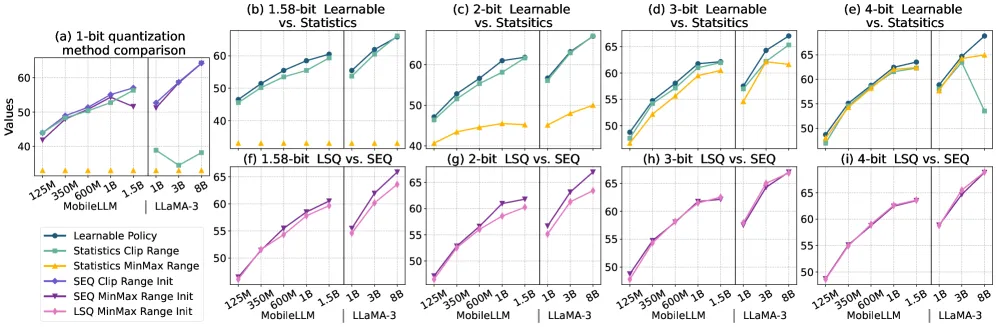
Figure 6: 不同比特宽度的量化方法比较。
ParetoQ 统一量化函数
\alpha \cdot \text{Sign}(\mathbf{W}_{\mathbf{R}}^{i}), & \text{if } N_{bit}=1 \\
\alpha(\lfloor \text{Clip}(\frac{\mathbf{W}_{\mathbf{R}}^{i}}{\alpha}, -1, 1) \times k/2 - 0.5 \rceil + 0.5)/k \times 2, & \text{if } N_{bit}=1.58, 2 \\
\alpha \lfloor \text{Clip}(\frac{\mathbf{W}_{\mathbf{R}}^{i}}{\alpha}, n, p) \rceil, & \text{if } N_{bit}=3, 4
\end{cases}$$
其中:
- **1-bit**: Elastic Binarization
- **1.58-bit 和 2-bit**: 提出的 **SEQ (Stretched Elastic Quant)**
- **3-bit 和 4-bit**: LSQ (Learned Step Size Quantization)
### SEQ 量化器
$$\mathbf{W}_{\mathbf{Q}}^{i} = \alpha \left( \lfloor \text{Clip}\left(\frac{\mathbf{W}_{\mathbf{R}}^{i}}{\alpha}, -1, 1\right) \times \frac{k}{2} - 0.5 \rceil + 0.5 \right) / k \times 2$$
**特点**:
- 平衡输出量化水平
- 均匀划分全精度权重跨度
- 适用于三值和 2-bit 量化
## 五、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|--------|------|---------------|
| **统一框架** | 第一个支持 1-4-bit 严格比较的框架 | 8 个模型 (125M-3B) × 5 种量化策略 |
| **最优训练策略** | 90% FP + 10% QAT 分配 | MobileLLM-125M 实验验证 |
| **SEQ 量化器** | 对称水平 + 平衡范围覆盖 | 三值和 2-bit 优于 LSQ |
| **学习转变发现** | 2-bit 和 3-bit 之间存在行为转变 | 权重差异分析 |
| **2-bit 优越性** | 精度-大小权衡优于 4-bit | Pareto 曲线分析 |
## 六、实验结果
### 实验设置
| 项目 | 配置 |
|------|------|
| **模型** | MobileLLM-125M/360M/600M/1B, LLaMA-2 7B/13B/70B, LLaMA-3 8B |
| **比特宽度** | 1-bit, 1.58-bit, 2-bit, 3-bit, 4-bit |
| **训练数据** | 最多 100B token |
| **评估** | 8 个零样本常识推理任务 |
### Pareto 最优性

**Figure 7**: (a)(b) 在 sub-4-bit 领域,1.58-bit、2-bit 和 3-bit 量化在精度-大小权衡上优于 4-bit。(c) 在硬件约束下,2-bit 量化在精度-速度权衡上优于更高比特方案。
**关键发现**:
| 比特宽度 | 精度-大小权衡 | 硬件友好性 | 推荐度 |
|----------|---------------|------------|--------|
| **1-bit (二值)** | 差 | 高 | 不推荐 |
| **1.58-bit (三值)** | 好 | 低 | 有条件推荐 |
| **2-bit** | 好 | 高 | **推荐** |
| **3-bit** | 好 | 中等 | 有条件推荐 |
| **4-bit** | 中等 | 高 | 基线 |
### 精度比较

**Figure 8**: 8 个模型的精度比较。ParetoQ 超越所有 SOTA PTQ 和 QAT 方法。
### 三值量化精度

**Figure 9**: 8 个零样本常识推理任务的三值量化精度平均值。ParetoQ 始终如一地优于先前方法。
### 具体性能数据
| 模型 | 方法 | 比特宽度 | 零样本精度 | Wiki2 PPL |
|------|------|----------|------------|-----------|
| LLaMA-3 8B | 全精度 | 16-bit | 69.6 | 6.1 |
| LLaMA-3 8B | ParetoQ | 4-bit | 68.5 | 6.4 |
| LLaMA-3 8B | ParetoQ | 3-bit | 67.2 | 6.8 |
| LLaMA-3 8B | ParetoQ | 2-bit | 65.8 | 7.1 |
| LLaMA-3 8B | ParetoQ | 1.58-bit | 65.2 | 7.3 |
| LLaMA-3 8B | ParetoQ | 1-bit | 38.2 | 1e3 |
### 与先前方法对比
| 方法 | LLaMA-3 8B (W4A4KV4) | LLaMA-2 7B (W4A4KV4) |
|------|----------------------|----------------------|
| SmoothQuant | 38.7 | 39.0 |
| LLM-QAT | 43.2 | 44.9 |
| QuaRot | 63.3 | 62.5 |
| **ParetoQ** | **65.2** | **64.0** |
**关键结果**:
- ParetoQ 三值 600M 模型超越先前 SOTA 三值 3B 模型(仅用 1/5 参数)
- ParetoQ LLaMA-3 8B (1.58-bit) 比 1-bit Era 的 LLaMA-3 8B 减少 37.8% 性能差距(仅用 30% 训练 token)
## 七、GPU 延迟分析

**Figure 10**: (a) 精度与端到端 GPU 延迟权衡分析。(b) 相对于 4-bit 的 GPU 内核延迟加速。
**关键结果**:
- 2-bit 量化在相同精度下比 4-bit 更快
- 2-bit 实现更高的精度-速度权衡
## 八、与现有方法对比
| 方面 | SmoothQuant | LLM-QAT | QuaRot | ParetoQ |
|------|-------------|---------|--------|---------|
| **量化类型** | PTQ | QAT | PTQ+旋转 | QAT |
| **支持比特** | 4-bit | 4-bit | 4-bit | **1-4-bit** |
| **训练策略** | N/A | 未优化 | N/A | **优化 (90/10)** |
| **量化函数** | Min-max | 未优化 | 随机旋转 | **每比特最优** |
| **公平比较** | 否 | 否 | 否 | **是** |
## 九、相关工作
| 相关工作 | 与本文关系 |
|----------|------------|
| **LLM.int8()** | 8-bit 量化基线 |
| **SmoothQuant** | 4-bit PTQ 基线,ParetoQ 超越 25.0 点 |
| **LLM-QAT** | 4-bit QAT 基线,ParetoQ 超越 19.1 点 |
| **QuaRot** | 4-bit PTQ+旋转,ParetoQ 减少 45.1% 差距 |
| **BitNet/1-bit Era** | 1.58-bit 量化,ParetoQ 减少 37.8% 差距 |
| **Spectra** | 三值量化,ParetoQ 提供公平比较 |
## 十、总结
### 核心贡献
1. **统一框架**: 第一个支持 1-bit 到 4-bit 严格比较的量化框架
2. **最优训练策略**: 发现 90% FP + 10% QAT 是最优分配
3. **SEQ 量化器**: 提出适用于三值和 2-bit 的新量化函数
4. **学习转变发现**: 揭示 2-bit 和 3-bit 之间的行为转变
5. **2-bit 优越性**: 证明 2-bit 在精度-大小权衡上优于 4-bit
### 技术影响
- **实践指导**: 为 LLM 量化提供明确的比特宽度选择指南
- **硬件启示**: 2-bit 量化需要社区支持(如 NVIDIA tensor cores 的 INT2 支持)
- **公平比较**: 为未来量化研究提供统一的比较框架
- **SOTA 性能**: 在所有比特宽度上超越先前方法
### 局限性
- 仅在有限的模型规模上验证(最大 70B)
- 2-bit 量化需要专门的硬件支持才能实现实际加速
- 未探索混合精度量化策略
- 训练成本较高(需要 QAT)
## 十一、参考资源
- **论文**: [arXiv:2502.02631](https://arxiv.org/abs/2502.02631)
- **主题**: cs.LG, cs.AI, cs.CL
- **页数**: 约 20 页, 14 图, 9 表
- **会议**: ICLR 2025