Sparse VideoGen: Accelerating Video Diffusion Transformers with Spatial-Temporal Sparsity
利用时空稀疏性加速视频扩散Transformer推理,实现2.28×/2.33×端到端加速
Sparse VideoGen: Accelerating Video Diffusion Transformers with Spatial-Temporal Sparsity
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Sparse VideoGen: Accelerating Video Diffusion Transformers with Spatial-Temporal Sparsity |
| 作者 | Haocheng Xi, Shuo Yang, Yilong Zhao, Chenfeng Xu, Muyang Li, Xiuyu Li, Yujun Lin, Han Cai, Jintao Zhang, Dacheng Li, Jianfei Chen, Ion Stoica, Kurt Keutzer, Song Han |
| 机构 | UC Berkeley, MIT, NVIDIA |
| 论文 | arXiv:2502.01776 |
| 代码 | GitHub |
| 发布 | 2025-02-03 |
| 领域 | 机器学习 (cs.LG), ICML 2025 |
二、核心思想
问题定义
视频扩散Transformer(DiTs)在生成高质量视频方面表现卓越,但其计算成本极高。以HunyuanVideo为例,在NVIDIA A100上生成5秒视频需要近1小时,其中3D全注意力机制占据了80%以上的推理时间。
核心挑战:
- 3D全注意力的二次计算复杂度随上下文长度急剧增长
- 现有的稀疏注意力方法(如MInference)直接应用于视频DiTs效果不佳
- 视频数据具有独特的稀疏模式,不同于文本数据
核心发现
本文的关键观察是:视频DiTs中的注意力头天然具有两种不同的稀疏模式:
-
Spatial Head(空间头):注意力分数集中在同一帧内的空间相邻token上
- 注意力图呈现块状布局(block-wise)
- 负责维持生成视频的空间一致性
-
Temporal Head(时间头):注意力分数集中在不同帧的相同空间位置token上
- 注意力图呈现斜线布局(slash-wise)
- 由于每帧被tokenize为固定数量的token L,相同空间位置的token间隔为L
- 负责维持生成视频的时间一致性
解决方案概述
Sparse VideoGen (SVG) 是一个无需训练的框架,通过以下创新实现端到端加速:
- 在线profiling策略:采样1%的token,计算全注意力和两种稀疏注意力的MSE,动态选择最优稀疏模式
- 硬件友好的张量布局变换:将时间头的非连续稀疏模式重排为连续布局
- 定制化CUDA内核:基于FlashAttention、FlashInfer和Triton实现高效稀疏注意力
核心结果:
- CogVideoX-v1.5:2.28× 端到端加速,PSNR 29.99
- HunyuanVideo:2.33× 端到端加速,PSNR 29.55
三、技术架构
3D全注意力的计算瓶颈
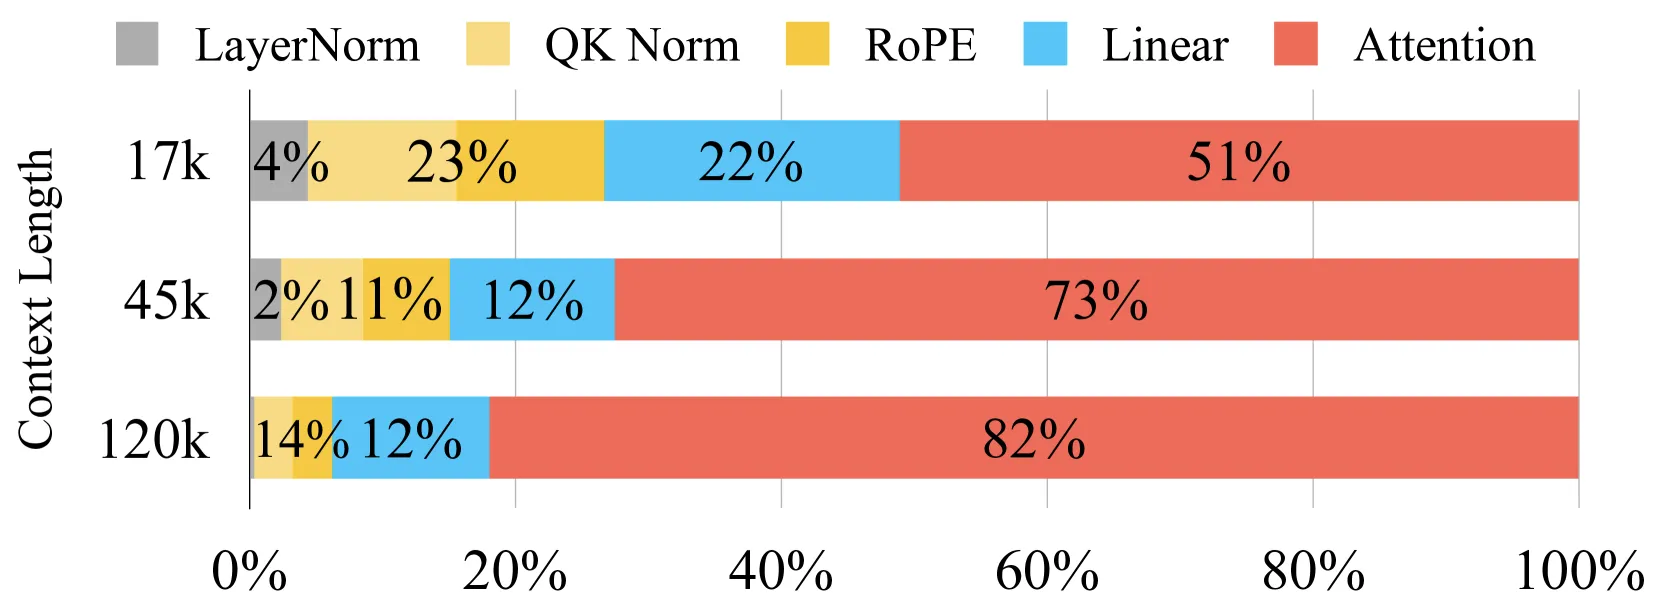
| 模型 | 上下文长度 | 注意力占比 |
|---|---|---|
| CogVideoX-v1 | 17k | 51% |
| CogVideoX-v1.5 | 45k | 73% |
| HunyuanVideo | 120k | 80%+ |
空间头与时间头
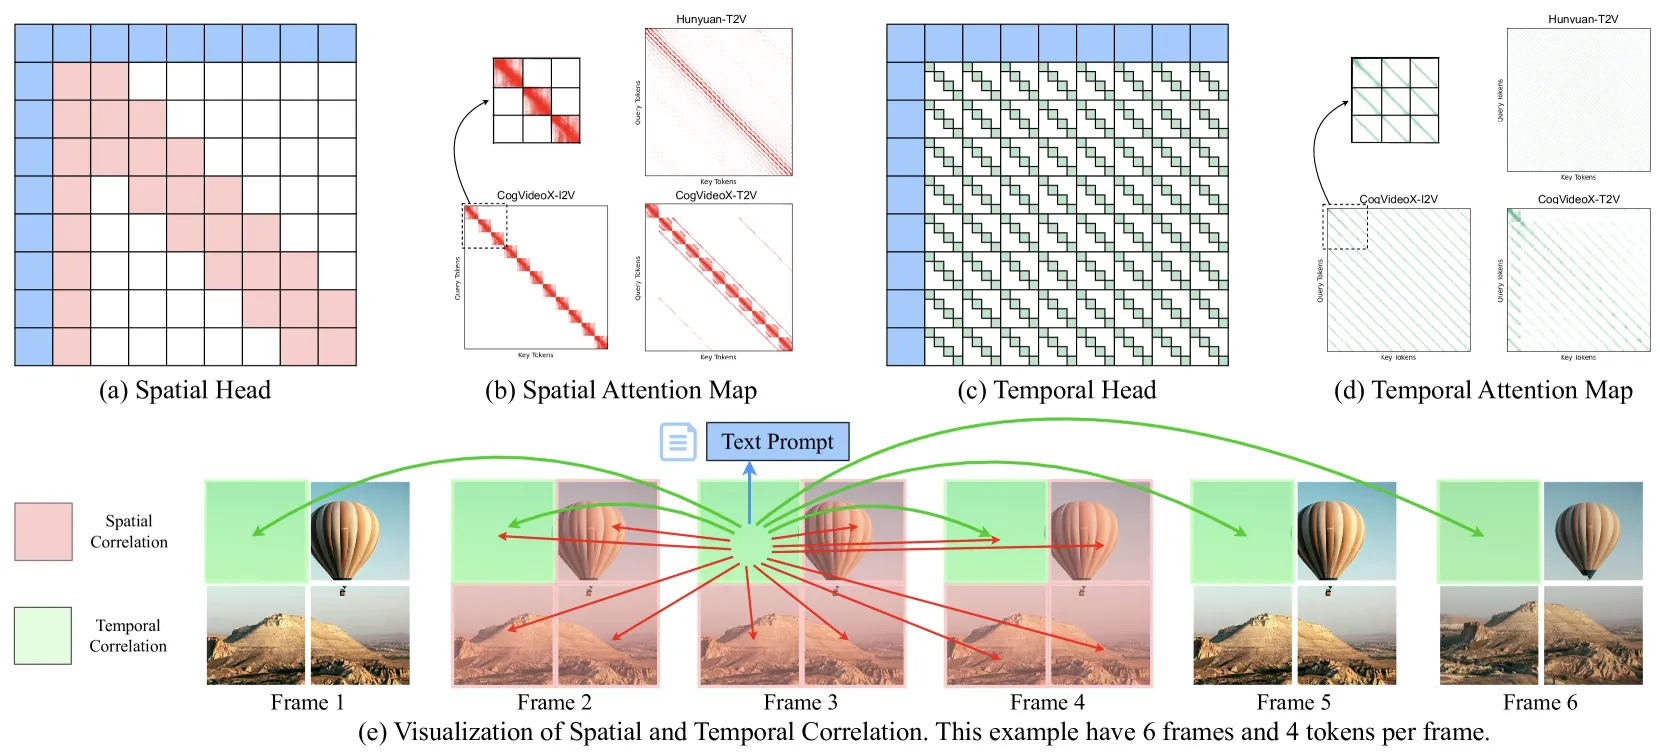
空间头特征:
- 注意力图为块状布局(block-wise)
- 每个块对应一帧的token
- 块大小 = 每帧token数 L
时间头特征:
- 注意力图为斜线布局(slash-wise)
- 斜线间隔 = L(每帧token数)
- 捕获跨帧相同位置的token关系
SVG框架总览
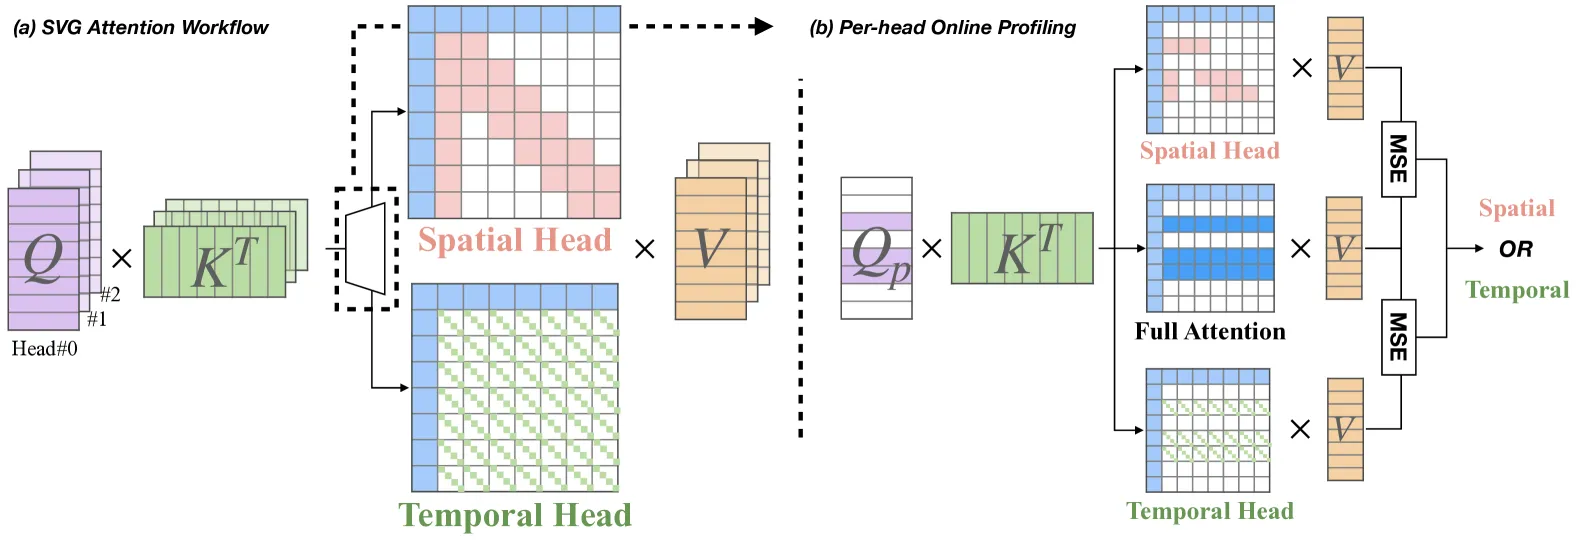
框架组成:
- 在线profiling:采样少量token,快速识别每个头的最优稀疏模式
- 稀疏注意力计算:根据识别结果应用空间或时间稀疏注意力
- 硬件优化:张量布局变换 + 定制化内核
核心算法:在线profiling策略
Algorithm 1: Online Profiling Strategy
indices = sample_indices(S, t)  # (t,)
Q_i = Q[:, :, indices, :]  # 获取采样的Q

mask_spatial = gen_spatial_mask()[:, :, indices, :]
mask_temporal = gen_temporal_mask()[:, :, indices, :]

O_full = mask_attention(Q_i, K, V, None)      # [B, H, t, D]
O_spatial = mask_attention(Q_i, K, V, mask_spatial)
O_temporal = mask_attention(Q_i, K, V, mask_temporal)

MSE_s = (O_full - O_spatial).norm().mean(dim=(2,3))  # [B, H]
MSE_t = (O_full - O_temporal).norm().mean(dim=(2,3))  # [B, H]
best_mask_config = (MSE_s < MSE_t) # True=空间头, False=时间头关键参数:
- 采样比例:1%(仅引入~3%的运行时开销)
- 空间掩码:c_s = 4帧(CogVideoX-v1.5)/ 10帧(HunyuanVideo)
- 时间掩码:c_t = 1224 tokens(CogVideoX-v1.5)/ 1200 tokens(HunyuanVideo)
硬件友好的张量布局变换
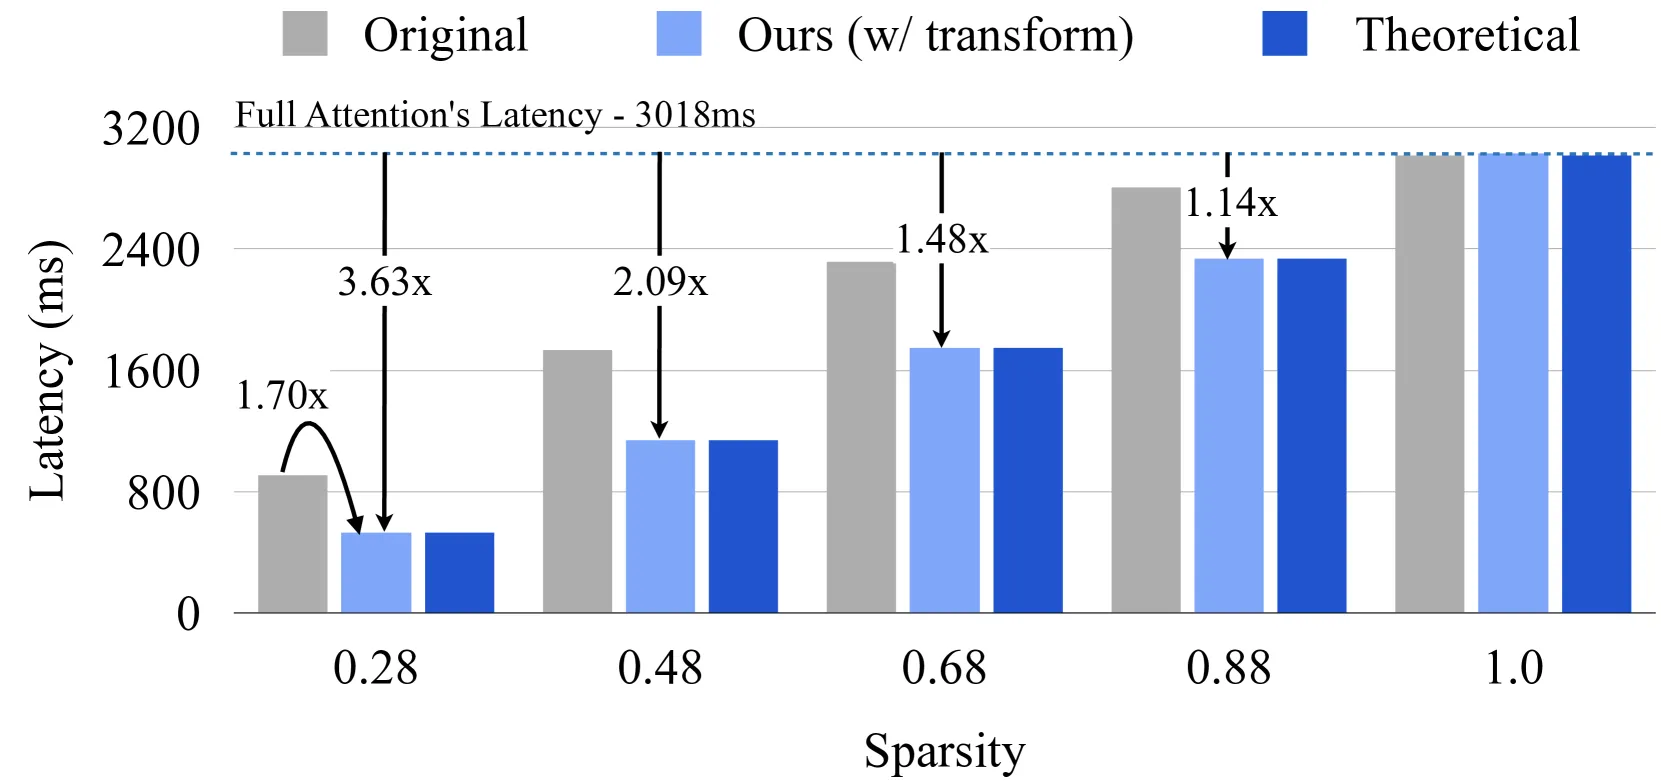
问题:时间头的斜线稀疏模式是非连续的,无法直接利用GPU的tensor core
解决方案:将非连续的稀疏模式重排为紧凑、硬件友好的布局
- 在10%稀疏度下,布局变换带来**1.7×**的额外加速
- 接近理论加速上限
其他优化
-
定制化QK-norm和RoPE内核:
- QK-norm:7.4×加速
- RoPE:15.5×加速
-
FP8注意力量化兼容:
- HunyuanVideo上额外1.3×加速
- PSNR仅下降0.1
- CogVideoX-v1.5由于head dimension=64限制了算术强度,不适用
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 空间/时间头分类 | 发现视频DiTs的两种天然稀疏模式 | 注意力图可视化分析 |
| 在线profiling策略 | 采样1%token动态识别稀疏模式 | 1%采样达到31.1 PSNR,仅3%开销 |
| 硬件友好的布局变换 | 重排非连续稀疏为连续布局 | 10%稀疏度下1.7×额外加速 |
| 定制化CUDA内核 | QK-norm 7.4×, RoPE 15.5×加速 | 基于FlashInfer/Triton实现 |
| 无需训练 | 直接应用于预训练模型 | 保持生成质量无损失 |
五、实验结果
实验设置
模型:
- CogVideoX-v1.5-I2V(720p, 10s, 80帧)
- CogVideoX-v1.5-T2V(720p, 10s, 80帧)
- HunyuanVideo-T2V(720p, 5.33s, 128帧)
评估指标:
- 质量:PSNR↑, SSIM↑, LPIPS↓, VBench-1↑, VBench-2↑
- 效率:FLOPS↓, Latency↓, Speedup↑
硬件:NVIDIA H100-80GB-HBM3, CUDA 12.4
质量评估结果
CogVideoX-v1.5-I2V (720p, 10s, 80帧):
| 方法 | PSNR↑ | SSIM↑ | LPIPS↓ | VBench-1 | VBench-2 | Speedup |
|---|---|---|---|---|---|---|
| 原始 | - | - | - | 70.09% | 95.37% | 1× |
| DiTFastAttn | 24.591 | 0.836 | 0.167 | 70.44% | 95.29% | 1.56× |
| Temporal-only | 23.839 | 0.844 | 0.157 | 70.37% | 95.13% | 1.61× |
| MInference | 22.489 | 0.743 | 0.264 | 58.85% | 87.38% | 1.48× |
| PAB | 23.234 | 0.842 | 0.145 | 69.18% | 95.42% | 1.41× |
| SVG (Ours) | 28.165 | 0.915 | 0.104 | 70.41% | 95.29% | 2.23× |
CogVideoX-v1.5-T2V (720p, 10s, 80帧):
| 方法 | PSNR↑ | SSIM↑ | LPIPS↓ | Speedup |
|---|---|---|---|---|
| 原始 | - | - | - | 1× |
| DiTFastAttn | 23.202 | 0.741 | 0.256 | 1.56× |
| Temporal-only | 23.804 | 0.811 | 0.198 | 1.61× |
| MInference | 22.451 | 0.691 | 0.304 | 1.48× |
| PAB | 22.486 | 0.740 | 0.234 | 1.41× |
| SVG (Ours) | 29.989 | 0.910 | 0.112 | 2.28× |
HunyuanVideo-T2V (720p, 5.33s, 128帧):
| 方法 | PSNR↑ | SSIM↑ | LPIPS↓ | Speedup |
|---|---|---|---|---|
| 原始 | - | - | - | 1× |
| SVG | 29.55 | - | - | 2.33× |
| SVG + FP8 | 29.45 | - | - | 3.03× |
效率评估
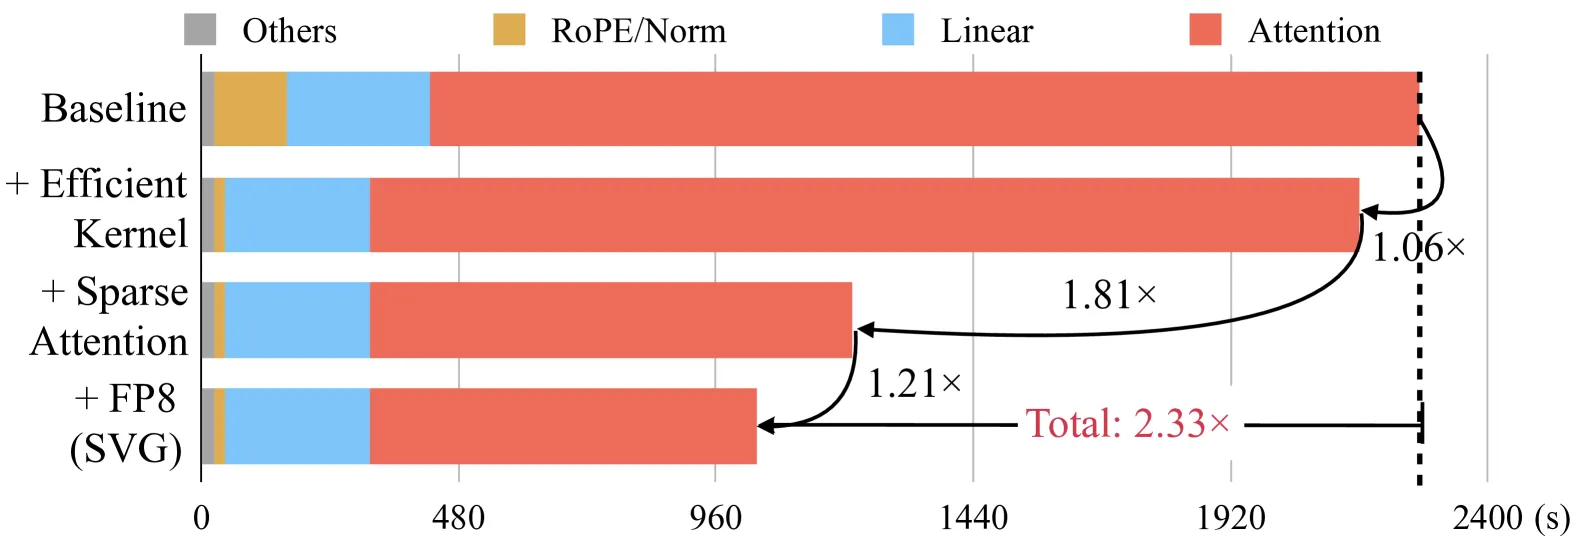
HunyuanVideo端到端加速分解:
- 原始:2253秒
- SVG优化后:968秒
- 总加速:2.33×
各优化组件贡献:
- 稀疏注意力:1.81×(最大贡献)
- 定制化QK-norm:7.4×
- 定制化RoPE:15.5×
- 布局变换:1.7×(相对于朴素稀疏)
生成质量示例
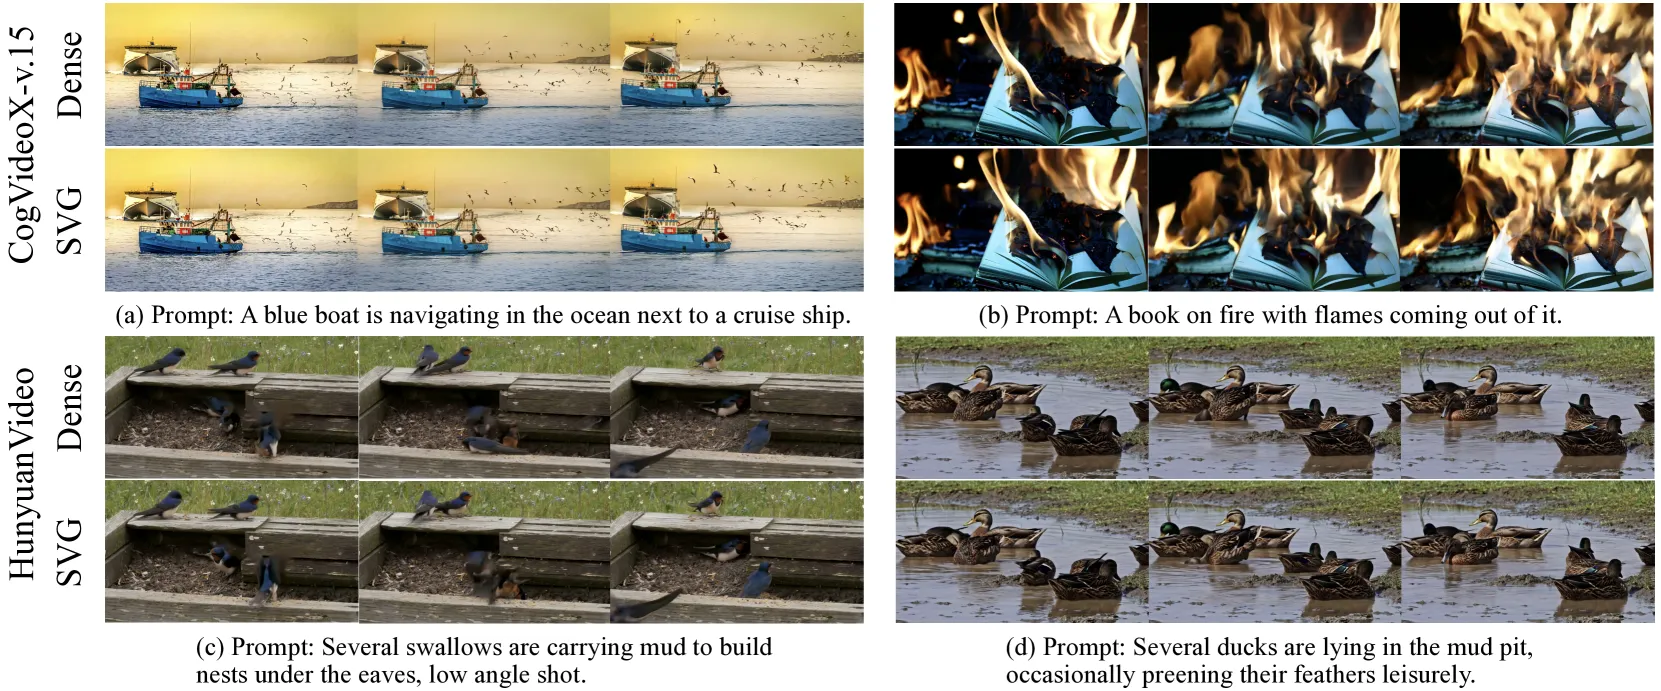
SVG在四种场景下保持高质量生成:
- 轻微场景变化
- 显著场景变化
- 稀有物体交互
- 频繁物体交互
敏感性测试
在线profiling比例:
| 采样比例 | PSNR↑ | SSIM↑ | LPIPS↓ |
|---|---|---|---|
| 0.1% | 30.791 | 0.941 | 0.0799 |
| 1% | 31.118 | 0.945 | 0.0757 |
| 5% | 31.008 | 0.944 | 0.0764 |
| 100% (Oracle) | 31.324 | 0.947 | 0.0744 |
结论:仅需1%采样即可达到接近Oracle的质量。
六、相关工作
| 方法 | 特点 | SVG优势 |
|---|---|---|
| DiTFastAttn | 空间稀疏注意力 | 同时考虑空间和时间稀疏 |
| MInference | LLM稀疏注意力 | 适配视频DiT的稀疏模式 |
| PAB | 缓存复用 | 不牺牲生成质量 |
| FlashAttention | 高效注意力实现 | 进一步减少计算量 |
| 量化方法 | 降低精度 | 正交优化,可结合使用 |
七、总结
核心贡献
- 发现视频DiTs的两种天然稀疏模式:空间头(block-wise)和时间头(slash-wise)
- 提出在线profiling策略:采样1%token即可动态识别最优稀疏模式,仅3%开销
- 硬件友好的张量布局变换:将非连续稀疏重排为连续布局,1.7×额外加速
- 端到端加速:CogVideoX-v1.5 2.28×,HunyuanVideo 2.33×,无质量损失
- ICML 2025:首个针对视频DiT的训练-free稀疏注意力框架
技术影响
- 为视频扩散模型的推理加速提供了新范式
- 空间/时间头分类思想可推广到其他时空注意力模型
- 无需训练的特性使其易于部署
- 与量化等技术正交,可进一步结合
局限性
- 稀疏度固定(~30%),未实现自适应控制
- 主要验证在CogVideoX和HunyuanVideo上
- 在线profiling引入少量额外计算(~3%)
- 未探索与其他加速技术(如蒸馏、步数减少)的结合
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | SVG加速效果总览 | figure1-speedup.png |
| Figure 2 | 注意力计算占比分析 | figure2-attention-breakdown.png |
| Figure 3 | 空间头和时间头可视化 | figure3-spatial-temporal-heads.png |
| Figure 4 | SVG框架总览 | figure4-svg-framework.png |
| Figure 6 | 生成质量对比示例 | figure6-generated-examples.png |
| Figure 7 | 端到端运行时分解 | figure7-runtime-breakdown.png |
| Figure 8 | 稀疏注意力延迟对比 | figure8-latency-comparison.png |