An Inquiry into Datacenter TCO for LLM Inference with FP8
FP8 量化对数据中心 LLM 推理 TCO 的影响分析
An Inquiry into Datacenter TCO for LLM Inference with FP8
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | An Inquiry into Datacenter TCO for LLM Inference with FP8 |
| 作者 | Intel 研究团队 |
| 机构 | Intel |
| 论文 | arXiv:2502.01070 |
| 代码 | 未开源 |
| 发布 | 2025年2月 |
| 许可 | 未明确 |
二、核心思想
问题定义
随着大语言模型(LLM)持续扩展,AI 加速器在数据中心的高功耗带来了重大挑战,显著增加了提供 LLM 推理的云服务提供商(CSP)的总拥有成本(TCO)。FP8 格式已成为下一代 LLM 的基线精度,但不同架构实现和利用低精度计算的方式存在显著差异。
解决方案概述
本文从 TCO 角度分析 LLM 推理的计算特性,提出一个可泛化的框架来比较不同 AI 加速器在多样化操作需求下的表现。使用此模型研究 Intel(Gaudi 2 & 3)和 NVIDIA(H100 & H200)加速器的关键工作负载特性对 TCO 的影响,特别是 thin GEMM 利用率 和 FP8 量化。
核心发现
- Thin GEMM 吞吐量对 TCO 的影响大于理论硬件峰值吞吐量,因为内存受限的 decode 阶段由类 GEMV 计算主导
- Gaudi HPU 在 thin GEMM 上实现了优于同类产品的利用率,特别是在 FP8 量化模型中
- 实证、工作负载级别的分析在评估加速器性能时至关重要,不能仅依赖理论硬件规格
三、技术架构
LLM 推理两阶段
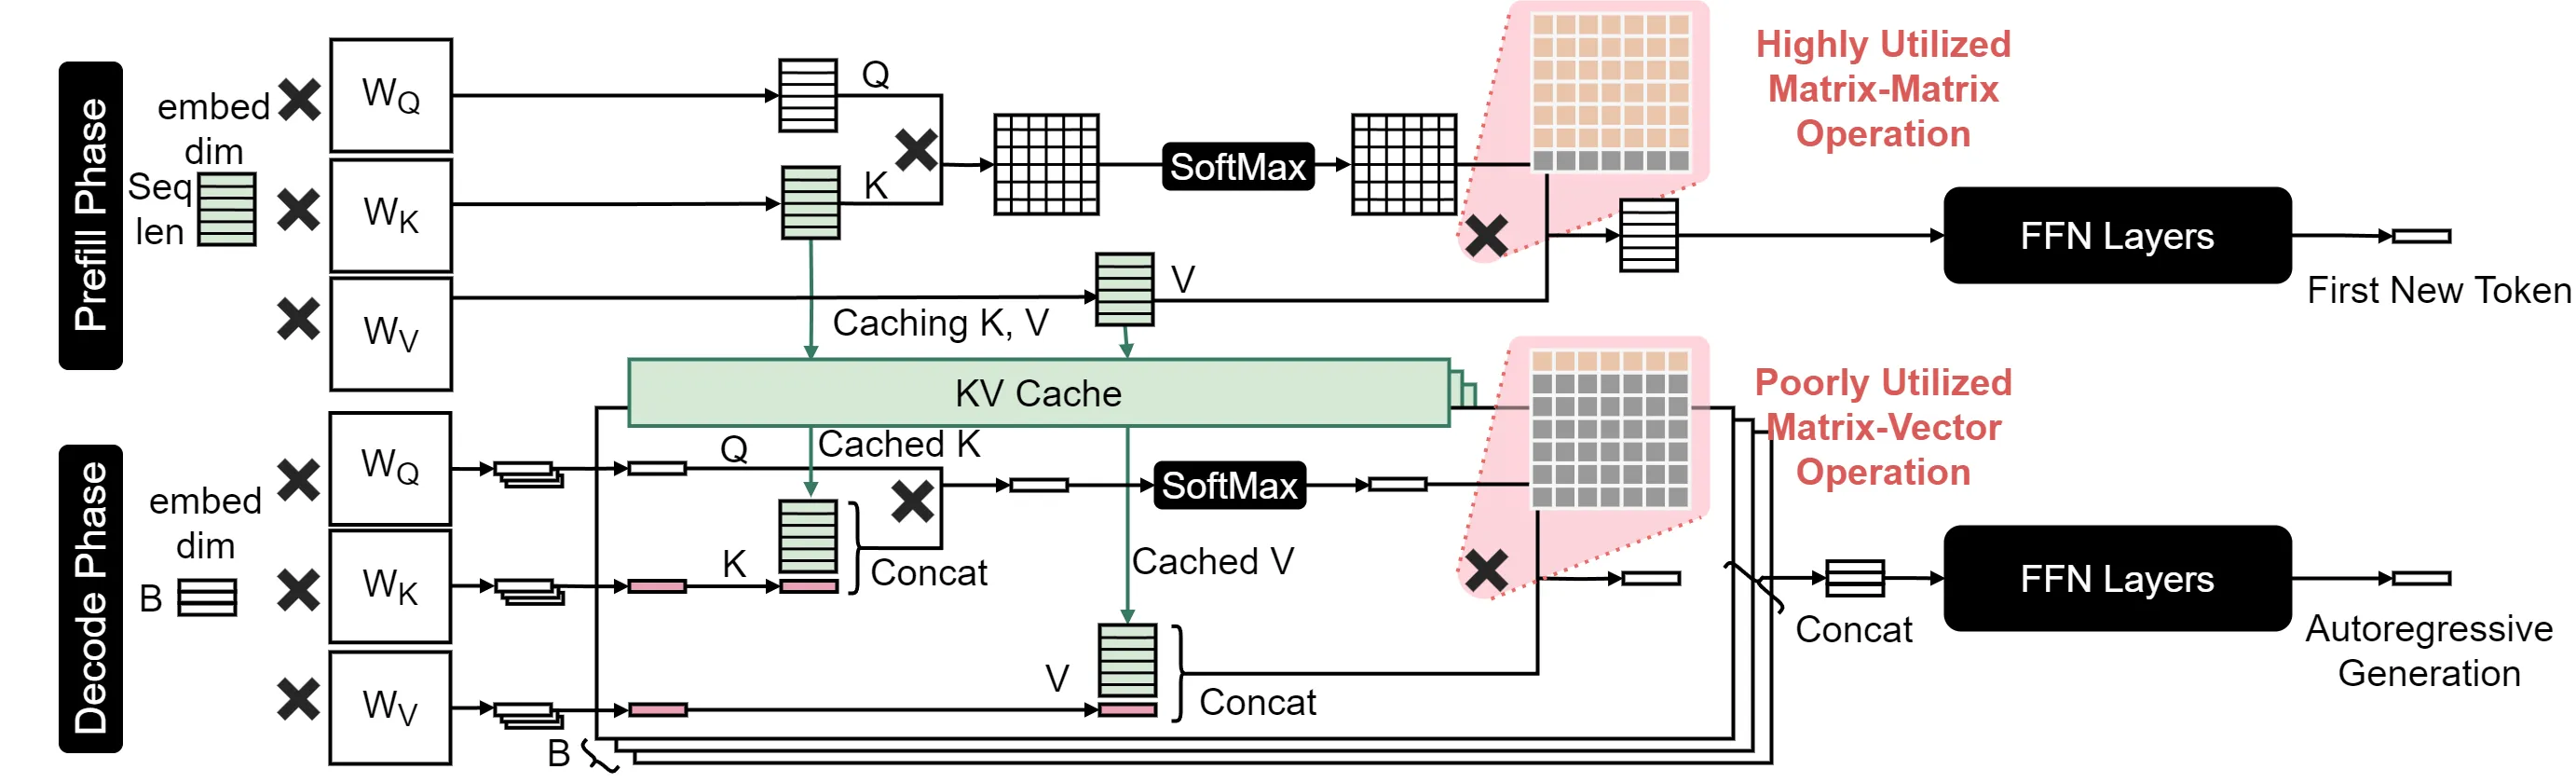
Figure 2: 生成式 LLM 推理两个阶段的过程和利用率特征
| 阶段 | 特征 | 计算类型 | 瓶颈 |
|---|---|---|---|
| Prefill | 处理整个输入提示,生成第一个 token | 矩阵-矩阵运算(GEMM) | 计算受限 |
| Decode | 自回归逐个生成输出 token | 矩阵-向量运算(GEMV) | 内存受限 |
FP8 实现差异
累加精度
- Hopper GPU: FP8 GEMM 使用 14 位累加器,需要转换到 CUDA 核心以获得更高精度
- Gaudi HPU: 始终以 FP32 累加,确保更高数值精度
E4M3 范围
- Gaudi 2: 遵循 IEEE 规范,最大值 240
- NVIDIA GPU: 使用单一特殊值表示,最大值 448
- Gaudi 3: 已修复此差异
2 的幂缩放
- Gaudi HPU 允许修改浮点指数偏置以加速缩放因子应用
- 支持固定硬件加速缩放因子:2^-8, 2^-4, 2^0, 2^4
核心公式
缩放 FP8 GEMM:
其中反量化函数:
缩放因子 s 可以是:
- Per-tensor: 整个张量使用单一缩放因子
- Per-row: 每行使用独立缩放因子(更高精度)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| TCO 分析框架 | 从 TCO 角度评估 AI 加速器 | 考虑功耗、吞吐量、精度的综合模型 |
| Thin GEMM 分析 | 关注 decode 阶段的类 GEMV 计算 | 对 TCO 影响大于理论峰值 |
| 跨架构 FP8 对比 | Intel Gaudi vs NVIDIA Hopper | 不同实现对性能和精度的影响 |
| 实证工作负载分析 | 基于实际工作负载而非理论规格 | 更准确反映真实部署性能 |
五、实验结果
方阵 FP8 GEMM 性能
| 设备 | 矩阵大小 | TFLOPS | 功耗 (W) | TF/W |
|---|---|---|---|---|
| Gaudi 2 | 1K | 367.9 (42.5%) | 375 (63%) | 1.0 |
| 2K | 586.2 (67.8%) | 460 (77%) | 1.3 | |
| 4K | 817.1 (94.5%) | 460 (77%) | 1.8 | |
| 8K | 741.8 (85.8%) | 490 (82%) | 1.5 | |
| H100 | 1K | 218.3 (11.0%) | 350 (50%) | 0.6 |
| 2K | 879.7 (44.2%) | 690 (99%) | 1.3 | |
| 4K | 1167.6 (58.7%) | 690 (99%) | 1.7 | |
| 8K | 1084.7 (54.5%) | 690 (99%) | 1.6 |
Thin GEMM 性能(关键)
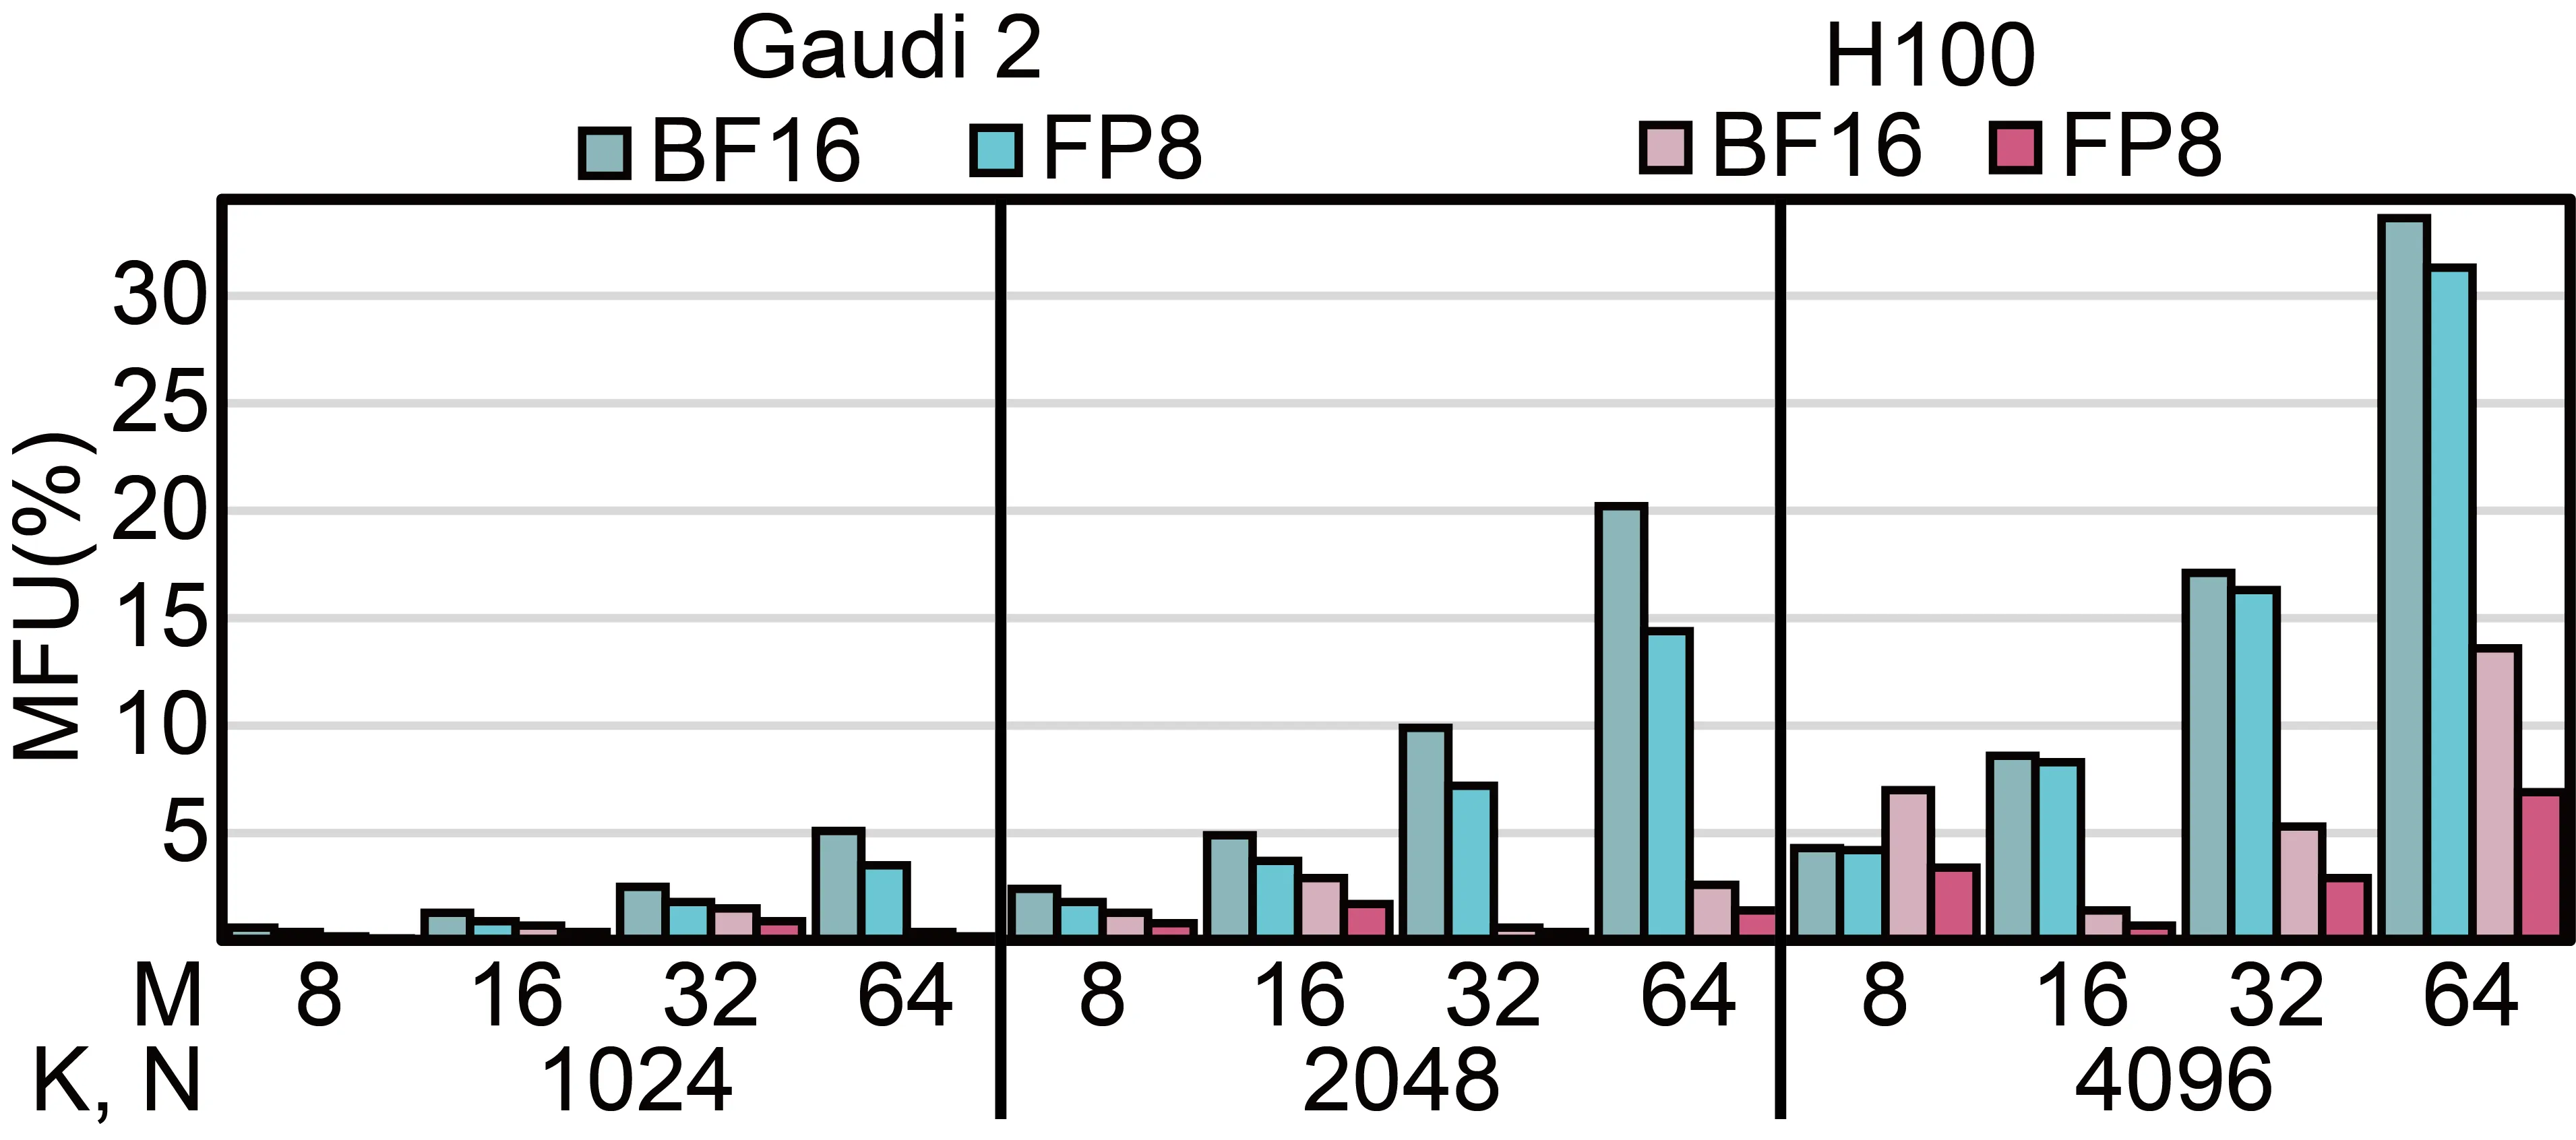
Figure 5: Gaudi 2 和 H100 在 BF16 和 FP8 下的 Thin GEMM MFU 对比
| Shape (M,K,N) | Gaudi 2 BF16 | Gaudi 2 FP8 | H100 BF16 | H100 FP8 |
|---|---|---|---|---|
| (8, 1024, 1024) | 3.3 | 3.8 | 1.7 | 1.7 |
| (16, 1024, 1024) | 6.5 | 11.4 | 3.4 | 3.9 |
| (32, 1024, 1024) | 12.8 | 23.8 | 6.5 | 7.0 |
| (64, 1024, 1024) | 26.7 | 54.0 | 12.6 | 14.9 |
| (8, 4096, 4096) | 18.8 | 35.4 | 14.4 | 16.8 |
| (64, 4096, 4096) | 144.5 | 253.4 | 133.3 | 133.9 |
关键发现: Gaudi 2 在 thin GEMM 上持续优于 H100,即使在 BF16 下也是如此。在 FP8 下优势更加明显。
Decode 阶段吞吐量
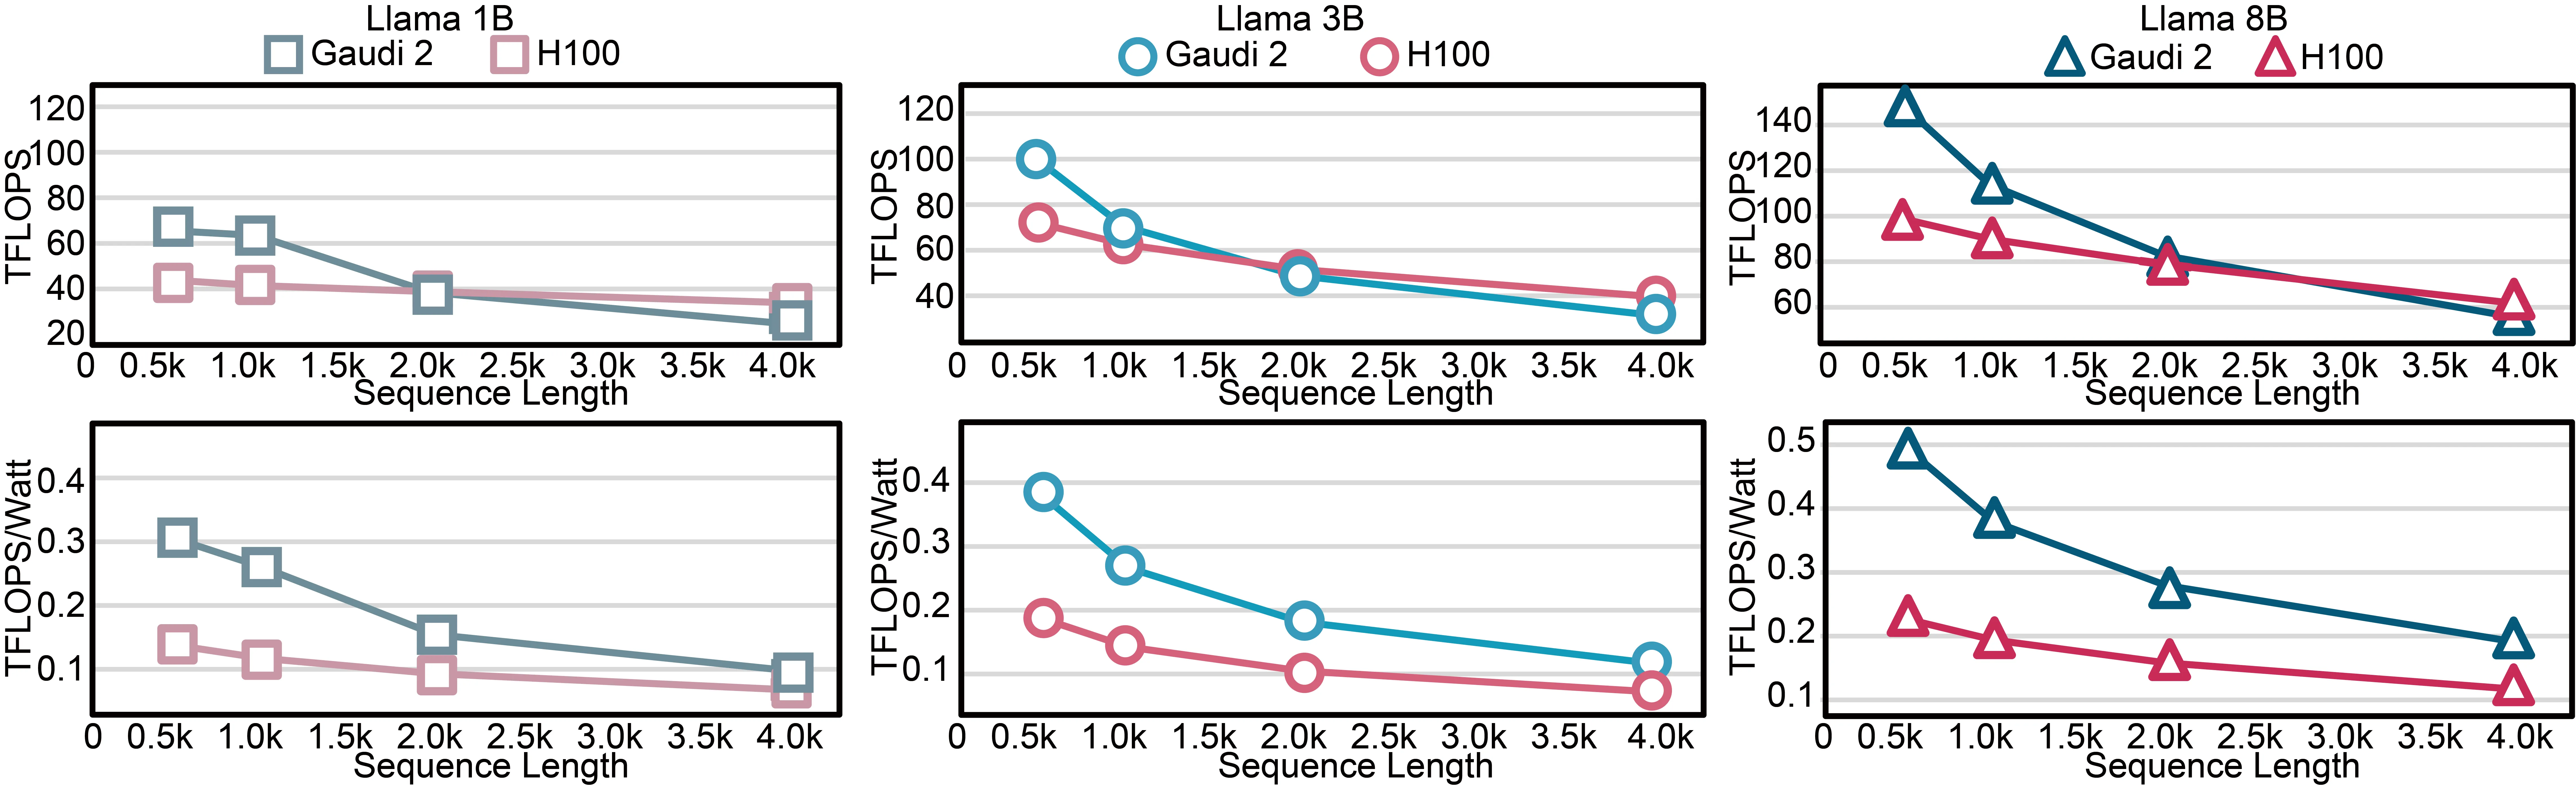
Figure 1: Gaudi 2 和 H100 在 FP8 decode 阶段的 TFLOPS 和 TFLOPS/Watt 对比
- 对于短序列,Gaudi 2 在绝对吞吐量和 TFLOPS/Watt 上均有优势
- 在长序列下,H100 由于更高的内存带宽实现更高 TFLOPS,但由于更高功耗能效较低
FP8 精度影响
数据类型和舍入模式
| 模型 | 数据类型 | 舍入 | MMLU |
|---|---|---|---|
| Llama v3.2 1B | BF16 | - | 46.3% |
| E4M3 | SR | 45.7% | |
| E4M3 | RTN | 45.5% | |
| E5M2 | RTN | 44.5% | |
| Llama v3.1 8B | BF16 | - | 68.8% |
| E4M3 | SR | 68.3% | |
| E4M3 | RTN | 68.3% | |
| E5M2 | RTN | 67.5% | |
| Llama v3.3 70B | BF16 | - | 82.0% |
| E4M3 | SR | 82.0% |
关键发现:
- E4M3 始终优于 E5M2
- 随机舍入对精度影响最小,甚至可能有害
- 动态缩放实现与 BF16 相当的精度,无需校准集
缩放策略对比
| 缩放方式 | Llama 1B MMLU | Llama 8B MMLU |
|---|---|---|
| BF16 | 68.8% | 68.8% |
| FP8 动态 | 68.3% | 68.3% |
| FP8 静态 | 66.3% | 66.3% |
Prefill Roofline 分析
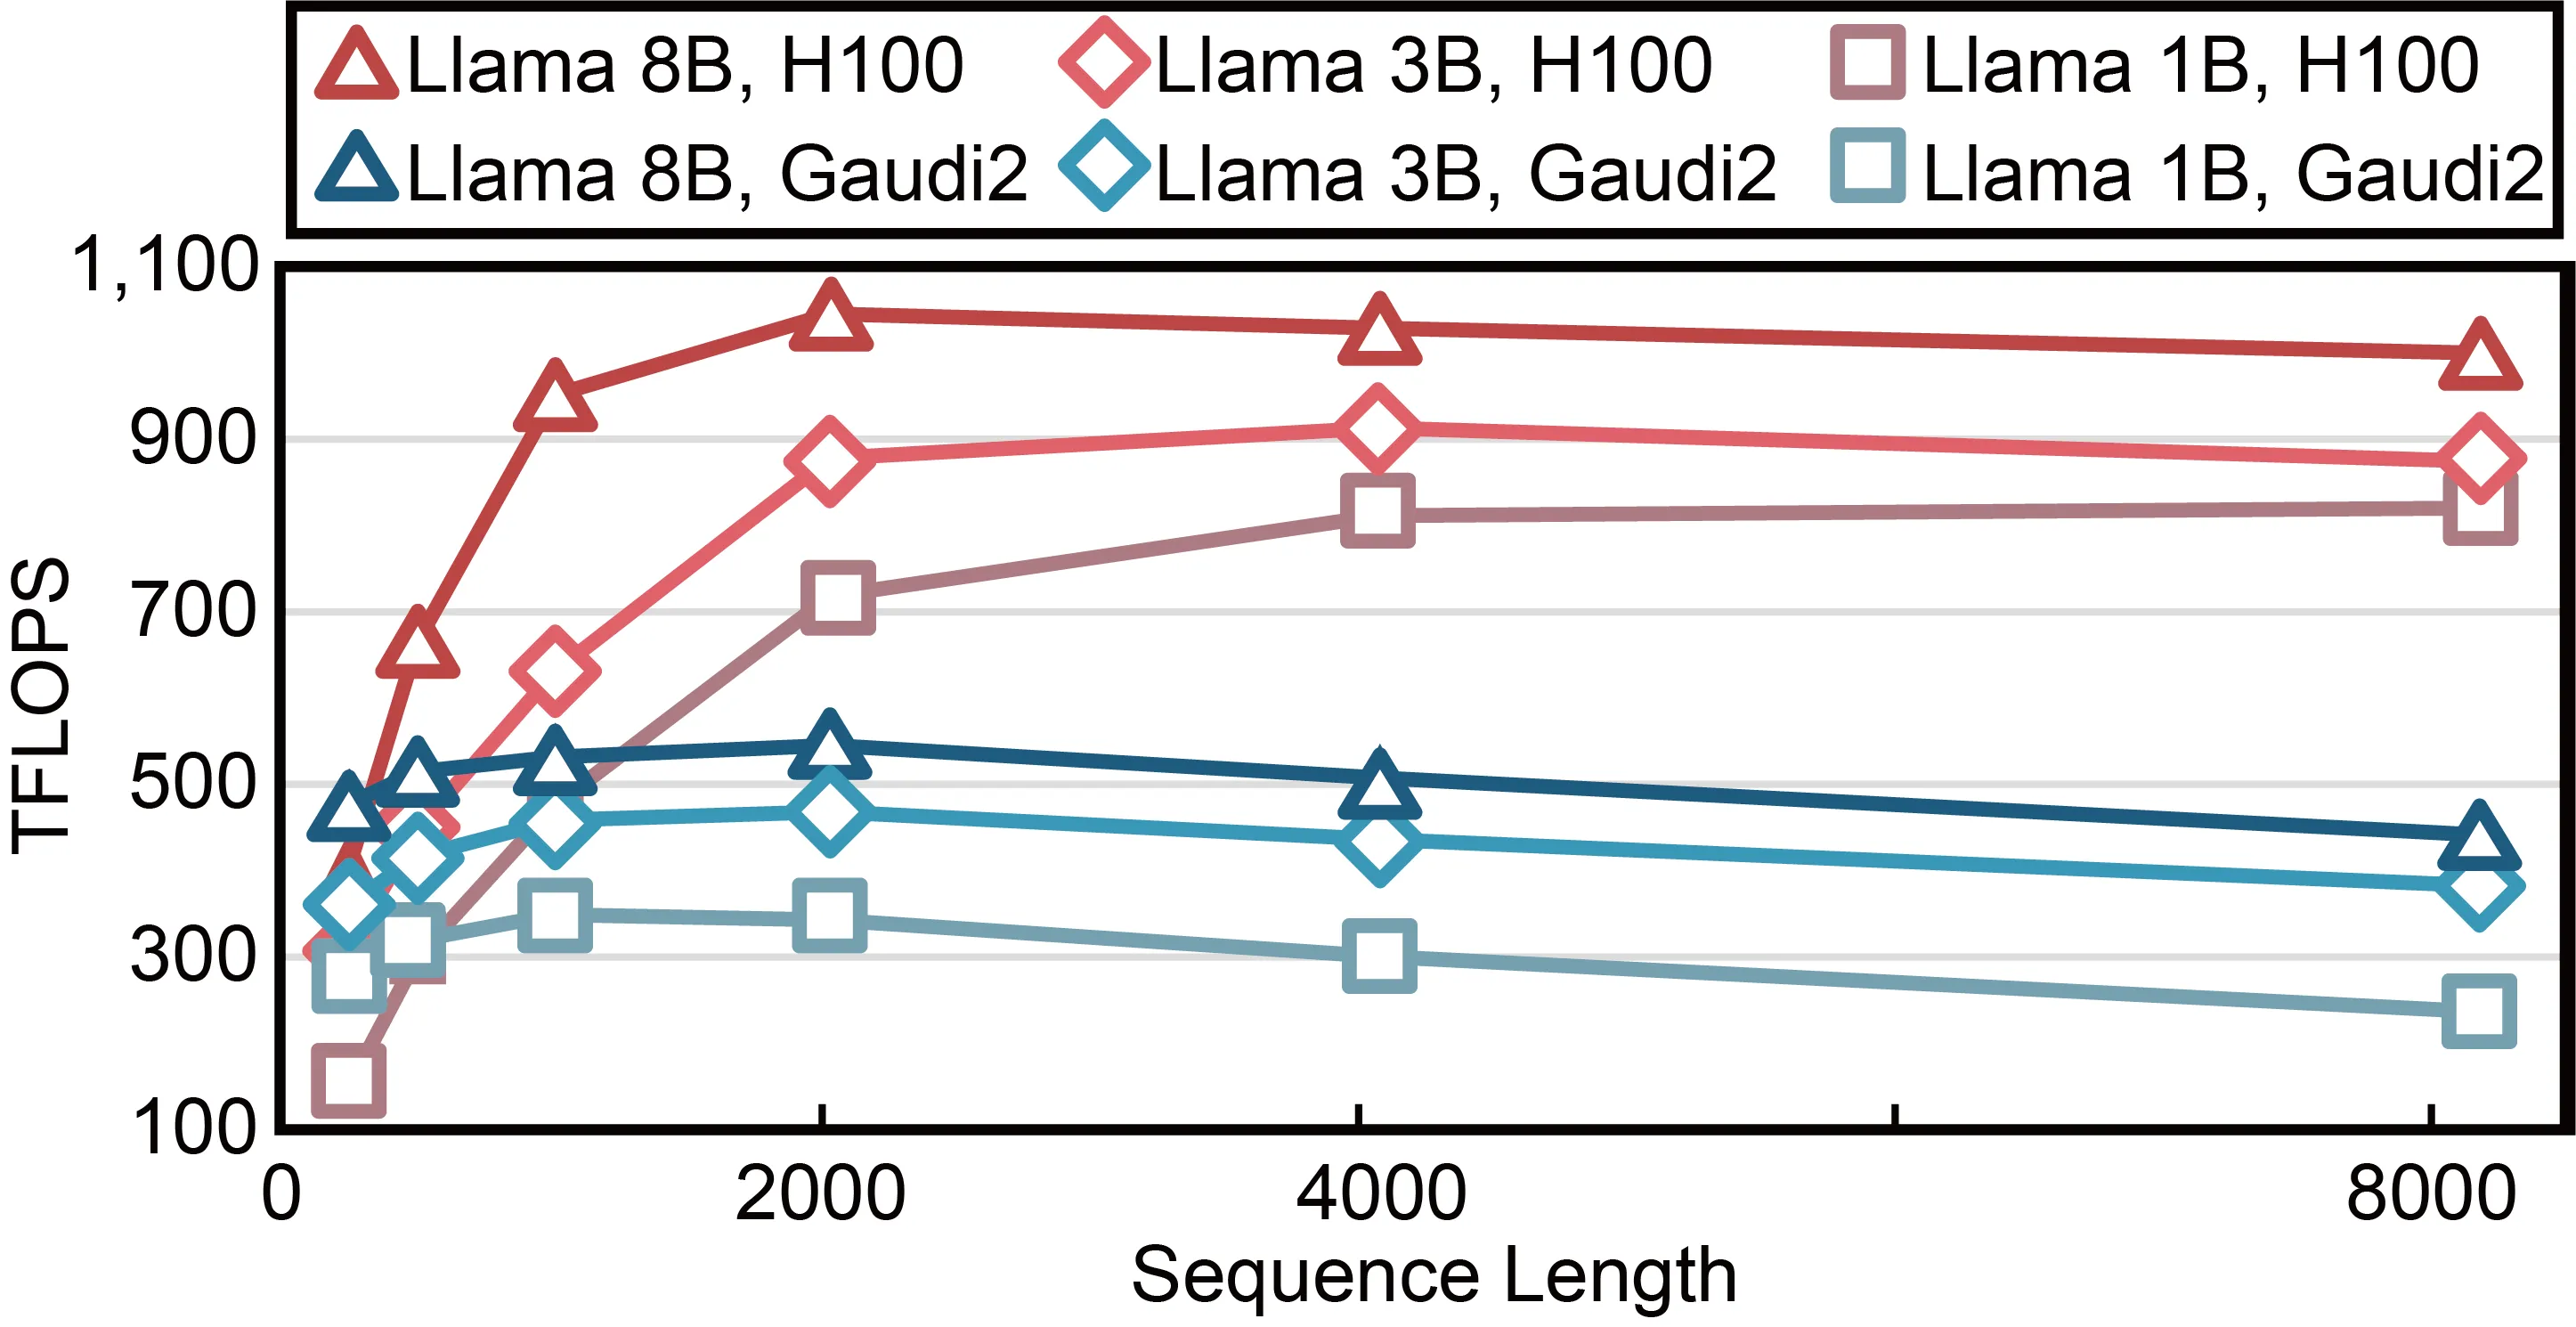
Figure 3: Prefill 阶段的 Roofline 图(batch size 1)
- 吞吐量随序列长度增加而提高
- 当注意力计算占比增加时开始下降(注意力比 GEMM 慢)
静态 vs 动态缩放
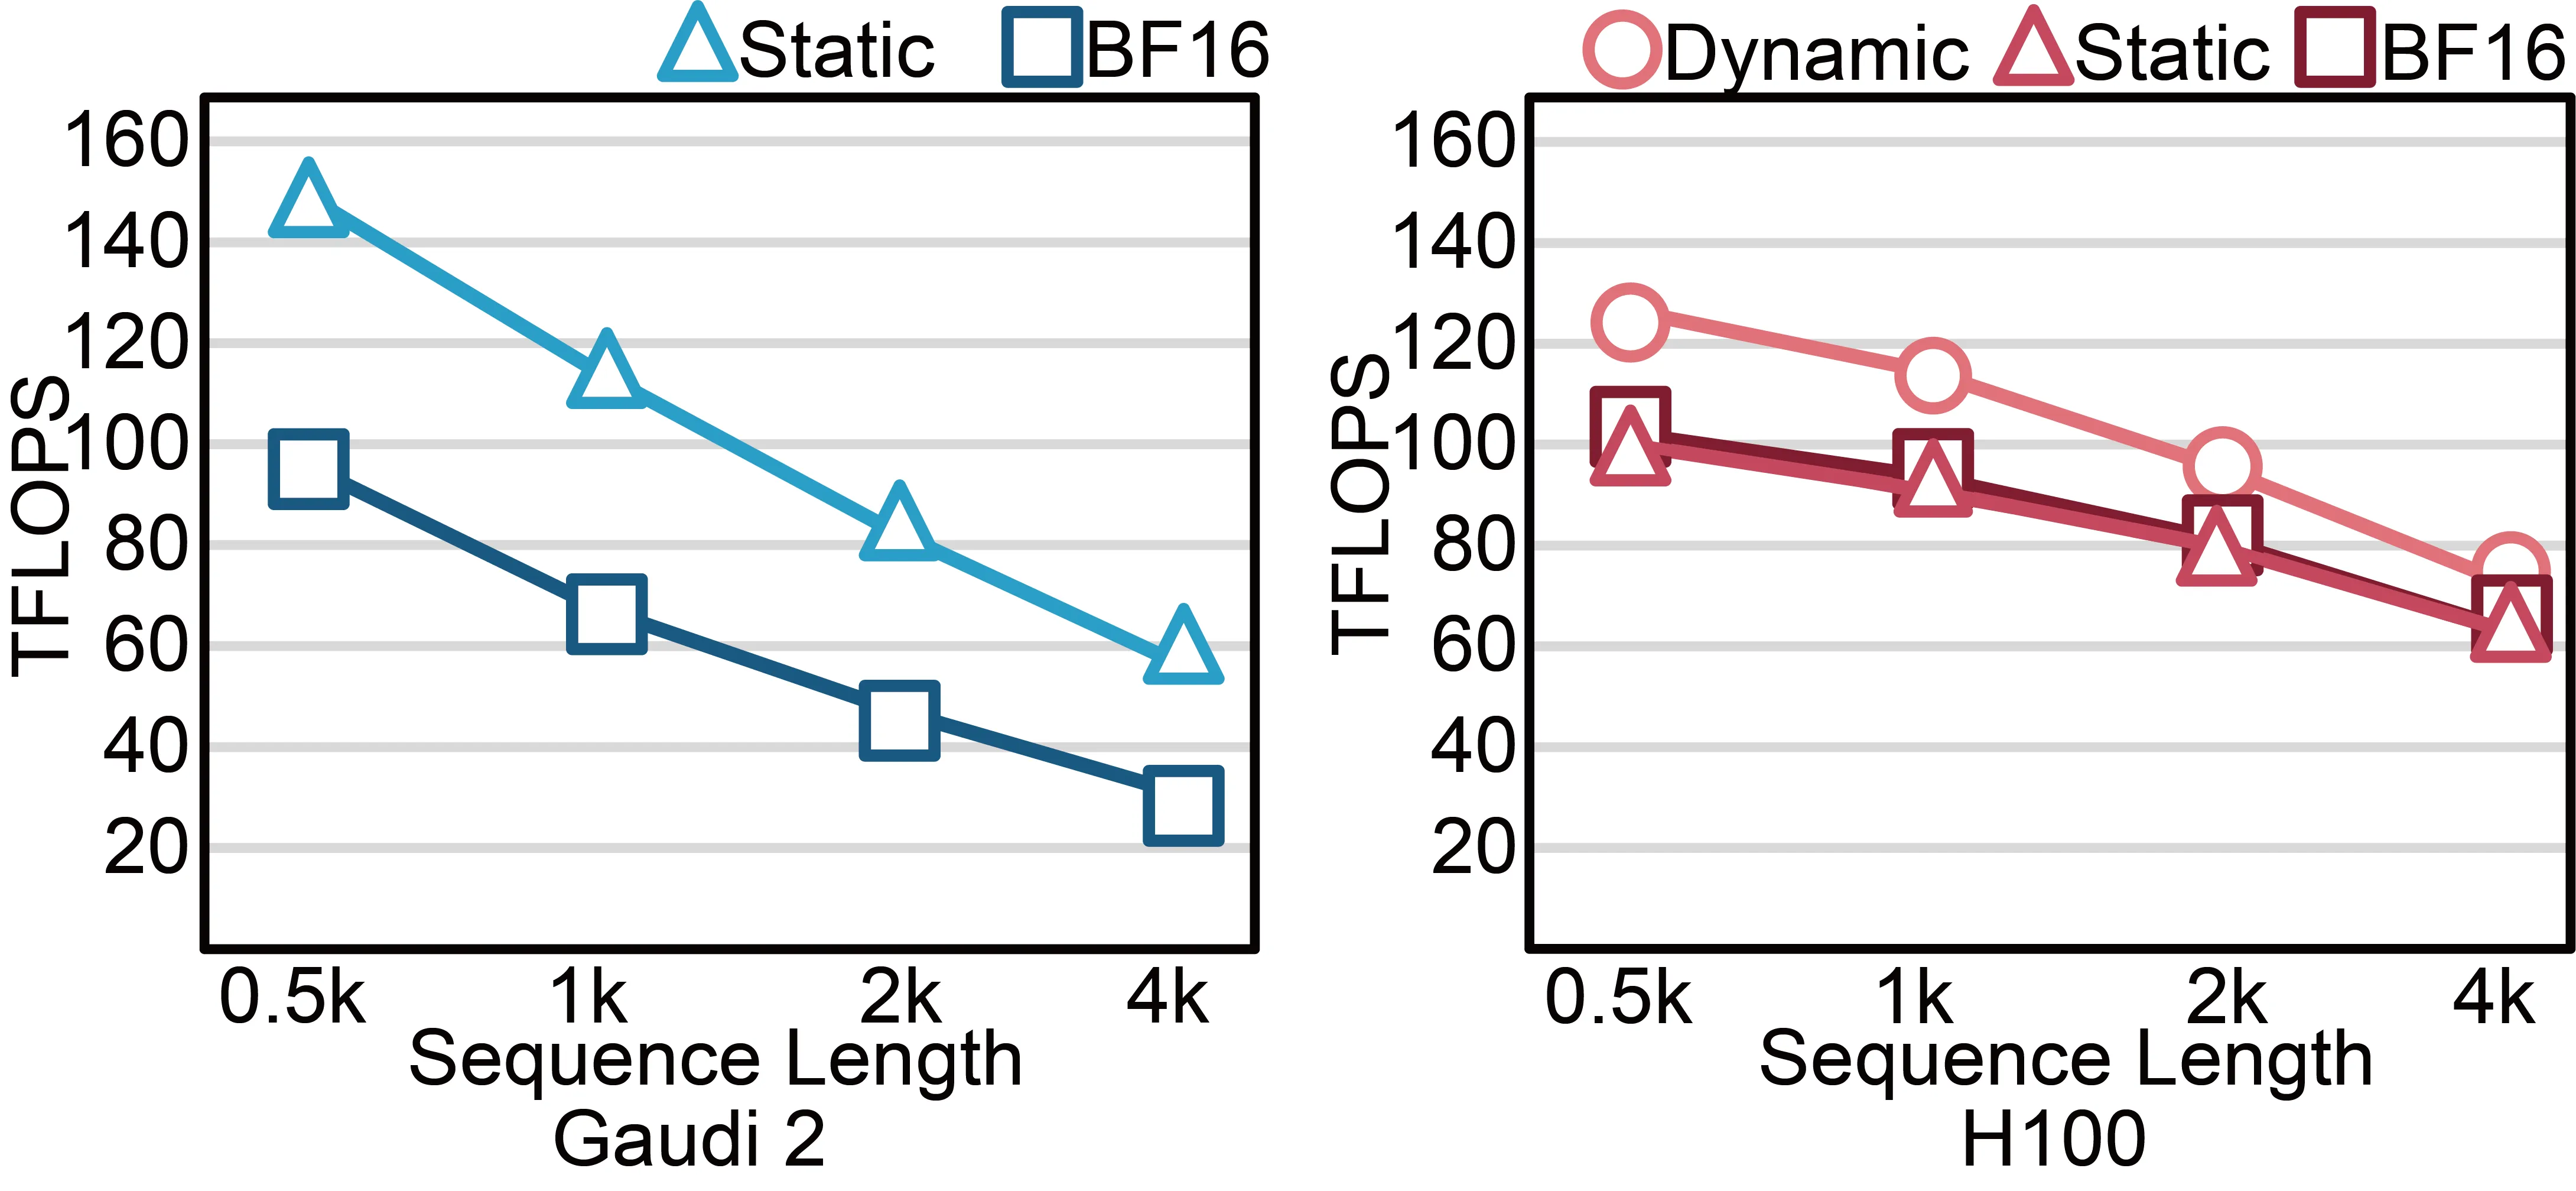
Figure 4: BF16 和 FP8 在 Llama v3.1 8B 上的 decode 吞吐量对比
- Gaudi 2: FP8 vs BF16 差异 ≥ 50%
- H100: FP8 vs BF16 差异 < 25%
- 动态缩放尽管开销更大,但吞吐量更高(因为行级 GEMM 对小矩阵更快)
六、TCO 分析框架
关键因素
- 功耗: 数据中心级别的功耗约束
- 吞吐量: 实际工作负载下的 TFLOPS
- 精度: FP8 量化对模型质量的影响
- 利用率: Thin GEMM 的实际 MFU
TCO 公式
其中 Quality Factor 考虑 FP8 量化带来的精度损失。
加速器对比总结
| 维度 | Gaudi 2 | H100 |
|---|---|---|
| Thin GEMM FP8 | 优秀(高 MFU) | 一般(低 MFU) |
| 方阵 GEMM | 中等 | 优秀 |
| 功耗 | 600W TDP | 700W TDP |
| 内存带宽 | 较低 | 较高 |
| 软件生态 | 有限 | 成熟 |
| FP8 累加精度 | FP32 | 14-bit |
七、总结
核心贡献
- 提出从 TCO 角度评估 AI 加速器的通用框架
- 揭示 thin GEMM 吞吐量对 TCO 的影响大于理论峰值
- 证明 Gaudi HPU 在 thin GEMM(特别是 FP8)上优于 H100
- 全面分析 FP8 量化策略(数据类型、舍入、缩放)对精度的影响
- 强调实证工作负载分析的重要性
技术影响
- 部署决策: 在选择加速器时应考虑实际工作负载特性而非仅看理论规格
- 量化策略: E4M3 + 动态行级缩放是最佳选择
- 架构设计: Thin GEMM 优化对 LLM decode 性能至关重要
局限性
- Gaudi 软件支持有限(缺少内核融合、分页注意力支持不完善)
- 无法测试 Gaudi 3 的改进
- 缺少 KV cache 量化支持
- 仅测试 Llama 系列模型
八、参考资源
- 论文: arXiv:2502.01070
- PDF: arXiv PDF
- HTML: arXiv HTML
- 相关工作: DeepSeek-AI (2024), Micikevicius et al. (2022), Kalamkar et al. (2019)