Robust Representation Consistency Model via Contrastive Denoising
rRCM reformulates generative denoising as discriminative latent-space learning for certified robustness with 85× speedup
Robust Representation Consistency Model via Contrastive Denoising
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Robust Representation Consistency Model via Contrastive Denoising |
| 作者 | Jiachen Lei, Julius Berner, Jiongxiao Wang, Zhongzhu Chen, Zhongjia Ba, Kui Ren, Jun Zhu, Anima Anandkumar |
| 机构 | Tsinghua University, NVIDIA Research, Caltech |
| 论文 | https://arxiv.org/abs/2501.13094 |
| 代码 | https://github.com/jiachenlei/rRCM |
| 发布 | 2025-01-22 (v1), 2025-06-30 (v2) |
| 许可 | CC BY-SA 4.0 |
二、核心思想
问题定义
深度神经网络的对抗脆弱性在安全敏感应用中是一个关键问题。随机平滑(Randomized Smoothing) 是提供对抗扰动认证鲁棒性的黄金标准。
近期基于扩散模型的随机平滑方法(如 DDS, DensePure, DiffSmooth)在小扰动半径下表现优异,但面临两个核心问题:
- 大扰动半径下性能急剧下降:当对抗扰动增大时,扩散去噪效果不足以恢复干净样本
- 推理成本极高:扩散模型需要数百甚至数千次迭代采样,单个样本推理时间长达 3-52 分钟
相比之下,经典随机平滑方法速度快但认证鲁棒性较弱。
解决方案概述
本文提出 rRCM(Robust Representation Consistency Model)——一种将生成式建模任务reformulate为判别式潜空间学习的新范式。
核心洞察:扩散模型在 PF ODE 轨迹上天然建立了干净样本与扰动样本之间的联系。干净样本是轨迹的初始点,扰动样本只是同一轨迹上不同时间步的点。因此,同一轨迹上的点共享相同的潜在表示(由初始干净点 x₀ 定义)。
rRCM 通过实例鉴别在轨迹上对齐相邻点的表示,使得模型能够在一个单次前向传播中隐式完成”去噪+分类”,将推理成本降低 85×,同时在 ImageNet 上超越扩散方法 5.3%(平均),大扰动半径下提升达 11.6%。
三、技术架构
整体框架图
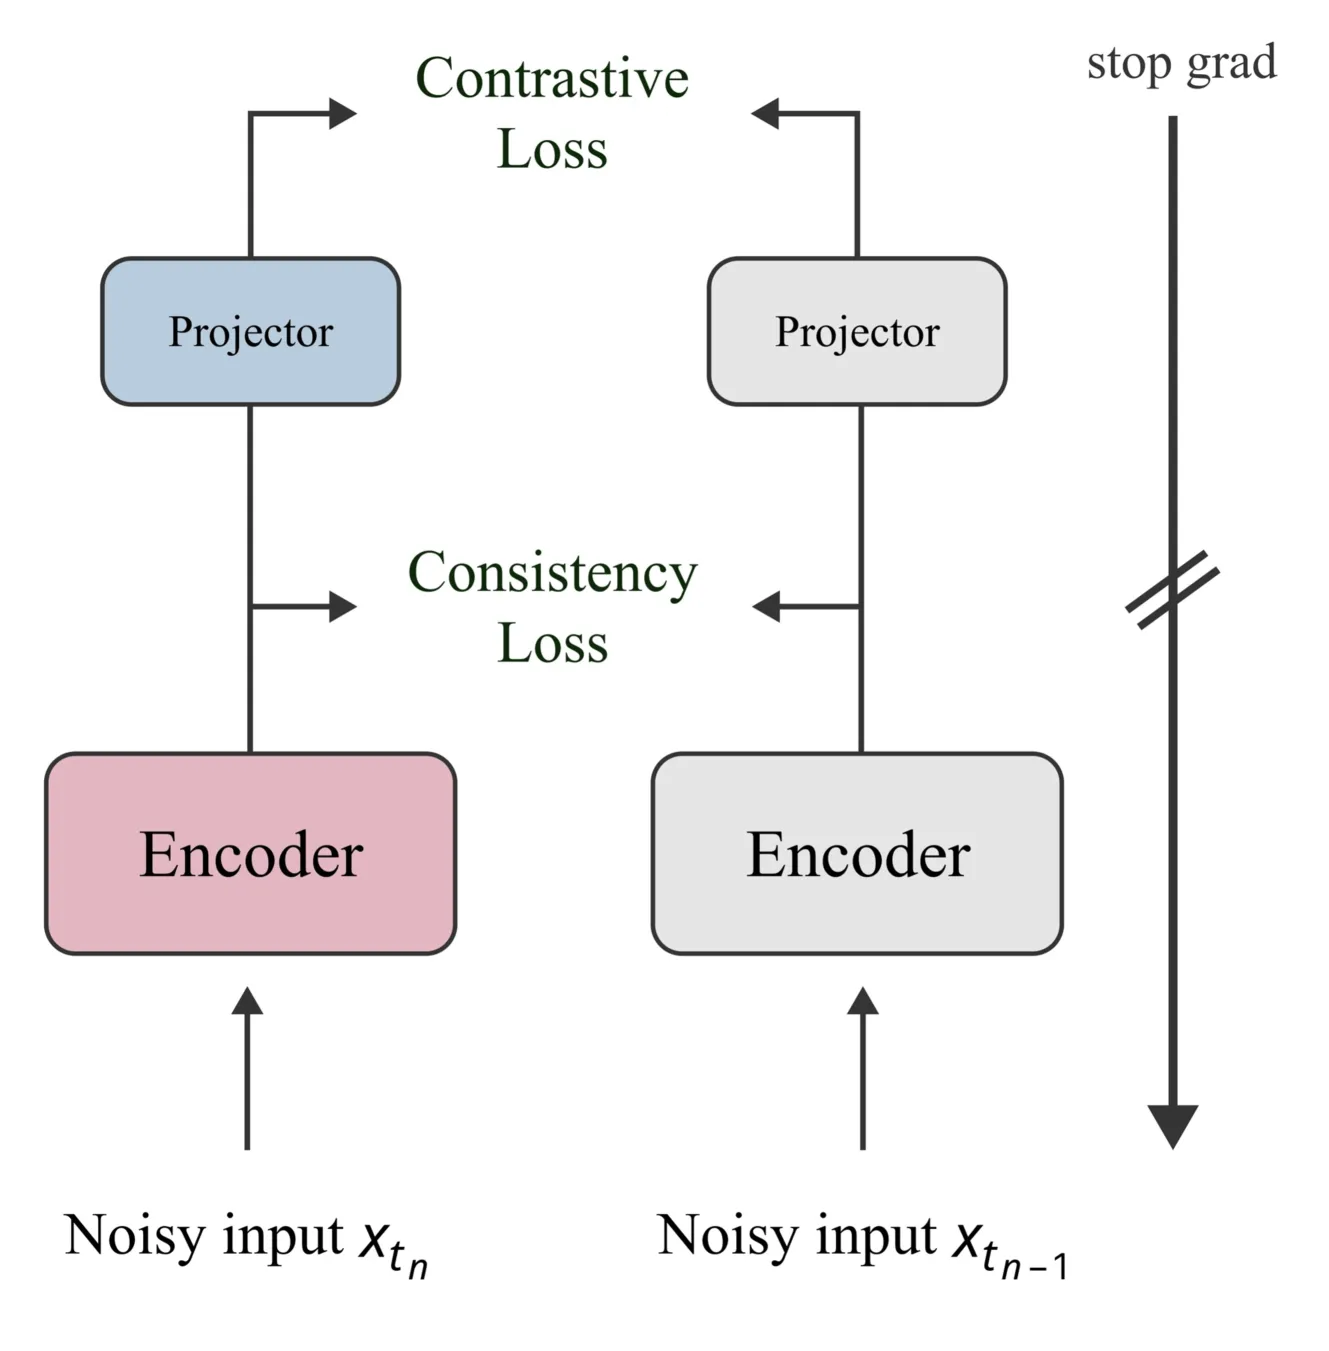
rRCM 的核心思想对比:
┌─────────────────────────────────────────────────────────────────┐
│  Prior Diffusion-based Methods          │  rRCM (Ours)          │
│                                         │                         │
│  Two Independent Models:                │  Single Unified Model:  │
│                                         │                         │
│  x_t ─→ [Denoiser] ─→ x_clean ─→ [Classifier] ─→ y            │
│           (generative)      (discriminative)                     │
│           ~1000 steps                     single forward pass    │
│                                         │                         │
│  Problem:                               │  Key Idea:              │
│  - High inference cost                  - Align representations   │
│  - Degraded at large radii              - Implicit denoise+classify│
└─────────────────────────────────────────────────────────────────┘
两阶段训练策略
┌──────────────────────────────────────────────────────────────────┐
│  Stage 1: Pre-training (Contrastive Denoising)                   │
│  ┌────────────────────────────────────────────────────────────┐ │
│  │  PF ODE Trajectory Sampling:                               │ │
│  │  x₀ ──(ODE)──→ x_{t₁} ──→ x_{t₂} ──→ ... ──→ x_{tₙ}      │ │
│  │                                                          │ │
│  │  InfoNCE Loss:                                             │ │
│  │  • Attract: f̂(x_{t_n}) · f̂(x_{t_{n-1}}) for same traj    │ │
│  │  • Repel: different trajectories                           │ │
│  │                                                          │ │
│  │  f_φ = h_w ∘ g_θ  (encoder + projection head)             │ │
│  └────────────────────────────────────────────────────────────┘ │
│                    ↓                                            │
│  ┌────────────────────────────────────────────────────────────┐ │
│  │  Result: Trajectory-aligned representations                 │ │
│  │  Same trajectory → same latent representation               │ │
│  └────────────────────────────────────────────────────────────┘ │
│                    ↓                                            │
│  Stage 2: Fine-tuning (Supervised)                              │
│  ┌────────────────────────────────────────────────────────────┐ │
│  │  • Discard projection head h_w                               │ │
│  │  • Add linear classification head                            │ │
│  │  • Enforce consistent predictions on perturbed samples       │ │
│  │    of same noise magnitude                                   │ │
│  └────────────────────────────────────────────────────────────┘ │
└──────────────────────────────────────────────────────────────────┘
核心公式
表示对齐优化目标:
其中 是软模型输出的归一化表示, 和 是 PF ODE 轨迹上相邻时间步的点。
模型参数化:
其中 是神经网络编码器, 是线性投影头。
预训练损失(InfoNCE 风格):
其中 是同轨迹的相邻时间步样本(positive), 是不同轨迹的样本(negative)。
模型架构
| 变体 | 参数量 | 说明 |
|---|---|---|
| rRCM-S | Small | 小型 ViT 变体 |
| rRCM-B | Base | 基础 ViT 变体 |
| rRCM-B-Deep | Base (Deep) | 深层 ViT 变体 |
所有模型使用 Vision Transformer (ViT) 架构。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 生成→判别 reformulation | 将像素空间生成式去噪reformulate为潜空间判别式表示学习 | PF ODE 轨迹上的点共享同一潜在表示 |
| 轨迹对齐预训练 | 利用实例鉴别对齐相邻时间步的表示 | InfoNCE loss 吸引同轨迹点、排斥异轨迹点 |
| 隐式去噪+分类 | 单次前向传播完成,无需迭代采样 | 推理成本降低 85× |
| 结构化噪声调度 | 首次利用结构化噪声调度训练随机平滑模型 | 比随机高斯噪声更能利用扩散轨迹的语义一致性 |
| 可扩展性 | 模型规模和训练批次增加均带来性能提升 | ImageNet 上 scaling law 验证 |
五、代码实现分析
GitHub: https://github.com/jiachenlei/rRCM
rRCM 的关键实现:
- 基于 ViT 架构,使用 PF ODE 采样生成轨迹数据
- 预训练阶段使用 InfoNCE 对比损失对齐轨迹表示
- 微调阶段丢弃投影头,添加线性分类头
- 认证遵循 Carlini et al. (2022) 标准:500 测试图像,99.9% 置信度
六、实验结果
基准测试
ImageNet 认证鲁棒性对比(Carlini et al. 2022 协议):
| 方法 | r=0.25 | r=0.5 | r=1.0 | 推理延迟 |
|---|---|---|---|---|
| rRCM-B (10K noises) | — | 63.0% | — | 6 秒 |
| rRCM-B-Deep (10K noises) | — | 64.0% | — | 1 分 41 秒 |
| DiffSmooth (m=15) | — | 62.2% | — | ~30 分钟 |
| DensePure (K=5) | — | 64.6% | — | ~30 分钟 |
| 经典 RS (Gaussian) | 较弱 | 较弱 | 较弱 | <1 秒 |
关键数字:
- rRCM-B 在 r=0.5 时达到 63.0% 认证准确率,延迟仅 6 秒
- 相比扩散方法(DiffSmooth/DensePure)延迟降低 ~5×
- 在所有扰动半径上平均超越扩散方法 5.3%
- 大扰动半径下提升达 11.6%
- 推理成本平均降低 85×
性能-延迟权衡
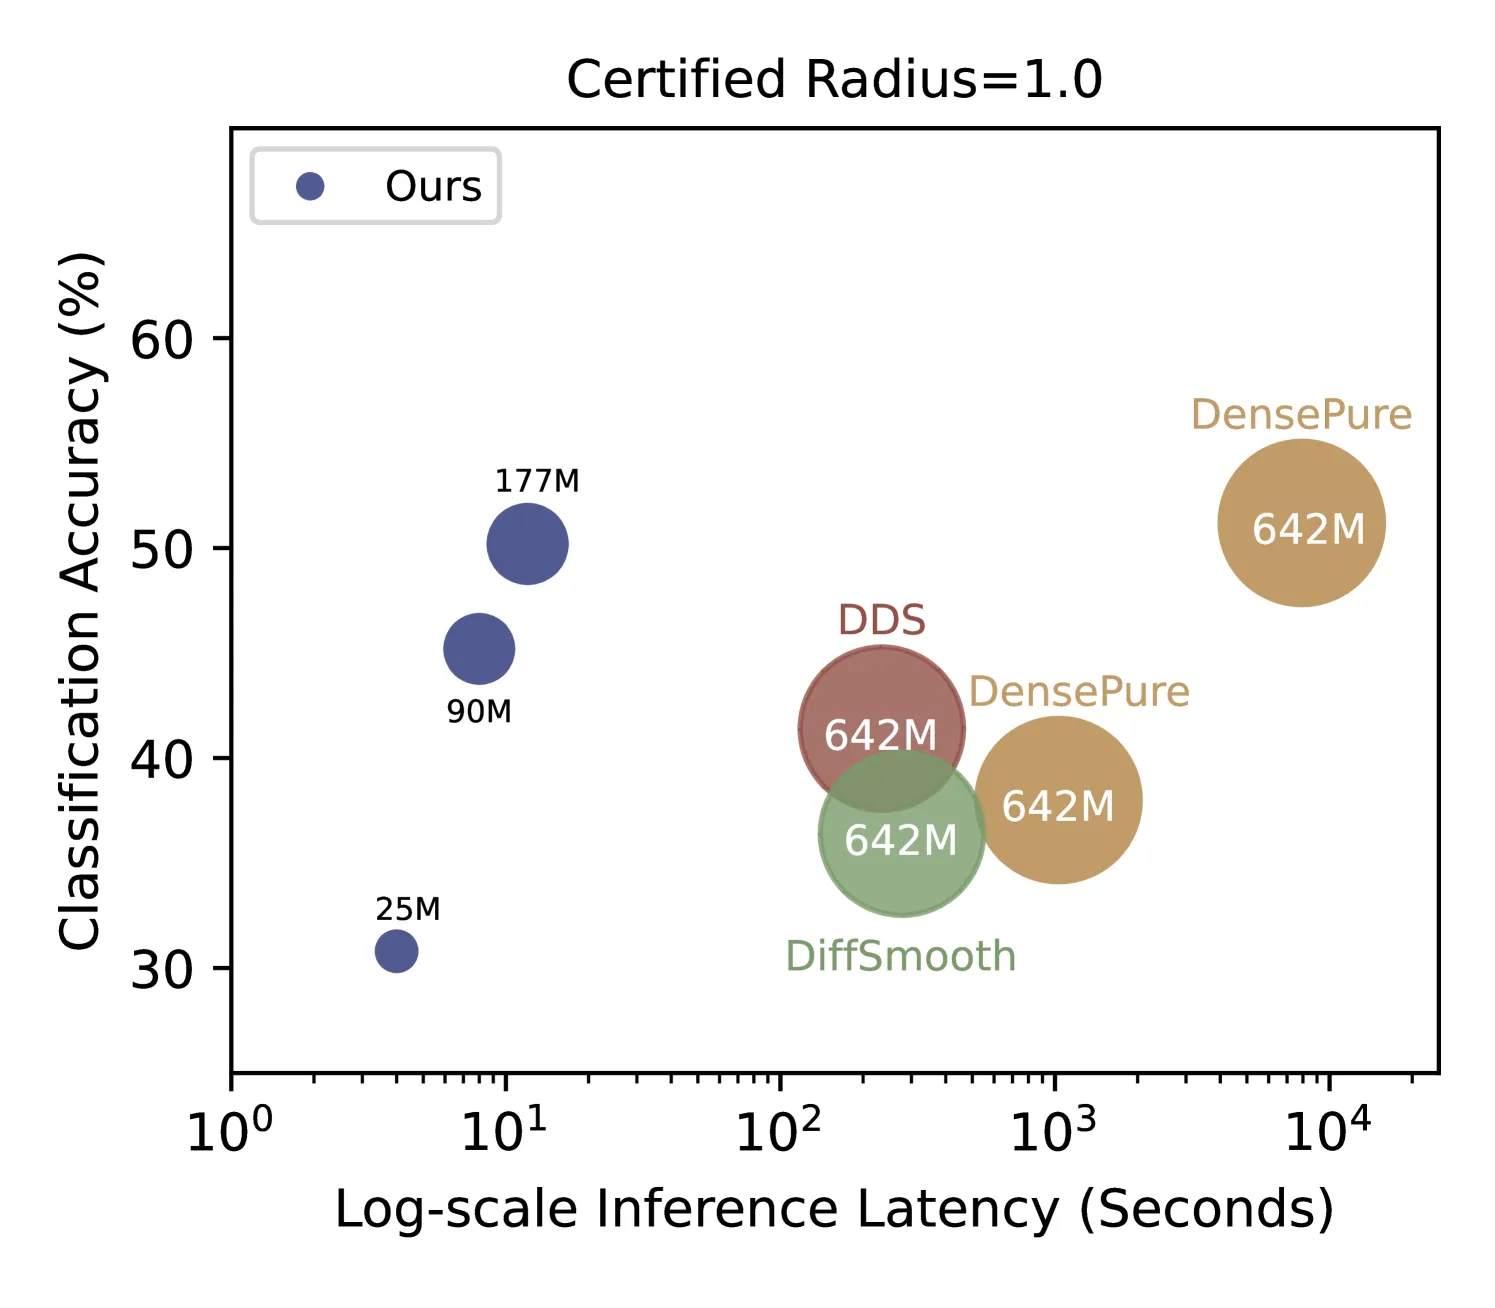
rRCM 在性能-延迟 Pareto 前沿上显著优于所有基线方法,特别是在高延迟区域(扩散方法聚集区)实现了更好的权衡。
CIFAR10 结果
CIFAR10 上观察到类似的优越模式,rRCM 在所有噪声水平下均超越扩散基线。
可扩展性
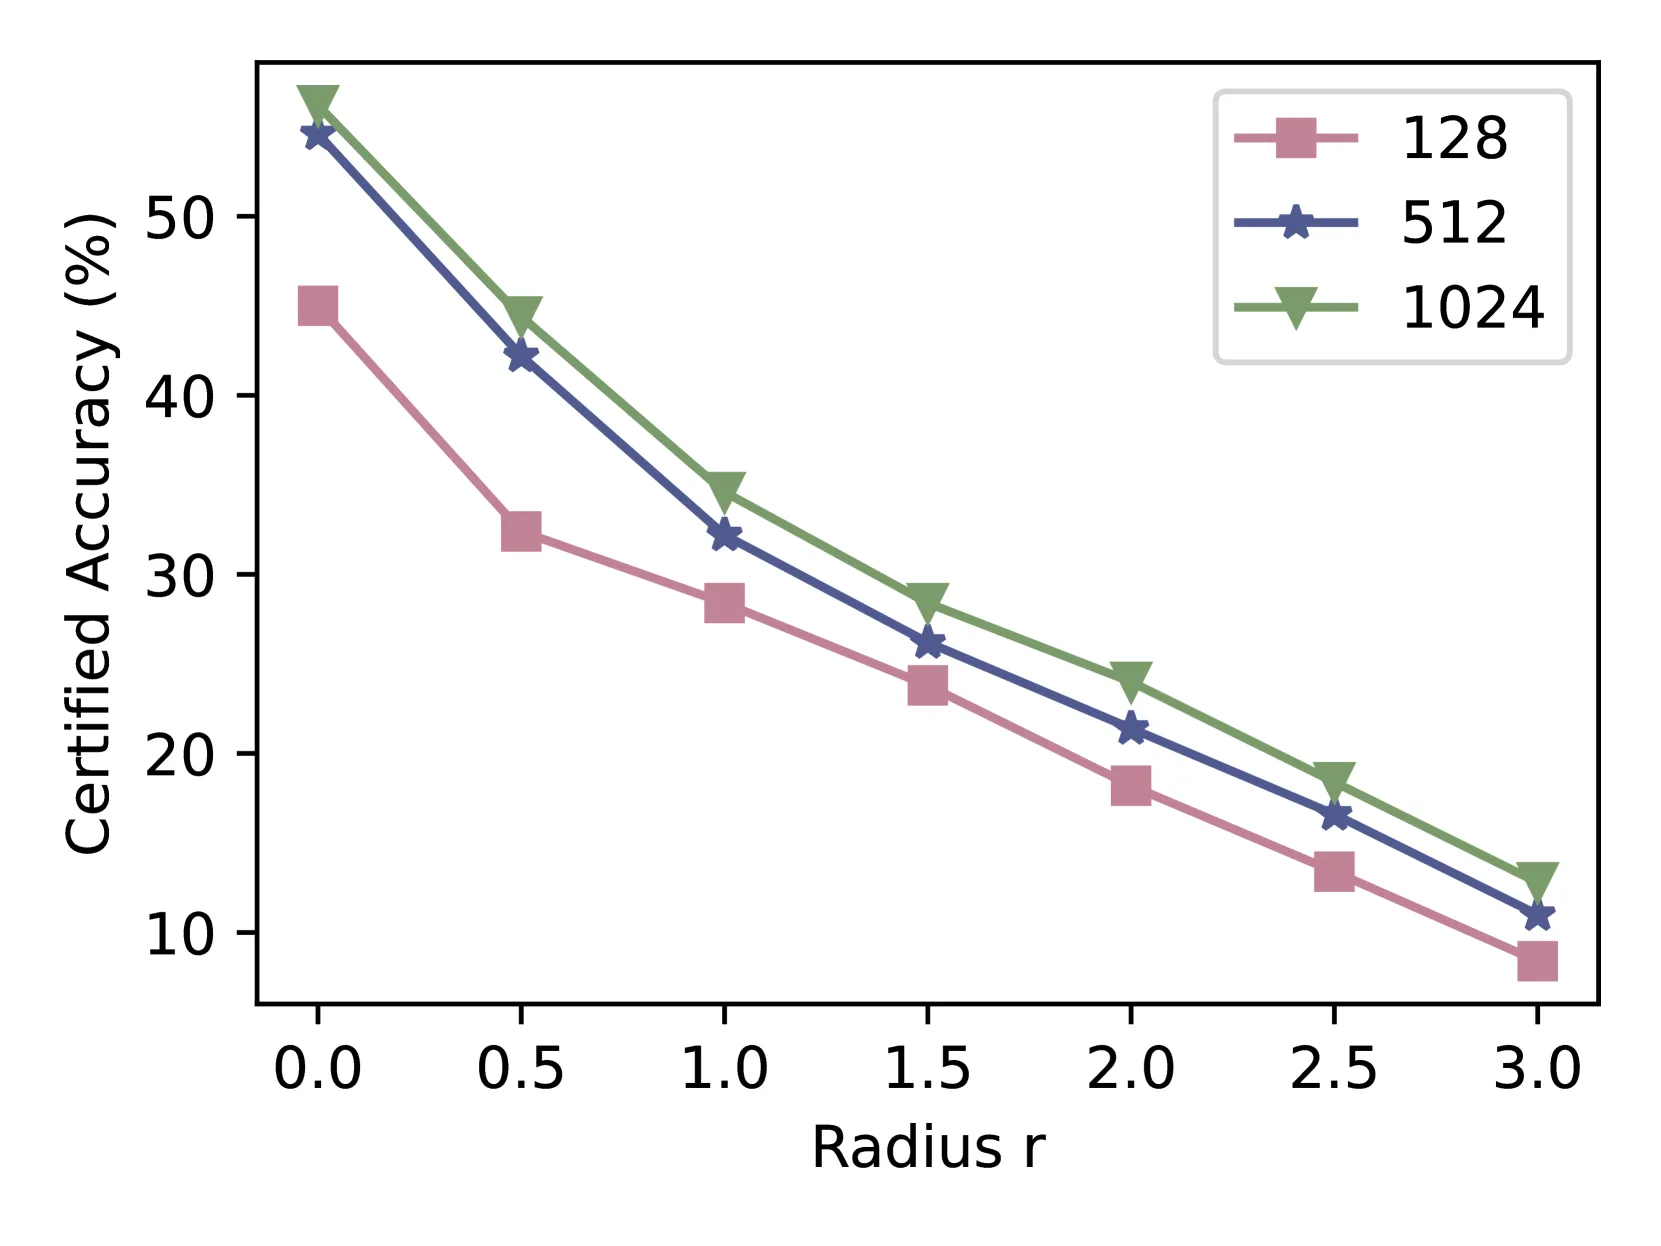
- 模型规模:增大模型尺寸持续提升 ImageNet 性能
- 训练批次:增加训练批次规模也带来性能提升
- 方法在模型容量和训练吞吐量上均表现出良好的 scaling 特性
与一致性模型(Consistency Models)的区别
| 维度 | 一致性模型 | rRCM |
|---|---|---|
| 学习目标 | 一致的图像预测 | 一致的潜表示 |
| 边界条件 | 静态(干净图像) | 动态(学习到的低维初始点) |
| 训练方式 | 近似 PF ODE 解析解 | 对比实例鉴别 |
| 推理 | 少步扩散采样 | 单次前向传播 |
七、相关工作
- 认证鲁棒性:随机平滑是黄金标准(Monteiro et al., Carlini et al.)
- 对比学习:MoCo-v3, SimCLR, MoCo-v2 通过匹配增强视图学习视觉表示
- 一致性模型:Song et al. (2023) 近似 PF ODE 解析解,但目标是图像级一致性
- 扩散平滑:DDS, DensePure, DiffSmooth 将扩散模型用于随机平滑
八、总结
核心贡献
- rRCM 框架:首次将生成式去噪 reformulate 为判别式表示学习
- PF ODE 轨迹对齐:利用扩散轨迹的结构化特性进行对比预训练
- 单次前向传播:隐式去噪+分类,推理成本降低 85×
- ImageNet SOTA:超越扩散方法 5.3%(平均),大扰动下 11.6%
- 可扩展性验证:模型规模和训练批次的 scaling 规律
技术影响
- 证明了扩散模型的 PF ODE 轨迹可以用于判别式任务,不限于生成
- 为认证鲁棒性提供了高效替代方案,消除了扩散模型的高推理成本
- 打开了一条新路径:利用生成模型的内在结构改进判别学习任务
局限性
- 当前仅在 ImageNet 和 CIFAR10 上验证,未扩展到更大规模数据集
- 预训练需要 PF ODE 轨迹采样,增加了训练复杂度
- 与大扰动半径下的极端情况相比仍有提升空间
九、参考资源
- arXiv: https://arxiv.org/abs/2501.13094
- GitHub: https://github.com/jiachenlei/rRCM
- License: CC BY-SA 4.0
- 评估硬件: A800 GPU (推理延迟测量)
- 评估协议: Carlini et al. (2022), 500 测试图像, 99.9% 置信度
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 性能 vs 推理延迟对比 | performance-latency.png |
| Figure 2 | 预训练方法与模型前向传播 | method-overview.png |
| Figure 5 | 对比学习、一致性模型与 rRCM 训练对比 | training-comparison.png |