InternVideo2.5: Empowering Video MLLMs with Long and Rich Context Modeling
通过长和丰富上下文(LRC)建模,增强视频多模态大语言模型的细粒度细节感知和长时序结构捕获能力
InternVideo2.5: Empowering Video MLLMs with Long and Rich Context Modeling
论文信息: arXiv:2501.12386 [cs.CV] 21 Jan 2025
机构: 上海 AI 实验室、南京大学、深圳先进院
模型规模: 7B/8B 参数
开源地址: https://github.com/OpenGVLab/InternVideo/tree/main/InternVideo2.5
一、论文概述
1.1 研究背景
视频多模态大语言模型(MLLM)在视频理解领域取得了显著进展,但仍面临两大核心挑战:长视频理解和细粒度细节感知。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 长视频理解 | 现有模型难以处理超过 1000 帧的长视频,记忆能力有限 |
| 细粒度感知 | 模型在识别、定位和回忆物体、场景和运动方面表现不佳 |
| 上下文建模 | 视觉上下文的长度和精细度不足,影响理解和推理性能 |
| 计算效率 | 处理长视频时计算成本高,容易出现 OOM 错误 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| LRC 建模 | 长和丰富上下文(Long and Rich Context)建模方法 |
| DPO 集成 | 通过直接偏好优化将密集视觉任务标注集成到 MLLM |
| HiCo 压缩 | 自适应层次化 token 压缩,实现紧凑时空表示 |
| 长视频支持 | 支持 6x 更长的视频输入(至少 3,000 帧) |
| 专业视觉能力 | 增强目标跟踪、分割等专业视觉任务能力 |
| 开源模型 | 提供 7B 和 8B 参数版本 |
1.3 一句话总结
InternVideo2.5 通过长和丰富上下文(LRC)建模,增强了视频 MLLM 的细粒度细节感知和长时序结构捕获能力,在主流视频理解基准上达到 SOTA 性能。
二、核心思想
2.1 设计原则
┌─────────────────────────────────────────────────────────────────┐
│                    InternVideo2.5 设计原则                       │
├─────────────────────────────────────────────────────────────────┤
│  1. 长上下文建模 (Long Context Modeling)                         │
│     • 支持 6x 更长的视频输入                                     │
│     • 至少 3,000 帧的视频理解                                   │
│     • 自适应层次化 token 压缩 (HiCo)                             │
│                                                                 │
│  2. 丰富上下文建模 (Rich Context Modeling)                       │
│     • 通过 DPO 集成密集视觉任务标注                              │
│     • 细粒度细节感知能力                                        │
│     • 专业视觉任务(跟踪、分割)                                │
│                                                                 │
│  3. 效率优化 (Efficiency Optimization)                           │
│     • HiCo 层次化 token 压缩                                    │
│     • 紧凑时空表示                                              │
│     • 避免 OOM 错误                                             │
│                                                                 │
│  4. 开源生态 (Open Source Ecosystem)                             │
│     • 提供 7B 和 8B 参数版本                                    │
│     • 完整代码和模型                                            │
│     • 易于研究和应用                                            │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | InternVideo2.5 解决方案 |
|---|---|---|
| 长视频记忆 | 模型无法处理超过 1000 帧 | HiCo 压缩 + 长视频训练 |
| 细粒度感知 | 难以识别物体、场景、运动 | DPO 集成密集视觉标注 |
| 计算效率 | 长视频处理导致 OOM | 自适应层次化 token 压缩 |
| 上下文丰富度 | 视觉上下文长度和精细度不足 | LRC 建模方法 |
三、技术架构
3.1 整体架构
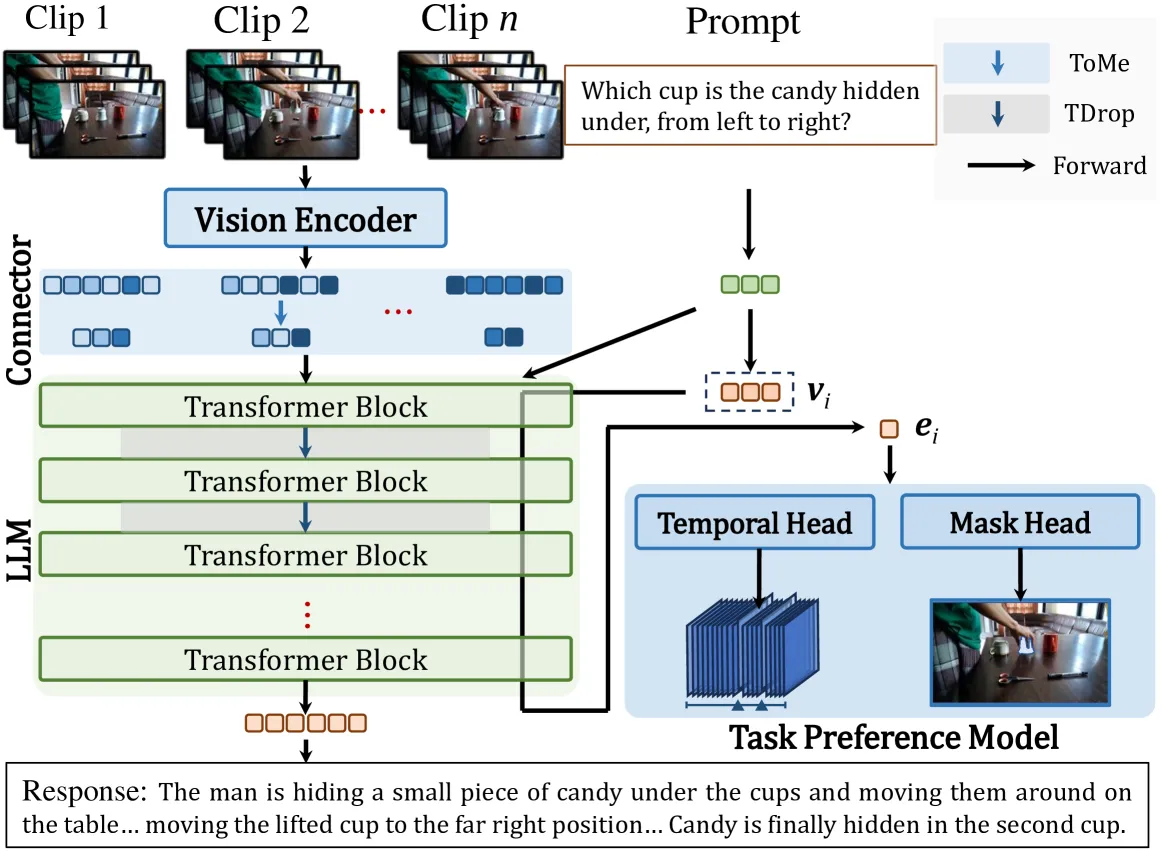 图 2:InternVideo2.5 的长和丰富上下文(LRC)建模框架。
核心组件:
| 组件 | 说明 | 关键特性 |
|---|---|---|
| ViT 编码器 | 视觉 Transformer 编码器 | 支持长视频输入 |
| HiCo 压缩 | 自适应层次化 token 压缩 | 紧凑时空表示 |
| DPO 优化 | 直接偏好优化 | 集成密集视觉标注 |
| LLM 解码器 | 大语言模型解码器 | 7B/8B 参数 |
3.2 LRC 建模方法
长上下文建模(Long Context):
-
HiCo(Hierarchical Context Compression):自适应层次化 token 压缩
- 视频 token 通过层次化压缩减少数量
- 保持关键时空信息
- 支持超过 10,000 帧的视频输入
-
长视频训练:在长视频数据上训练
- 增强模型对长时序结构的理解
- 提升长视频记忆能力
丰富上下文建模(Rich Context):
- DPO 集成:通过直接偏好优化将密集视觉任务标注集成到 MLLM
- 目标跟踪标注
- 分割标注
- 时序定位标注
3.3 核心公式
HiCo 压缩:
其中 , 为原始 token 数量。
DPO 损失:
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| LRC 建模 | 长和丰富上下文建模 | 支持 6x 更长视频输入 |
| HiCo 压缩 | 自适应层次化 token 压缩 | 处理超过 10,000 帧不 OOM |
| DPO 集成 | 密集视觉任务标注集成 | 增强细粒度感知能力 |
| 长视频记忆 | 至少 3,000 帧记忆能力 | Needle-in-a-haystack 评估 |
| 专业视觉能力 | 目标跟踪、分割 | 定性结果展示 |
4.2 技术亮点
1. 长上下文建模:
- HiCo 层次化 token 压缩
- 支持超过 10,000 帧的视频输入
- 避免 OOM 错误
- 增强长时序结构理解
2. 丰富上下文建模:
- DPO 集成密集视觉任务标注
- 目标跟踪、分割等专业能力
- 细粒度细节感知
- 增强模型注意力和记忆能力
3. 高效压缩:
- 自适应层次化 token 压缩
- 保持关键时空信息
- 显著减少计算成本
- 支持实时视频理解
4. 开源生态:
- 提供 7B 和 8B 参数版本
- 完整代码和模型
- 易于研究和应用
- 促进社区发展
五、实验结果
5.1 视频理解基准
短视频理解:
| 模型 | MVBench | PerceptionTest | EgoSchema | 平均 |
|---|---|---|---|---|
| GPT-4o | 64.6 | - | 72.2 | - |
| Gemini-1.5-Pro | 60.5 | - | 71.2 | - |
| InternVL2-8B | 66.4 | - | - | - |
| InternVideo2.5-7B | 68.7 | 64.7 | 68.2 | 67.2 |
关键发现:
- InternVideo2.5 在短视频理解上超越 GPT-4o 和 Gemini-1.5-Pro
- MVBench 准确率 68.7%,提升 4-8%
- 感知测试准确率 64.7%
长视频理解:
| 模型 | LongVideoBench | MLVU | VideoMME | LVBench |
|---|---|---|---|---|
| GPT-4o | - | 66.7 | 64.6 | 71.9 |
| Gemini-1.5-Pro | - | 64.0 | - | 75.0 |
| InternVideo2.5-7B | 58.3 | 69.2 | 61.0 | 53.2 |
关键发现:
- 在 MLVU 上超越 GPT-4o(69.2 vs 66.7)
- 长视频理解能力显著提升
- 但仍低于 Gemini-1.5-Pro 在某些任务上的表现
5.2 长视频记忆能力
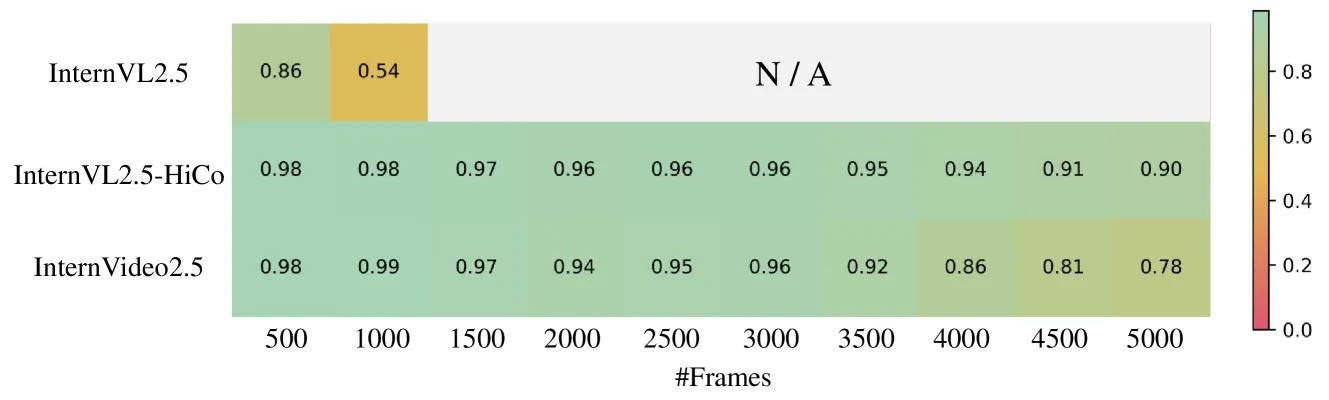 图 3:单跳 Needle-in-a-haystack 评估结果,使用 5,000 帧。
关键发现:
- InternVL2.5-8B:在 500 帧内难以准确召回目标帧,超过 1,000 帧出现 OOM
- InternVideo2.5:准确召回 3,000 帧序列,处理超过 10,000 帧不 OOM
- LRC 变体:在 3,000 帧内保持高召回率,之后性能下降
5.3 定性结果
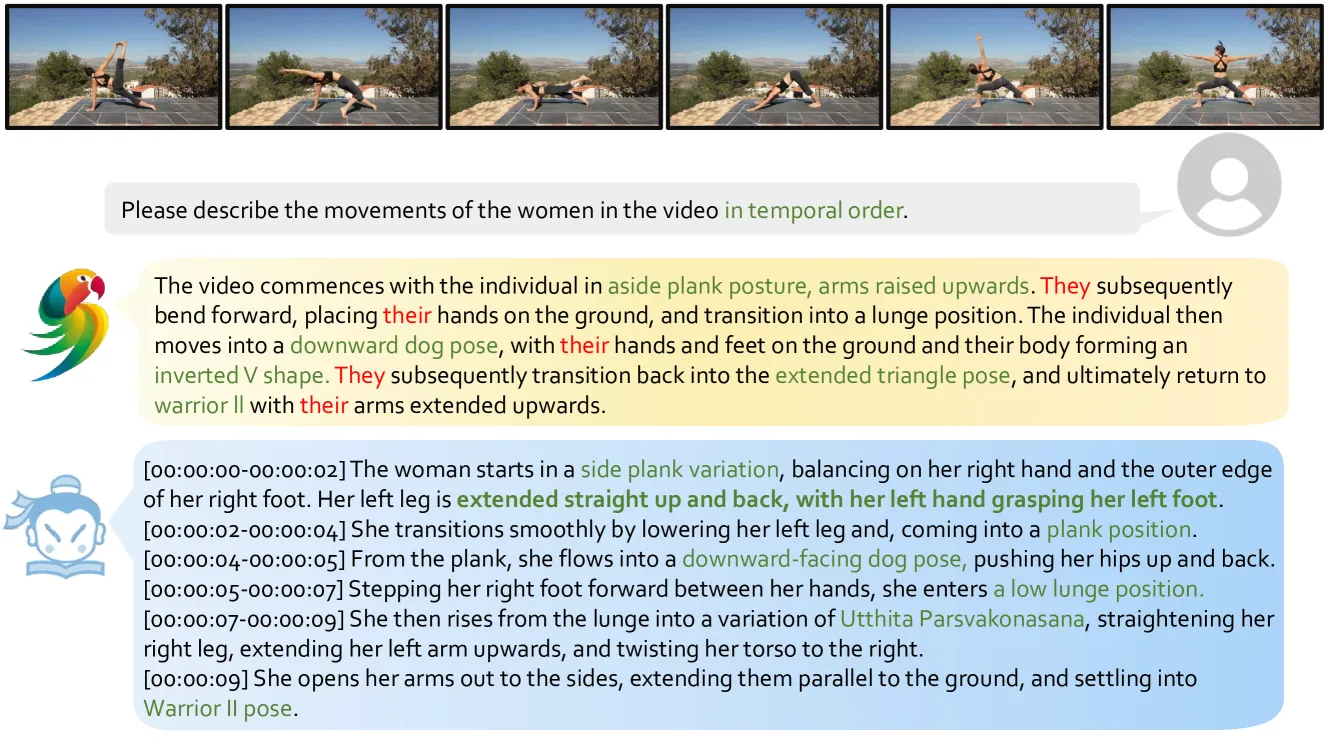 图 4:InternVideo2.5 能够用精确的时间参考描述时空运动。
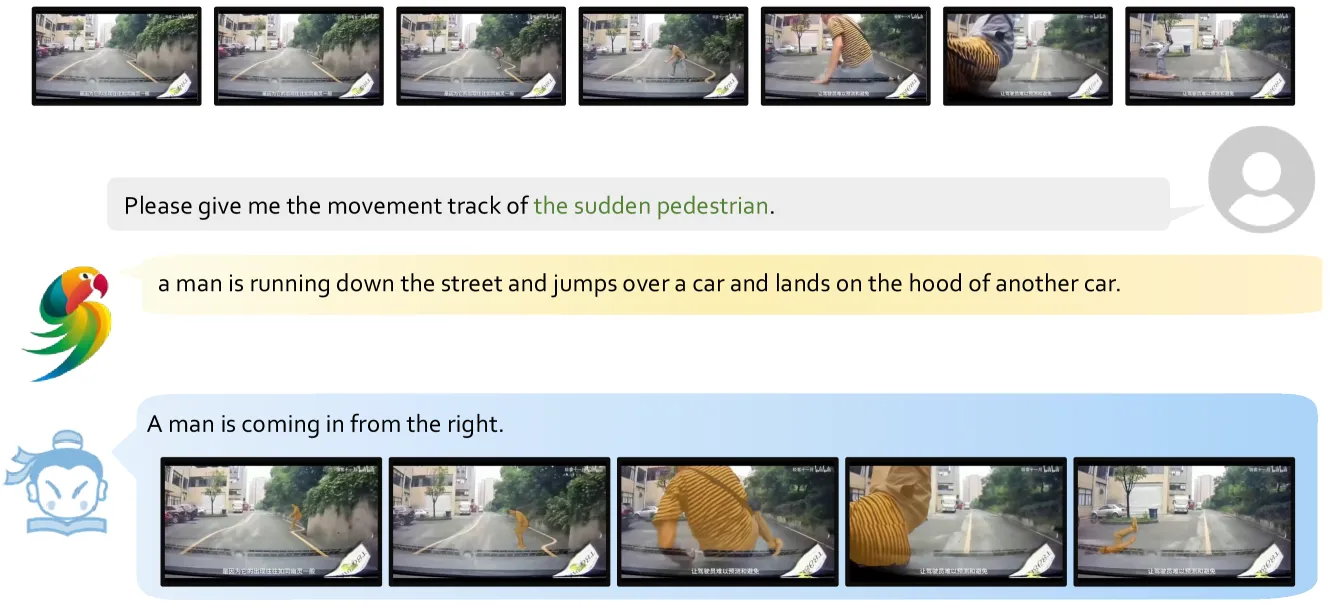 图 5:InternVideo2.5 能够跟踪用户指定的目标并进行推理。
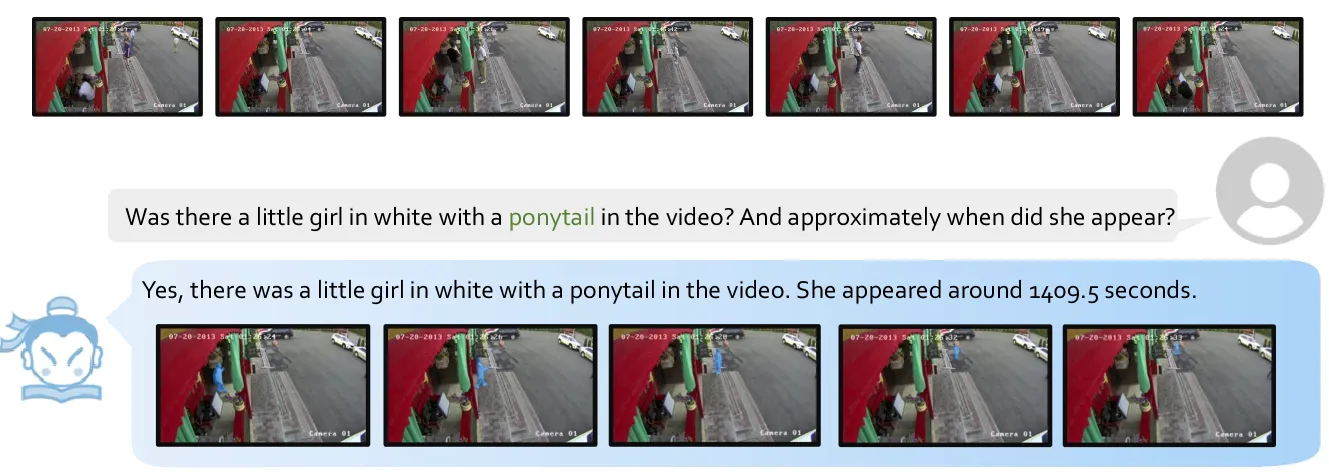 图 6:InternVideo2.5 能够理解扩展监控视频进行时刻检索。
关键观察:
- 精确时间参考:模型能用精确时间描述时空运动
- 目标跟踪:能跟踪用户指定的目标并推理
- 监控视频:能理解扩展监控视频进行时刻检索
- 异常检测:能检测异常事件
5.4 关键发现
- 显著性能提升:在主流视频理解基准上达到 SOTA
- 长视频支持:支持 6x 更长的视频输入
- 细粒度感知:增强目标跟踪、分割等专业能力
- 高效压缩:HiCo 压缩显著减少计算成本
- 开源贡献:提供 7B 和 8B 参数版本
六、应用场景
6.1 视频理解
- 动作识别:识别视频中的动作类别
- 视频问答:回答关于视频内容的问题
- 视频描述:生成视频的文字描述
6.2 长视频分析
- 监控视频:理解扩展监控视频
- 会议记录:分析长时间会议视频
- 教学视频:理解长时间教学内容
6.3 专业视觉任务
- 目标跟踪:跟踪视频中的目标
- 视频分割:分割视频中的物体
- 时序定位:定位视频中的特定时刻
6.4 实时应用
- 视频检索:根据查询检索相关视频
- 异常检测:检测视频中的异常事件
- 视频推荐:基于视频内容推荐
七、相关工作
7.1 视频 MLLM
| 方法 | 特点 | 局限性 |
|---|---|---|
| InternVideo2 | 6B 参数,三阶段训练 | 长视频支持有限 |
| VideoLLaMA2 | 多模态融合 | 细粒度感知不足 |
| InternVideo2.5 | LRC 建模,长视频支持 | 本方法 |
7.2 长视频理解
| 方法 | 特点 | 局限性 |
|---|---|---|
| VideoLLM-Online | 在线视频处理 | 计算成本高 |
| LongVA | 长视频注意力 | 压缩效率低 |
| InternVideo2.5 | HiCo 压缩 + DPO | 本方法 |
7.3 视觉任务集成
| 方法 | 特点 | 局限性 |
|---|---|---|
| Pixel-to-Sequence | 像素到序列 | 推理速度慢 |
| Pixel-to-Embedding | 像素到嵌入 | 信息损失 |
| InternVideo2.5 | DPO 集成密集标注 | 本方法 |
八、总结
8.1 核心贡献
- LRC 建模:长和丰富上下文建模方法
- HiCo 压缩:自适应层次化 token 压缩
- DPO 集成:密集视觉任务标注集成
- 长视频支持:支持 6x 更长的视频输入
- 专业视觉能力:增强目标跟踪、分割等能力
- 开源模型:提供 7B 和 8B 参数版本
8.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| 视频理解 | 在主流基准上达到 SOTA |
| 长视频分析 | 支持超过 3,000 帧的视频 |
| 细粒度感知 | 增强专业视觉任务能力 |
| 计算效率 | HiCo 压缩显著减少计算成本 |
8.3 局限性
- 长视频性能:在超长视频(>3,000 帧)上性能下降
- 计算成本:处理长视频仍需大量计算资源
- 数据依赖:DPO 需要高质量密集视觉标注
- 任务覆盖:主要针对视频理解任务
8.4 未来方向
- 超长视频:探索更长视频的处理能力
- 实时应用:优化推理速度
- 更多任务:扩展到更多视觉任务
- 数据增强:探索更高效的数据构建方法
九、参考资源
9.1 论文链接
9.2 代码资源
9.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | InternVideo2.5 性能概览 | figure-1-overview.png |
| 图 2 | InternVideo2.5 LRC 框架 | figure-2-framework.png |
| 图 3 | 长视频 Needle-in-a-haystack 评估 | figure-3-needle-haystack.png |
| 图 4 | 时序运动描述 | figure-4-temporal-movement.png |
| 图 5 | 目标跟踪与推理 | figure-5-object-tracking.png |
| 图 6 | 监控视频理解 | figure-6-surveillance.png |
| 图 7 | 异常事件检测 | figure-7-abnormal-detection.png |


9.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| InternVideo2 | Wang et al. | 2024 | 前代模型 |
| VideoLLaMA2 | Cheng et al. | 2024 | 视频 MLLM |
| InternVL2 | Chen et al. | 2024 | 视觉语言模型 |
9.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 长和丰富上下文 | Long and Rich Context (LRC) | 本文核心方法 |
| 自适应层次化 token 压缩 | Adaptive Hierarchical Token Compression (HiCo) | 高效压缩方法 |
| 直接偏好优化 | Direct Preference Optimization (DPO) | 集成密集视觉标注 |
| Needle-in-a-haystack | Needle-in-a-haystack | 长视频记忆评估 |
| 视频多模态大语言模型 | Video Multimodal Large Language Model (Video MLLM) | 研究对象 |
分析完成时间:2026年6月17日 分析工具:Claude Code + curl + Python