FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
FlashInfer:面向LLM推理服务的高效可定制注意力引擎,通过块稀疏格式、JIT编译和负载均衡调度实现高性能注意力计算
FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 论文标题 | FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving |
| 作者 | Zihao Ye, Lequn Chen, Ruihang Lai, Wuwei Lin, Yineng Zhang, Stephanie Wang, Tianqi Chen, Baris Kasikci, Vinod Grover, Arvind Krishnamurthy, Luis Ceze |
| 机构 | University of Washington, Carnegie Mellon University, NVIDIA |
| 论文链接 | arXiv:2501.01005 |
| 代码仓库 | github.com/flashinfer-ai/flashinfer |
| 项目主页 | flashinfer.ai |
| 发表日期 | 2025年1月2日(v1),2025年4月21日(v2) |
| 会议 | MLSys 2025 |
| 领域 | 分布式/并行/集群计算 (cs.DC)、人工智能 (cs.AI)、机器学习 (cs.LG) |
二、核心思想
问题定义
随着大语言模型(LLM)的规模不断扩大,高效的GPU注意力内核对于实现高吞吐量和低延迟推理变得至关重要。然而,LLM推理服务中的注意力计算面临两大核心挑战:
-
工作负载多样性与输入动态性
- LLM服务涉及多种注意力计算模式:预填充(prefill)、批量解码(batched decoding)、前缀复用(prefix-reuse)、树解码(tree decoding)等
- 查询长度和KV缓存大小在批次内和时间上都在变化
- 朴素实现会导致负载不均衡问题
-
硬件实现的定制化需求
- 内存层面:需要高效的存储格式(如分页注意力、基数树)来管理不断增长的KV缓存
- 计算层面:需要针对特定硬件架构定制流水线和模板
- 机制层面:需要支持现代LLM中日益多样化的注意力机制(分组注意力头、特殊掩码、自定义注意力分数计算等)
解决方案概述
FlashInfer提出了一种基于代码生成的注意力引擎,包含三个核心设计:
- 统一的块稀疏存储格式:使用块稀疏行(BSR)格式统一处理KV缓存的异构性,并引入可组合格式提升内存效率
- 可定制的注意力模板:通过JIT编译支持各种注意力变体,实现快速适配
- 动态感知的运行时调度:负载均衡调度算法适配用户请求的动态性,同时保持与CUDAGraph的兼容性
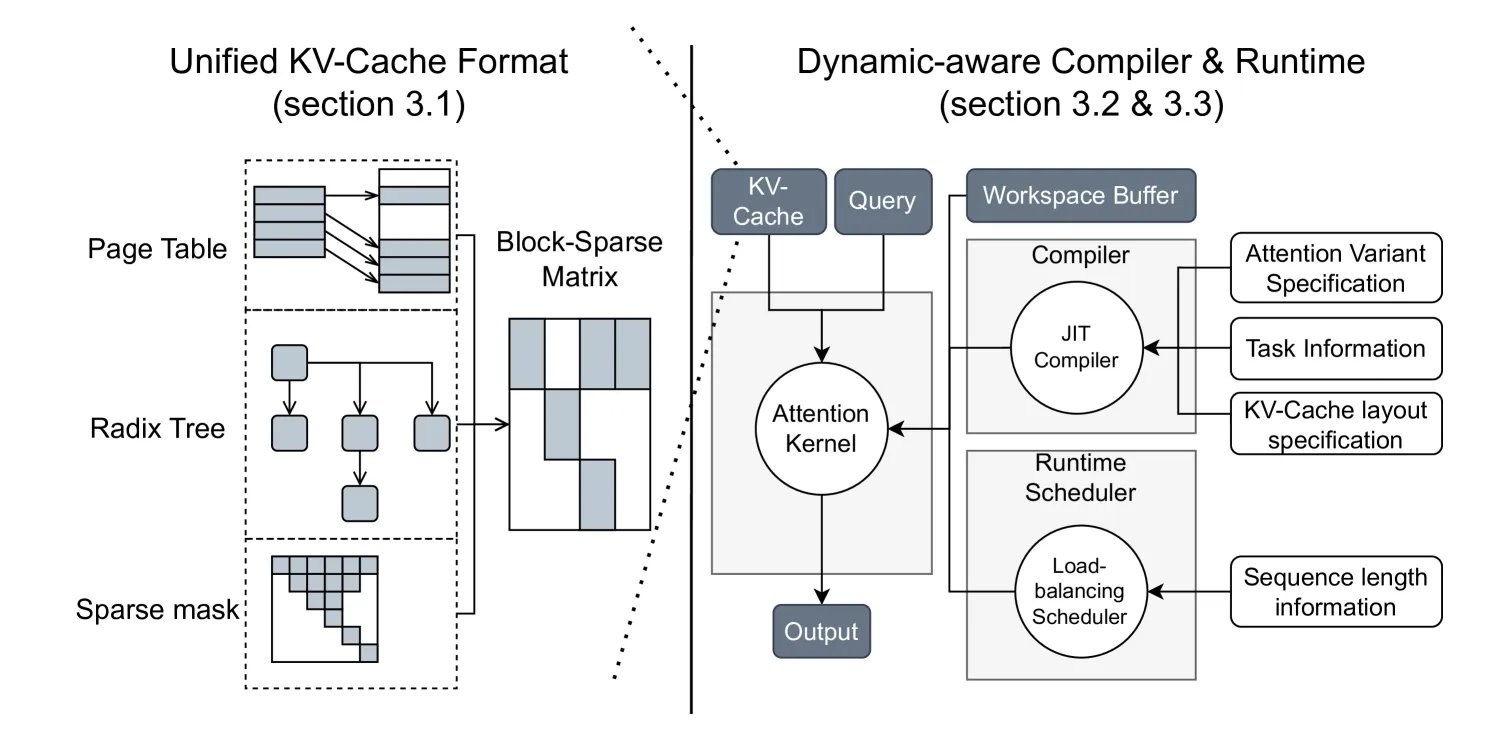
Figure 1: FlashInfer系统设计概览:注意力变体规范、任务信息和KV缓存布局在编译时提供用于JIT编译,序列长度信息在运行时输入用于动态调度。
三、技术架构
核心设计
FlashInfer的架构由三个主要层次组成:
3.1 KV缓存存储层
块稀疏矩阵作为统一格式
FlashInfer使用块稀疏行(BSR)格式作为KV缓存存储的统一抽象。BSR将非零元素分组为大小为 (B_r, B_c) 的连续矩阵块,具有以下优势:
- 寄存器复用效率高:连续内存访问提升硬件利用率
- 与硬件矩阵乘法兼容:适配GPU和NPU的Tensor Core指令
- 支持跳过空块:减少计算开销
- 灵活性强:支持任意块大小,突破传统128×128的限制
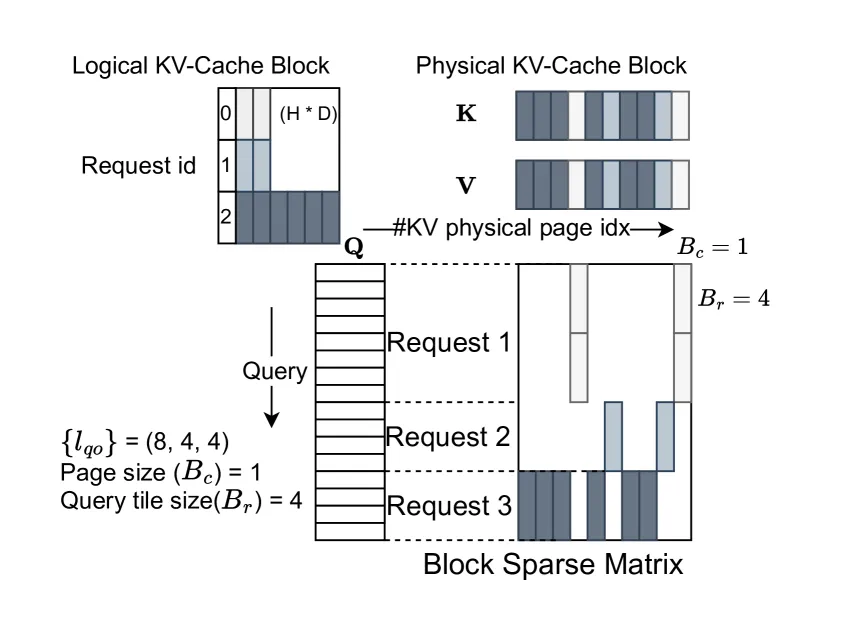
Figure 2: Page Table在BSR (B_r=4, B_c=1)格式中的表示。块稀疏矩阵中的列块数对应Page Table分配的总块数。
可组合格式提升内存效率
受SparseTIR启发,FlashInfer引入可组合格式,使用多个块稀疏格式而非单一格式存储稀疏矩阵:
- 对于共享前缀的请求,使用较大的B_r存储对应的密集子矩阵
- 对于唯一的KV缓存,使用较小的B_r避免碎片化
- 无需移动KV缓存数据,只需计算索引和索引指针数组
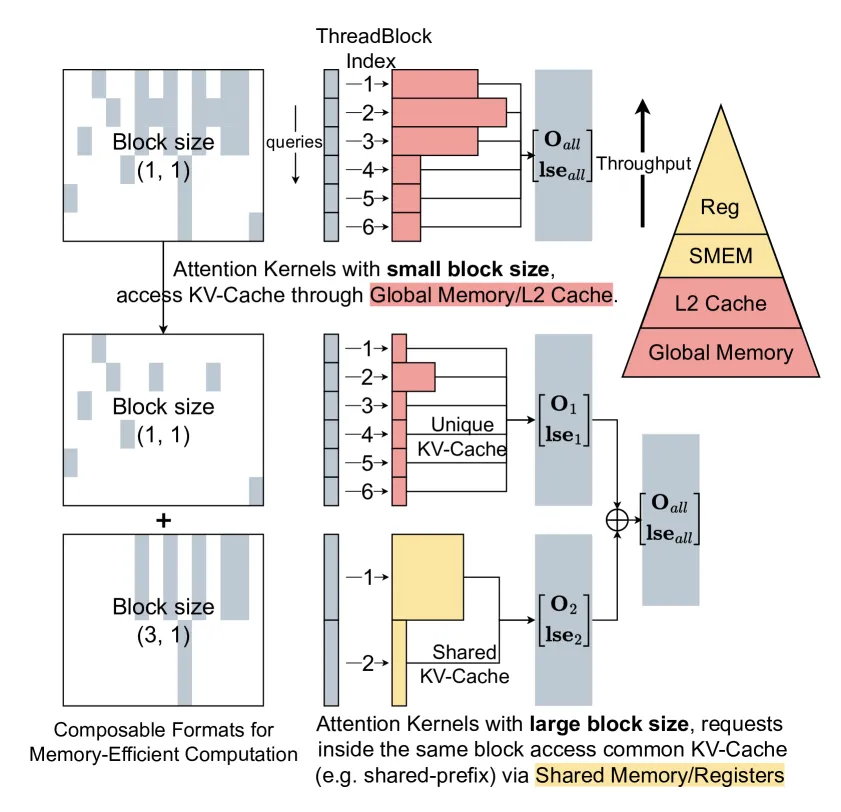
Figure 3: 注意力计算中共享前缀分解的可组合格式。前6行查询共享前缀,后6行查询共享前缀。
3.2 计算抽象层
全局到共享内存的数据移动
FlashInfer支持任意块大小,需要专门的数据加载方法:
- 使用异步拷贝指令LDGSTS(128B宽度)最大化内存带宽
- 对于Hopper架构,支持TMA(Tensor Memory Accelerator)用于连续KV缓存
- 对于非仿射内存访问模式,回退到Ampere风格的异步拷贝
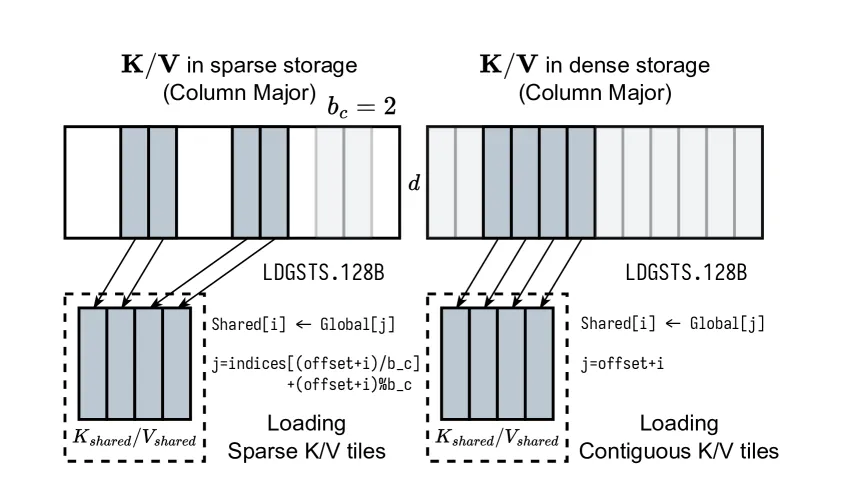
Figure 4: FlashInfer中稀疏/密集KV-Cache从全局内存到共享内存的数据传输。
不同Tile大小的微内核
为适应LLM应用的不同操作强度,FlashInfer实现了多种FA2内核尺寸:
- 查询tile大小:{1, 16, 32, 64, 128}
- KV tile大小:{32, 64, 128}
- 选择启发式:
- 确定批次平均查询长度,选择满足要求的最小查询tile大小
- 根据寄存器和共享内存约束最大化SM资源占用率
JIT编译器支持注意力变体
FlashInfer设计了可定制的CUDA模板和JIT编译器:
-
变体规范包括:
- QueryTransform/KeyTransform/ValueTransform:注意力计算前的变换
- OutputTransform:输出前的变换
- LogitsTransform/LogitsMask:softmax前的logits变换和掩码
-
支持的变体:
- 自定义掩码
- Logits soft-cap(如Gemma、Grok)
- 滑动窗口注意力(Longformer)
- 无softmax的注意力变体(FlashSigmoid)
- 融合RoPE和投影到注意力内核
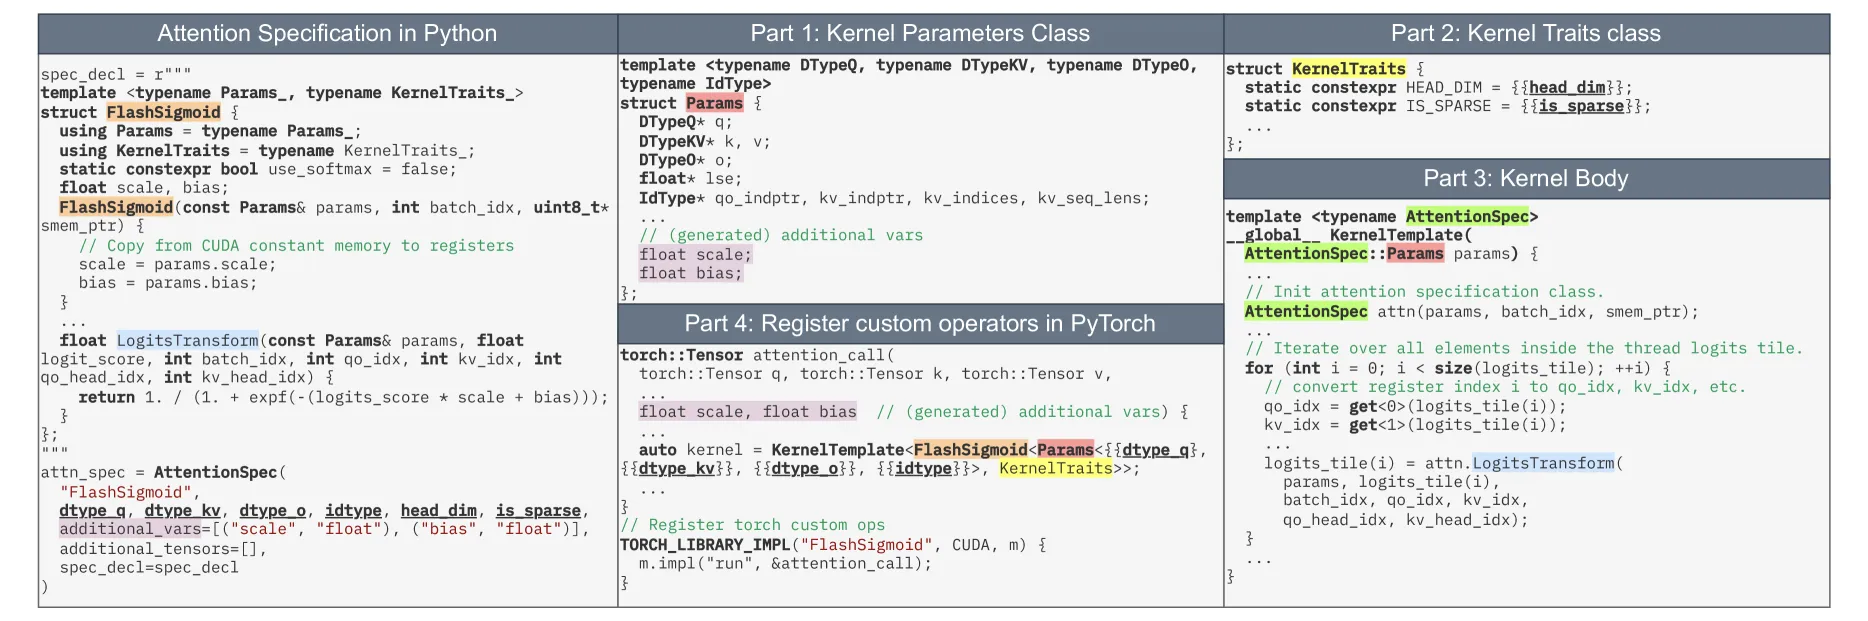
Figure 5: FlashInfer的JIT编译器,展示定义变体函子的CUDA代码字符串、额外变量/张量和数据类型。
3.3 动态感知运行时层
负载均衡调度算法
FlashInfer的调度算法旨在通过均匀分配工作负载来最小化SM空闲时间:
- 输入:查询/输出和键/值维度的序列长度信息
- 输出:工作负载与CTA的映射关系,部分和最终输出的索引映射
- 算法流程:
- 计算最大KV块大小 L_kv
- 将每个查询tile的KV分成块
- 按长度降序排序
- 使用优先队列进行贪心分配
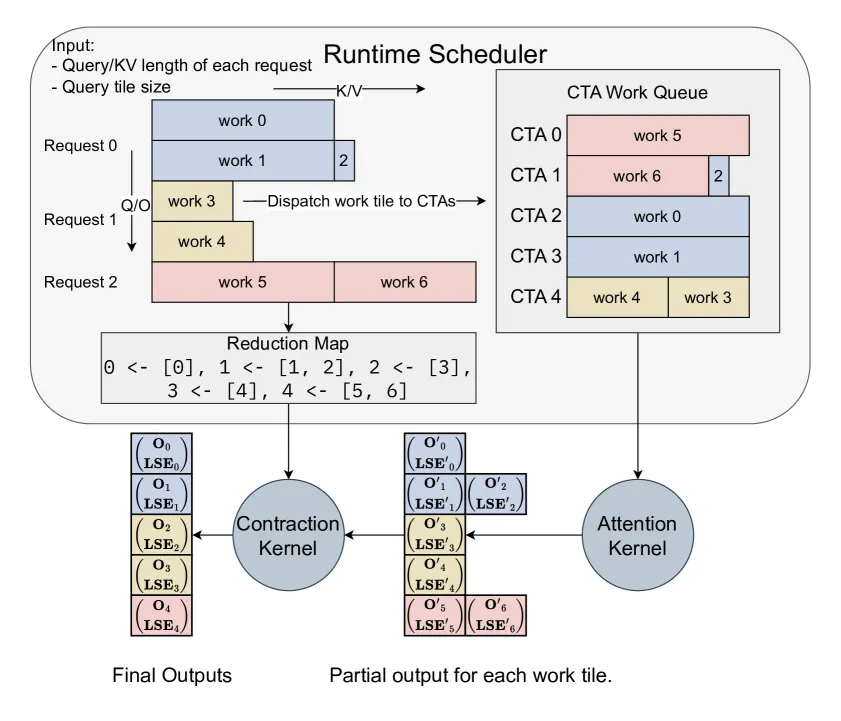
Figure 6: FlashInfer的负载均衡运行时调度器工作流程。
CUDAGraph兼容性
FlashInfer确保注意力和收缩内核都与CUDAGraph兼容:
- 使用持久化内核,网格大小编译后固定
- 工作区缓冲区各部分使用固定偏移量
- plan函数在CPU上运行,run函数可被CUDAGraph捕获
关键技术
块稀疏格式的核心创新
| 特性 | 传统方法 | FlashInfer |
|---|---|---|
| 块大小限制 | 通常128×128 | 任意 (B_r, B_c) |
| 存储格式 | 单一格式 | 可组合多格式 |
| 稀疏性支持 | 有限 | 向量级细粒度稀疏 |
| 内存效率 | 受碎片化影响 | 通过组合优化 |
JIT编译的工作流程
class FlashSigmoid:
    def query_transform(self, q, head_idx):
        return q  # 无变换

    def key_transform(self, k, head_idx):
        return k  # 无变换

    def logits_transform(self, logits, q_idx, k_idx):
        return sigmoid(logits)  # 使用sigmoid替代softmax

    def output_transform(self, o, lse):
        return o  # 无变换
编程接口设计
workspace = torch.empty(...)
seqlen_info.init()

attn = AttentionWrapper(attn_spec, task_info, workspace)

g = torch.cuda.CUDAGraph()
attn.plan(seqlen_info)
with torch.cuda.graph(g):
    attn.run(...)

while not finished:
    seqlen_info.update()
    attn.plan(seqlen_info)  # 每个生成步骤重新规划
    g.replay()
四、核心创新
| 创新点 | 描述 | 技术优势 |
|---|---|---|
| 统一块稀疏格式 | 使用BSR格式统一KV缓存存储 | 支持任意块大小,兼容多种存储模式(分页注意力、基数树等) |
| 可组合格式 | 多个块稀疏格式组合存储 | 共享前缀使用大块提升复用,唯一部分使用小块减少碎片 |
| JIT编译注意力变体 | CUDA模板+变体规范生成优化内核 | 仅需20行代码即可实现新变体(如融合RoPE) |
| 负载均衡调度 | 基于Stream-K的动态调度算法 | 适配变长序列,确定性输出,CUDAGraph兼容 |
| 灵活的Tile大小 | 支持{1,16,32,64,128}×{32,64,128} | 适配不同查询长度和硬件架构 |
| 向量稀疏支持 | 支持(16,1)或(1,16)的细粒度稀疏 | 先gather到共享内存再用密集Tensor Core |
五、实验结果
性能提升
端到端LLM服务性能
在NVIDIA A100 40GB SXM和H100 80GB SXM GPU上进行评估:
| 指标 | 模型 | 数据集 | FlashInfer vs Triton | FlashInfer vs TRT-LLM |
|---|---|---|---|---|
| ITL | Llama 3.1 8B | ShareGPT | 降低29% | 接近 |
| ITL | Llama 3.1 8B | Variable | 降低35% | 接近 |
| ITL | Llama 3.1 70B | ShareGPT | 降低45% | 略低 |
| ITL | Llama 3.1 70B | Variable | 降低69% | 接近 |
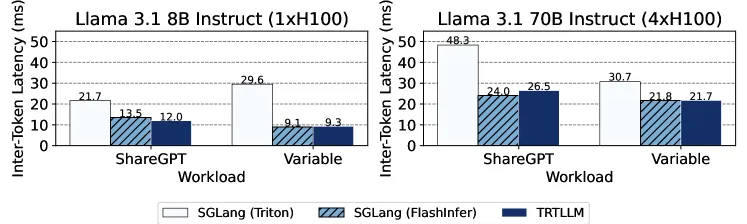
Figure 7: SGLang集成FlashInfer和Triton的中位ITL和TTFT,与TensorRT-LLM对比。
内核级性能
在不同序列长度分布下的带宽和FLOPs利用率:
| 序列长度分布 | Decode带宽利用率 | Prefill FLOPs利用率 |
|---|---|---|
| 常数(1024) | 与FlashAttention相当 | 与FlashAttention相当 |
| 均匀(512-1024) | 显著优于FlashAttention | 显著优于FlashAttention |
| 偏斜(Zipf) | 显著优于FlashAttention | 显著优于FlashAttention |
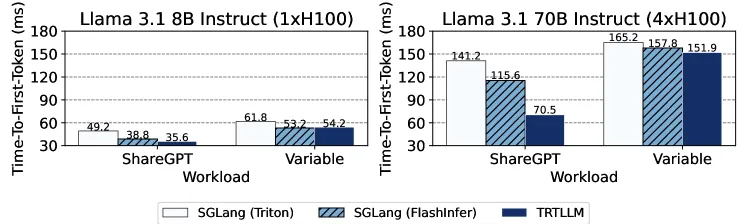
Figure 8: Decode(上)和Prefill(下)内核的带宽和FLOPs利用率。
长上下文推理性能
Streaming-LLM场景下的融合RoPE内核:
| 指标 | FlashInfer融合内核 | FlashAttention非融合内核 | 提升 |
|---|---|---|---|
| ITL | - | - | 降低28-30% |
| 带宽利用率 | - | - | 提升1.6-3.7倍 |
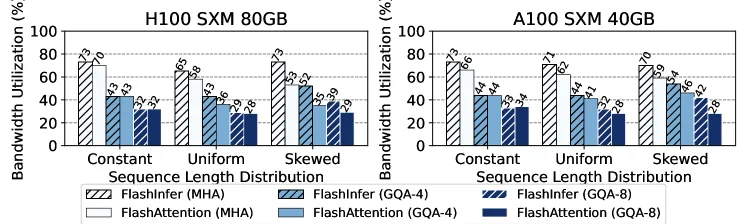
Figure 9: 上:Streaming-LLM的端到端延迟对比。下:融合RoPE内核的带宽利用率对比。
并行生成性能
MLC-Engine中使用可组合格式的并行生成:
| 并行数n | 8B模型ITL提升 | 70B模型ITL提升 | 8B模型TTFT提升 | 70B模型TTFT提升 |
|---|---|---|---|---|
| n=4 | 13.73% | 17.42% | 16.41% | 22.86% |
| n=8-32 | 持续提升 | 持续提升 | 持续提升 | 持续提升 |
| n>32 | 收益递减 | 收益递减 | 收益递减 | 收益递减 |
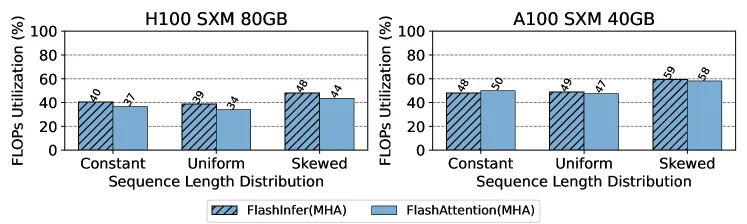
Figure 10: MLC-Engine使用和不使用可组合格式的并行生成ITL和TTFT对比。
关键发现
-
动态序列长度的显著优势:FlashInfer的负载均衡调度在非均匀序列长度分布下表现尤为突出,相比FlashAttention有显著提升
-
解码内核的tile大小优化:FlashInfer的灵活tile大小选择在解码场景下优于FlashAttention的固定大tile
-
融合内核的重要性:RoPE与注意力的融合可带来1.6-3.7倍的带宽利用率提升,突显了可定制性的价值
-
可组合格式的适用场景:在中等并行度(4≤n≤32)下效果最佳,计算量不足或注意力非瓶颈时收益有限
-
与主流框架的集成:已成功集成到SGLang、vLLM和MLC-Engine,证明了其通用性和实用性
六、相关工作
| 方向 | 代表工作 | FlashInfer的改进 |
|---|---|---|
| 注意力优化 | FlashAttention 1/2/3, FlashDecoding | 扩展FA2/3模板支持稀疏内核,Stream-K优化变长序列 |
| 稀疏优化 | Blocksparse, TC-GNN, Magicube | 支持任意块大小的块稀疏FlashAttention |
| 注意力编译器 | FlexAttention, Mirage | 扩展编程接口支持查询/键变换,专注向量稀疏和负载均衡 |
| LLM服务系统 | Orca, PagedAttention, SGLang, vLLM | 统一的块稀疏注意力内核解决方案 |
| 共享前缀优化 | RelayAttention, Hydragen, ChunkAttention | 多级别、多前缀解码,统一页表管理 |
FlashInfer与FlexAttention的对比
| 特性 | FlexAttention | FlashInfer |
|---|---|---|
| 代码生成 | Triton | CUDA/CUTLASS |
| 反向传播 | 自动生成 | 需手动实现(专注前向推理) |
| 稀疏性支持 | 有限 | 向量级细粒度稀疏 |
| 负载均衡 | 无 | Stream-K风格动态调度 |
| 主要目标 | 训练和推理 | LLM服务推理 |
七、总结
核心贡献
-
灵活的块稀疏和可组合格式:解决KV缓存存储异构性,实现高效内存管理和访问
-
可定制的注意力模板:通过JIT编译适配各种注意力变体,确保高性能执行
-
动态调度框架:管理输入动态性,同时保持CUDAGraph兼容,最大化硬件利用率
-
全面的性能评估:在多种推理场景下展示显著的内核和端到端性能提升
技术影响
- 系统层面:为LLM服务提供了统一、高效、可扩展的注意力引擎解决方案
- 生态层面:已集成到三大主流LLM服务框架(SGLang、vLLM、MLC-Engine),具有广泛的影响力
- 研究层面:提出了注意力计算的新抽象,为未来研究提供了基础平台
- 产业层面:开源项目促进了社区驱动的改进和创新
局限性
-
仅支持前向推理:论文主要关注推理场景,反向传播(训练)支持需要额外工作
-
硬件特化:CUDA/CUTLASS代码生成针对NVIDIA GPU,其他硬件平台(AMD、Intel)需要适配
-
JIT编译开销:首次编译需要时间,虽然可缓存但在动态变体场景下可能有影响
-
调度器的CPU开销:plan函数在CPU上运行,虽然可跨层复用,但在极端延迟敏感场景下仍有开销
-
可组合格式的适用范围:在并行度过高或注意力非瓶颈时收益有限
未来方向
作者提到的未来工作包括:
- 编译更高级别的DSL到FlashInfer注意力规范
- 代码生成到其他后端(如AMD、Intel GPU)
- 集成FlashDecoding++的异步状态更新技术
八、参考资源
论文与代码
- 论文PDF:https://arxiv.org/pdf/2501.01005
- HTML版本:https://arxiv.org/html/2501.01005v2
- GitHub仓库:https://github.com/flashinfer-ai/flashinfer
- 项目主页:https://flashinfer.ai/
相关框架
- SGLang:https://github.com/sgl-project/sglang
- vLLM:https://github.com/vllm-project/vllm
- MLC-Engine:https://github.com/mlc-ai/mlc-llm
前置工作
- FlashAttention:https://github.com/Dao-AILab/flash-attention
- FlexAttention:https://pytorch.org/tutorials/intermediate/scaled_dot_product_attention_tutorial.html
- CUTLASS:https://github.com/NVIDIA/cutlass
论文图片
论文中的关键图片已下载至 docs/figures/flashinfer/ 目录:
| 图片 | 文件名 | 描述 |
|---|---|---|
| Figure 1 | figure1.png | FlashInfer系统设计概览 |
| Figure 2 | figure2.png | Page Table在BSR格式中的表示 |
| Figure 3 | figure3.png | 可组合格式的共享前缀分解 |
| Figure 4 | figure4.png | 稀疏/密集KV-Cache数据传输 |
| Figure 5 | figure5.png | JIT编译器架构 |
| Figure 6 | figure6.png | 负载均衡运行时调度器 |
| Figure 7 | figure7.png | 端到端ITL和TTFT性能对比 |
| Figure 8 | figure8.png | 内核带宽和FLOPs利用率 |
| Figure 9 | figure9.png | Streaming-LLM性能对比 |
| Figure 10 | figure10.png | 并行生成性能对比 |
| Figure 11 | figure11.png | Head-group融合 |
| Figure 12 | figure12.png | FA2/FA3模板性能对比 |
| Figure 13-16 | figure13-16.png | 附录中的补充实验结果 |
关键引用
@article{ye2025flashinfer,
  title={FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving},
  author={Ye, Zihao and Chen, Lequn and Lai, Ruihang and Lin, Wuwei and Zhang, Yineng and Wang, Stephanie and Chen, Tianqi and Kasikci, Baris and Grover, Vinod and Krishnamurthy, Arvind and Ceze, Luis},
  journal={arXiv preprint arXiv:2501.01005},
  year={2025}
}