A Survey on Large Language Model Acceleration based on KV Cache Management
基于KV缓存管理的LLM加速综述,系统梳理Token级、模型级和系统级三层优化策略
A Survey on Large Language Model Acceleration based on KV Cache Management
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | A Survey on Large Language Model Acceleration based on KV Cache Management |
| 作者 | Jian Chen, Peilin Zhao, Yik-Chung Wu, Minghua Chen |
| 论文 | arXiv:2412.19442 |
| 发布 | 2024-12-27 (v1), 2025-05-22 (v3) |
| 主题 | cs.CL (Computation and Language); cs.AI (Artificial Intelligence); cs.LG (Machine Learning) |
二、核心思想
问题定义
大语言模型(LLM)推理面临的关键瓶颈是KV缓存管理:
- 自回归生成机制需要存储所有先前token的Key-Value对
- KV缓存大小随序列长度线性增长,成为内存和计算瓶颈
- 长上下文应用场景对KV缓存管理提出更高要求
综述范围
本综述系统梳理了基于KV缓存管理的LLM加速方法,提出三层优化分类体系:
- Token级优化:细粒度的KV对选择、压缩和量化
- 模型级优化:注意力机制和架构设计优化
- 系统级优化:内存管理、调度和硬件加速
与其他综述的区别
| 综述 | 焦点 |
|---|---|
| Ding et al. | 数据级+模型架构级效率 |
| Miao et al. | 系统级高效推理 |
| Tang et al. | 数据+模型+系统级优化 |
| 本综述 | 专注KV缓存管理的三层优化 |
三、技术架构
Transformer与KV缓存基础
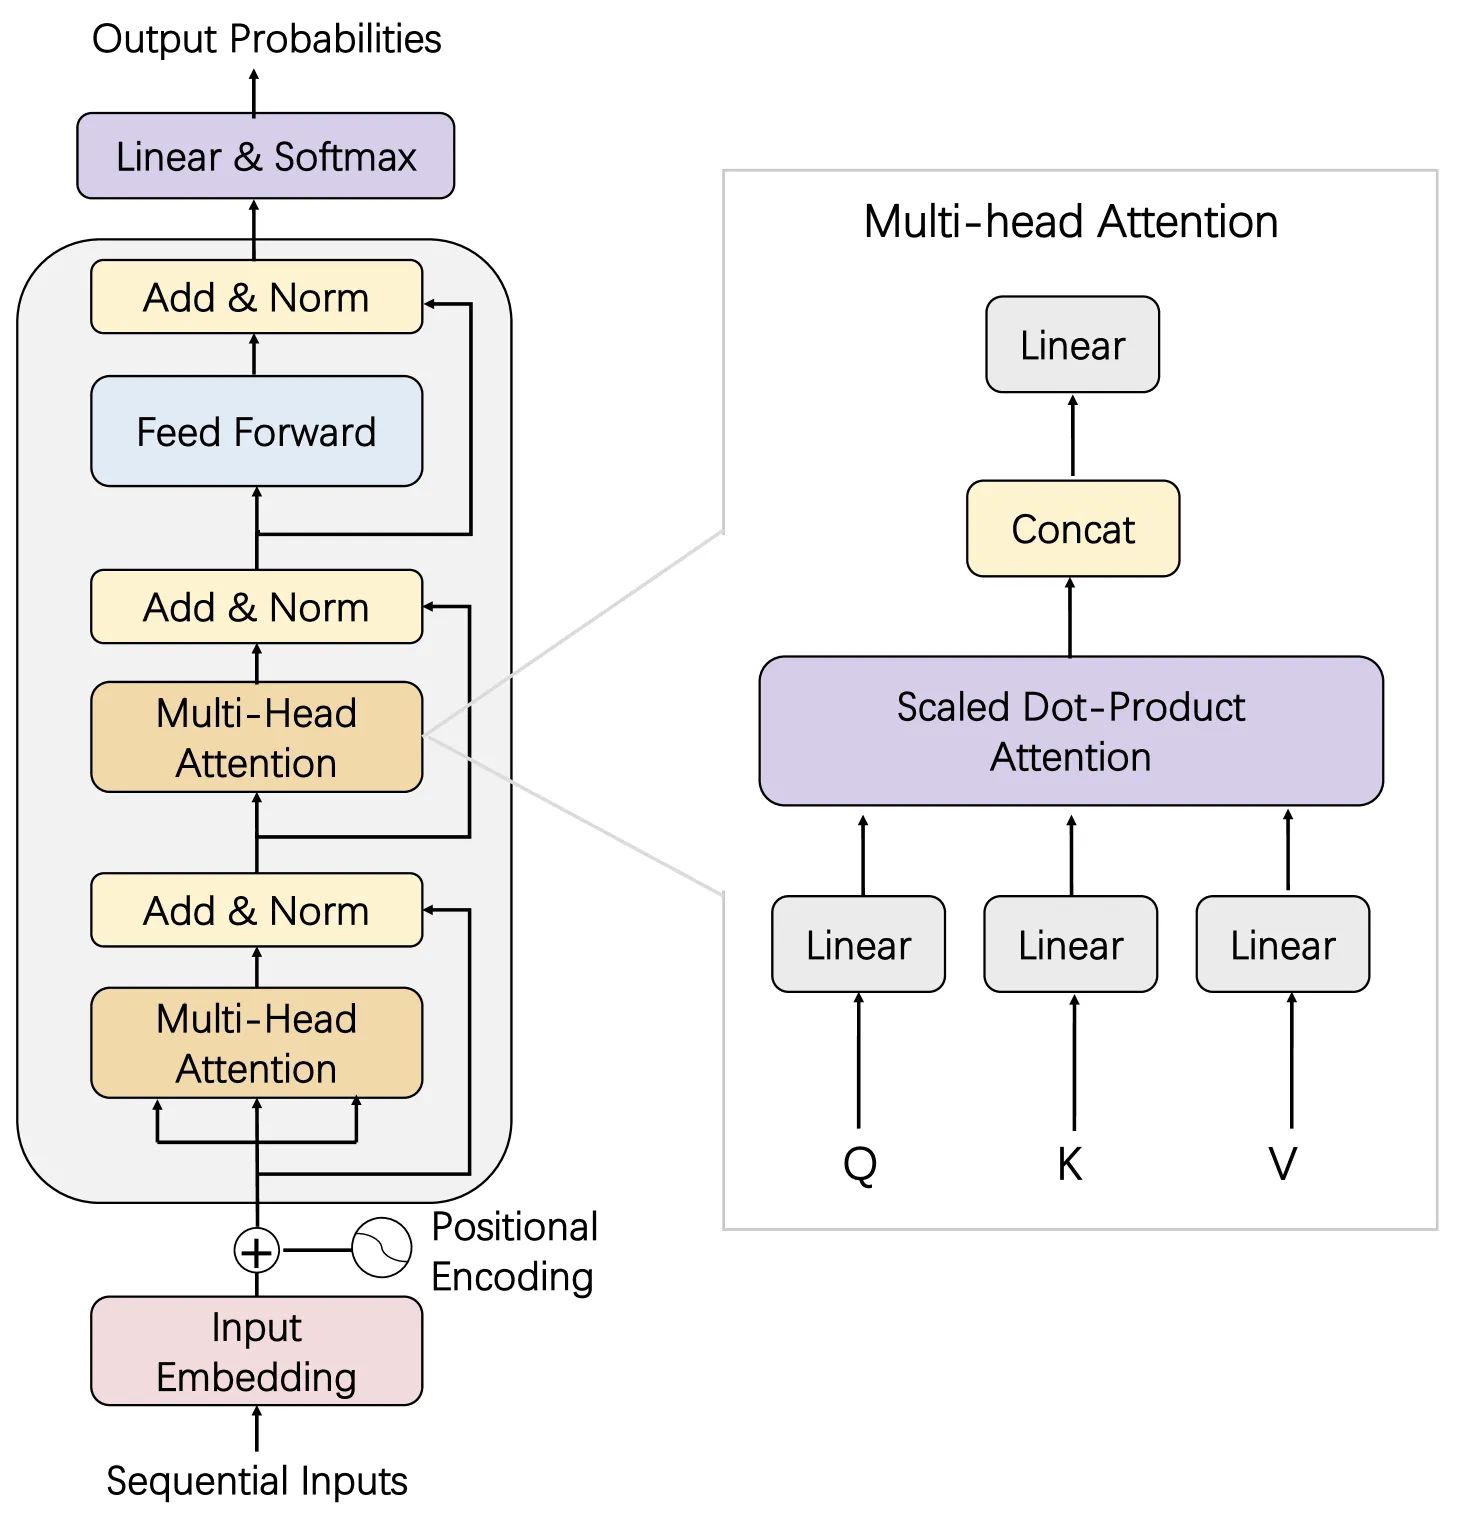
Figure 1: LLM的Decoder-only Transformer架构。
核心组件:
- 输入嵌入:
- 注意力计算:, ,
- KV缓存:,
分类体系
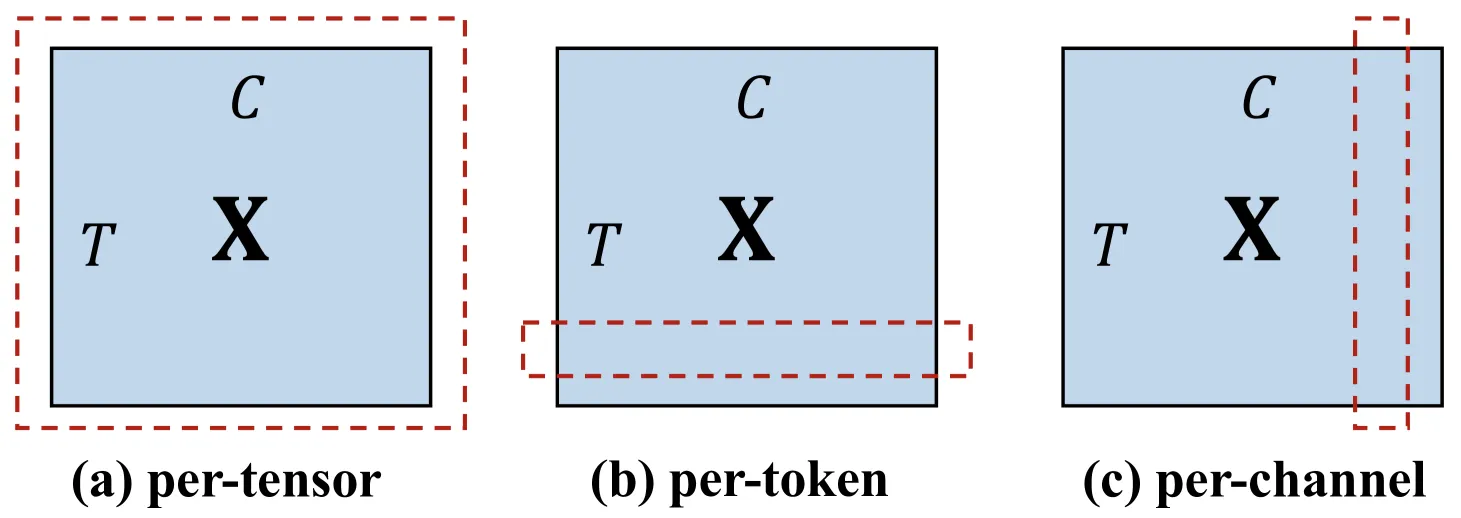
Figure 3: Token级KV缓存优化分类。
四、Token级优化
4.1 KV缓存选择
静态选择(Prefilling阶段一次性压缩):
- FastGen:识别5种注意力结构,针对性保留
- SnapKV:基于观察窗口检测重要token
- Attention-Gate:可学习的驱逐策略
动态选择(Decoding阶段持续更新):
- H2O:基于累积注意力分数的贪心驱逐
- StreamingLLM:保留初始token+recent tokens
- Scissorhands:基于重要性持久性驱逐
- InfLLM/Quest:块级检索优化
选择策略对比:
| 方法 | 初始token | Top-k | Recent | 永久驱逐 | 动态选择 | 粒度 |
|---|---|---|---|---|---|---|
| FastGen | ✓ | ✓ | ✓ | ✓ | token | 5种结构 |
| SnapKV | ✓ | ✓ | ✓ | token | 观察窗口 | |
| H2O | ✓ | ✓ | ✓ | ✓ | token | 累积注意力 |
| StreamingLLM | ✓ | ✓ | ✓ | ✓ | token | 初始+recent |
| InfLLM | ✓ | ✓ | ✓ | ✓ | block | 块级管理 |
| Quest | ✓ | ✓ | block | 新块表示 | ||
| SqueezedAttention | ✓ | ✓ | cluster | 层次聚类 |
4.2 KV缓存预算分配
层级分配:
- PyramidKV/PyramidInfer:金字塔式分配,浅层多深层少
- DynamicKV:动态调整各层预算
- PrefixKV/SimLayerKV:基于前缀的分配策略
头级分配:
- AdaKV:自适应头级预算
- CriticalKV/LeanKV:识别关键头
- RazorAttention/HeadKV/DuoAttention:差异化头级处理
4.3 KV缓存合并
层内合并:
- CCM/LoMA/DMC:基于相似度合并
- CaM/D2O:补偿机制合并
- KVMerger/CHAI:聚类合并
跨层合并:
- MiniCache:跨层KV共享
- KVSharer:层间KV共享
4.4 KV缓存量化
固定精度量化:
- ZeroQuant/FlexGen:统一低精度
- PQCache:乘积量化
混合精度量化:
- KVQuant/KIVI:Key和Value不同精度
- SKVQ/ZipCache:动态精度选择
- MiniKV:关键token高精度
异常值重分布:
- SmoothQuant/DuQuant:平滑异常值
- QuaRot/QServe:旋转量化
- AWQ/OmniQuant:激活感知量化
4.5 KV缓存低秩分解
奇异值分解(SVD):
- ECKVH/EigenAttention:特征分解
- LoRC/ShadowKV/Palu:低秩近似
张量分解:
- DecoQuant:张量分解量化
学习低秩近似:
- LESS/MatryoshkaKV:可学习的低秩表示
五、模型级优化
5.1 注意力分组与共享
层内分组:
- MQA:所有头共享单一K、V(激进策略)
- GQA:分组共享K、V(平衡策略)
- AsymGQA:非对称分组
- Weighted GQA:带权重的GQA
- QCQA:进化算法优化分组
- KDGQA:动态键驱动分组
- GQKVA:广义Q、K、V分组
跨层共享:
- CLA:跨层注意力共享
- LCKV/SA/MLKV:不同层间KV共享
- LISA/DHA/SVFormer:轻量级适配
5.2 架构改进
增强注意力:
- MLA(DeepSeek-V2):多头潜在注意力
- FLASH:快速注意力
- Infini-Attention:无限上下文注意力
增强架构:
- YOCO:双块注意力
- CEPE:上下文并行编码
- XC-Cache/Block Transformer:块级优化
5.3 非Transformer架构
自适应序列处理:
- RWKV:线性复杂度RNN
- Mamba:选择性状态空间模型
- RetNet:保留网络
- MCSD:多尺度动态
混合架构:
- MixCon:混合Transformer+RNN
- GoldFinch/RecurFormer:递归Transformer
六、系统级优化
6.1 内存管理
架构设计:
- vLLM(PagedAttention):OS启发的分页KV缓存
- vTensor:虚拟内存抽象
- LeanKV:统一分页+异构量化
前缀感知设计:
- ChunkAttention:块级前缀共享
- MemServe:分布式KV缓存管理
6.2 调度策略
前缀感知调度:
- BatchLLM:批量前缀复用
- RadixAttention:基数注意力调度
抢占式调度:
- FastServe/FastSwitch:公平上下文切换
层级调度:
- LayerKV/CachedAttention:层感知调度
- ALISA/LAMPS:层级资源分配
6.3 硬件加速设计
单/多GPU设计:
- vLLM/ORCA/DistServe:分布式推理
- HydraGen/DeFT:高效GPU利用
I/O优化:
- FlashAttention:内存高效注意力
- Bifurcated/HCache/Cake:缓存优化
异构计算:
- NEO/FlexInfer/Pensieve:GPU-CPU-Disk分层
- FastServe/FastDecode:异构调度
SSD优化:
- FlexGen/InstInfer:SSD卸载
七、核心创新总结
Token级优化对比
| 方法类别 | 代表方法 | 核心思想 | 优势 | 局限 |
|---|---|---|---|---|
| KV选择 | H2O, SnapKV | 选择重要token | 内存节省 | 信息丢失 |
| 预算分配 | PyramidKV, AdaKV | 差异化分配 | 更优资源利用 | 需要启发式 |
| KV合并 | CaM, KVMerger | 合并相似token | 保留信息 | 计算开销 |
| KV量化 | KIVI, ZipCache | 降低精度 | 内存节省 | 精度损失 |
| 低秩分解 | LoRC, Palu | 低秩近似 | 内存节省 | 近似误差 |
模型级优化对比
| 方法类别 | 代表方法 | 核心思想 | 是否需要重训练 |
|---|---|---|---|
| 层内分组 | MQA, GQA | 头级KV共享 | 需要/微调 |
| 跨层共享 | CLA, MLKV | 层间KV共享 | 需要 |
| 增强注意力 | MLA, Infini-Attention | 新注意力机制 | 需要 |
| 非Transformer | RWKV, Mamba | 替代架构 | 需要 |
系统级优化对比
| 方法类别 | 代表方法 | 核心思想 | 适用场景 |
|---|---|---|---|
| 内存管理 | vLLM, LeanKV | 分页/虚拟内存 | 通用推理 |
| 调度优化 | RadixAttention, FastServe | 前缀复用/公平调度 | 多用户服务 |
| 硬件加速 | FlashAttention, FlexGen | I/O优化/异构计算 | 高性能推理 |
八、评估数据集
文本数据集
| 任务类型 | 数据集 | 平均长度 | 语言 |
|---|---|---|---|
| 单文档QA | Qasper, MultifieldQA | 3.6K-6.7K | EN/ZH |
| 多文档QA | HotpotQA, MuSiQue | 0.6K-11K | EN |
| 摘要 | GovReport, MultiNews | 5K-26K | EN |
| 推理 | 2WikiMultihopQA, MuSiQue | 0.6K-1.8K | EN |
| 检索 | NewsQA, HotpotQA | 3.7K-11K | EN/ZH |
| 生成 | LCC, RepoBench-P | 4K-13K | Code |
多模态数据集
支持长视频、长文档、高分辨率图像等多模态评估。
九、总结
核心贡献
- 系统分类体系:首次提出Token级-模型级-系统级三层优化分类
- 全面覆盖:涵盖200+篇相关论文
- 深入分析:每个方法的原理、优势和局限
- 实用指导:为实际部署提供选择建议
技术趋势
- Token级:从静态选择到动态选择,从token粒度到块/簇粒度
- 模型级:从MQA到GQA到MLA,从层内到跨层共享
- 系统级:从单一GPU到异构计算,从本地到分布式
实际部署建议
| 场景 | 推荐方法 |
|---|---|
| 内存受限 | KV量化(KIVI)+ KV选择(H2O) |
| 延迟敏感 | FlashAttention + vLLM + 前缀缓存 |
| 长上下文 | KV合并 + 层级分配 + SSD卸载 |
| 多用户服务 | RadixAttention + 抢占式调度 |
| 高吞吐 | GQA/MQA + 批量调度 + 分布式推理 |
未来方向
- 更高效的在线算法:减少选择/合并的计算开销
- 自适应策略:根据输入动态调整优化策略
- 跨模态KV缓存:统一文本、图像、视频的KV管理
- 硬件协同设计:算法与硬件的联合优化