Scaling Deep Learning Training with MPMD Pipeline Parallelism
提出MPMD流水线并行训练方法,通过JAX/XLA编译器优化实现大规模深度学习训练的高效扩展。
Scaling Deep Learning Training with MPMD Pipeline Parallelism
一、论文概述 (Overview)
| 项目 | 内容 |
|---|---|
| 标题 | Scaling Deep Learning Training with MPMD Pipeline Parallelism |
| 作者 | Anxhelo Xhebraj, Sean Lee, Hanfeng Chen, Vinod Grover |
| 机构 | NVIDIA (推测) |
| 提交日期 | 2024-12-18 |
| 会议 | MLSys 2025 (Under Review) |
| arXiv | 2412.14374 |
| 关键词 | 流水线并行、MPMD、分布式训练、JAX/XLA、大规模模型 |
摘要
本文提出了 JaxPP,一个用于高效扩展大规模深度学习模型训练的系统,支持灵活的流水线并行(Pipeline Parallelism)。JaxPP 引入了一个无缝的编程模型,允许用户自定义梯度累积的流水线调度策略。系统自动将任务(对应流水线阶段)分配到集群节点,并自动推断节点间的通信。JaxPP 实现了一个 MPMD 运行时,用于异步执行 SPMD 任务。实验表明,JaxPP 的流水线并行实现相比最佳 SPMD 配置,可将硬件利用率提升最高 1.11 倍。
二、核心思想 (Core Idea)
2.1 问题背景
大规模深度学习模型训练需要组合多种并行策略:
- 数据并行 (Data Parallelism, DP):将数据分片到多个设备
- 张量并行 (Tensor Parallelism, TP):将单个算子分片到多个设备
- 流水线并行 (Pipeline Parallelism, PP):将模型的不同层分配到不同设备
现有的 GSPMD(Google’s Scalable Partitioner for MD)编程模型采用 SPMD(Single Program Multiple Data) 模式,虽然简化了并行化过程,但存在关键限制:
- SPMD 模式限制:只能实现一种流水线并行变体,无法支持需要 MPMD 范式的流水线调度
- 高带宽依赖:SPMD 的集合通信操作需要高带宽连接(如 NVSwitch、ICI),难以扩展到低带宽域
- 调度灵活性不足:无法实现多种改进吞吐量和内存使用的流水线调度策略
2.2 核心洞察
JaxPP 的核心洞察是:通过从 SPMD 扩展到 MPMD 模式,可以解锁更灵活的流水线并行策略,从而:
- 支持用户自定义的流水线调度(如 Interleaved 1F1B、GPipe 等)
- 实现异步的点对点通信,减少同步开销
- 在低带宽连接(如 DCN)下仍能高效运行
- 将并行策略与模型实现解耦,提高代码复用性
三、技术架构 (Technical Architecture)
3.1 系统概览
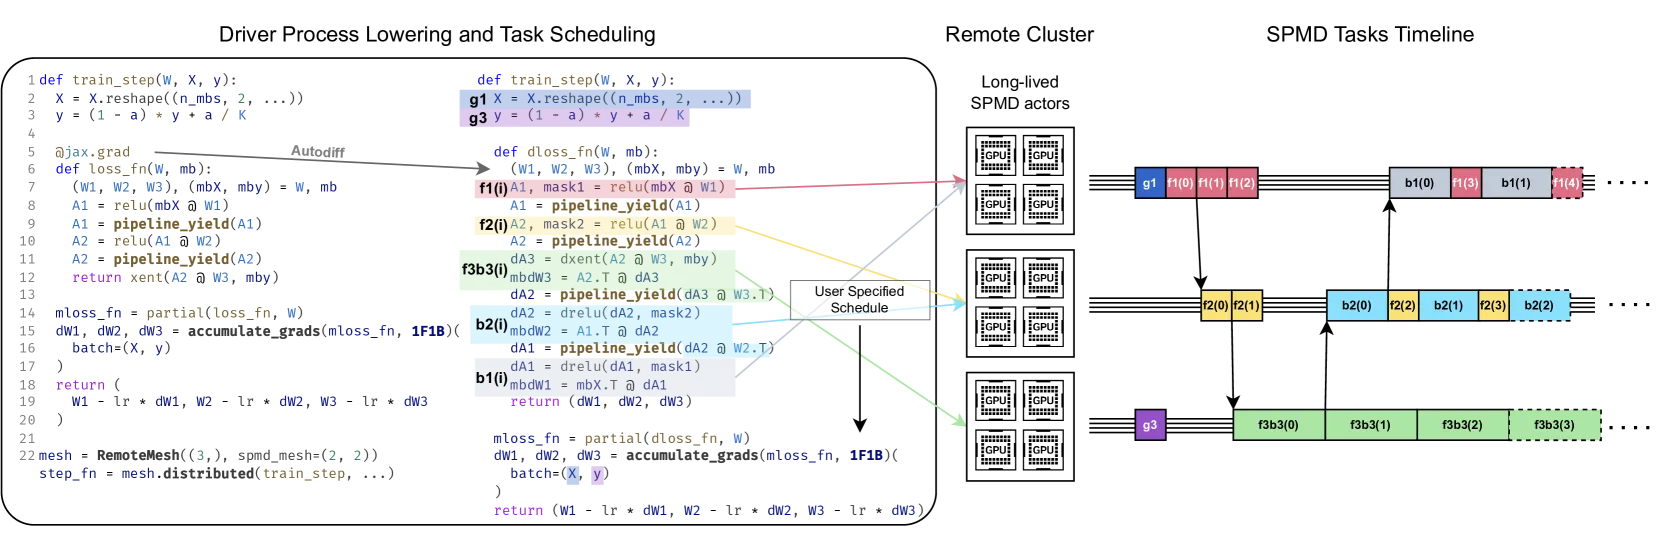 Figure 2: JaxPP 系统概览。左侧展示了驱动进程中描述计算并标注流水线阶段边界的代码。自动微分产生对应的”反向”计算阶段。用户指定阶段到 SPMD Actor 的映射和调度策略。
JaxPP 的架构包含以下核心组件:
| 组件 | 功能描述 |
|---|---|
| Driver Process | 用户代码运行环境,负责追踪、转换和分发任务 |
| SPMD Actors | 远程执行单元,每个 Actor 管理一组设备的 SPMD 执行 |
| Task Graph | 任务图,描述任务间的依赖和通信关系 |
| MPMD Runtime | 异步执行引擎,协调多个 SPMD Actor 的并行执行 |
| Remote Mesh | 远程设备网格,管理分布式设备资源 |
3.2 编程模型
JaxPP 的编程模型基于 JAX 的命名轴(Named Axes)机制,通过轻量级的分片注解实现并行化:
@shard(("batch","emb"), ("emb","mlp"), ("mlp","emb"))
def ffn(X, W1, W2):
    H1 = relu(X @ W1)
    H1 = shard(H1, ("batch", "mlp"))
    H2 = H1 @ W2
return shard(H2, ("batch", "emb"))关键特性:
- 逻辑轴名与物理网格轴的映射是可配置的
- 同一份代码可以根据不同的网格形状实例化为不同的并行策略
- 并行化策略与模型实现完全解耦
3.3 流水线阶段标注
用户通过 pipeline_yield 标记流水线阶段边界:
def train_step(state, batch):
    def microbatch_grads(microbatch):
        loss, grads = forward_backward(state, microbatch)
        pipeline_yield  # 标记阶段边界
        return grads, loss

    grads, metrics = accumulate_grads(microbatch_grads)(batch)
    new_state = apply_gradients(state, grads)
    return new_state, metrics
自动微分会自动为每个 pipeline_yield 产生对应的前向和反向阶段。
四、核心创新 (Core Innovations)
4.1 梯度累积循环 (Gradient Accumulation Loop)
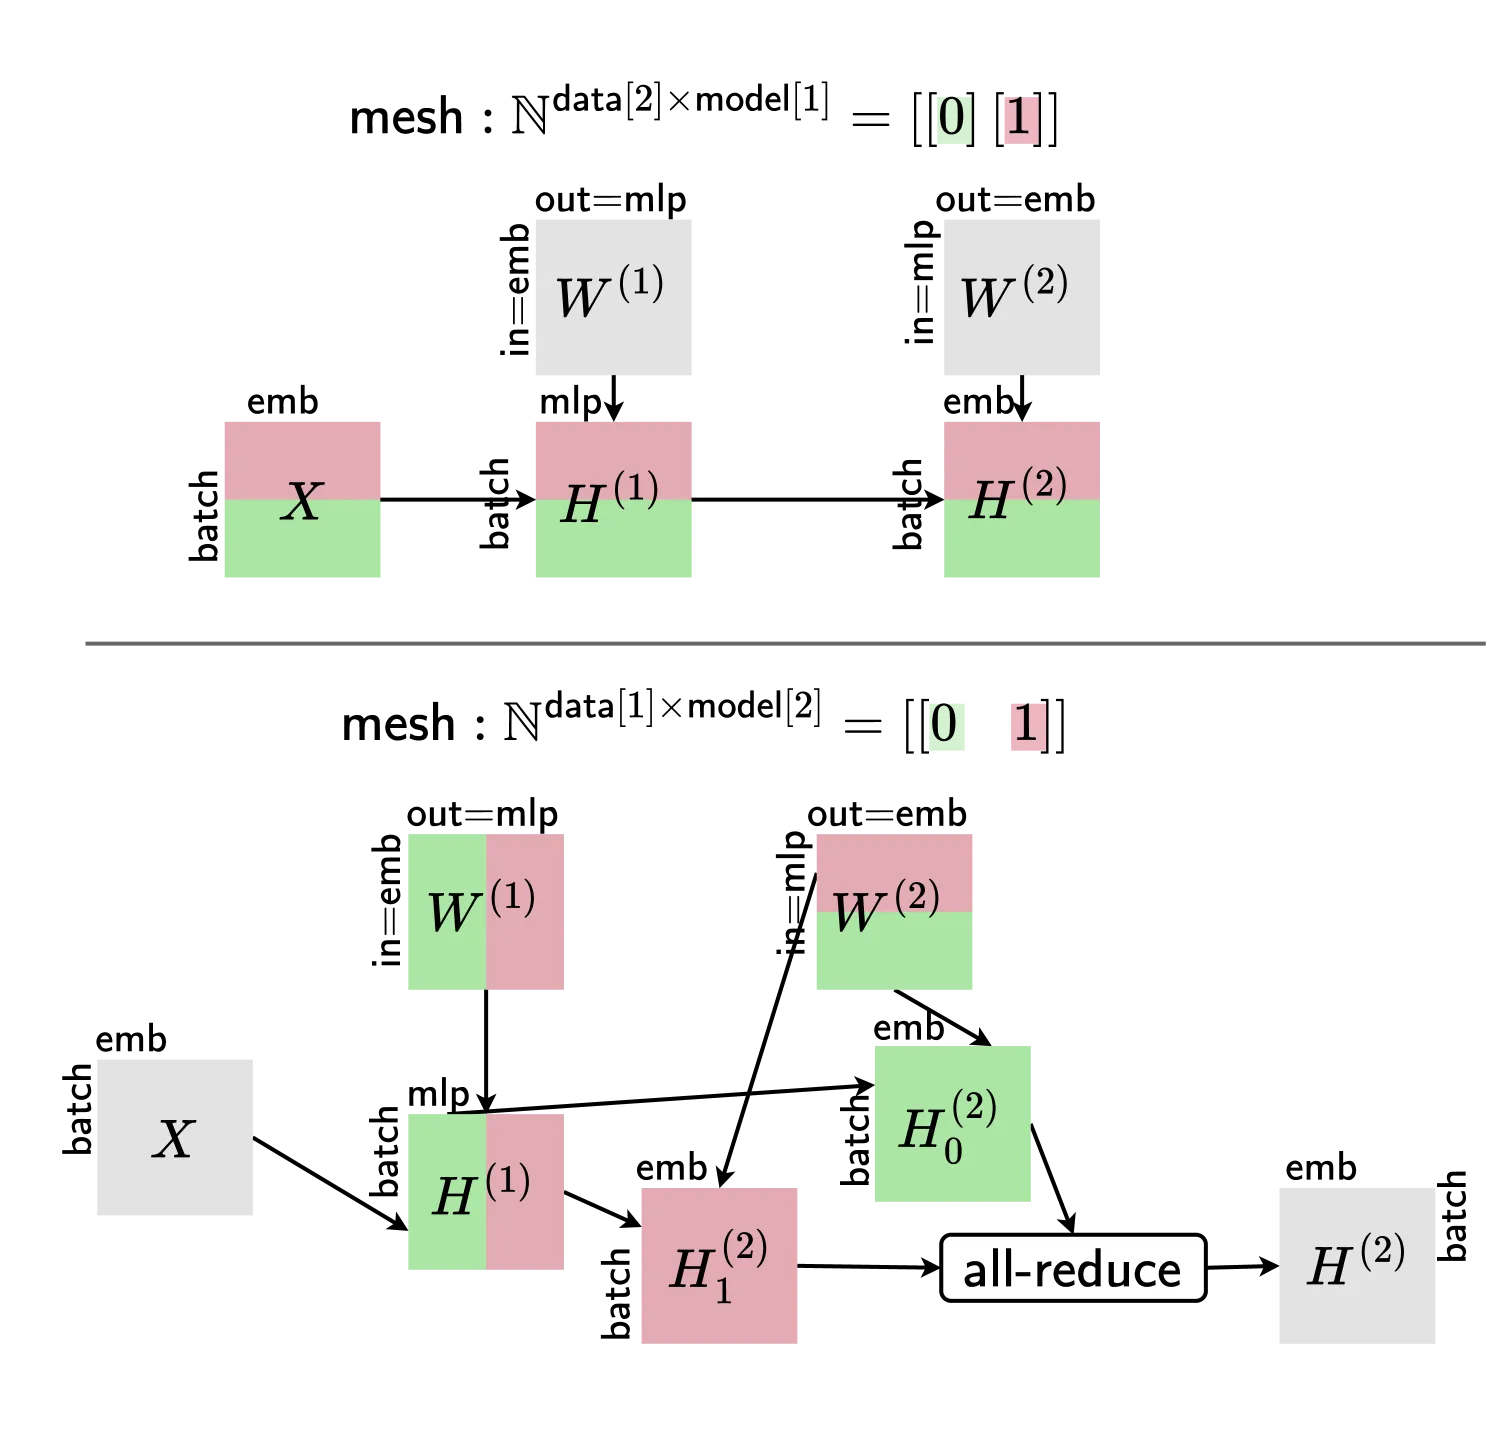 Figure 1: 通过命名轴实现可配置的并行策略。左上:带逻辑轴名标注的模型实现。左下:分区规范。右侧:不同网格形状下的并行实例化。
JaxPP 引入了 accumulate_grads 原语,无缝集成用户定义的调度策略:
- 语义:对每个微批次调用梯度计算函数,累加梯度并收集损失
- 灵活性:支持任意的微批次调度策略
- 透明性:用户无需手动管理跨阶段通信
4.2 任务图实现 (Task Graph Implementation)
JaxPP 的任务图系统负责:
| 功能 | 描述 |
|---|---|
| 任务调度 | 将任务分配到分布式设备网格 |
| 通信推断 | 自动推断任务间的 Send/Receive 操作 |
| 资源管理 | 处理缓冲区分配和释放 |
| 任务融合 | 将所有任务融合为单个 MPMD “程序” |
4.3 MPMD 运行时 (MPMD Runtime)
JaxPP 实现了单控制器(Single-Controller)MPMD 运行时:
- 异步执行:支持 SPMD 任务的异步并行执行
- 灵活调度:支持任意用户指定的流水线调度策略
- 高效通信:异步点对点 Send/Receive,避免同步开销
- 阶段映射:支持用户可扩展的阶段执行映射(如 Interleaved 1F1B)
4.4 与现有系统的对比
| 特性 | JaxPP | Alpa | Pathways | Megatron/NeMo |
|---|---|---|---|---|
| 并行策略 | 用户控制 | 自动推断 | 固定 | 手动实现 |
| MPMD 支持 | 是 | 是 | 是 | 否 |
| 编程模型 | JAX + 注解 | JAX 改造 | JAX | PyTorch |
| 编译时间 | 短 | 长(搜索) | 中 | 短 |
| 模型无关性 | 是 | 是 | 是 | 否 |
| 调度灵活性 | 高 | 中 | 低 | 低 |
五、实验结果 (Experimental Results)
5.1 实验设置
| 配置项 | 详情 |
|---|---|
| 硬件 | NVIDIA EOS 集群,DGX H100 节点 |
| GPU | 8x H100 80GB per node |
| 互联 | InfiniBand NDR400 |
| 模型 | GPT-3 175B, Llama2 70B |
| 精度 | BF16 |
| 序列长度 | GPT-3: 2048, Llama2: 4096 |
5.2 性能特征
交错/循环重复与调度开销
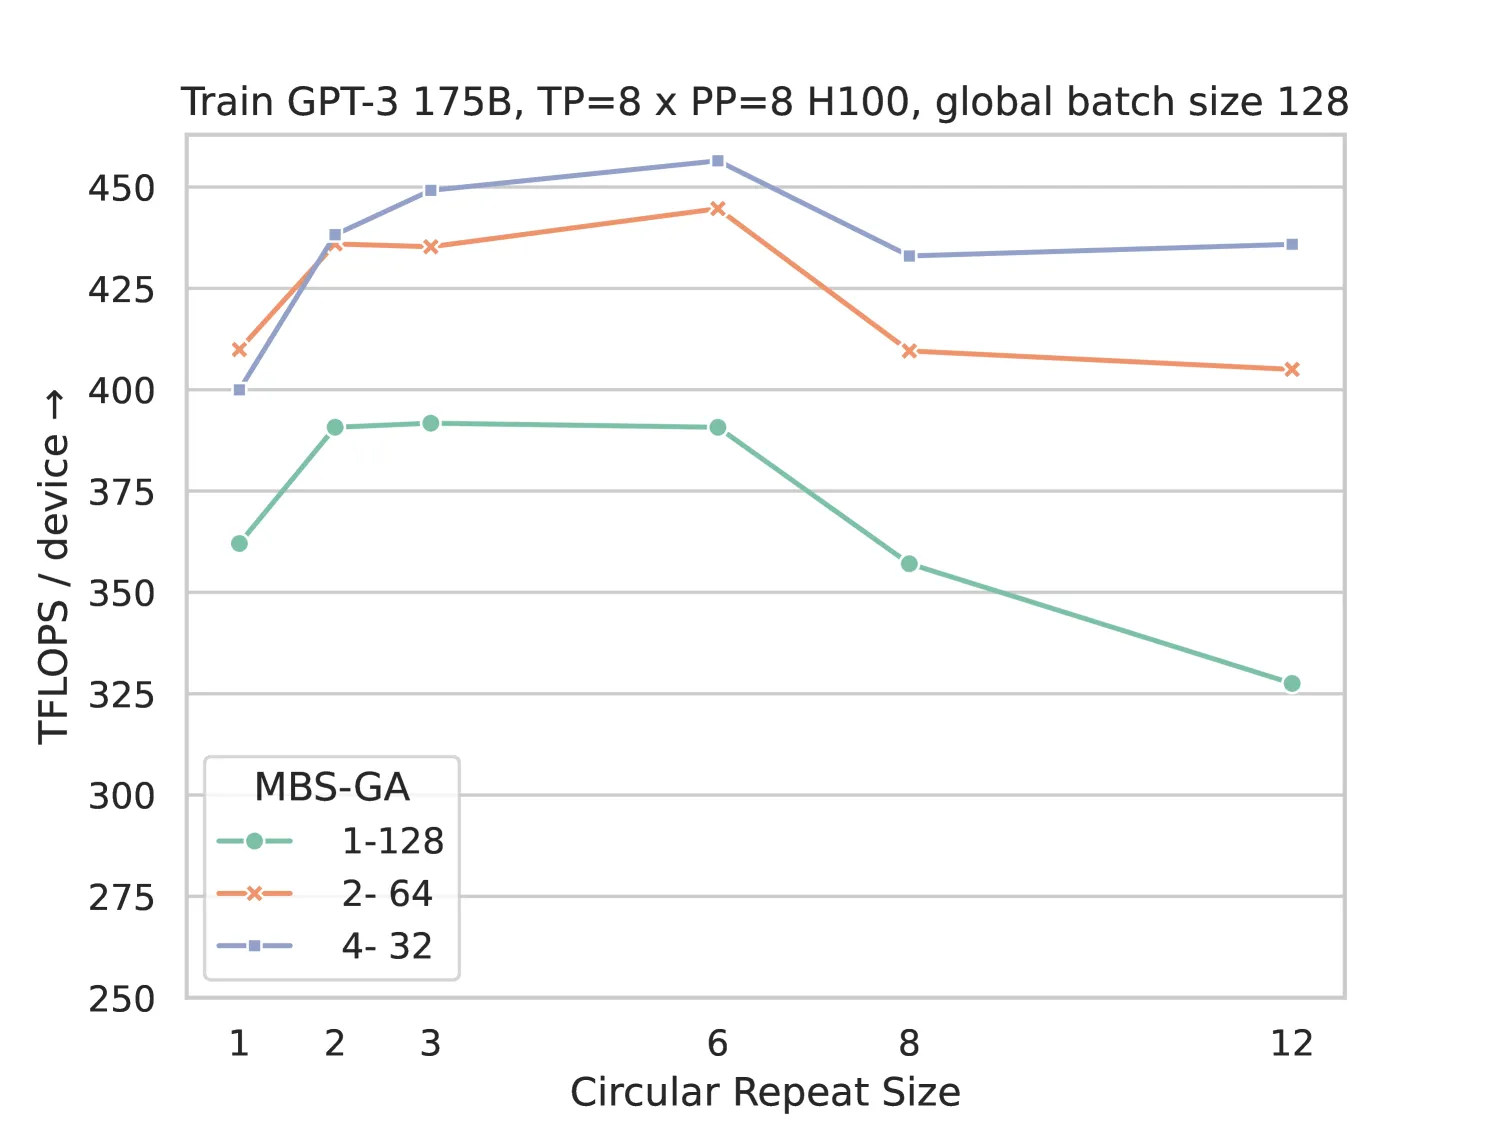 Figure 3: GPT-3 175B 在 64 GPU 上的训练性能,全局批大小 128,不同交错/循环重复和微批次大小配置。
关键发现:
- 增加循环重复(Circular Repeat)可减少流水线气泡,但过小的任务会增加 XLA 调度开销
- 较大的微批次可减少集合通信次数,但会增加气泡时间
- 存在最优的循环重复和微批次大小配置
利用率权衡
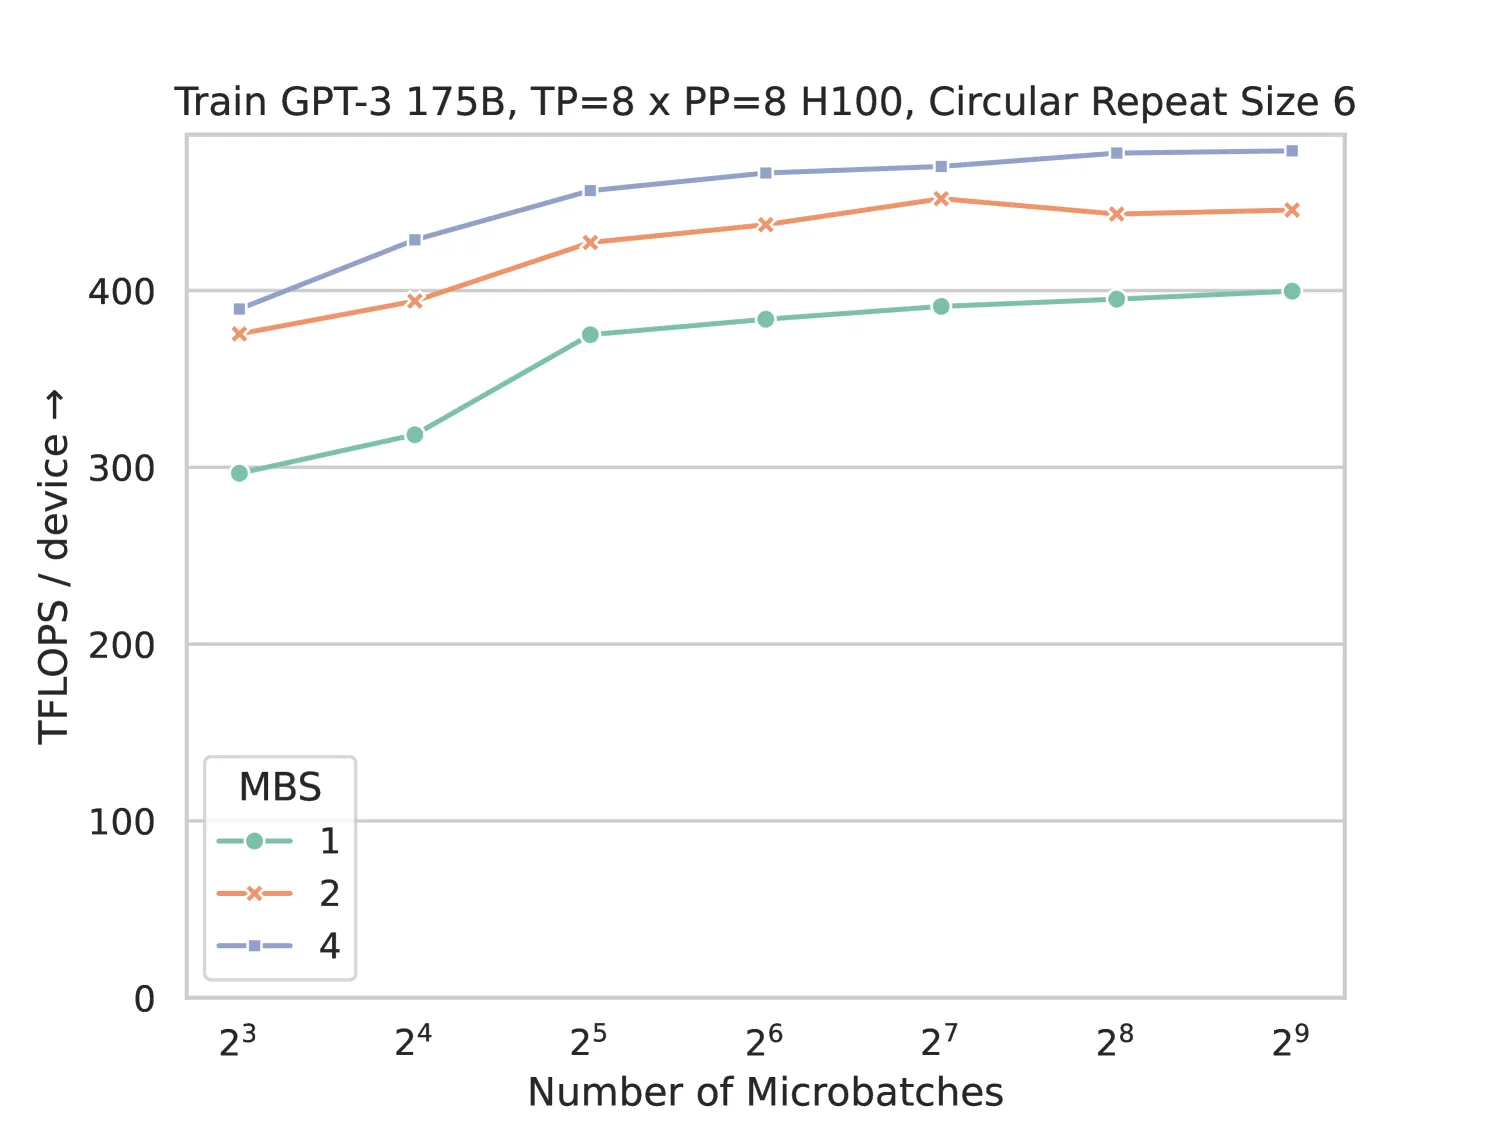 Figure 4: GPT-3 175B 在 64 GPU 上的性能,循环重复大小 6,不同梯度累积和微批次大小组合。
5.3 可扩展性
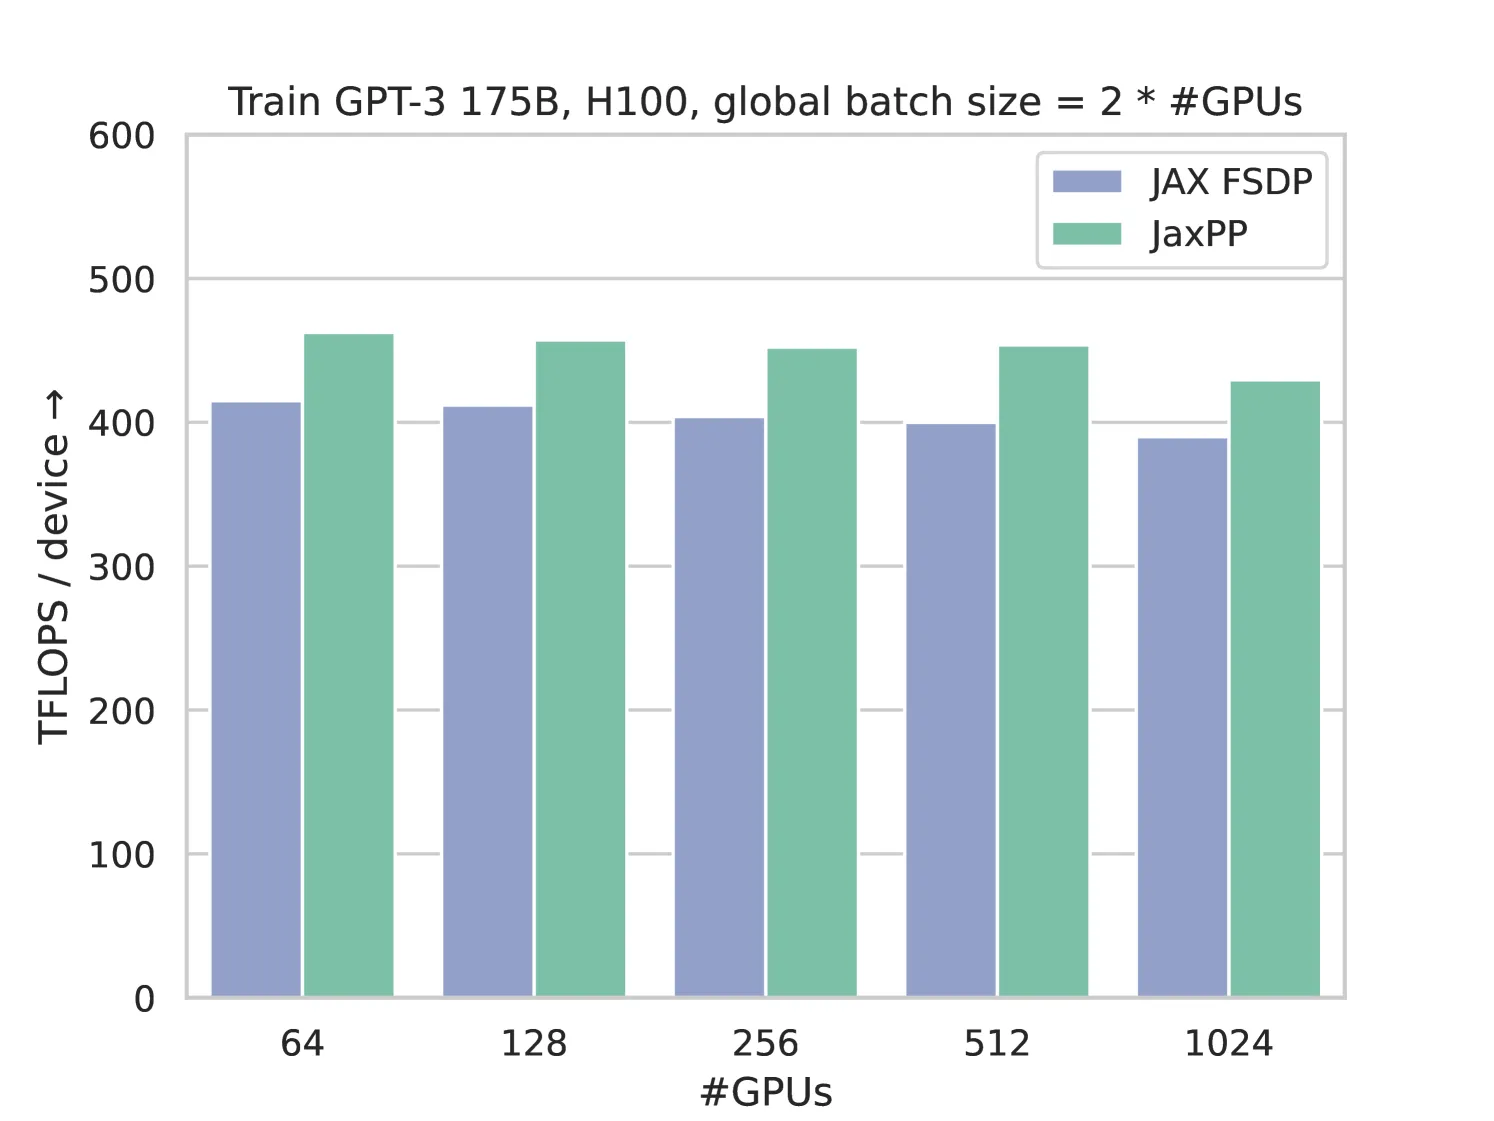 Figure 5: JaxPP 的弱扩展性与高度优化的 JAX FSDP 实现对比。
弱扩展性结果:
| 指标 | JaxPP | JAX FSDP |
|---|---|---|
| 扩展效率 | 92.87% | 93.97% |
| GPU 范围 | 64 → 1024 | 64 → 1024 |
| 批大小 | 128 → 2048 | 128 → 2048 |
JaxPP 不仅匹配 FSDP 的扩展效率,还提供更高的吞吐量和更低的端到端延迟。
5.4 训练性能对比
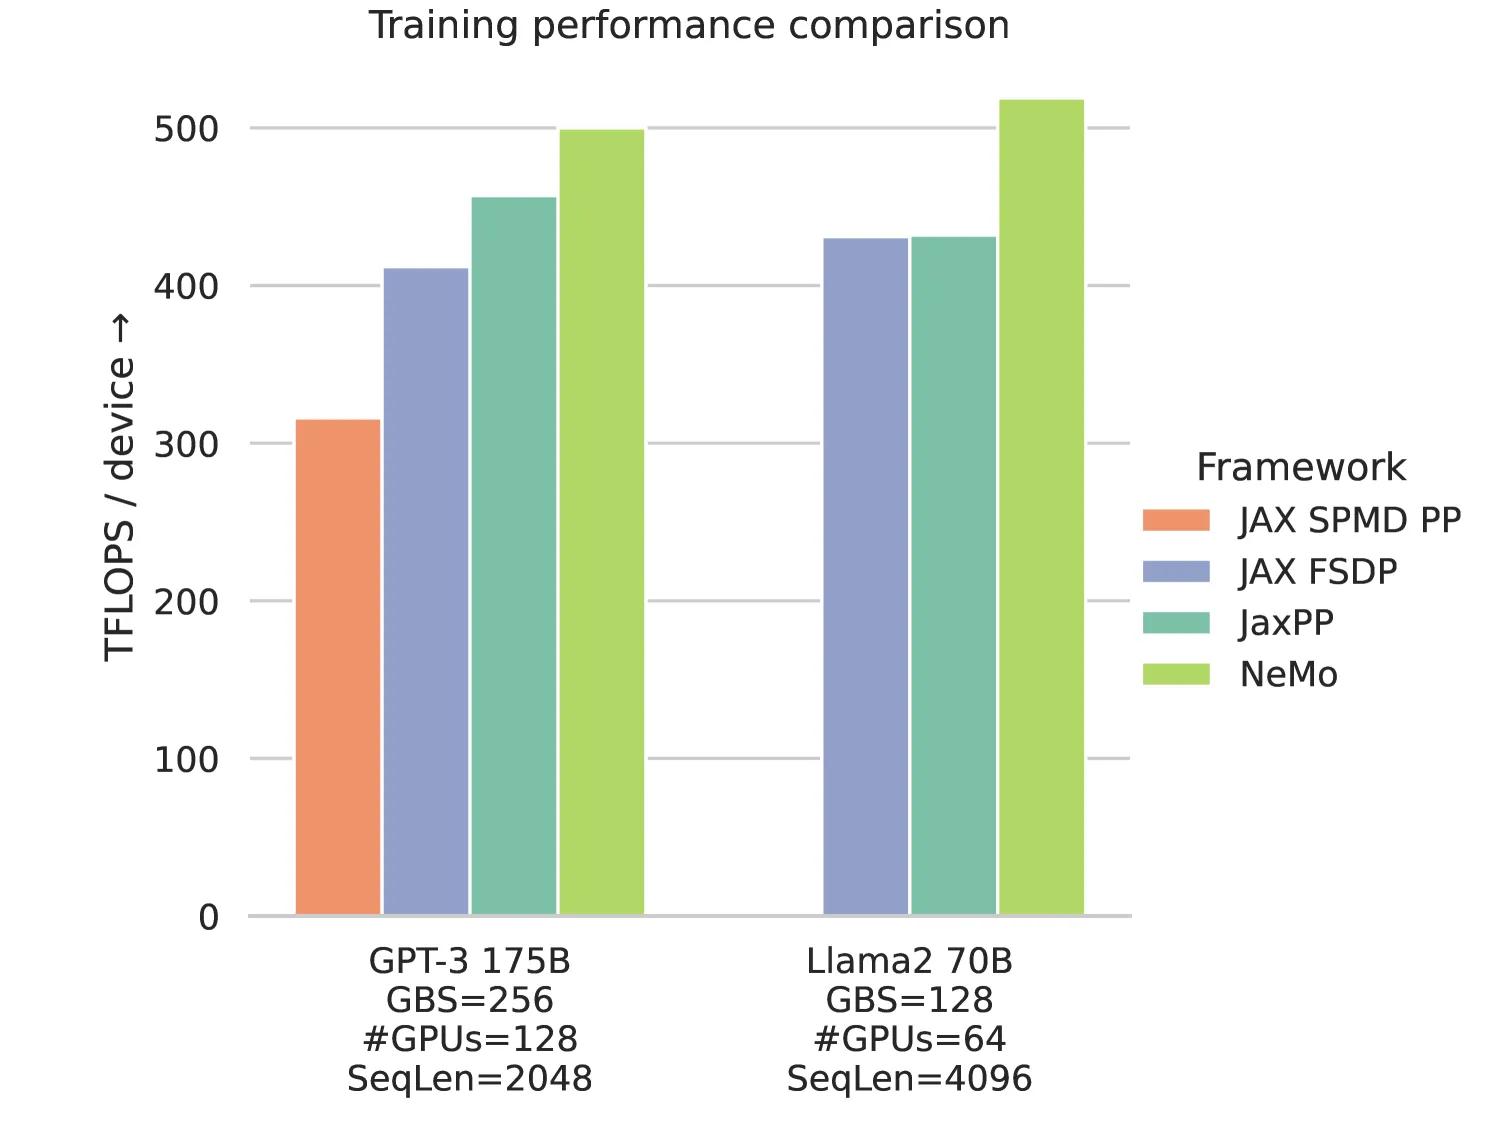 Figure 6: SPMD 流水线并行、JaxPP 和 NeMo 在 GPT-3 175B 和 Llama2 70B 上的性能对比。
GPT-3 175B 性能数据:
| 系统 | 批大小 | GPU | PP | TP | DP | 步时间(s) | TFLOPS/device |
|---|---|---|---|---|---|---|---|
| JaxPP | 128 | 64 | 8 | 8 | 1 | 9.53 | 462 |
| JaxPP | 256 | 128 | 8 | 8 | 2 | 9.64 | 457 |
| JaxPP | 512 | 256 | 8 | 8 | 4 | 9.74 | 452 |
| JaxPP | 1024 | 512 | 8 | 8 | 8 | 9.71 | 454 |
| JaxPP | 2048 | 1024 | 8 | 8 | 16 | 10.26 | 430 |
| JAX FSDP | 128 | 64 | 1 | 1 | 1 | 10.63 | 415 |
| JAX FSDP | 2048 | 1024 | 1 | 1 | 8 | 11.30 | 390 |
| JAX SPMD PP | 256 | 128 | 16 | 4 | 2 | 13.96 | 316 |
| NeMo | 256 | 128 | 8 | 4 | 4 | 9.78 | 500 |
Llama2 70B 性能数据:
| 系统 | 批大小 | GPU | PP | TP | DP | 步时间(s) | TFLOPS/device |
|---|---|---|---|---|---|---|---|
| JaxPP | 128 | 64 | 4 | 8 | 2 | 8.42 | 432 |
| JAX FSDP | 128 | 64 | 1 | 1 | 1 | 8.44 | 431 |
| NeMo | 128 | 64 | 4 | 4 | 4 | 7.02 | 519 |
5.5 性能提升分析
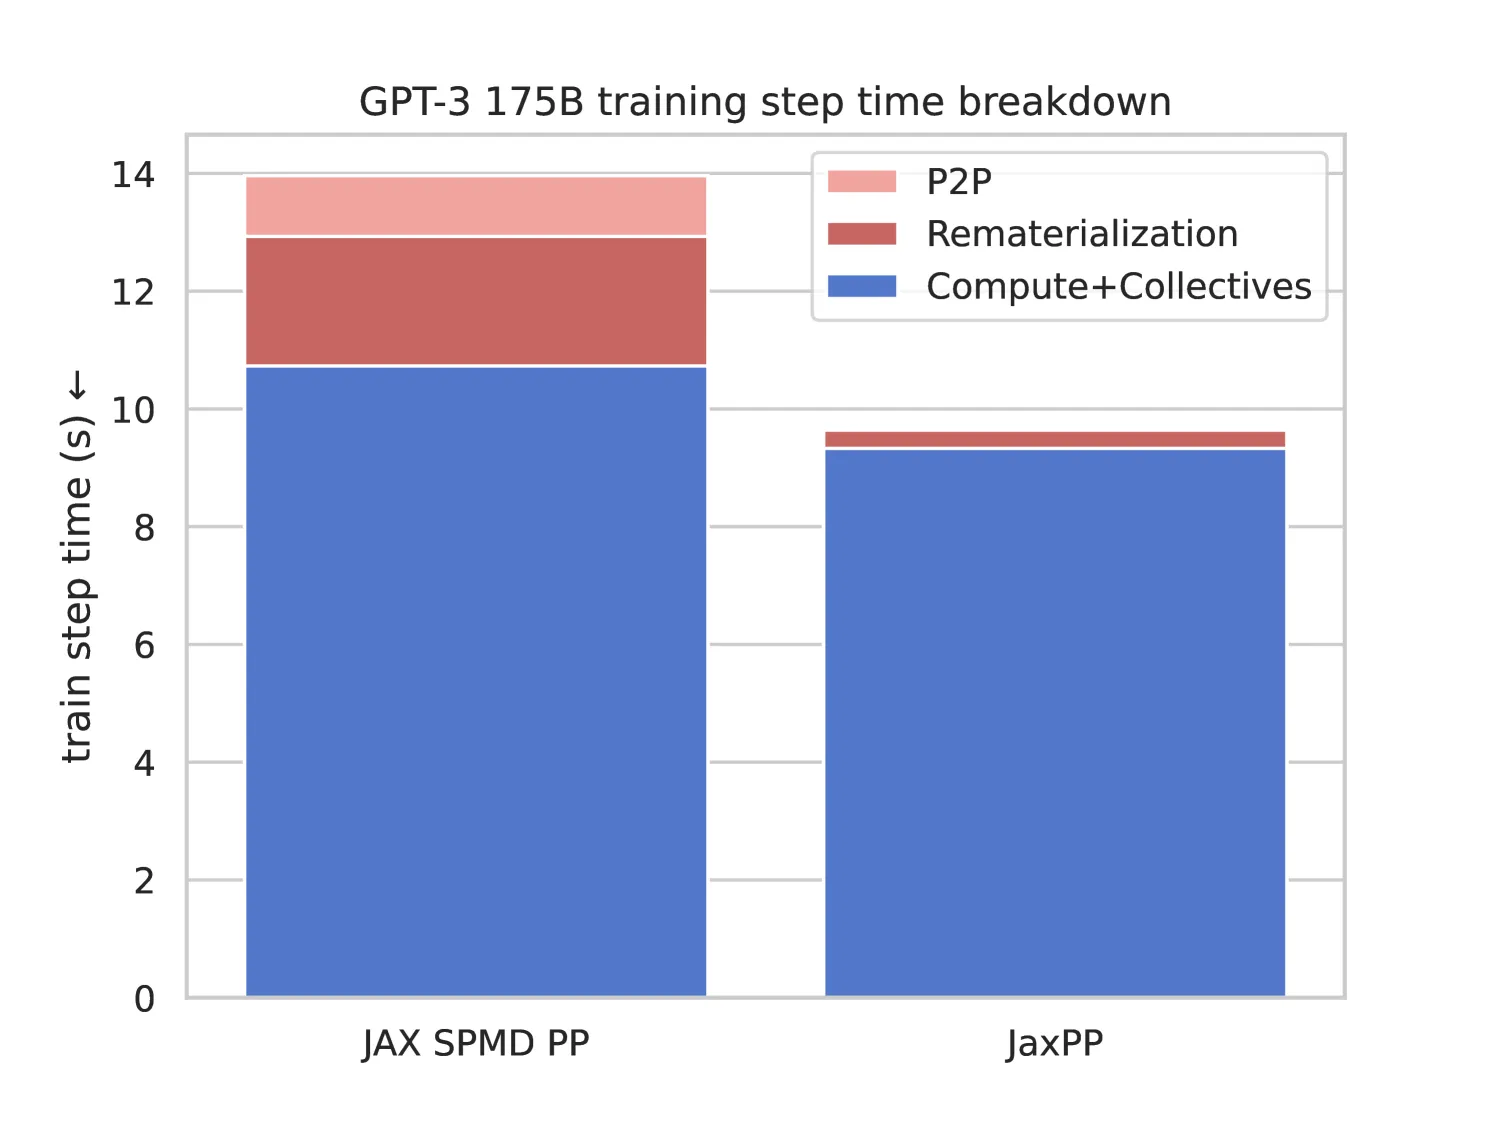 Figure 7: JAX SPMD PP 与 JaxPP 的开销对比。重计算成本和异步点对点通信是性能差异的主要来源。
JaxPP vs SPMD PP 性能提升分解:
| 优化项 | 贡献 |
|---|---|
| 减少重计算 | ~20% (Interleaved 1F1B vs GPipe) |
| 异步 P2P 通信 | 显著减少同步等待 |
| 整体提升 | 44.6% (128 GPU GPT-3 175B) |
关键性能数据:
- JaxPP vs SPMD PP: 快 44.6% (GPT-3 175B, 128 GPU)
- JaxPP vs JAX FSDP: 1.11x 吞吐量提升 (GPT-3 175B)
- JaxPP vs NeMo: 91.4% 吞吐量 (GPT-3 175B, 无自定义 kernel)
- 代码量减少:少 1000+ 行用户代码
六、相关工作 (Related Work)
6.1 直接相关系统
| 系统 | 主要特点 | 与 JaxPP 的差异 |
|---|---|---|
| GSPMD/XLA | SPMD 并行化,轻量注解 | 仅支持 SPMD,无法实现 MPMD 流水线 |
| Alpa | 自动推导最优并行策略 | 编译时间长,需要 fork JAX/XLA |
| Pathways | 异步分布式数据流 | 专注于时间共享和多路复用 |
| Megatron-LM | 高度优化的手动实现 | 模型特定,不通用 |
| DeepSpeed | ZeRO 优化器 + 流水线 | 需要手动并行化 |
| NeMo | NVIDIA 训练框架 | 依赖自定义高性能 kernel |
6.2 流水线调度研究
JaxPP 的设计支持多种流水线调度策略:
| 调度策略 | 特点 | JaxPP 支持 |
|---|---|---|
| GPipe | 简单,高内存需求 | 是 |
| 1F1B | 交错前向/反向,减少内存 | 是 |
| Interleaved 1F1B | 更细粒度交错 | 是 |
| Circular 1F1B | 循环重复阶段 | 是 |
| Zero Bubble | 零气泡调度 | 可扩展支持 |
| Breadth-First | 广度优先调度 | 可扩展支持 |
6.3 新兴研究方向
论文指出 JaxPP 的架构可支持以下新兴研究:
- Lamy-Poirier (2022) - 新型流水线调度
- Huang et al. (2024) - 改进的流水线策略
- Lin et al. (2024) - 流水线并行新方法
- Qi et al. (2024) - 流水线并行应用
七、总结 (Summary)
7.1 主要贡献
- 新颖的编程模型:无缝表达流水线并行,无需用户干预跨阶段通信
- 任务图实现:自动调度、通信推断和资源管理
- MPMD 运行时:支持任意用户指定的流水线调度策略
- 实践验证:在大规模训练基准上展示性能优势
7.2 技术优势
| 优势 | 说明 |
|---|---|
| 灵活性 | 支持任意 MPMD 流水线调度 |
| 易用性 | 并行策略与模型实现解耦 |
| 性能 | 比 SPMD PP 快 44.6%,比 FSDP 快 1.11x |
| 可扩展性 | 92.87% 弱扩展效率 (64→1024 GPU) |
| 通用性 | 模型无关,无需自定义 kernel |
7.3 局限性
- 与 NeMo 的差距:在 Llama2 70B 上仅达到 NeMo 83.2% 的吞吐量
- Kernel 优化:未使用自定义高性能 kernel(除 cuDNN attention)
- 调度开销:极小任务时 XLA 调度开销明显
- 平台依赖:目前仅实现于 JAX/XLA 生态
7.4 未来方向
- MLIR 集成:将核心思想实现为 MLIR dialect
- 跨平台支持:扩展到其他编译器和运行时技术
- 新型调度:支持更多新兴的流水线调度策略
- Kernel 优化:集成高性能自定义 kernel
八、参考资源 (References)
论文资源
| 资源 | 链接 |
|---|---|
| arXiv | https://arxiv.org/abs/2412.14374 |
| https://arxiv.org/pdf/2412.14374 | |
| HTML | https://arxiv.org/html/2412.14374v1 |
关键参考文献
| 参考文献 | 主题 |
|---|---|
| Brown et al. (2020) | GPT-3: Language Models are Few-Shot Learners |
| Xu et al. (2021) | GSPMD: General and Scalable Parallelization for ML |
| Shoeybi et al. (2020) | Megatron-LM: Training Multi-Billion Parameter Models |
| Barham et al. (2022) | Pathways: Asynchronous Distributed Dataflow for ML |
| Zheng et al. (2022) | Alpa: Automating Inter- and Intra-Operator Parallelism |
| Smith et al. (2022) | DeepSpeed: System Optimizations Enable Training |
| Narayanan et al. (2021) | Efficient Large-Scale Language Model Training |
| Huang et al. (2019) | GPipe: Efficient Training of Giant Neural Networks |
相关工具和框架
| 工具 | 说明 |
|---|---|
| JAX | Google 的高性能数值计算库 |
| XLA | 加速线性代数编译器 |
| GSPMD | XLA 中的可扩展分区器 |
| Megatron-LM | NVIDIA 的大模型训练框架 |
| NeMo | NVIDIA 的对话 AI 工具包 |
| DeepSpeed | 微软的深度学习优化库 |
图表索引
| 图表 | 文件 | 描述 |
|---|---|---|
| Figure 1 | x1.png | 命名轴并行配置 |
| Figure 2 | x2.png | 系统概览 |
| Figure 3 | x3.png | 交错/循环重复性能 |
| Figure 4 | x4.png | 利用率权衡 |
| Figure 5 | x5.png | 弱扩展性 |
| Figure 6 | x6.png | 性能对比 |
| Figure 7 | x7.png | 性能分解 |


分析生成时间: 2025-01