SCOPE: Optimizing Key-Value Cache Compression in Long-context Generation
分离prefill和decoding阶段的KV缓存压缩框架,解决长文本生成中的heavy hitter偏移问题
SCOPE: Optimizing Key-Value Cache Compression in Long-context Generation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SCOPE: Optimizing Key-Value Cache Compression in Long-context Generation |
| 作者 | Jialong Wu, Zhenglin Wang, Linhai Zhang, Yilong Lai, Yulan He, Deyu Zhou |
| 机构 | Southeast University, King’s College London, The Alan Turing Institute |
| 论文 | arXiv:2412.13649 |
| 发布 | 2024-12-18 |
| 主题 | cs.CL (Computation and Language) |
| 基准 | LoNGGENBENCH |
二、核心思想
问题定义
KV缓存已成为LLM长上下文生成的瓶颈。尽管已有大量工作,但解码阶段的优化普遍被忽视。
两个关键观察:
观察(i):Prefill阶段过度压缩损害推理能力
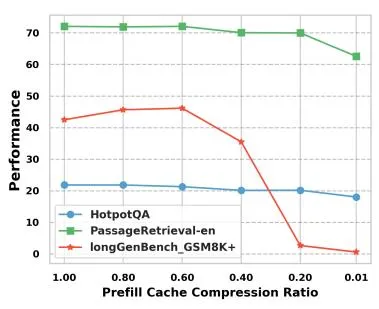
Figure 2a: 不同压缩率下三个任务的性能(full decoding cache条件)。
- PassageRetrieval-en和HotpotQA:20%压缩率仍保持接近full cache性能
- GSM8K+推理任务:20%压缩率导致95%性能下降
- 结论:需要精细上下文的任务,过度压缩严重损害性能
观察(ii):Heavy Hitter在解码阶段发生偏移
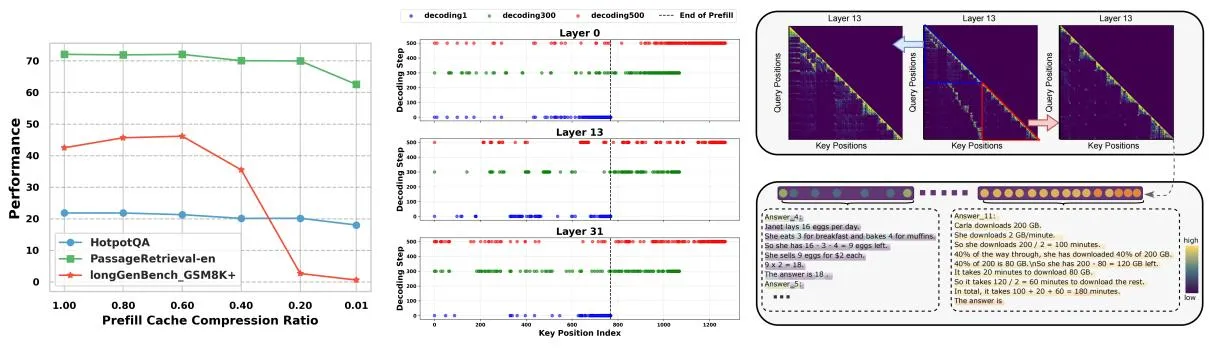
Figure 2b: 解码步骤1、300、500时heavy hitters的位置分布。
- 保留的heavy hitters主要来自解码阶段生成的KV缓存
- 贪婪算法选择的heavy hitters发生偏移
- 长输出任务中偏移更加明显
核心洞察
洞察:分别分配prefill和decoding阶段的KV缓存预算至关重要。
解决方案概述
SCOPE:分别在prefill和decoding阶段执行KV缓存优化的框架。
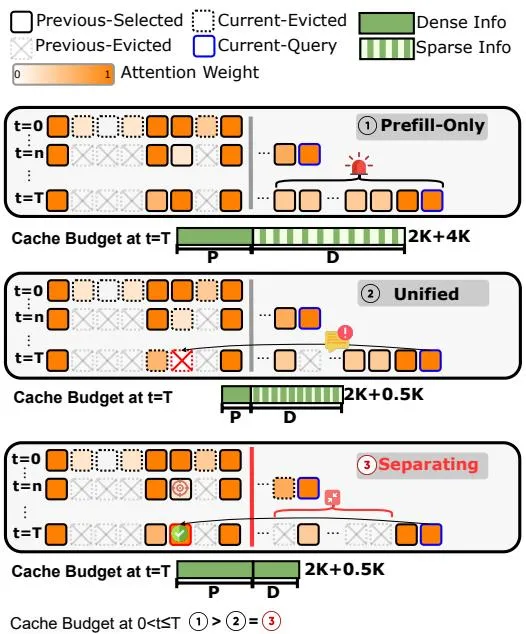
Figure 1: 三种解码阶段压缩范式示意图(4K输入+4K输出)。
三种压缩方法对比:
| 方法 | 特点 | 问题 |
|---|---|---|
| Prefill-Only | 仅压缩prefill阶段 | 线性缓存增长,内存压力大 |
| Unified | 统一压缩两阶段 | Heavy hitter偏移,丢失prefill信息 |
| SCOPE | 分别优化两阶段 | 保持prefill信息,优化decoding |
三、技术架构
整体框架
核心设计:
- 保留prefill阶段的KV缓存:确保对长内容的理解
- 滑动策略管理decoding阶段:动态选择essential heavy hitters
- 自适应和不连续策略:进一步优化内存使用和传输
数学形式化
KV缓存池:
- :存储prefill阶段生成的KV缓存
- :存储decoding阶段生成的KV缓存
Heavy Hitter选择函数:
- 从给定注意力权重中选择Top-K KV缓存
Prefill阶段压缩:
- :prefill essential history window长度
- :prefill local window长度
- 总保留KV缓存长度:
三种解码策略
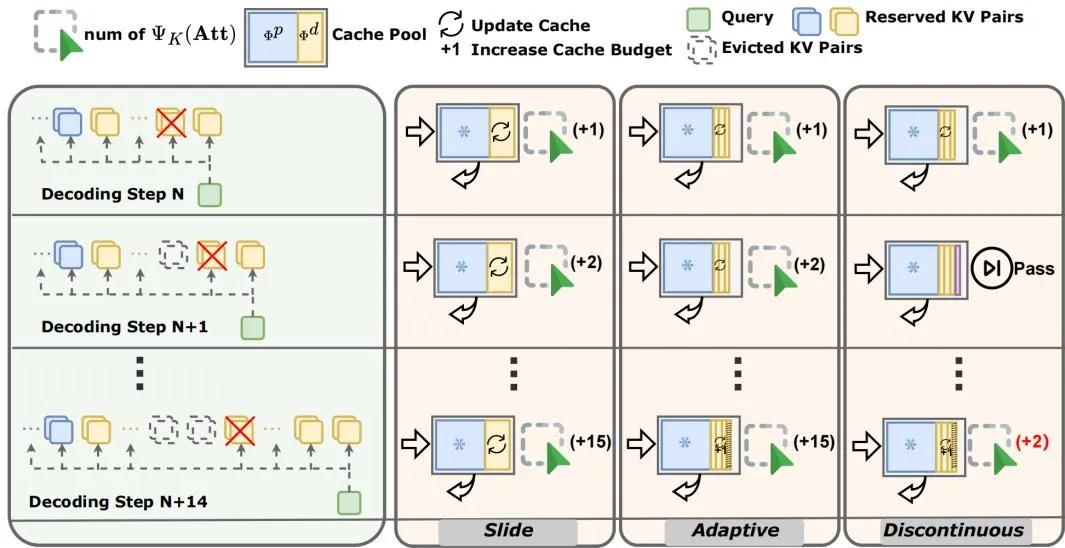
Figure 3: SCOPE三种策略示意图。
1. Slide策略(滑动策略)
核心思想:通过滑动decoding essential history window 和 decoding local window 压缩decoding阶段的KV缓存。
执行条件:
更新函数:
特点:
- 仅更新,保持不变
- 每步执行Top-K选择
2. Adaptive策略(自适应策略)
核心思想:从内存使用角度优化,自适应增加其大小。
自适应窗口:
预算大小:
特点:
- 初始大小为,随时间步线性增长
- 到达时大小变为
- 无需额外超参数
- 更早开始执行
3. Discontinuous策略(不连续策略)
核心思想:从内存传输角度优化,减少的执行频率。
执行间隔:每执行一次
频率降低:从次降至次
特点:
- 利用连续查询倾向于选择相似key的特性
- 减少GPU I/O压力
- 优化更新操作的延迟
四、实验结果
实验设置
模型:
- LLaMA-3.1-8B-Instruct
- Mistral-7B-Instruct-v0.3
数据集:
- LoNGGENBENCH-4K(输出长度4K)
- LoNGGENBENCH-8K(输出长度8K)
- ∞BENCH En.Sum(输出长度1.1K)
超参数:
- Prefill压缩率:约60%
- :2048(4K)/ 4096(8K)
- :8
- :512 / 1024
- :256
主要结果
Table 1: LoNGGENBENCH基准测试结果
LLaMA-3.1-8B-Instruct (Decoding Compression Ratio=25%):
| 方法 | GSM8K+ | MMLU+ | CSQA+ | Avg |
|---|---|---|---|---|
| Full Cache | 53.26 | 54.40 | 71.67 | 59.78 |
| StreamingLLM | 10.78 | 34.15 | 43.50 | 29.48 |
| H2O | 35.04 | 48.11 | 69.50 | 50.88 |
| PyramidInfer | 38.76 | 48.93 | 71.58 | 53.09 |
| SCOPE (Slide) | 46.51 | 46.62 | 72.50 | 56.21 |
| SCOPE (Adaptive) | 43.10 | 50.25 | 71.50 | 54.95 |
| SCOPE (Discontinuous) | 42.02 | 49.75 | 72.67 | 54.81 |
关键结果:
- SCOPE在所有策略下均优于基线
- Slide策略在GSM8K+上表现最佳(46.51 vs 38.76)
- 接近Full Cache性能(56.21 vs 59.78)
Plug-in兼容性实验
Table 2: 与Prefill-Only方法的兼容性(LLaMA3.1-8B, GSM8K+)
| Decoding策略 | Full Cache | SnapKV | PyramidKV |
|---|---|---|---|
| Full Cache | 53.26 | 27.75 | 27.75 |
| Slide | 52.17 | 26.90 | 26.90 |
| Adaptive | 43.88 | 27.60 | 27.60 |
| Discontinuous | 47.21 | 27.67 | 27.67 |
关键发现:
- SCOPE可与SnapKV、PyramidKV无缝集成
- 某些策略甚至超越Full Cache结果
- 验证了decoding阶段KV缓存的稀疏性
效率分析
Table 3: 内存和延迟效率(LLaMA3.1-8B, 60% prefill + 12.5% decoding)
| 方法 | Peak KV Mem. | Tokens/s |
|---|---|---|
| Full Cache | 15.6 GB (100%) | 36.57 |
| SnapKV | 12.5 GB (80.1%) | 38.28 |
| StreamingLLM | 5.8 GB (37.1%) | 22.02 |
| H2O | 5.8 GB (37.1%) | 21.78 |
| SCOPE (Slide) | 5.8 GB (37.1%) | 18.28 |
| SCOPE (Adaptive) | 5.8 GB (37.1%) | 18.28 |
| SCOPE (Discontinuous) | 5.8 GB (37.1%) | 25.92 |
关键发现:
- 内存减少63%(15.6GB → 5.8GB)
- Discontinuous策略延迟最低(25.92 tokens/s)
分析实验
Heavy Hitter保持效果
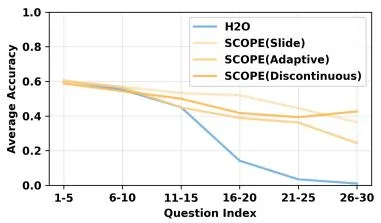
Figure 4a: 不同问题位置的准确率分布。
- H2O在后期预测中性能显著下降
- SCOPE三种策略均缓解了这种下降
- 验证了保留prefill KV缓存的有效性
压缩率影响
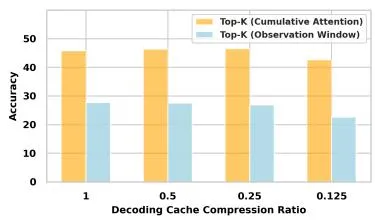
Figure 4b: 不同压缩率下的准确率。
关键发现:
- Prefill阶段:20%压缩率导致GSM8K+ 95%性能下降
- Decoding阶段:25%压缩率仅导致15%性能下降
- 验证了分别优化两阶段的必要性
Top-K选择算法对比
| 算法 | 特点 | 效果 |
|---|---|---|
| Top-K (Observation Window) | 固定大小局部窗口 | 窗口不足,性能较差 |
| Top-K (Cumulative Attention) | 全局累积注意力 | 更好,需要回顾对应问题 |
通用性验证
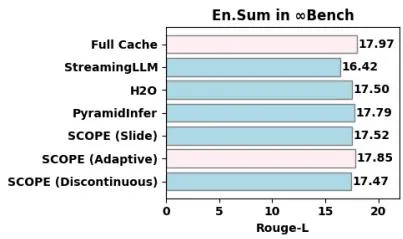
Figure 4c: ∞BENCH En.Sum任务结果。
- Adaptive策略与Full Cache最接近
- 不仅适用于多QA任务,也适用于摘要任务
- 验证了SCOPE的通用性
五、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 阶段分离 | 首次解耦prefill和decoding阶段 | 保持prefill信息,优化decoding |
| Slide策略 | 滑动窗口管理decoding KV缓存 | 有效选择heavy hitters |
| Adaptive策略 | 自适应调整窗口大小 | 优化内存使用 |
| Discontinuous策略 | 不连续执行Top-K | 减少GPU I/O,降低延迟 |
| Plug-in兼容 | 可与其他prefill压缩方法集成 | 灵活性强 |
六、与相关方法对比
| 方法 | 压缩阶段 | 特点 | SCOPE优势 |
|---|---|---|---|
| StreamingLLM | Unified | 保留首尾token | 丢失中间关键信息 |
| H2O | Unified | 累积注意力选择 | Heavy hitter偏移 |
| PyramidInfer | Unified | 层级稀疏性 | 长输出效果不明显 |
| SnapKV | Prefill-Only | 观察窗口选择 | Decoding线性增长 |
| PyramidKV | Prefill-Only | 动态预算分配 | Decoding未优化 |
| SCOPE | 分离优化 | 两阶段独立策略 | 兼顾理解和效率 |
七、局限性
- Top-K算法开销:每步执行Top-K选择有时间成本
- 超参数敏感:、需要调整
- 模态限制:目前仅在文本模态验证
- 数据集有限:主要在LoNGGENBENCH和∞BENCH验证
八、总结
核心贡献
- 首次分离优化:解耦prefill和decoding阶段的KV缓存压缩
- 关键观察:发现heavy hitter偏移现象
- 三种策略:Slide、Adaptive、Discontinuous逐步优化
- Plug-in兼容:可与其他方法无缝集成
- 广泛验证:在多个基准上验证有效性
性能总结
| 指标 | LLaMA-3.1-8B | Mistral-7B |
|---|---|---|
| GSM8K+ (vs Full Cache) | 46.51 vs 53.26 | 11.55 vs 11.01 |
| 内存减少 | 63% | 63% |
| 延迟优化 | Discontinuous最佳 | Discontinuous最佳 |
技术影响
SCOPE展示了阶段分离优化的重要性:
- Prefill阶段:保留足够信息理解上下文
- Decoding阶段:动态管理heavy hitters
- Plug-in设计:可与其他方法组合
- 实用性强:简单有效,易于部署
九、参考资源
- 论文: arXiv:2412.13649
- 相关工作:
- SnapKV - Prefill阶段KV压缩
- PyramidKV - 动态预算分配
- H2O - Heavy-Hitter Oracle
- StreamingLLM - 流式LLM
- LoNGGENBENCH - 长文本生成基准