FastVLM: Efficient Vision Encoding for Vision Language Models
Apple提出的高效视觉语言模型,通过新型混合视觉编码器FastViTHD实现85×更快的首token延迟,同时保持竞争性准确率
FastVLM: Efficient Vision Encoding for Vision Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FastVLM: Efficient Vision Encoding for Vision Language Models |
| 作者 | Pavan Kumar Anasosalu Vasu, Fartash Faghri, Chun-Liang Li, Cem Koc, Nate True, Albert Antony, Gokul Santhanam, James Gabriel, Peter Grasch, Oncel Tuzel, Hadi Pouransari |
| 机构 | Apple |
| 论文 | https://arxiv.org/abs/2412.13303 |
| 代码 | https://github.com/apple/ml-fastvlm |
| 会议 | CVPR 2025 |
| 发布 | 2024-12-17 (v1), 最新 v2 (2025-05-15) |
二、核心思想
问题定义
提升VLM性能的关键是提高输入图像分辨率,但带来两大挑战:
| 挑战 | 说明 |
|---|---|
| 视觉编码器效率低 | ViT在高分辨率下产生大量token,编码延迟高 |
| LLM预填充慢 | 大量视觉token增加LLM预填充时间,提高TTFT |
解决方案概述
FastVLM 是Apple提出的高效VLM,核心创新:
- FastViTHD:新型混合视觉编码器(卷积+Transformer),专门为高分辨率VLM设计
- 架构优化:5阶段设计,额外下采样层,生成4×更少token
- 无需token剪枝:仅通过缩放输入图像实现最优token-分辨率平衡
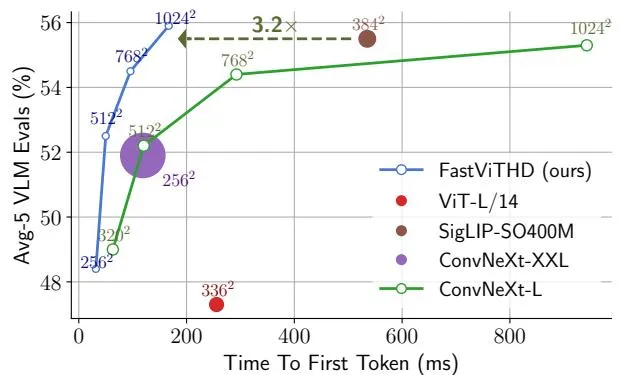
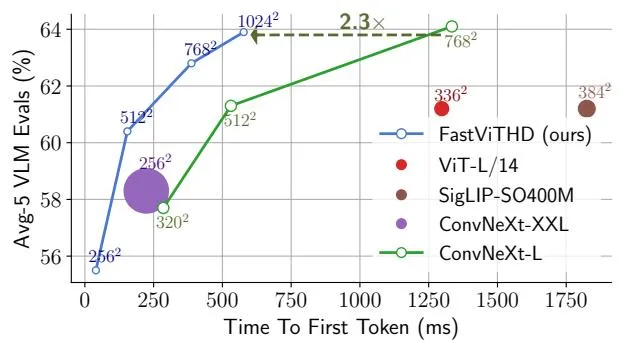
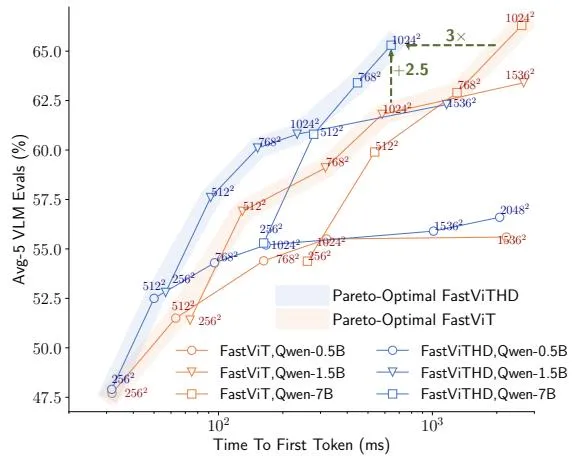
- 85×更快TTFT:相比LLaVA-OneVision,同等0.5B LLM下快85倍
三、技术架构
整体框架
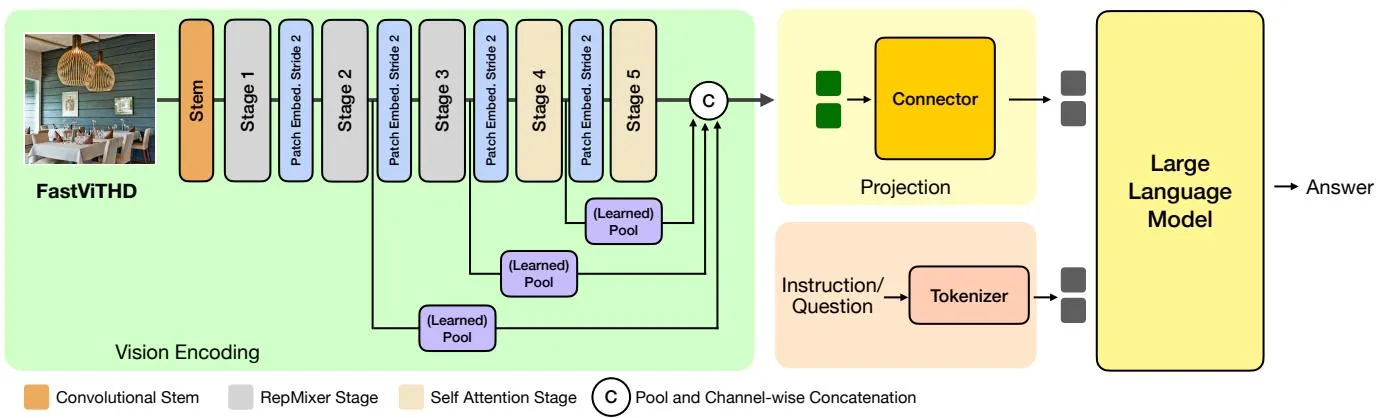
FastVLM由三个组件构成:
- FastViTHD:新型混合视觉编码器
- 投影层:连接视觉编码器和LLM
- LLM解码器:Qwen2-0.5B/1.5B/7B或Vicuna-7B
FastViTHD架构
FastViTHD是5阶段混合架构:
| 阶段 | 类型 | 深度 | 嵌入维度 | 说明 |
|---|---|---|---|---|
| Stage 1 | RepMixer | 2 | 96 | 卷积特征提取 |
| Stage 2 | RepMixer | 12 | 192 | 卷积特征提取 |
| Stage 3 | RepMixer | 24 | 384 | 卷积特征提取 |
| Stage 4 | Self-Attention | 4 | 768 | Transformer细化 |
| Stage 5 | Self-Attention | 2 | 1536 | Transformer细化 |
关键设计:
- 额外下采样层:引入第5阶段,使自注意力在32×下采样张量上操作(而非16×)
- 4×更少token:相比FastViT,生成4×更少视觉token
- 16×更少token:相比ViT-L/14在336分辨率下
- 125.1M参数:比最大FastViT变体大3.5×,但仍小于ViT-L/14(304M)
缩放策略
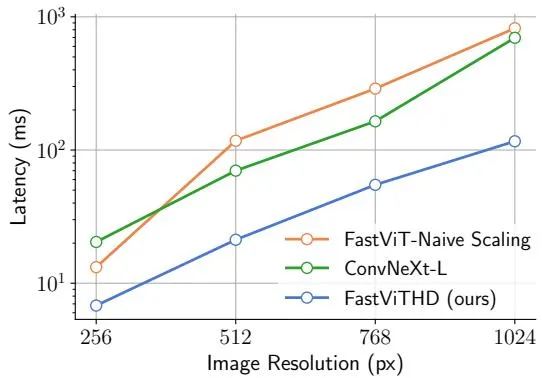
| 分辨率 | FastViT-Naive | ConvNeXt-L | FastViTHD |
|---|---|---|---|
| 256 | 10ms | 30ms | 5ms |
| 512 | 100ms | 70ms | 20ms |
| 768 | 300ms | 150ms | 50ms |
| 1024 | 1000ms | 500ms | 100ms |
FastViTHD在所有分辨率下均显著快于朴素缩放和ConvNeXt-L。
多尺度特征
- 从多个阶段聚合特征
- 使用深度卷积(而非平均池化)进行特征融合
- 性能提升:Avg-5从62.6提升到62.9
视觉编码器-语言解码器交互
TTFT分解:
| 分辨率 | 视觉编码延迟 | LLM预填充 |
|---|---|---|
| 256 | 5ms | 50ms |
| 512 | 25ms | 70ms |
| 768 | 50ms | 90ms |
| 1024 | 110ms | 110ms |
| 1536 | 800ms | 300ms |
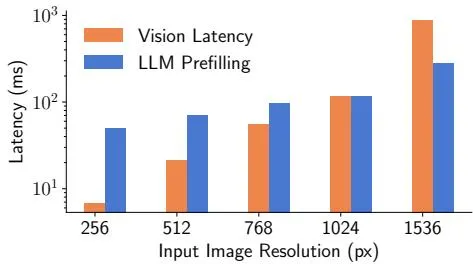
关键发现:在高分辨率下,视觉编码延迟成为TTFT的主要瓶颈。
静态vs动态分辨率
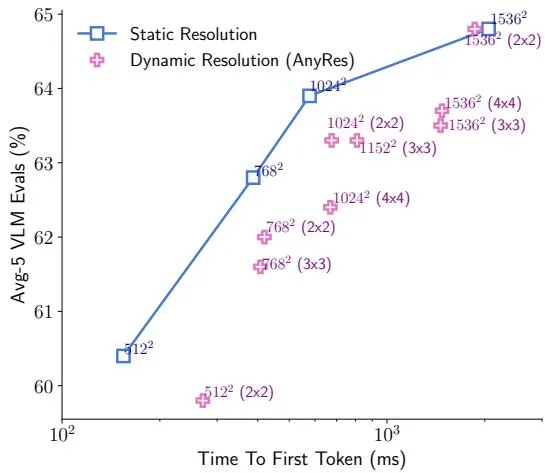
- 动态分辨率(AnyRes):仅在最高分辨率+少tile(2×2)时最优
- 静态分辨率:在多数场景下更简单高效
- FastVLM通过缩放输入图像实现最优平衡,无需额外token剪枝
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| FastViTHD混合架构 | 卷积+Transformer,5阶段设计 | 高效高分辨率编码 |
| 额外下采样层 | 第5阶段,32×下采样 | 4×更少token |
| 无需token剪枝 | 仅通过缩放输入图像 | 简化模型设计 |
| 多尺度特征融合 | 深度卷积聚合多阶段特征 | 提升VLM性能 |
| Pareto最优分析 | 系统研究分辨率-延迟-准确率权衡 | 指导模型设计 |
五、训练流程
训练设置
Stage 1(对齐训练):
- 数据:LLaVA-558K对齐数据集
- 仅训练投影层
- 批大小:256,学习率:10⁻³
- 1个epoch
Stage 1.5(分辨率缩放):
- 数据:15M样本
- 训练视觉编码器+投影层
- 输入分辨率:目标分辨率
- 约77小时(8×H100,1024×1024)
Stage 2(视觉指令微调):
- 数据:LLaVA-665K监督微调数据集
- 训练所有模块
- 约8小时(8×H100,1024×1024)
Stage 3(可选,高质量微调):
- 数据:Mammoth-VL高质量指令微调数据集(含CoT推理)
- 进一步提升性能
训练数据
| 阶段 | 数据集 | 样本数 | 说明 |
|---|---|---|---|
| Stage 1 | LLaVA-558K | 558K | 图文对齐 |
| Stage 1.5 | 混合预训练数据 | 15M | 分辨率缩放 |
| Stage 2 | LLaVA-665K | 665K | 视觉指令微调 |
| Stage 3 | Mammoth-VL | 12.5M/23.1M | 高质量CoT推理 |
硬件需求
| 项目 | 值 |
|---|---|
| GPU | 8× NVIDIA H100-80GB |
| Stage 1 | ~30分钟 |
| Stage 1.5 | ~77小时 |
| Stage 2 | ~8小时 |
| 总训练时间 | ~85小时 |
六、实验结果
与Token剪枝方法对比
| 方法 | 输入分辨率 | 视觉token数 | GQA | TextVQA | POPE | DocVQA | SeedBench | Avg-5 |
|---|---|---|---|---|---|---|---|---|
| ViT-L/14 M3 | 336 | 9 | 58.0 | - | 83.4 | - | 55.4 | - |
| ViT-L/14 MQT | 336 | 16 | 57.6 | - | 80.8 | - | - | - |
| FastViTHD | 256 | 16 | 60.6 | 53.1 | 82.3 | 17.4 | 58.8 | 55.5 |
| ViT-L/14 PruMerge+ | 336 | 40 | - | 57.1 | 84.0 | - | - | - |
| FastViTHD | 512 | 64 | 63.0 | 59.3 | 86.4 | 25.7 | 61.8 | 60.4 |
| ViT-L/14 MQT | 336 | 144 | 61.4 | - | 83.9 | - | - | - |
| FastViTHD | 768 | 144 | 62.4 | 62.9 | 87.7 | 32.9 | 62.5 | 62.8 |
FastViTHD在相同token数下显著优于token剪枝方法。
与层次化骨干对比
| 方法 | 输入分辨率 | 编码器大小 | 延迟 | GQA | TextVQA | DocVQA | SeedBench | Avg-5 |
|---|---|---|---|---|---|---|---|---|
| ConvNeXT-L | 320 | 200M | 34.4ms | 61.9 | 55.5 | 21.3 | 64.6 | 57.7 |
| ConvNeXT-XXL | 256 | 846M | 89.9ms | 62.7 | 56.3 | 21.6 | 65.6 | 58.3 |
| FastViTHD | 256 | 125M | 10.1ms | 60.6 | 53.1 | 17.4 | 63.7 | 55.5 |
| ConvNeXT-L | 512 | 200M | 71.9ms | 61.8 | 61.0 | 30.8 | 66.8 | 61.3 |
| FastViTHD | 512 | 125M | 33.5ms | 63.0 | 59.3 | 25.7 | 67.1 | 60.4 |
| ConvNeXT-XXL | 512 | 846M | 397.1ms | 62.3 | 65.1 | 36.2 | 68.4 | 63.9 |
| FastViTHD | 1024 | 125M | 235.6ms | 63.1 | 64.4 | 35.6 | 68.5 | 63.9 |
FastViTHD在更高分辨率下以更小模型和更低延迟达到相当或更好的性能。
0.5B模型对比
| 方法 | 视觉编码器 | LLM | 输入分辨率 | 视觉token | 编码器大小 | TTFT | DocVQA | MMMU | SeedBench |
|---|---|---|---|---|---|---|---|---|---|
| nanoLLaVA | ViT-SO400M | Qw.1.5 | 384 | 729 | 430M | 535ms | - | 30.4 | - |
| LLaVAOV* | ViT-SO400M | Qw.2 | 1152 | 7290 | 430M | 14124ms | 70.0 | 31.4 | 65.5 |
| FastVLM (R4) | FastViTHD | Qw.2 | 1024 | 256 | 125M | 166ms | 70.4 | 32.9 | 69.2 |
| FastVLM (R5) | FastViTHD | Qw.2 | 1024 | 256 | 125M | 166ms | 79.1 | 33.6 | 69.3 |
FastVLM-0.5B在DocVQA(79.1)、MMMU(33.6)、SeedBench(69.3)上超越LLaVA-OneVision,同时:
- TTFT快85× (166ms vs 14124ms)
- 编码器小3.4× (125M vs 430M)
- 视觉token少28× (256 vs 7290)
7B模型对比
| 方法 | 视觉编码器 | LLM | 输入分辨率 | 视觉token | TTFT | GQA | TextVQA | DocVQA | MMMU |
|---|---|---|---|---|---|---|---|---|---|
| LLaVA-1.5 | ViT-L/14 | Vic. | 336 | 576 | 1297ms | 62.0 | 58.2 | 28.1 | 35.3 |
| ConvLLaVA | ConvNeXT-L | Vic. | 1024 | 256 | 1157ms | - | 62.5 | 48.5 | 35.1 |
| FastVLM (R29) | FastViTHD | Vic. | 1024 | 256 | 577ms | 65.2 | 70.6 | 72.4 | 36.7 |
| FastVLM (R30) | FastViTHD | Qw.2 | 1024 | 256 | 641ms | 65.8 | 72.1 | 73.3 | 46.2 |
| FastVLM (R40) | FastViTHD | Qw.2 | 1024 | 256 | 641ms | 66.0 | 73.1 | 78.7 | 42.8 |
多视觉编码器对比
| 方法 | 视觉编码器 | LLM | 视觉token | TTFT | DocVQA | MMMU | SeedBench |
|---|---|---|---|---|---|---|---|
| MiniGemini-HD | ConvNeXT-L + ViT-L/14 | L-3 | 2880 | 21832ms | 74.6 | 37.3 | 73.2 |
| Cambrian-1 | 4个编码器 | L-3 | 576 | 5085ms | 77.8 | 42.7 | 74.7 |
| FastVLM (R40) | FastViTHD | Qw.2 | 256 | 641ms | 78.7 | 42.8 | 75.9 |
FastVLM单编码器超越多编码器方法,且TTFT快7.9×。
与同期工作对比
| 方法 | 视觉编码器 | LLM | 视觉token | 编码器大小 | TextVQA | DocVQA | AI2D | SQA |
|---|---|---|---|---|---|---|---|---|
| SmolVLM2-0.5B | ViT-B | SmolLM2 | 1088* | 93M | 60.2 | 70.5 | 59.2 | 80.0 |
| FastVLM-0.6B | FastViTHD | Qw.2 | 256 | 125M | 65.8 | 79.1 | 66.0 | 82.0 |
| SmolVLM2-2.2B | ViT-SO400M | SmolLM2 | 2106* | 430M | 73.0 | 80.0 | 70.0 | 89.6 |
| FastVLM-1.7B | FastViTHD | Qw.2 | 256 | 125M | 71.2 | 84.2 | 76.6 | 92.9 |
FastVLM用4.3×更少token和2.2×更小编码器超越SmolVLM2。
七、相关工作
大型多模态模型
- LLaVA:视觉指令微调范式
- InternVL:视觉基础模型缩放
- Cambrian-1:多视觉编码器集成
- MM1:多模态缩放研究
高效图像编码
- SigLIP:CLIP预训练ViT
- ConvNeXt:纯卷积视觉编码器
- ConvLLaVA:卷积视觉编码器用于VLM
- ViTamin:VLM专用混合架构
Token压缩方法
- Matryoshka:多尺度token采样
- PruMerge:动态token剪枝
- VisionZip:视觉token压缩
- DynamicLLaVA:动态视觉-语言上下文稀疏化
FastVLM的差异化
- 专为高分辨率设计:非事后优化,而是架构层面优化
- 无需token剪枝:通过架构设计自然减少token
- 混合架构优势:卷积处理低层特征,Transformer处理高层语义
- 移动端友好:支持Apple Silicon推理,提供iOS演示应用
八、总结
核心贡献
- FastViTHD混合视觉编码器:5阶段设计,额外下采样层,125M参数,生成4×更少token
- 系统性效率分析:研究分辨率、视觉延迟、token数、LLM大小的交互关系
- Pareto最优分析:建立准确率-延迟权衡曲线,指导模型设计
- SOTA性能:
- 0.5B模型:85×更快TTFT,超越LLaVA-OneVision
- 7B模型:7.9×更快TTFT,超越Cambrian-1
- 单编码器超越多编码器方法
技术影响
- VLM效率新标杆:证明高效视觉编码可以大幅提升VLM延迟
- 移动部署可行性:支持iPhone/iPad/Mac实时推理
- 架构设计指导:混合架构+额外下采样的设计范式
- 开源生态:提供完整代码、模型和iOS应用
局限性
- 分辨率上限:当前主要评估到1024×1024,更高分辨率效果待验证
- 训练成本:Stage 1.5需要77小时训练(8×H100)
- 动态分辨率限制:AnyRes仅在2×2 tile时最优,复杂场景可能不足
- 编码器大小:125M仍比ViT-B(86M)大,对极端资源受限场景可能过大
- 任务泛化:主要评估VQA和理解任务,对生成任务效果未充分验证
九、参考资源
论文
- 本文: https://arxiv.org/abs/2412.13303
- 代码: https://github.com/apple/ml-fastvlm
- 模型: 提供0.5B/1.5B/7B三个规模的预训练权重
相关论文
- LLaVA: Visual Instruction Tuning (NeurIPS 2023)
- FastViT: Fast Hybrid Vision Transformer (ICML 2023)
- MobileCLIP: Mobile Vision-Language Models
- ConvLLaVA: Hierarchical Backbones for VLMs
- Qwen2: 大型语言模型
- Vicuna: 对话式语言模型