TurboAttention: Efficient Attention Approximation For High Throughputs LLMs
首个将FlashAttention与量化算法结合的注意力加速方案,实现1.8倍延迟加速和2.37倍吞吐量提升
TurboAttention: Efficient Attention Approximation For High Throughputs LLMs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TurboAttention: Efficient Attention Approximation For High Throughputs LLMs |
| 作者 | Hao Kang, Srikant Bharadwaj, James Hensman, Tushar Krishna, Victor Ruhle, Saravan Rajmohan |
| 会议 | MLSys 2024 |
| 论文 | arXiv:2412.08585 |
| 硬件 | NVIDIA A100-SXM-80GB |
| 领域 | LLM推理优化、注意力机制加速 |
二、核心思想
问题定义
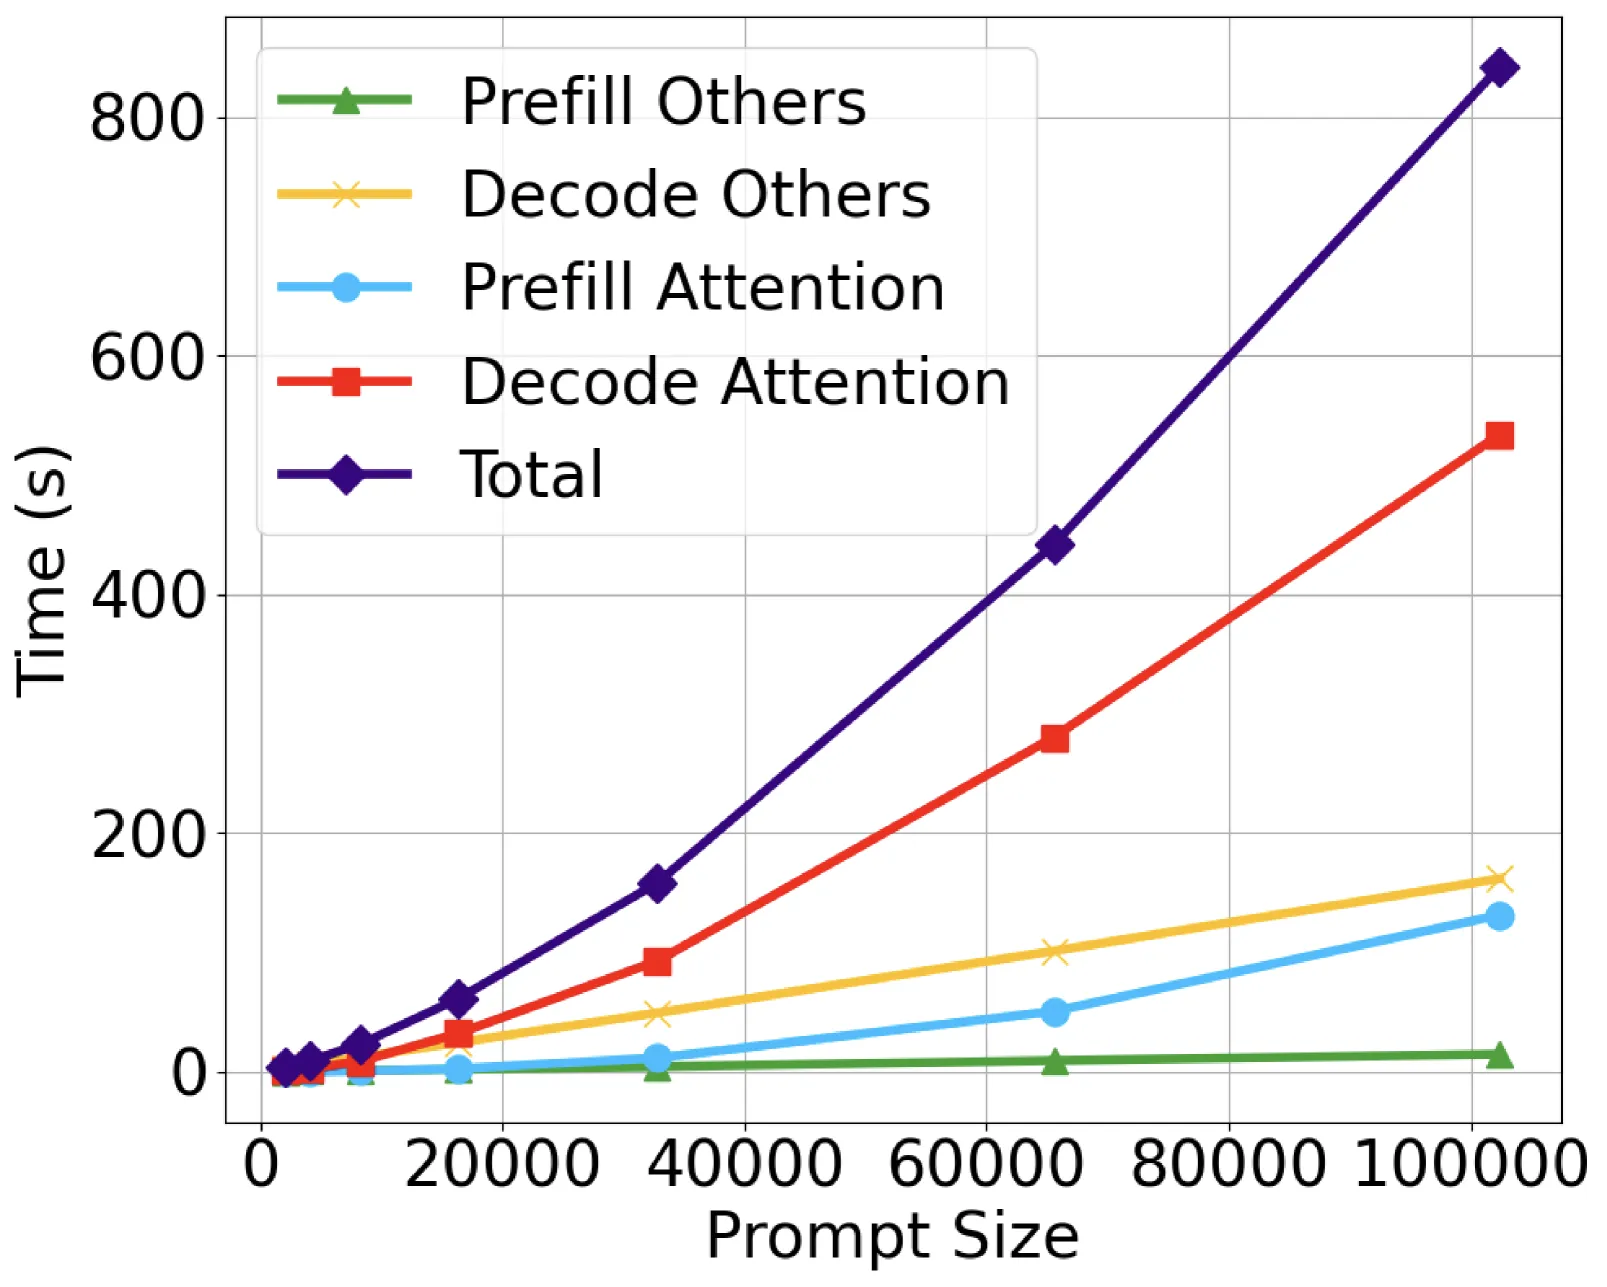
Figure 1a: KV缓存压缩技术在注意力核延迟中的反量化开销
LLM推理中的注意力机制存在三重瓶颈:
| 瓶颈 | 描述 | 现有方案局限 |
|---|---|---|
| 计算瓶颈 | 注意力占整体延迟高达80%(>80k上下文) | FlashAttention需FP16/FP32 |
| 内存瓶颈 | KV缓存占用大量内存带宽 | KIVI/GEAR需FP反量化 |
| 精度瓶颈 | FP32 CUDA核心性能仅为FP16张量的3% | 无法利用低精度张量核 |
关键观察:现有技术分别解决不同方面——量化聚焦权重-激活操作,FlashAttention改善执行但需高精度格式,KV缓存压缩减少带宽但仍需FP反量化。
核心方案
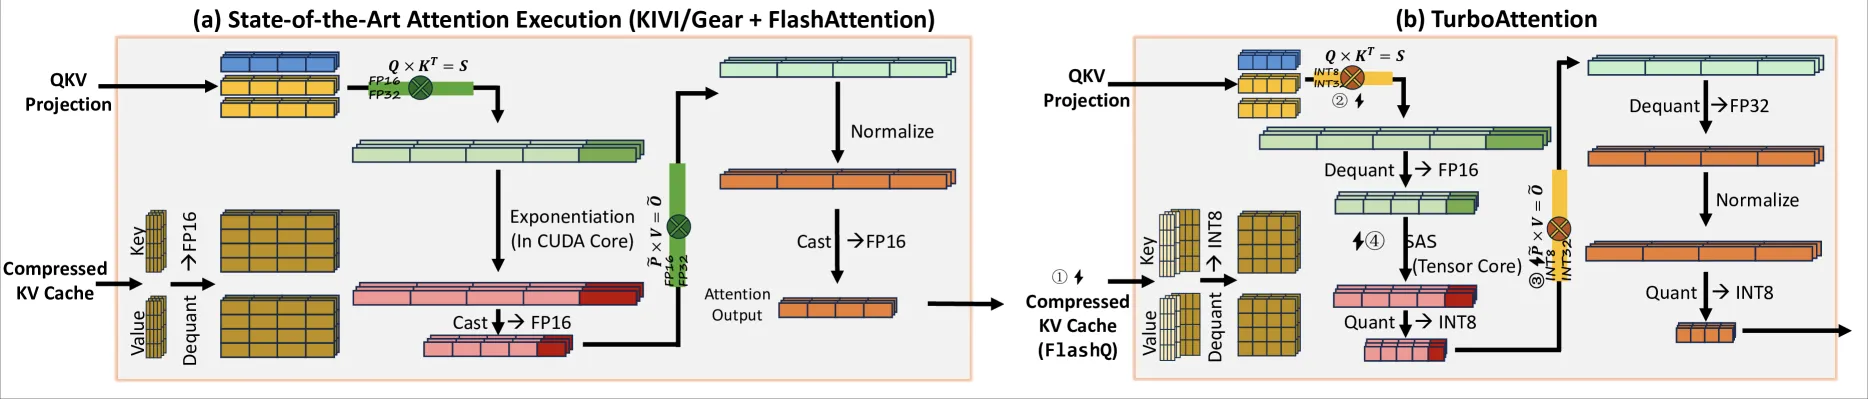
Figure 2: TurboAttention与SOTA KV缓存压缩技术的高级对比
TurboAttention是首个将FlashAttention与量化算法结合的工作,同时解决内存和计算效率:
- FlashQ:头级混合精度渐进量化,实现KV缓存压缩和量化矩阵乘法
- SAS:稀疏激活Softmax近似,消除指数运算的FP32反量化需求
三、技术架构
FlashQ:头级混合精度渐进量化
块级渐进量化(BPQ)
FlashAttention兼容的量化流程:
- 将Q、K、V分块为子块
- 对K和V进行INT8量化
- 在INT8精度下执行矩阵乘法
- 渐进压缩至INT4/INT2
与FlashAttention的集成:
- 保持FlashAttention的分块执行模式
- 在线计算注意力矩阵
- 无需额外的内存开销
头级混合精度
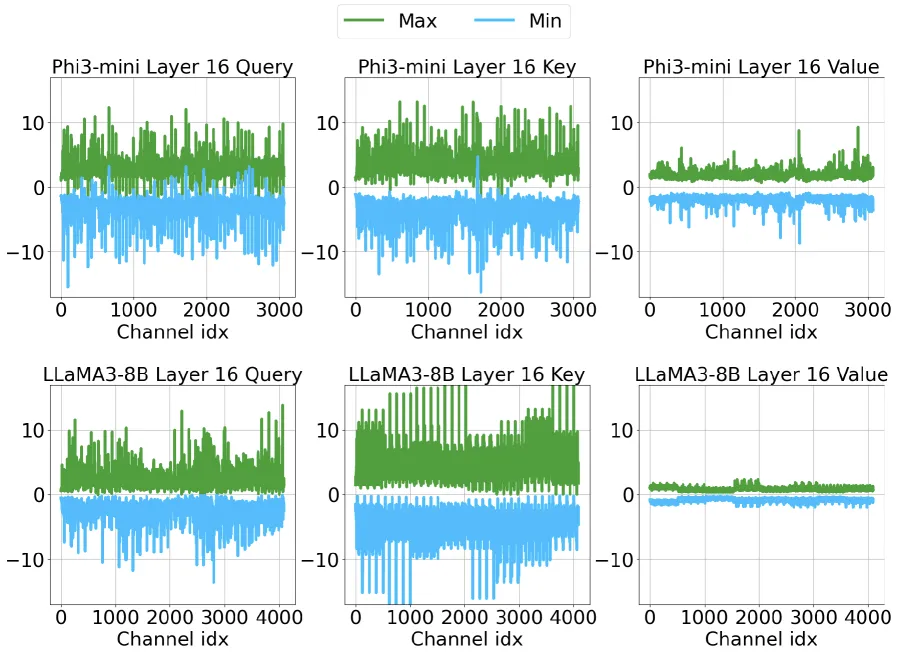
Figure 4: Phi3-mini和LLaMA3-8B模型的Query/Key/Value通道分布
动机:不同注意力头的分布特性不同,某些头存在显著的通道级异常值。
优先级度量:
其中:
- :头h的min-max范围
- :头h的标准差
混合精度策略:
- 低优先级头 → 2-bit压缩
- 高优先级头 → 4-bit压缩
- 一半头使用2-bit,另一半使用4-bit
增强KV缓存缓冲区
解码缓冲区设计:
- 缓冲区大小
- 使用8-bit对称量化
- 缓冲区满后应用渐进量化压缩至低位宽
SAS:稀疏激活Softmax
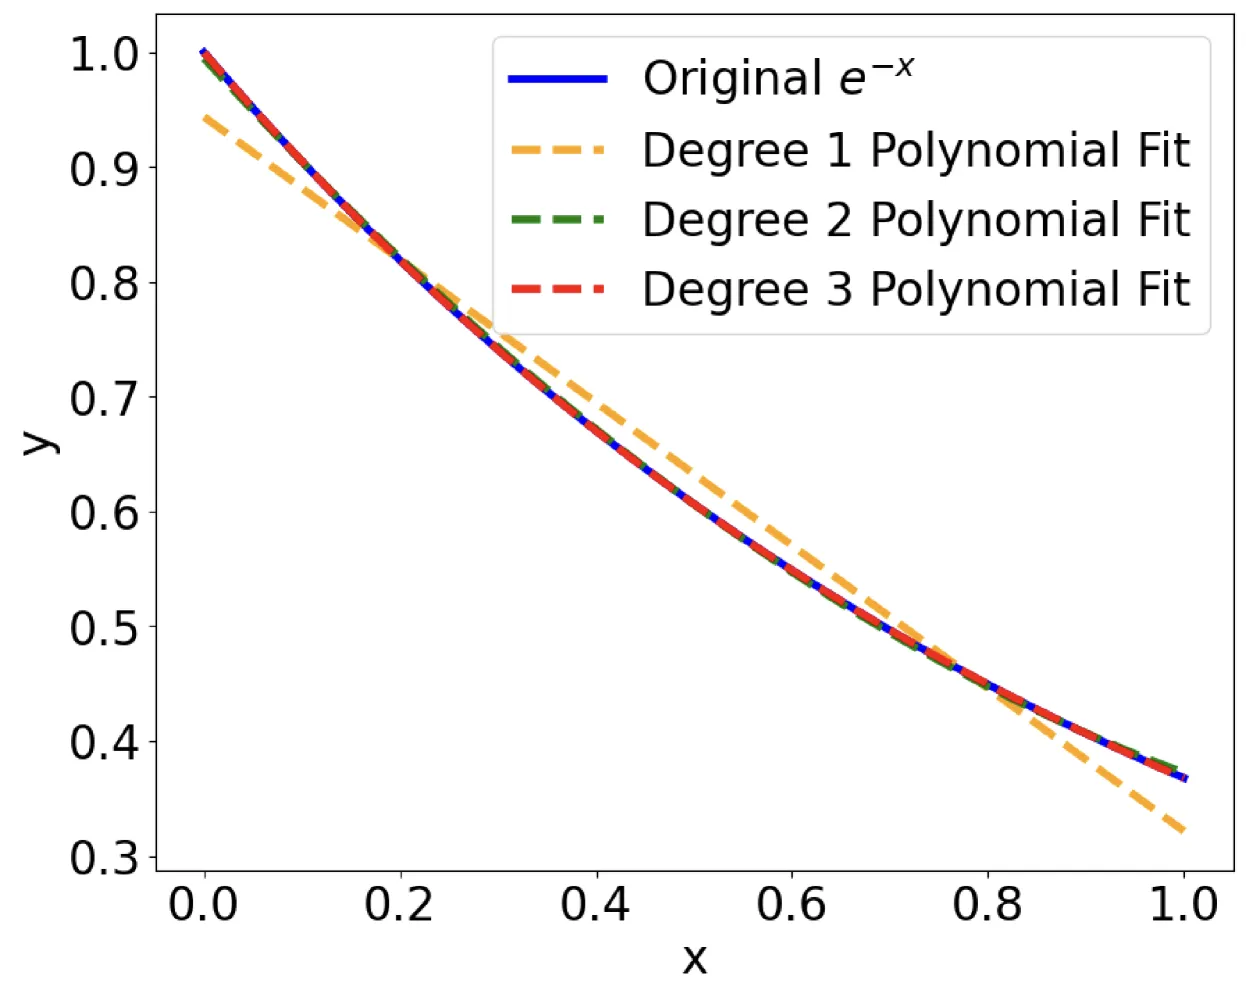
Figure 5: 指数运算小数部分的多项式拟合
问题:Softmax占注意力执行时间超过30%,主要瓶颈是FP16到FP32的数据类型转换。
多项式近似:
用于近似 在 区间上的值。
稀疏化策略:
- 保留范围 (如0到-6)内的较大注意力分数
- 将范围外的小值设为零
- 完全在FP16精度下在GPU张量核上执行
数据流
Prefill阶段:
- 将QKV块级压缩为INT8(Step1)
- 使用SAS在线计算注意力矩阵(Step2)
- 将INT8 KV块非对称压缩为INT4/INT2,通道级存储到缓存(Step3)
Decode阶段:
- 将生成的qkv压缩为INT8(Step1)
- 将KV缓存解压为INT8进行整数推理(Step2)
- 使用SAS计算注意力(Step3)
四、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| FlashQ | 头级混合精度渐进量化 | KV缓存4.4倍压缩 + 量化MatMul |
| BPQ | 块级渐进量化,FlashAttention兼容 | 无缝集成FlashAttention |
| SAS | 3次多项式近似 + 稀疏化 | 消除FP32反量化,Softmax加速 |
| 头级混合精度 | 优先级驱动的2/4-bit分配 | 平衡精度与压缩率 |
| 端到端量化 | 首次量化整个注意力机制 | 同时加速MatMul和Softmax |
关键差异化:TurboAttention不仅是KV缓存压缩算法,而是注意力机制的统一近似算法,同时处理矩阵乘法和Softmax操作。
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| GPU | 1× NVIDIA A100-SXM-80GB |
| 模型 | LLaMA3-8B-inst, Phi3-mini-inst, Qwen2.5-7B |
| 数据集 | GSM8k, AQuA, BigBench-Hard (BBH) |
| 评估方式 | 8-shot Chain-of-Thought |
| 生成长度 | 256 tokens |
| 基线 | FP16, FlashAttention, KIVI, GEAR-L |
延迟加速
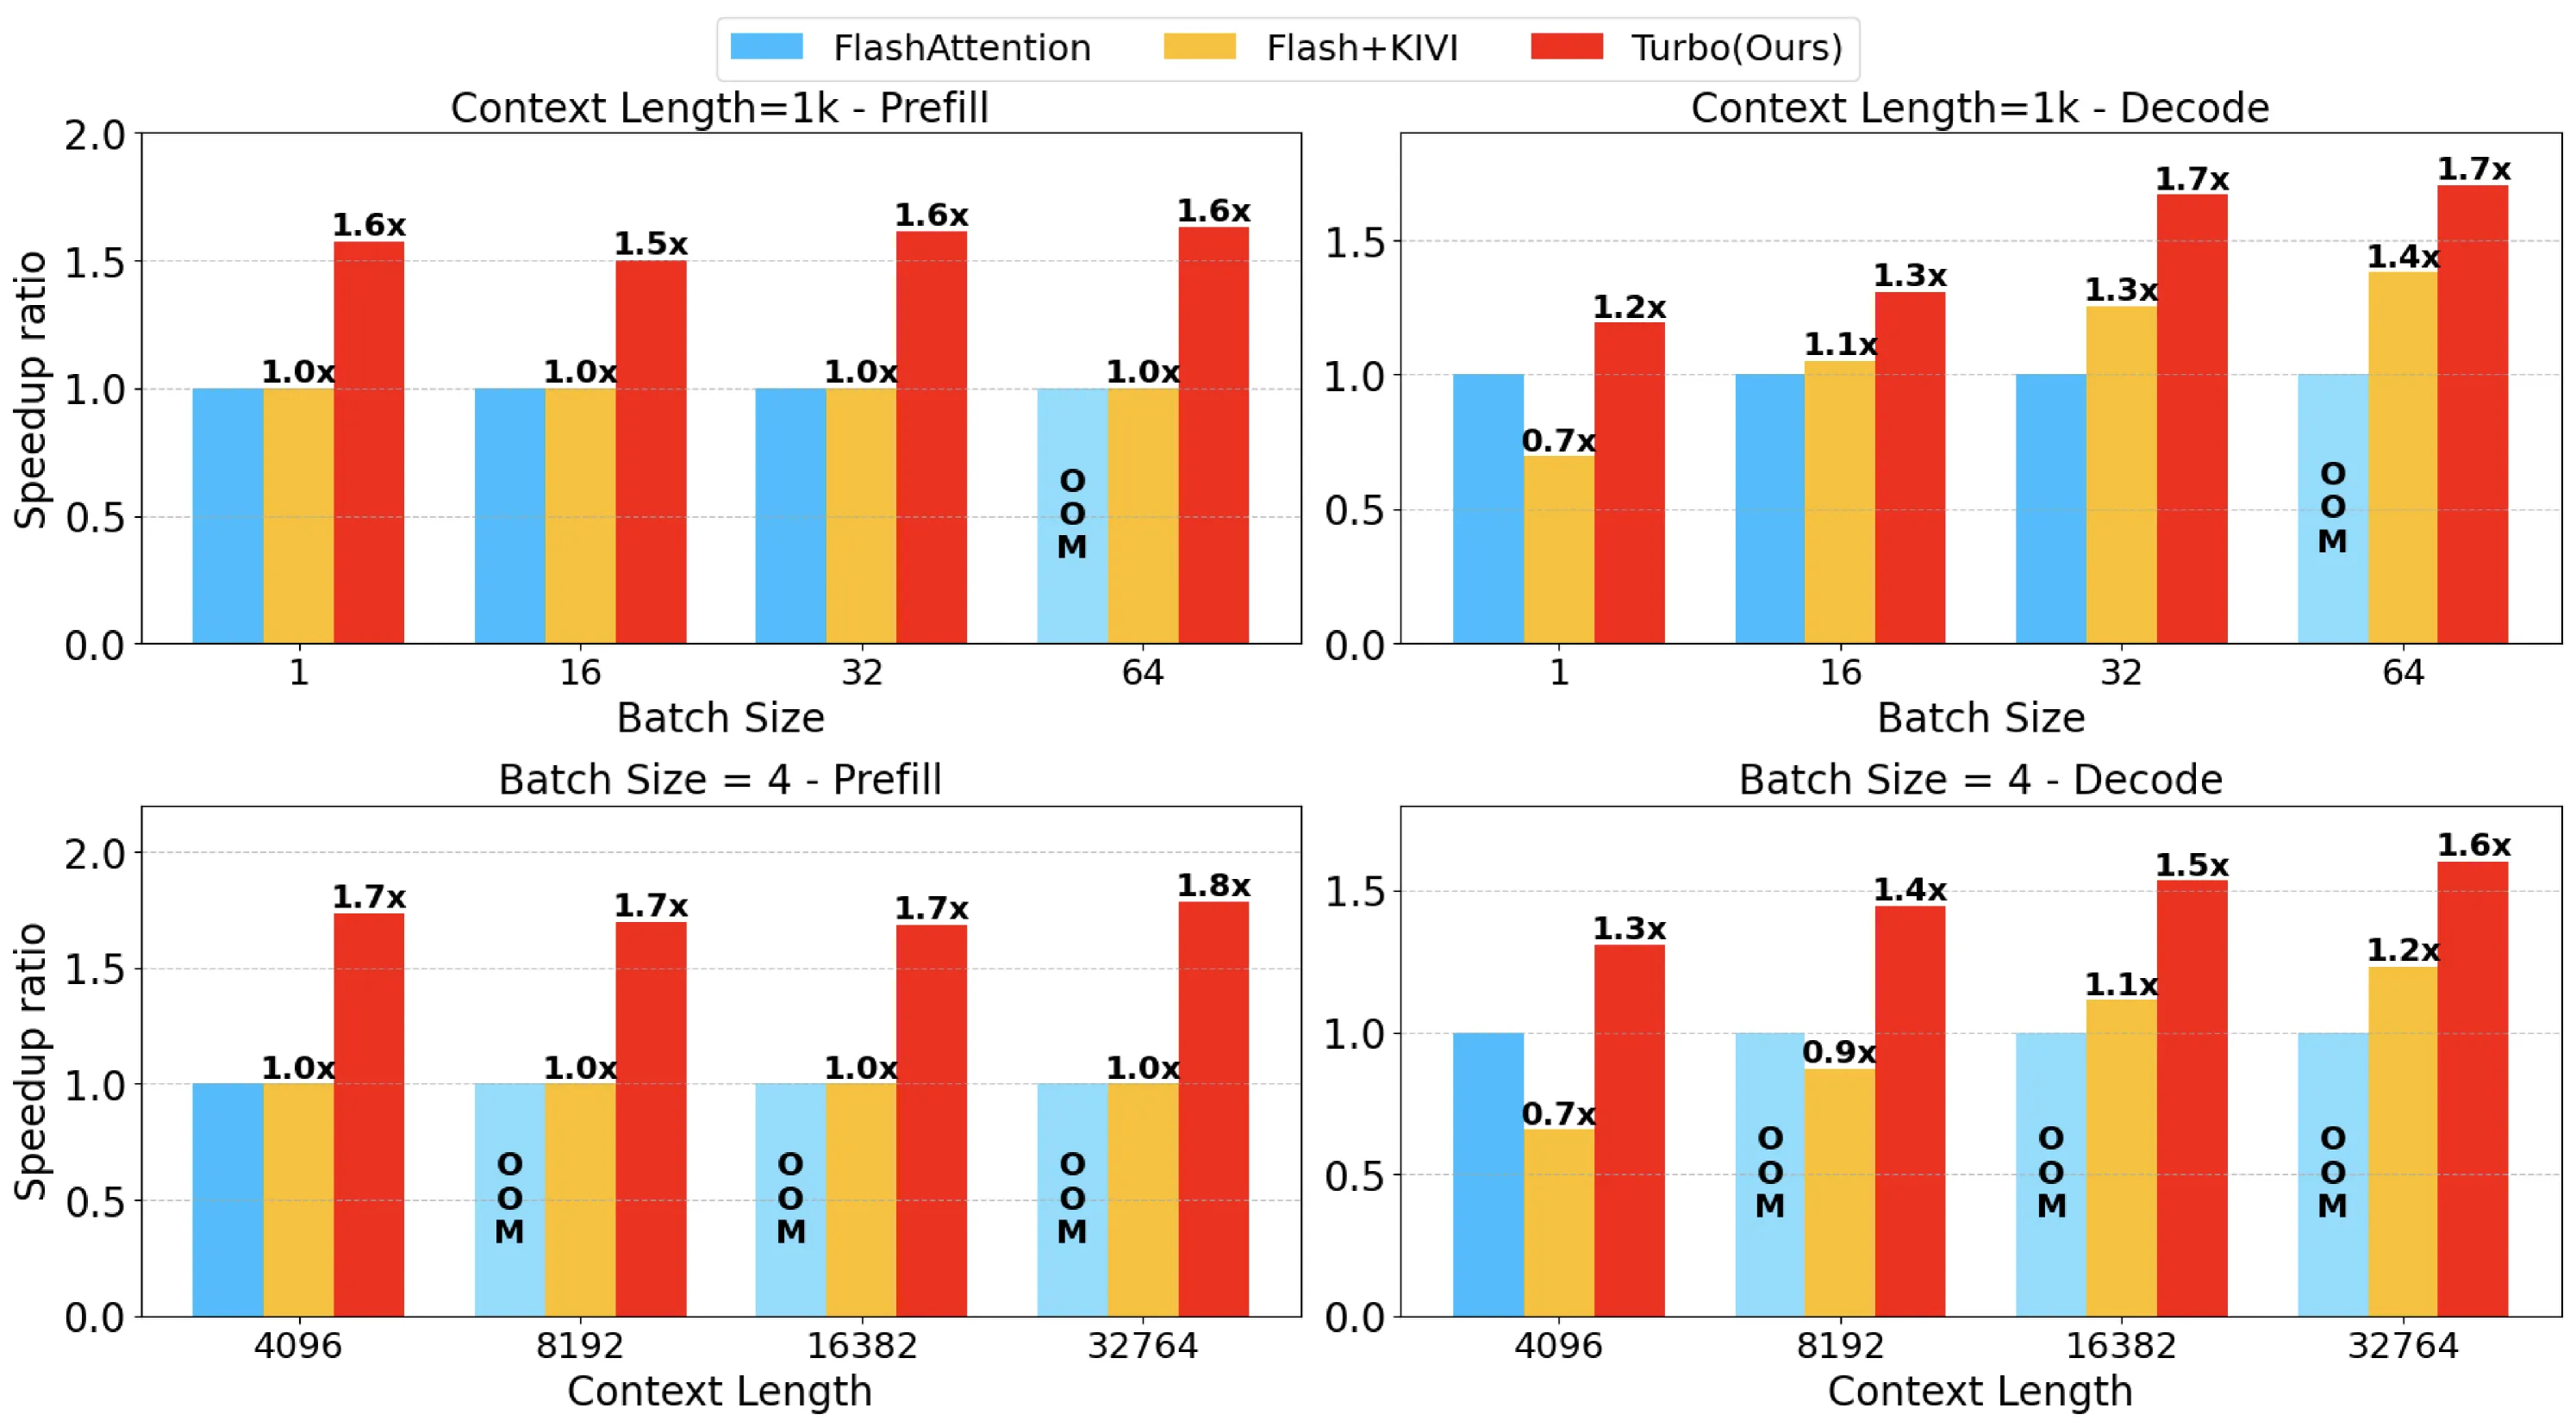
Figure 6: Phi3-medium在A100上的注意力机制加速
| 阶段 | 加速比 | 场景 |
|---|---|---|
| Prefill | 最高1.8倍 | 各种批大小和上下文长度 |
| Decode | 最高1.7倍 | 对比FlashAttention FP16 |
注意:KIVI可能因反量化开销导致延迟比FP16基线更差。
吞吐量提升
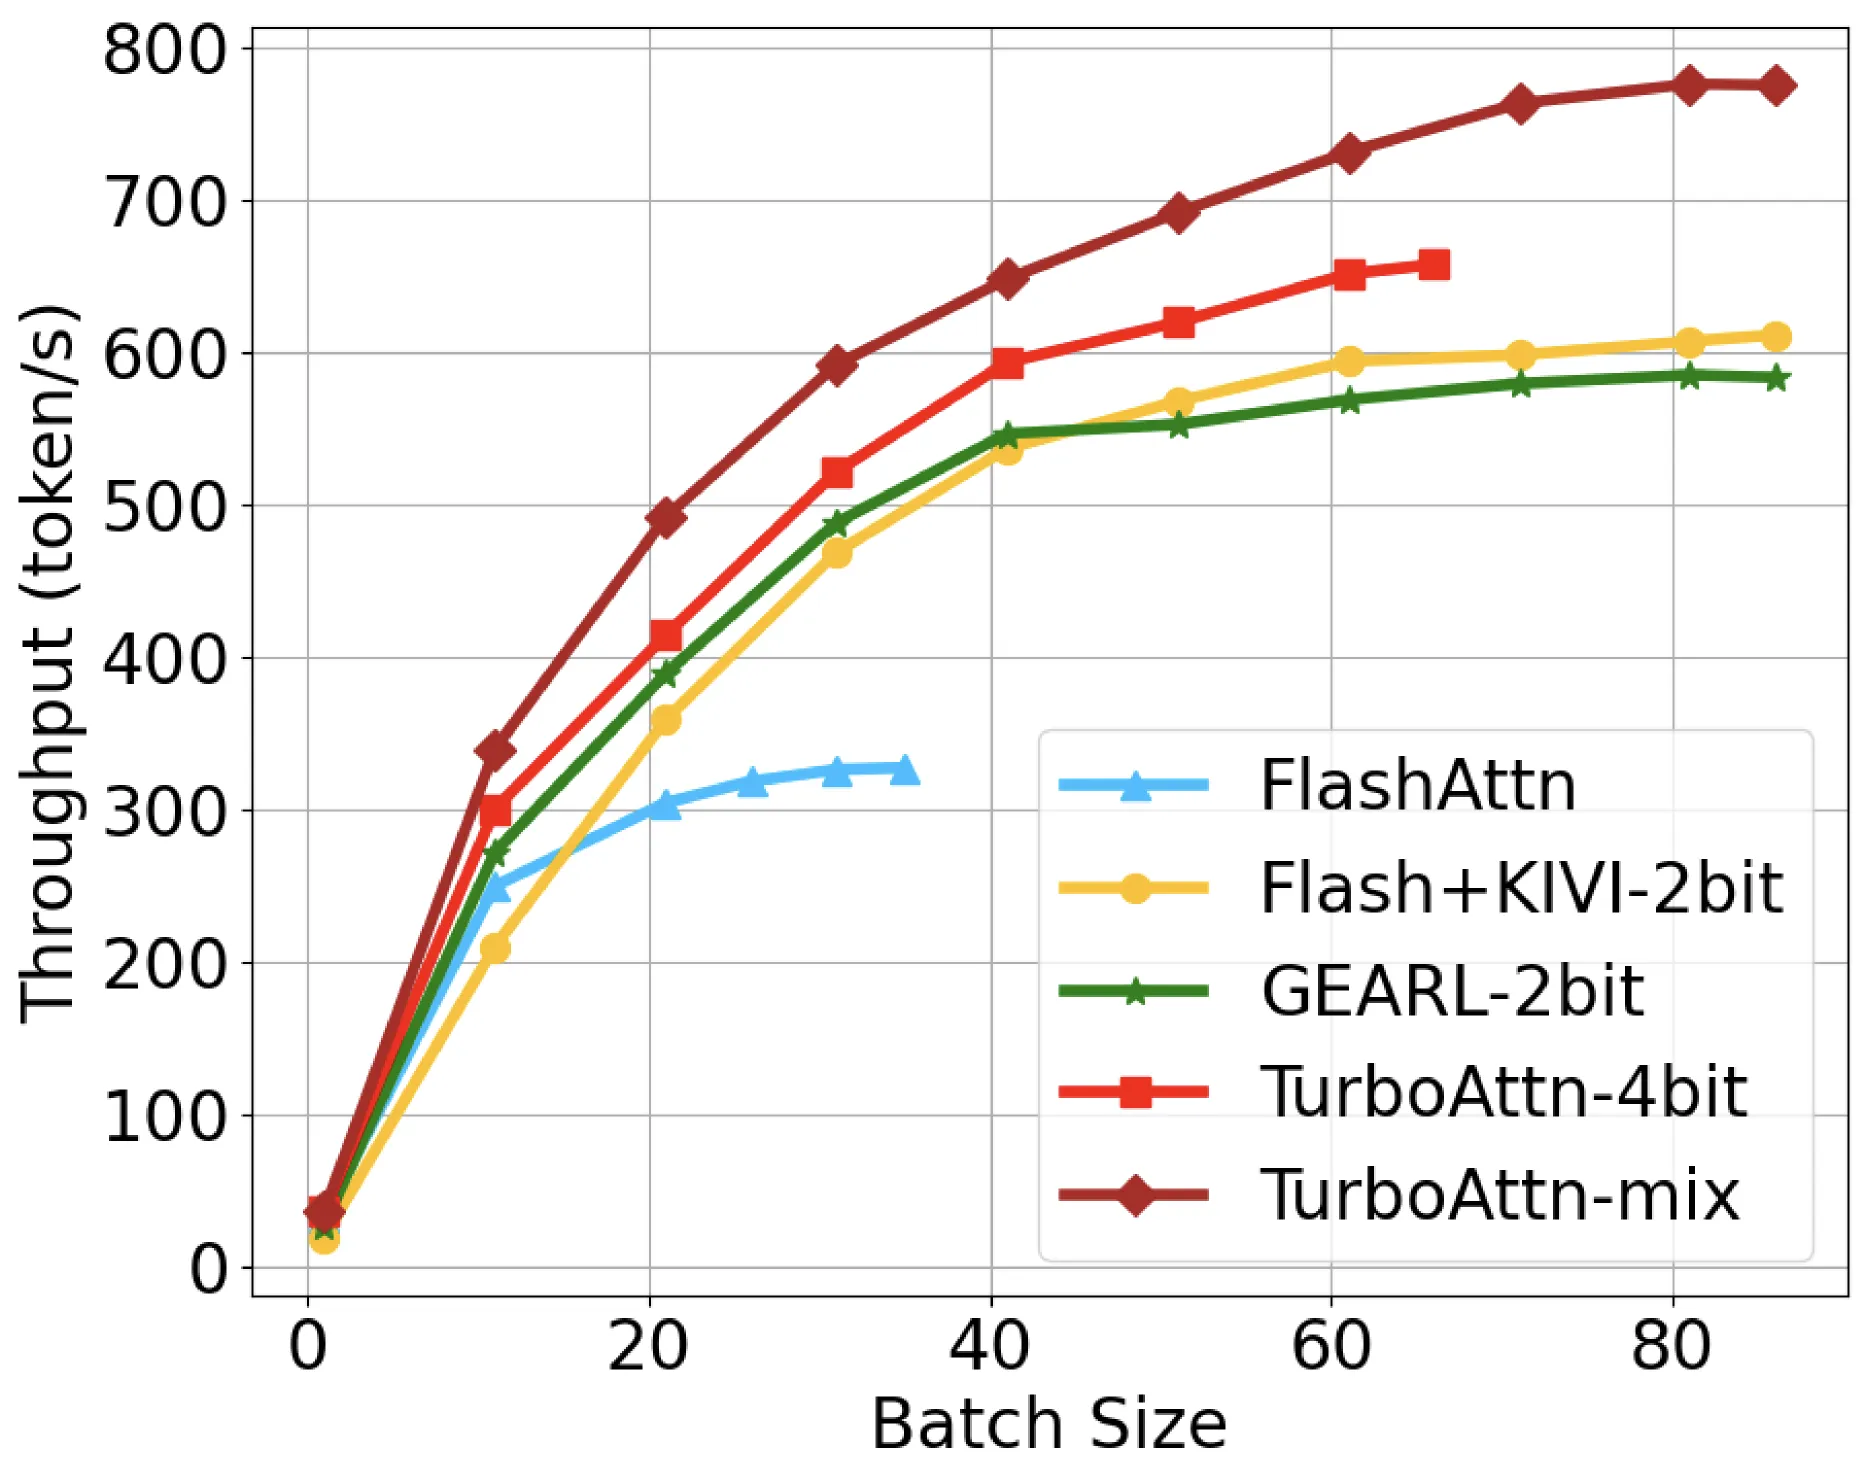
Figure 7a: Phi3-Medium在A100上的吞吐量对比
- 最大吞吐量提升:最高2.37倍(对比Flash-FP16基线)
- 优于KIVI和GEAR,得益于高效的渐进反量化
KV缓存压缩
| 指标 | 数值 |
|---|---|
| KV缓存压缩比 | 超过4.4倍 |
| 支持位宽 | 4-bit, 3-bit, 混合2/4-bit |
长上下文能力
- 支持batch size 4下32k tokens的长上下文生成
- FP16基线在4k以上即OOM
精度评估
| 方法 | 位宽 | LLaMA3 GSM8k | Phi3 GSM8k | 平均 |
|---|---|---|---|---|
| FP16 | 16 | 78.24 | 84.53 | 61.89 |
| KIVI | 4 | 61.18 | 57.09 | 51.85 |
| GEAR-L | 4 | 64.94 | 79.86 | 55.97 |
| TurboAttention | 4 | 78.31 | 84.00 | 60.27 |
| TurboAttention | 2/4混合 | 77.53 | 63.53 | 53.31 |
关键结果:
- 4-bit精度下仅**1.62%**精度差距(60.27% vs 61.89%)
- LLaMA3-8B GSM8K上几乎无损:78.31% vs 78.24%
- 显著优于KIVI和GEAR-L
消融实验
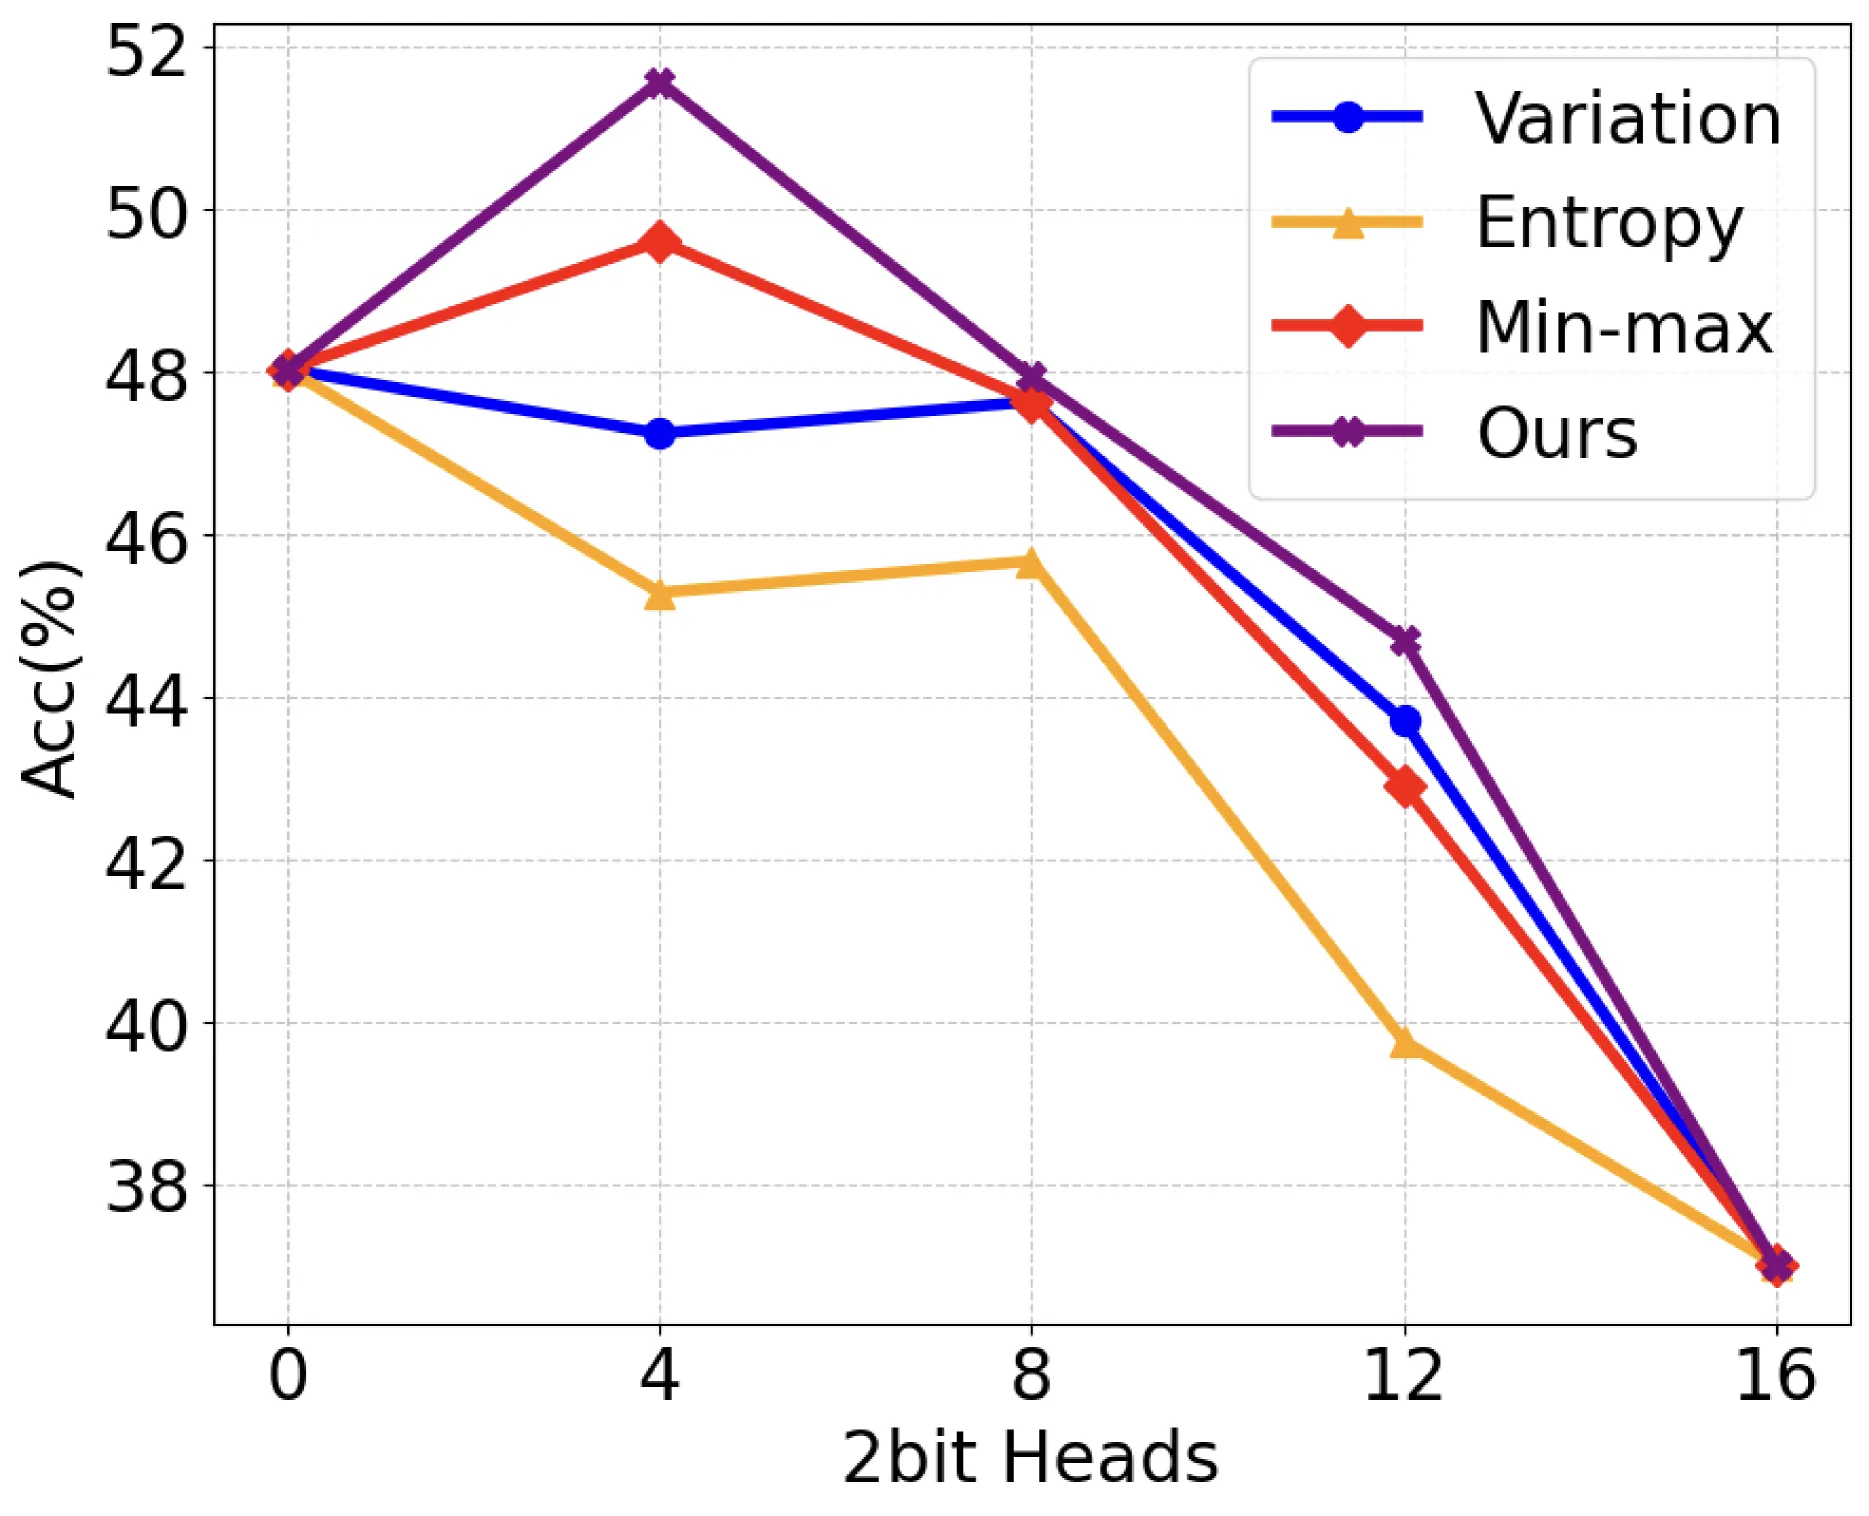
Figure 7b: 不同优先级技术的精度对比
头选择策略对比:
- 提出的优先级策略(gap × std)显著优于:
- 熵(entropy)
- 最小-最大(min-max)
- 方差(variation)
块大小消融:
| 块大小 (B_r, B_c) | 精度 |
|---|---|
| (64, 32) | 78.31 |
| (64, 64) | 78.31 |
| (128, 128) | 77.83 |
块大小选择具有鲁棒性。
组件独立评估
| 方法 | 精度 |
|---|---|
| FP16 | 50.79 |
| FlashQ-4bit | 49.60 |
| SAS | 50.12 |
| FlashQ-4bit + SAS | 48.03 |
FlashQ和SAS各自贡献约一半的精度损失,组合使用效果最佳。
与其他量化方法的正交性
| 方法 | 精度 |
|---|---|
| FP16 | 78.24 |
| LLM.int8() | 77.94 |
| LLM.int8() + TurboAttention | 77.48 |
| Qserve | 78.07 |
| Qserve + TurboAttention | 77.64 |
TurboAttention可与现有权重/激活量化方法组合使用。
值分布分析
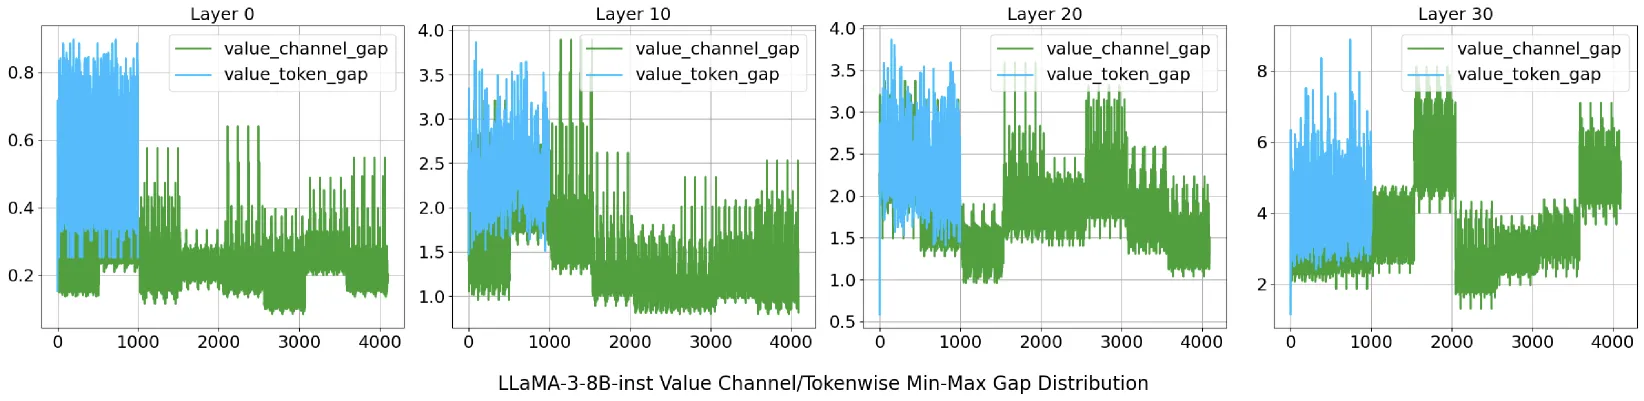
Figure 8: LLaMA-3-8B-inst Value通道/Token维度Min-Max分布
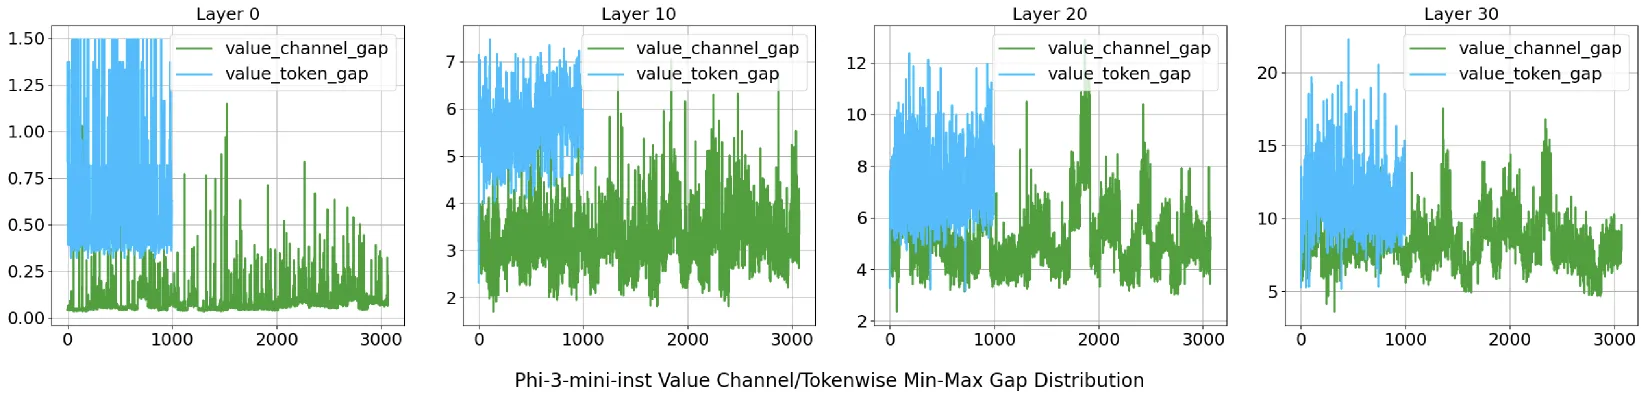
Figure 9: Phi-3-mini-inst Value通道/Token维度Min-Max分布
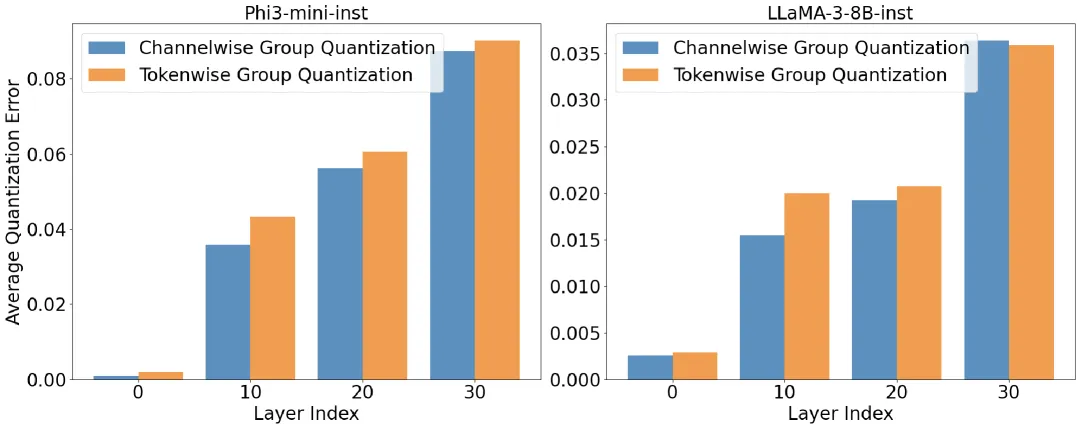
Figure 10: 两种方法的量化误差对比
通道级量化在具有显著通道异常值的模型(如Phi-3)上优于token级量化。
六、相关工作对比
| 方法 | 目标 | QKV量化 | KV压缩 | 注意力量化 | 特点 |
|---|---|---|---|---|---|
| ATOM | 线性操作 | ✓ | ✓ | - | 量化QKV投影和MLP |
| QuaRot | 线性操作 | ✓ | ✓ | - | 类似ATOM |
| Qserve | 线性操作 | ✓ | ✓ | - | 渐进量化 |
| KIVI | KV缓存 | - | ✓ | - | 逐通道key,逐token value |
| GEAR | KV缓存 | - | ✓ | - | 低秩近似 |
| FlashAttention | 注意力 | - | - | Flash | FP16/FP32分块执行 |
| TurboAttention | 注意力 | ✓ | ✓ | ✓ | 统一近似 |
TurboAttention的独特优势:
- 唯一同时提供量化QKV投影、KV缓存压缩和量化注意力执行的方法
- 首次将FlashAttention与量化算法桥接
- 首次应用有损技术加速整个注意力机制
七、总结
核心贡献
- FlashQ:头级混合精度渐进量化,实现KV缓存压缩和量化MatMul
- SAS:多项式近似+稀疏化,消除Softmax的FP32瓶颈
- 统一框架:首个同时优化注意力机制中矩阵乘法和Softmax的方案
- 正交兼容:可与ATOM、QuaRot、LLM.int8()、Qserve等组合使用
性能指标
| 指标 | 数值 |
|---|---|
| Prefill加速 | 最高1.8倍 |
| Decode加速 | 最高1.7倍 |
| 最大吞吐量 | 最高2.37倍 |
| KV缓存压缩 | 超过4.4倍 |
| 精度损失 | 4-bit仅1.62% |
| 长上下文 | 支持32k tokens |
技术影响
- 首次证明注意力机制可以进行有损压缩同时保持精度
- 将量化从线性操作扩展到注意力操作
- 为长上下文LLM推理提供高效解决方案
- 基于OpenAI Triton实现,有进一步CUDA优化空间
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1a | 反量化开销 | figure1a-latency-dequant-overhead.png |
| Figure 1b | 注意力核时间分布 | figure1b-attention-kernel-timeshare.png |
| Figure 1c | 端到端时间分布 | figure1c-end-to-end-timeshare.png |
| Figure 2 | 高级架构对比 | figure2-high-level-comparison.png |
| Figure 4 | 通道分布 | figure4-channel-distribution.png |
| Figure 5 | 多项式拟合 | figure5-polynomial-fit.png |
| Figure 6 | 注意力加速 | figure6-attention-speedup.png |
| Figure 7a | 吞吐量对比 | figure7a-throughput.png |
| Figure 7b | 优先级消融 | figure7b-priority-ablation.png |
| Figure 8 | LLaMA-3值分布 | figure8-llama3-value-distribution.png |
| Figure 9 | Phi-3值分布 | figure9-phi3-value-distribution.png |
| Figure 10 | 量化误差对比 | figure10-quantization-error.png |