Efficient LLM Inference using Dynamic Input Pruning and Cache-Aware Masking
通过动态输入剪枝和缓存感知掩码实现高效LLM推理,降低计算和内存开销。
论文分析: Efficient LLM Inference using Dynamic Input Pruning and Cache-Aware Masking
一、论文概述 (Paper Overview)
基本信息
| 属性 | 内容 |
|---|---|
| 标题 | Efficient LLM Inference using Dynamic Input Pruning and Cache-Aware Masking |
| 作者 | Anonymous Authors (提交至 MLSys 2025) |
| 机构 | Anonymous Institution (从 Snapdragon 引用推测与 Qualcomm 相关) |
| arXiv ID | 2412.01380 |
| 提交日期 | 2024年12月2日 |
| 会议 | Machine Learning and Systems (MLSys) - Under Review |
| 领域 | LLM推理优化、动态稀疏性、移动端部署 |
摘要
本文针对在内存受限的移动设备上高效运行大语言模型(LLM)推理的挑战,提出了Dynamic Input Pruning (DIP) 方法。现有的动态稀疏方法依赖于 ReLU 激活函数产生的自然稀疏性,但现代 LLM 广泛使用的 SwiGLU 架构几乎没有自然稀疏性。DIP 是一种无需预测器的动态剪枝方法,仅需最少的微调即可保持精度。此外,本文还引入了 Cache-Aware Masking 策略,通过考虑缓存状态和激活幅度来提高缓存命中率。
核心成果: 在 Phi-3-Medium 上实现 46% 内存减少 和 40% 吞吐量提升,困惑度损失 < 0.1。
二、核心思想 (Core Idea)
问题背景
| 挑战 | 描述 |
|---|---|
| 内存瓶颈 | 移动设备 DRAM 带宽增长远慢于 NPU 算力增长,LLM 推理受限于内存 |
| SwiGLU 稀疏性缺失 | 现代 LLM (Mistral, Llama-3, Phi-3 等) 使用 SwiGLU 而非 ReLU,自然稀疏性接近零 |
| 预测困难 | SwiGLU 激活值难以预测,现有 DejaVu 等预测方法失效 |
| 微调成本 | 替换为 ReLU 需要数十亿 token 的昂贵微调 |
核心洞察
- 输入级剪枝更有效: 直接基于输入激活幅度进行 top-K 剪枝,无需预测器
- 缓存感知优化: 将缓存状态纳入剪枝决策,优先选择已缓存的权重
- 轻量级恢复: 使用 LoRA 适配器恢复剪枝带来的精度损失
三、技术架构 (Technical Architecture)
3.1 整体框架
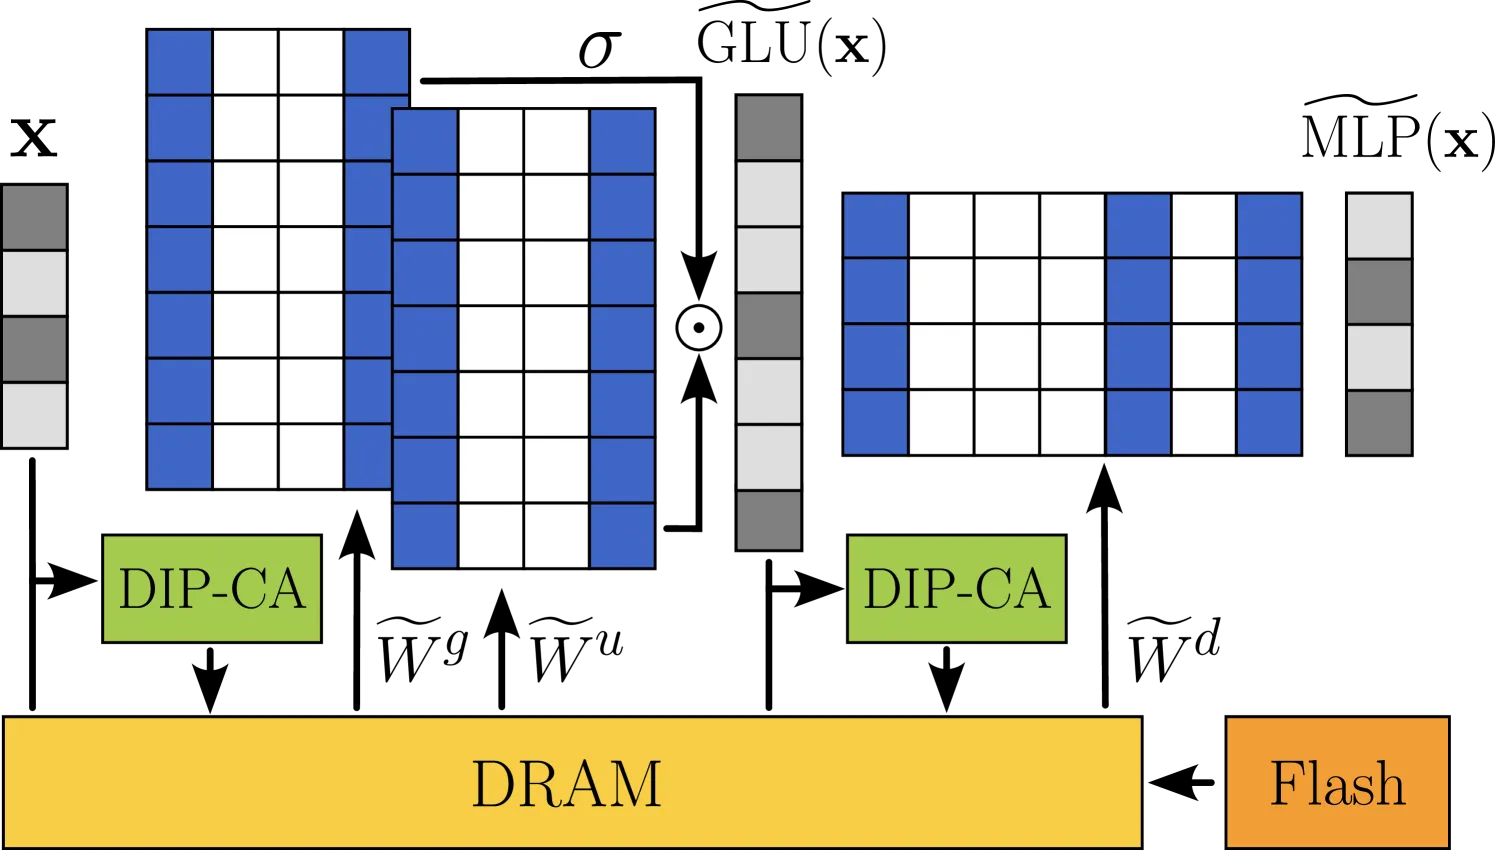 图1: Dynamic Input Pruning 方法在 Gated MLP 中的概述。Cache-Aware masking 组件基于当前输入激活和 DRAM 中缓存的权重输出列稀疏掩码。
3.2 GLU 架构基础
现代 LLM 的 MLP 层采用 Gated Linear Unit (GLU) 架构:
MLP(x) = W^d * GLU(x)
GLU(x) = W^u * x ⊙ σ(W^g * x)
其中:
W^u: Up 权重矩阵W^g: Gate 权重矩阵W^d: Down 权重矩阵σ: SiLU 激活函数
3.3 四种剪枝策略对比
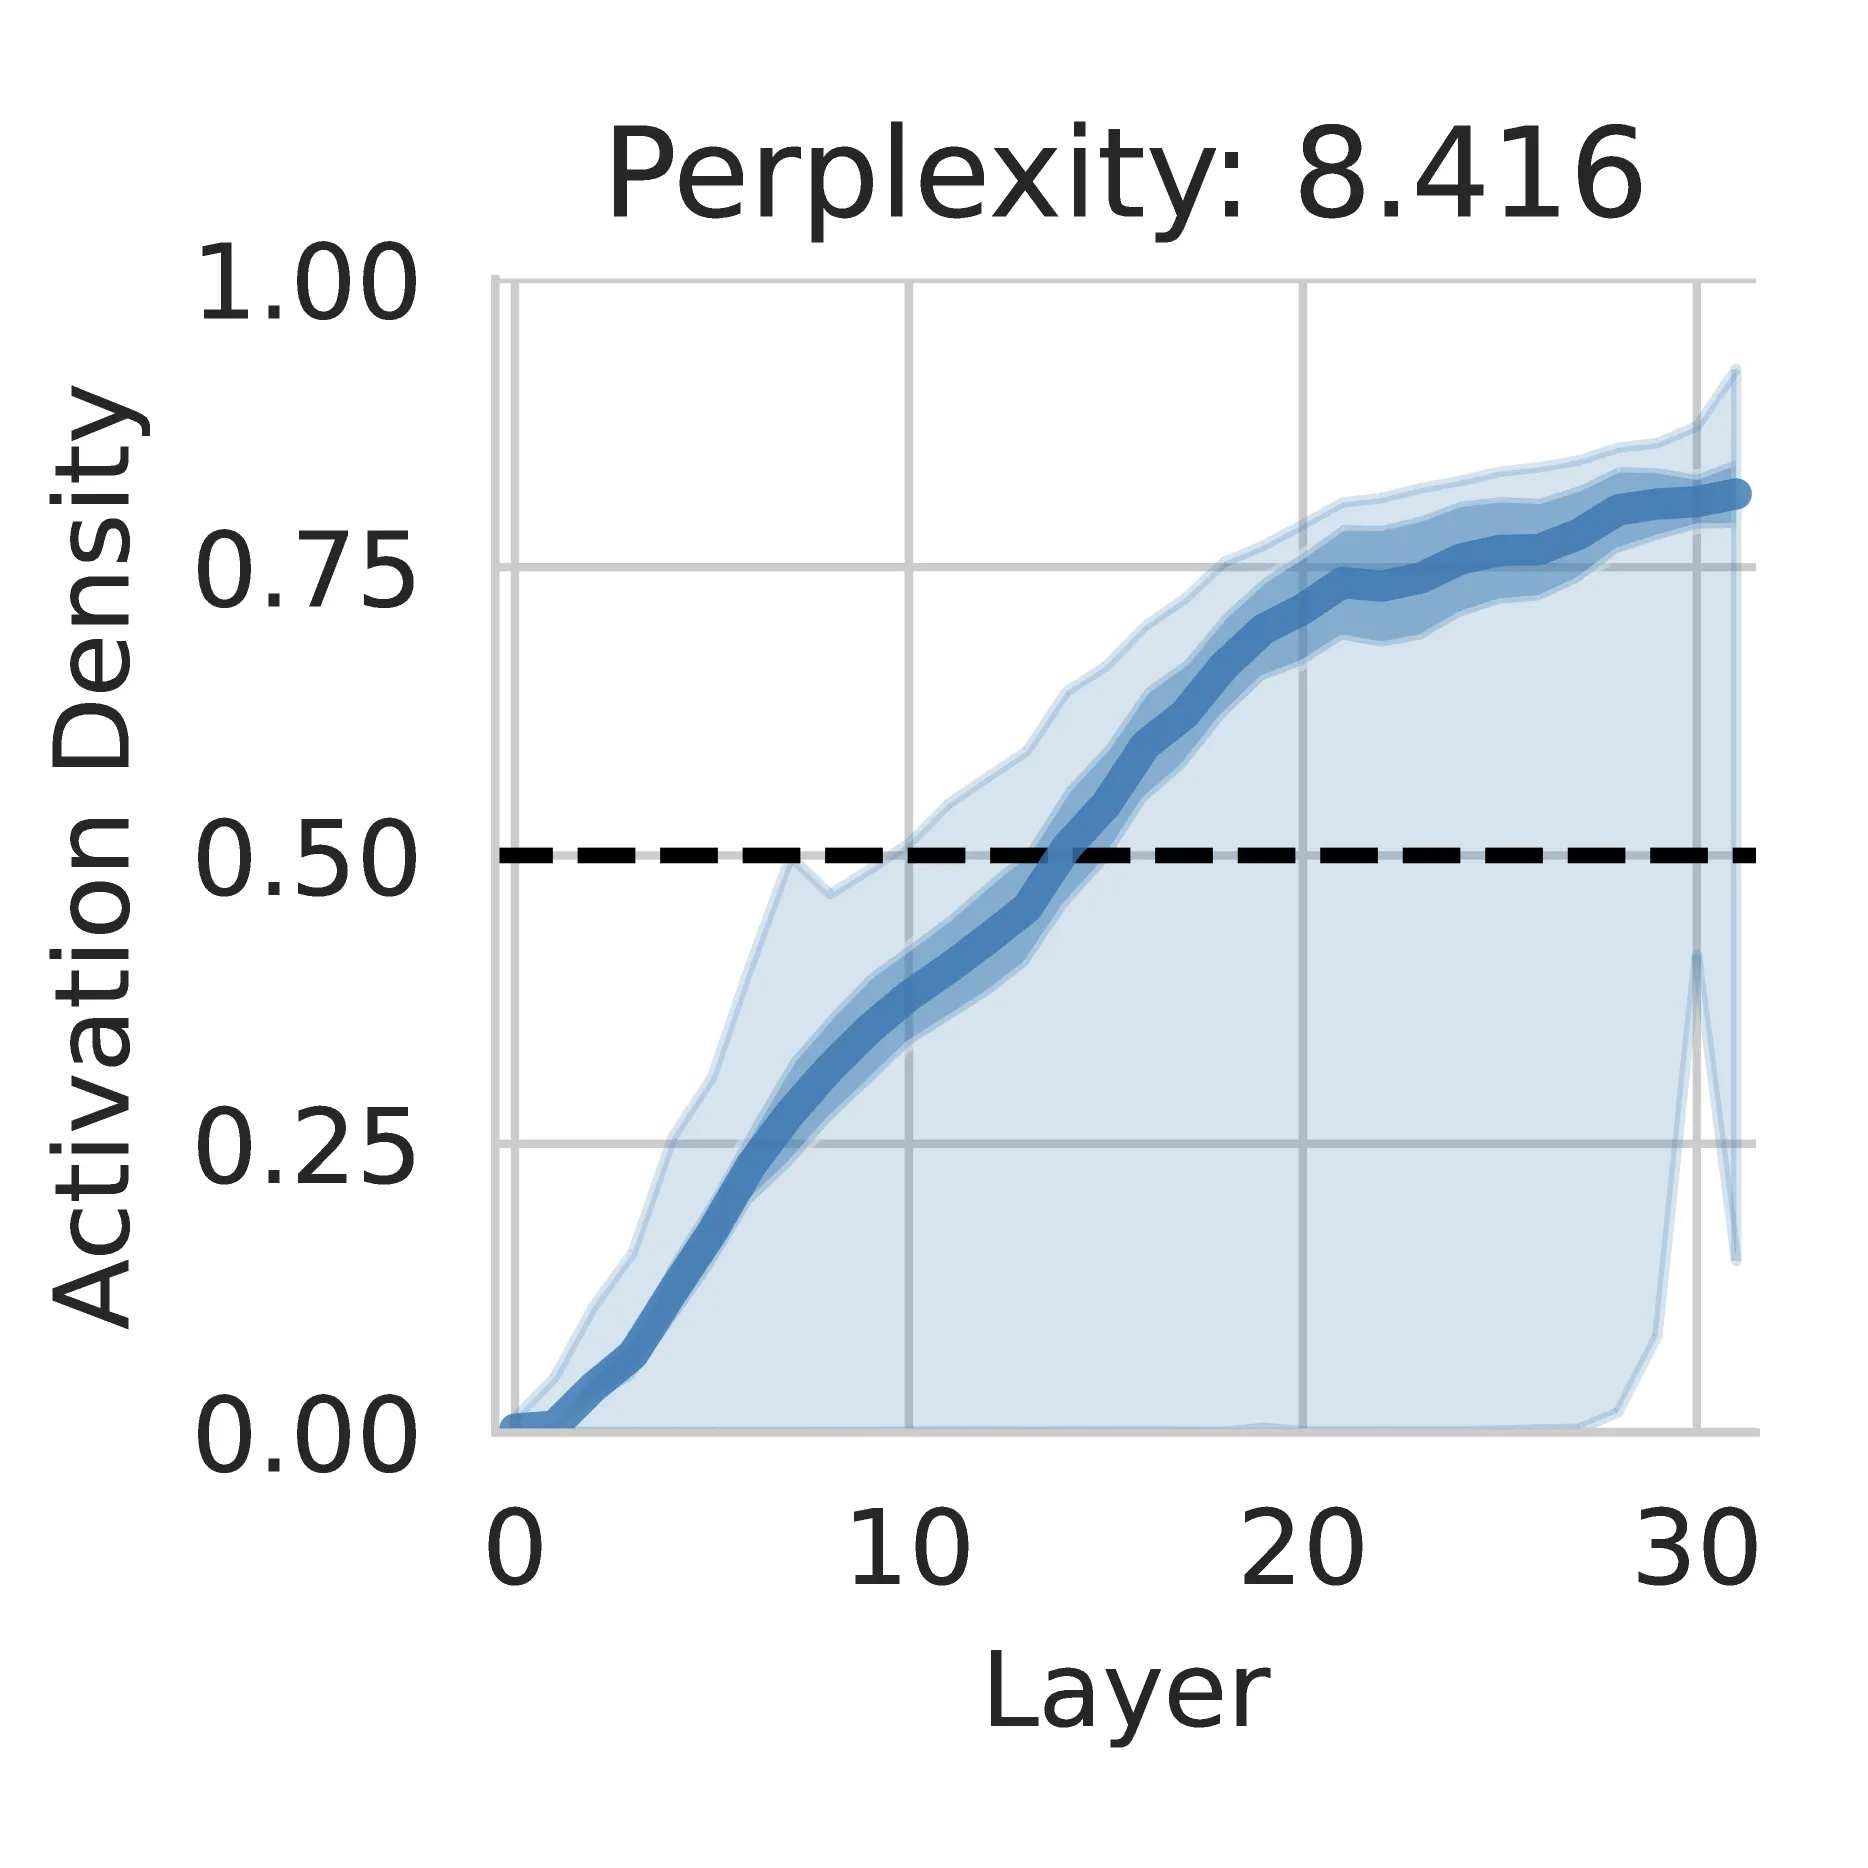 图5: GLU 剪枝、Gate 剪枝、预测剪枝和输入剪枝的示意图。
| 策略 | 剪枝对象 | 最大稀疏度 | 是否需要预测器 | 问题 |
|---|---|---|---|---|
| GLU Pruning | GLU 激活 -> W^d | 33% | 否 | 稀疏度上限低 |
| Gate Pruning | σ(W^g*x) -> W^u, W^d | 66% | 否 | 基于部分激活,效果差 |
| Predictive GLU | pred(x) -> 全部矩阵 | 66%+ | 是 | SwiGLU 上预测失败 |
| DIP (本文) | x -> W^u, W^g; GLU -> W^d | 66%+ | 否 | 解决方案 |
四、核心创新 (Core Innovations)
4.1 Dynamic Input Pruning (DIP)
DIP 的核心公式:
输入级剪枝 (剪枝 Up 和 Gate 矩阵):
W̃^u_{:,i}, W̃^g_{:,i} = {
    0, 0           if i ∉ topK(|x|)
    W^u_{:,i}, W^g_{:,i}  otherwise
}
GLU 级剪枝 (剪枝 Down 矩阵):
W̃^d_{:,i} = {
    0              if i ∉ topK(|GLU(x)|)
    W^d_{:,i}      otherwise
}关键优势:
- 无需额外预测器,减少参数开销
- 仅需最小化微调
- 可针对不同矩阵使用不同稀疏度
4.2 轻量级 LoRA 微调
为补偿剪枝带来的近似误差,在剪枝的 Up、Gate 和 Down 矩阵上添加 LoRA 适配器:
W_{:,i} -> (W + AB)_{:,i}其中 A 和 B 是低秩可学习矩阵。关键设计: 适配器在列选择之前应用,微调后可融合到原始矩阵,避免额外开销。
4.3 Cache-Aware Masking (DIP-CA)
 图7: Cache-Aware Dynamic Input Pruning 方法在单个线性层上的应用。
缓存感知重加权机制:
s^(t) = |x^(t)| * (c^(t-1) + γ(1 - c^(t-1))) / ||x^(t)||∞其中:
x^(t): 当前输入激活c^(t-1): 缓存状态的二值掩码γ: 惩罚超参数 (0.1-0.3 最优)
核心观察: 少数激活值幅度远大于其他,对层输出影响更大。中间范围的激活值贡献相近,可以被重排序以优先使用缓存权重。
算法流程 (Algorithm 1):
- 计算缓存感知分数 s^(t)
- 执行 top-K 选择获得掩码 m^(t)
- 更新缓存状态 c^(t)
- 应用掩码获得稀疏权重 W̃^(t)
五、实验结果 (Experimental Results)
5.1 实验设置
| 配置 | 详情 |
|---|---|
| 模型 | Phi-3-Medium (14B), Phi-3-Mini (3.8B), Llama-v3-8B, Mistral-7B |
| 量化 | INT4 (4-bit) |
| 评估指标 | WikiText-2 困惑度, MMLU 5-shot 准确率 |
| 硬件模拟 | 自定义 HW Simulator (详见附录 A) |
| 数据集 | WikiText-2, MMLU |
5.2 精度对比 (50% MLP 稀疏度)
| 方法 | Phi3Med PPL↓ | Phi3Mini PPL↓ | Llama8B PPL↓ | Mistral7B PPL↓ | Phi3Med MMLU↑ |
|---|---|---|---|---|---|
| Dense | 4.29 | 6.01 | 6.14 | 5.25 | 78.14% |
| GLU Pruning (oracle) | 4.45 | 6.10 | 6.30 | 5.29 | 77.98% |
| SparseGPT (unstructured) | 5.67 | 7.44 | 7.71 | 5.81 | 73.97% |
| SparseGPT (2:4) | 6.87 | 9.84 | 10.05 | 7.31 | 68.07% |
| Gate Pruning | 11.28 | 14.83 | 29.26 | 96.37 | 66.08% |
| Up Pruning | 7.41 | 10.94 | 13.93 | 7.13 | 70.68% |
| DejaVu | 6.15 | 8.76 | 9.43 | 6.24 | 68.99% |
| CATS | 8.34 | 10.83 | 28.24 | 60.48 | 71.08% |
| CATS+LoRA | 5.54 | 7.44 | 16.53 | 9.18 | 72.23% |
| DIP (本文) | 5.52 | 7.04 | 7.38 | 5.61 | 75.54% |
| DIP+LoRA (本文) | 5.01 | 6.79 | 7.26 | 5.57 | 75.89% |
关键发现:
- DIP 在所有模型和评估场景中均优于 CATS+LoRA 和其他基线
- DIP+LoRA 进一步改善结果,尤其在困惑度方面
- 在 Phi-3-Medium 上,DIP 仅损失 0.20 PPL 和 0.01% MMLU 准确率即可实现 30% 内存减少
5.3 吞吐量对比
| 方法 | Phi3Med @+0.2 PPL | Phi3Mini @+0.2 PPL | Llama8B @+0.2 PPL | Mistral7B @+0.2 PPL |
|---|---|---|---|---|
| Dense | 0.29 tok/s | 1.15 tok/s | 0.57 tok/s | 0.54 tok/s |
| GLU Pruning | 0.41 tok/s | 1.59 tok/s | 0.78 tok/s | 0.80 tok/s |
| Up Pruning | 0.43 tok/s | 1.69 tok/s | 0.76 tok/s | 1.03 tok/s |
| CATS | 0.40 tok/s | 1.54 tok/s | 0.73 tok/s | 0.69 tok/s |
| DIP | 0.43 tok/s | 1.69 tok/s | 0.73 tok/s | 0.98 tok/s |
| DIP-CA | 0.45 tok/s | 1.77 tok/s | 0.78 tok/s | 1.08 tok/s |
DIP-CA 在所有模型上实现最高吞吐量,在相同困惑度阈值下比 DIP 进一步提升。
5.4 Pareto 曲线分析
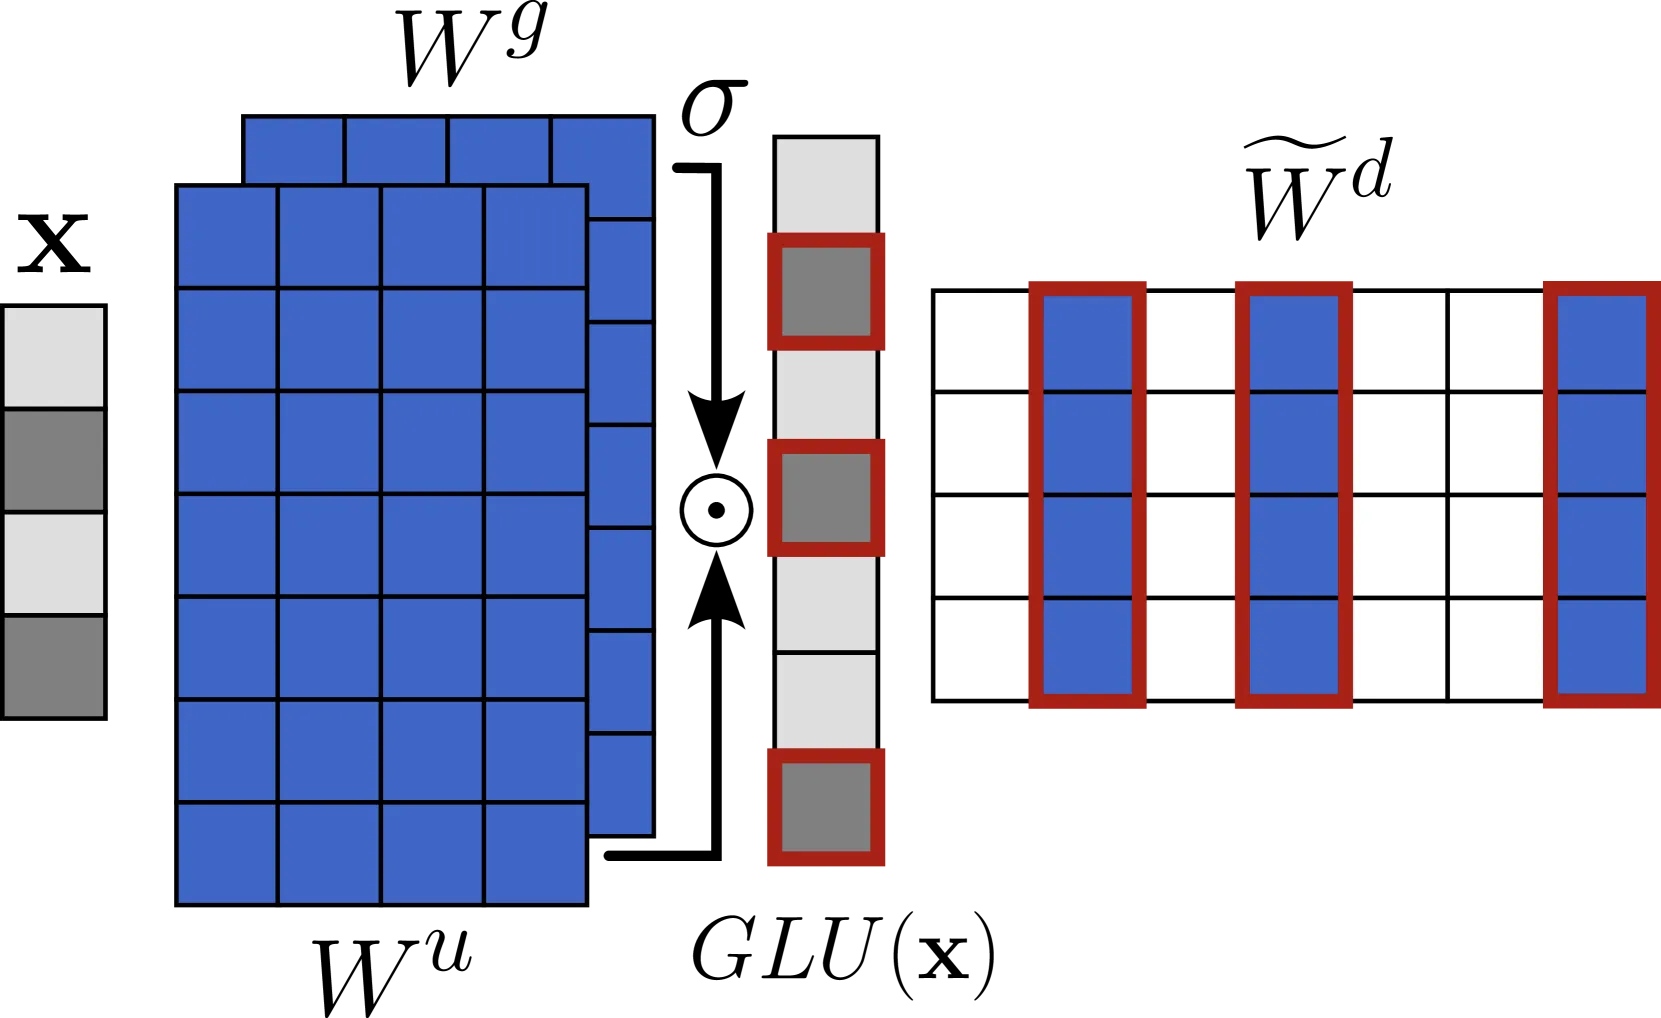 图8: WikiText-2 困惑度和 MMLU 准确率与 MLP 密度的 Pareto 曲线 (Phi-3-Medium)。
关键观察:
- DIP 在所有稀疏度水平上均优于静态和动态剪枝方法
- 在 70% 内存占用下,Phi-3-Medium 仅损失 0.20 PPL
5.5 与量化方法的兼容性
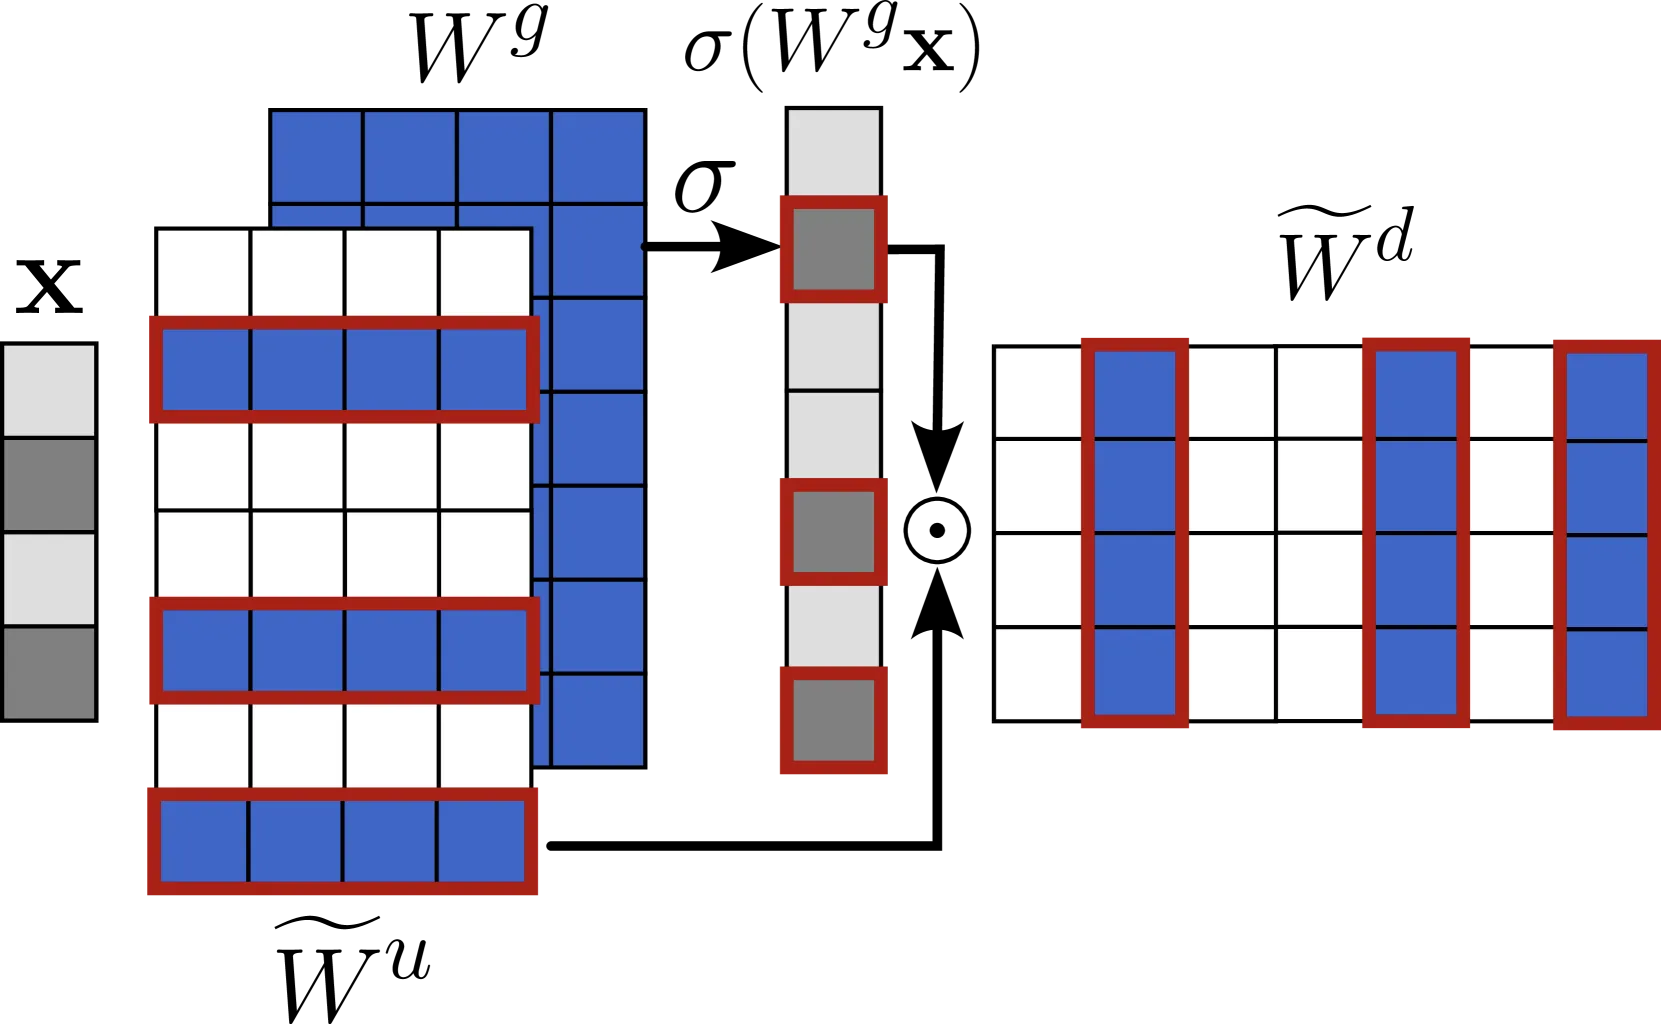 图9: DIP 与 4-bit BQ 和 3-bit VQ 量化的集成对比。
- DIP 应用于 4-bit BQ 模型时,比 SparseGPT 低 15% 困惑度
- BQ4+DIP 优于更激进的 BQ 量化,表明动态稀疏性优于降低量化位宽
- VQ3+DIP 在高稀疏度下优于 BQ4+DIP,证明 DIP 与量化方法互补
5.6 缓存策略对比
图11: 缓存淘汰策略与缓存感知掩码的对比。
| 策略 | 特点 | 性能 |
|---|---|---|
| 无缓存 | 每个 token 都从 Flash 加载 | 最差 |
| LRU | 淘汰最久未使用权重 | 中等 |
| LFU | 淘汰最少使用权重 | 略优于 LRU |
| Belady Oracle | 知道未来访问的最优策略 | 略优于 LFU |
| DIP-CA + LFU | 缓存感知重加权 + LFU | 最优,超越 Belady |
重要发现: DIP-CA + 简单 LFU 策略超越了知道未来访问模式的 Belady 最优算法,这是因为 DIP-CA 主动将剪枝决策偏向已缓存的权重。
六、相关工作 (Related Work)
6.1 静态剪枝与量化
| 方法 | 类型 | 特点 |
|---|---|---|
| SparseGPT | 静态剪枝 | 一次性权重剪枝,需要额外位存储掩码 |
| BQ (Blockwise Quantization) | 量化 | 块级量化,2-4 bit |
| VQ (Vector Quantization) | 量化 | 向量量化,更激进压缩 |
6.2 动态稀疏性
| 方法 | 类型 | 特点 |
|---|---|---|
| DejaVu | 预测器驱动 | 训练小预测器识别零激活,ReLU LLM 有效 |
| LLM in a Flash | 从 Flash 加载 | 结合动态稀疏和 DRAM 缓存 |
| CATS | 门激活剪枝 | 基于门激活的逐层阈值剪枝 |
| ShadowLLM | 预测器驱动 | 上下文稀疏性预测 |
6.3 SwiGLU 相关工作
- ReLU 替换法: 将 SiLU 替换为 ReLU 并重新训练 (如 TurboSparse),但需要数十亿 token 微调
- 本文方法: 无需修改激活函数,直接在输入级进行动态剪枝
七、总结 (Conclusion)
主要贡献
-
分析了现有方法的局限性: 证明 DejaVu 和 LLM in a Flash 在 SwiGLU LLM 上的预测方法不实用
-
提出 DIP 方法: 无需预测器的动态 MLP 剪枝,在所有测试的现代 LLM 上优于现有方法
-
引入 DIP-CA: 缓存感知掩码策略,在不同 DRAM 约束和硬件设置下实现更好的精度-延迟权衡
核心成果
| 指标 | Phi-3-Medium 上的表现 |
|---|---|
| 内存减少 | 46% |
| 吞吐量提升 | 40% |
| 困惑度损失 | < 0.1 |
| 与量化兼容 | 是 (可与 BQ/VQ 结合) |
局限性与未来工作
- 当前评估基于硬件模拟器,未在真实移动设备上验证
- 最大有效稀疏度约 50%,低于 ReLU LLM 的 90%+
- 未来将探索更广泛的模型和硬件配置
八、参考资源 (References)
核心参考文献
- Abdin et al. (2024) - Phi-3 technical report. arXiv:2404.14219
- Alizadeh et al. (2023) - LLM in a Flash. arXiv:2312.11514
- Liu et al. (2023) - DejaVu: Dynamic sparsity for efficient inference. arXiv:2310.05713
- Lee et al. (2024) - CATS: Context-aware thresholding sparsity. arXiv:2404.11717
- Frantar & Alistarh (2023) - SparseGPT. arXiv:2301.00774
- Hu et al. (2021) - LoRA: Low-rank adaptation. arXiv:2106.09685
- Mirzadeh et al. (2023) - ReLU strikes back. arXiv:2310.04564
- Song et al. (2024) - TurboSparse. arXiv:2404.02285
相关资源
- arXiv 论文: https://arxiv.org/abs/2412.01380
- HTML 版本: https://arxiv.org/html/2412.01380v1
- 代码: 论文计划开源 HW simulator、方法和实验代码
关键图表索引
| 图表 | 文件名 | 描述 |
|---|---|---|
| 图1 | fig1-dip-overview.png | DIP 方法在 Gated MLP 中的整体概述 |
| 图2 | fig2-npu-dram-trends.png | NPU 算力与 DRAM 容量趋势对比 |
| 图5 | fig5-sparsity-schemes.png | 四种稀疏性方案的示意图 |
| 图6 | fig6-glu-sparsification.png | SwiGLU vs ReLU 稀疏化效果对比 |
| 图7 | fig7-cache-aware-dip.png | DIP-CA 方法流程图 |
| 图8 | fig8-pareto-curves.png | 精度-稀疏度 Pareto 曲线 |
| 图9 | fig9-quantization-comparison.png | 与量化方法的兼容性对比 |
分析完成于 2025年1月 | 基于 arXiv:2412.01380v1